المعيار الذي يفشل فيه أفضل نموذج للذكاء الاصطناعي بنسبة 85٪ من الوقت في ملف PDF
استنادًا إلى: GDP.pdf: Benchmarking Grounded Multimodal Reasoning over Professional PDF Documents — Suhaas Garre, Emily Ritchie, Sushant Mehta, Edwin Chen
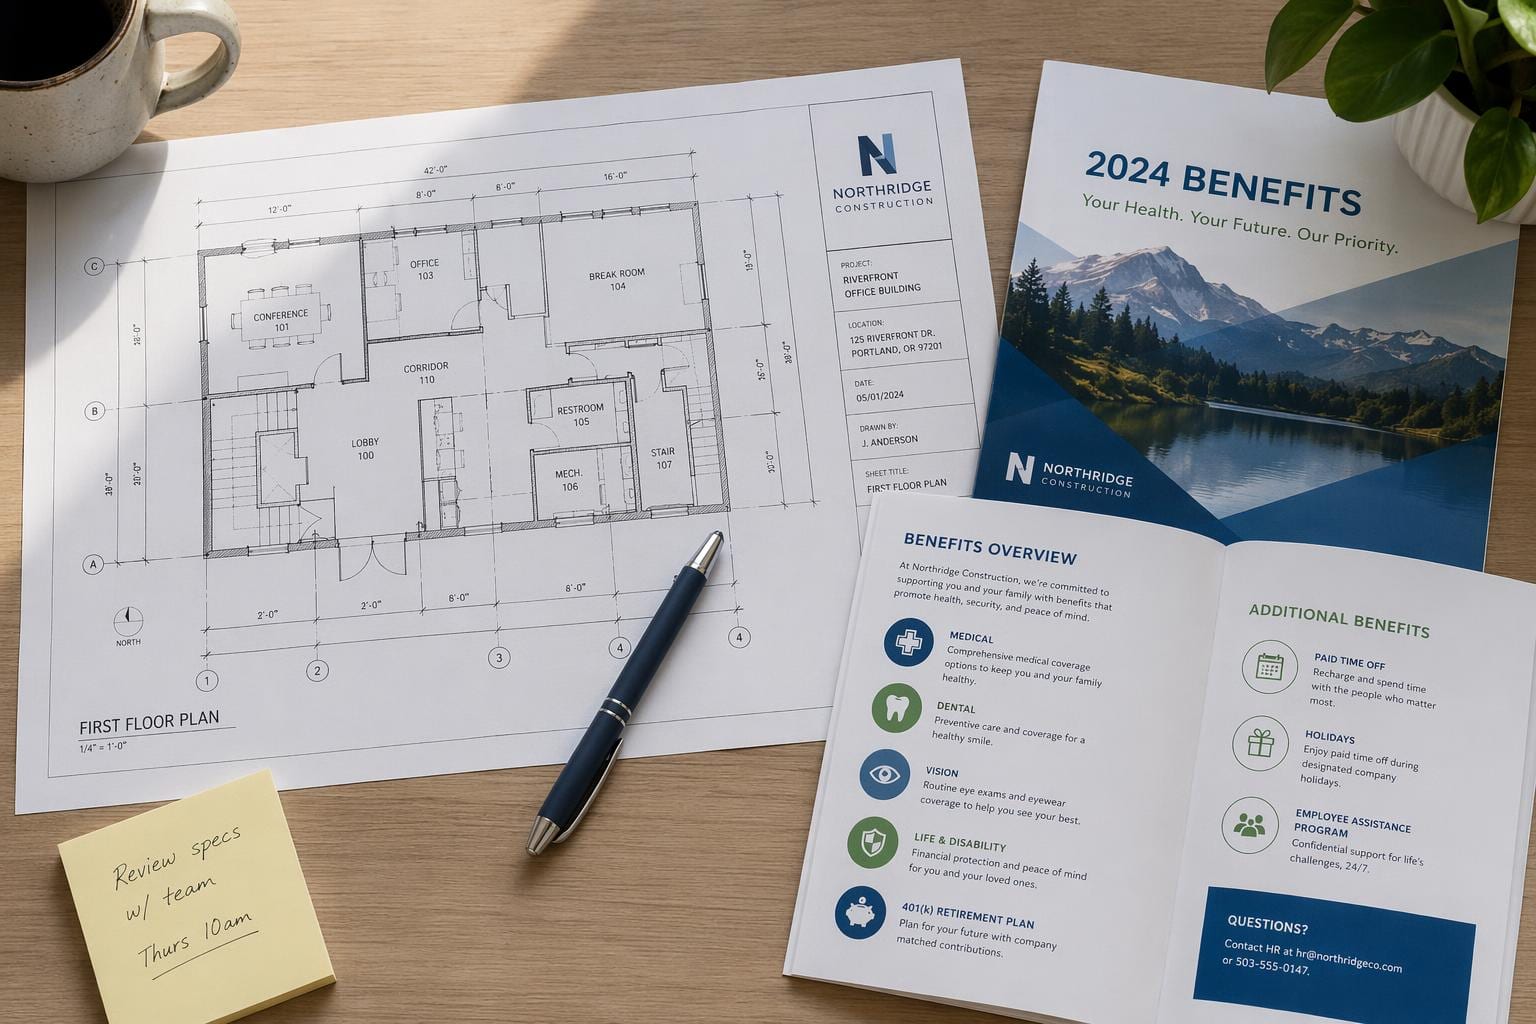
تخيل مسؤول مزايا لديه ملف PDF مكون من 40 صفحة مفتوح على شاشة واحدة، وسؤال موظف على الشاشة الأخرى: "إذا كان لدي خطة PPO وزرت أخصائياً خارج الشبكة، فما هو الحد الأقصى الفعلي للتكاليف الجيبية بعد خصم الاستقطاع؟" الإجابة موجودة هناك. لكنها مجرد متفرقة عبر جدول في الصفحة 12، وحاشية في الصفحة 14 تستثني زيارات معينة للأخصائيين، وتعديل في الصفحة 38 يتجاوز بهدوء الرقم الموجود في الصفحة 12. شخص يعرف كيفية قراءة حزم المزايا يمكنه العثور عليها في بضع دقائق. ورقة بحثية جديدة بعنوان GDP.pdf طرحت هذا النوع بالضبط من الأسئلة على سبعة نماذج متعددة الوسائط رائدة. أفضل نموذج أجاب بشكل صحيح على 15% من الأسئلة الـ 100 في المعيار. الأسوأ أجاب على 1% فقط.
هذا ليس معياراً تكون فيه النماذج قريبة من الحل وتضغط لاستخراج النقاط الأخيرة. هذا معيار تكون فيه المجال بالكاد قد بدأ. والسبب يستحق الفهم، لأنه يكشف شيئاً غير مريح حول كيفية قياسنا لـ "الذكاء الاصطناعي يمكنه قراءة المستندات الآن."
لماذا يخدعك معيار تقييم التعرف الضوئي على الحروف (OCR) الخاص بك
تختبر معظم معايير تقييم ذكاء المستندات المهارة الواحدة في كل مرة. فهناك معيار لقراءة النص من صفحة ممسوحة ضوئياً (التعرف الضوئي على الحروف). ومعيار آخر لفهم مواقع العناصر على الصفحة، مثل تحديد أي بند ينتمي إلى أي عمود (تحليل التخطيط). ومعيار لقراءة القيم من مخطط بياني (استدلال المخططات). ومعيار للإجابة على الأسئلة المتعلقة بجداول البيانات (الإجابة على أسئلة الجداول). ومعيار للمهام العامة التي تتطلب "نظرة على هذا المستند والإجابة على سؤال" (الإجابة المرئية على أسئلة المستندات).
قد يحقق نموذج أداءً جيداً في جميع هذه المجالات الخمسة عند اختبارها بشكل منفصل، ومع ذلك يفشل في المهمة التي يحتاجها المحترفون فعلياً: فتح ملف PDF محدد، معقد، وواقعي، والإجابة على سؤال محدد وذو أهمية حوله. وقد أوضح مؤلفو دراسة GDP.pdf هذا الأمر بوضوح في إطار الورقة البحثية: فإن الدرجة العالية في أي قدرة معزولة لا تخبرك عما إذا كان النموذج قادراً على التعامل مع سؤال واقعي حول مستند حقيقي. فعدم ملاحظة النموذج لملاحظة تالية في الصفحة الثالثة تستبعد نصف الصفوف، يجعل القراءة الصحيحة للجدول عديمة الفائدة. وبالمثل، فإن القراءة الصحيحة للمخطط البياني لا تنفع إذا لم يقم النموذج بمراجعته مقابل الفقرة التي تفسر ما يقيسه المخطط فعلياً.
هذه هي نفس المعضلة التي يتعامل معها بائعو تقنيات التعرف الضوئي على الحروف منذ سنوات: محرك ينجح في معالجة فاتورة نظيفة ومستقلة قد يفشل تماماً بمجرد أن تكون تلك الفاتورة صورة مسربة لنسخة ضوئية عليها بقعة قهوة، أو تمتد على صفحات متعددة مع تذييل مستمر، أو تحتوي على جدول يقفز عموداً في منتصف الصفحة. تقيس معايير المهارات المعزولة الحالة النظيفة. أما العمل الحقيقي فيعيش في الحالة المعقدة.
كيف بنوا معياراً يصعب التلاعب بنتائجه
الجزء الذكي في GDP.pdf لا يكمن في المستندات نفسها، بل في المرشح (Filter) الذي استخدموه لتحديد الأسئلة الجديرة بالشمول.
استقدم الفريق محترفين يعملون في عشر مجالات مختلفة، وهم أشخاص حقيقيون يتعاملون مع حزم المزايا، وعقود الإيجار، والكتالوجات التقنية، والإرشادات السريرية، ومخططات البناء كجزء من وظائفهم الفعلية، وطلب منهم كتابة أسئلة حول مستندات حقيقية من تخصصاتهم. لكن كتابة سؤال يبدو صعباً لا تعني بالضرورة كتابة سؤال يميز فعلياً بين النماذج القادرة والنماذج غير القادرة. لذا أضافوا حاجزاً: لا يُدرج السؤال المرشح في المعيار النهائي إلا إذا فشلت فيه نماذج متعددة الوسائط رائدة (Frontier) على الأقل بطرق ذات دلالة. ليس مجرد خلاف شكلي حول الصياغة، بل إجابة خاطئة، أو إغفال لدليل كان يجب أن يغير الإجابة، أو ادعاء مُفتعل لا تدعمه المستند.
هذه القاعدة التي تشترط فشل نموذجين لها أهمية أكبر مما قد تبدو عليه. فهي تعني أن كل سؤال في المعيار قد أثبت بالفعل، تجريبياً، أنه يعثر على أنظمة الذكاء الاصطناعي الحالية بطريقة محددة وذات مغزى. لا يوجد هنا أي محتوى عديم الفائدة، ولا أسئلة سهلة يحصل عليها كل نموذج بشكل صحيح لمجرد تضخيم النتيجة. كل عنصر من العناصر المائة موجود لأنه تغلب أولاً على نموذجين قويين على الأقل.
كما أنهم لم يكتفوا بالتقييم بنظام "ناجح/راسب". يأتي كل سؤال مع دليل تقييم (Rubric) يتكون من معايير ذرية، وهي متطلبات صغيرة وقابلة للتحقق يجب أن تستوفيها الإجابة، مما يسمح للورقة البحثية بالإبلاغ عن رقمين مختلفين: درجة التقييم التفصيلي (التي تمنح رصيداً جزئياً للإجابة الصحيحة على بعض الأجزاء)، ومعدل النجاح الصارم على مستوى المهمة (هل حصل النموذج على الإجابة كاملة وصحيحة تماماً؟). كما تم تصنيف كل عنصر وفقاً لتصنيف لـ 11 كفاءة عبر ثلاث مستويات، تغطي أموراً مثل استخراج النص والتأريض (Grounding) (هل يمكنك العثور على المقطع الصحيح واستشهاده بدقة)، وفهم الجداول والرسوم البيانية، والمراجع المتقاطعة عبر الصفحات، والاستدلال المكاني (كيف تترتب العناصر بالنسبة لبعضها البعض على الصفحة)، والامتناع عن الإجابة (Abstention) (هل يعرف النموذج متى لا يدعم المستند إجابة معينة، ويقول ذلك بدلاً من التخمين).
تستحق هذه النقطة المتعلقة بالامتناع عن الإجابة تسليط الضوء عليها بشكل خاص. يختبر تقييم الذكاء الاصطناعي للمستندات في كثير من الأحيان فقط ما إذا كان النموذج يحصل على الإجابة الصحيحة عندما تكون موجودة. لكن GDP.pdf يتحقق أيضاً مما إذا كان النموذج سيصنع إجابة عندما لا تحتوي المستند فعلياً على المعلومات المطلوبة، وهو ما يُعد على الأرجح نمط فشل أكثر خطورة في السياق المهني. لا يتضرر أحد عندما يقول النموذج "لا يمكنني العثور على ذلك في هذا المستند". لكن الناس يتضررون من رقم واثق وخاطئ في حساب المزايا أو في بند من بنود عقد الإيجار.
الأرقام التي ينبغي أن تثير قلقك
تبدو النتيجة الرئيسية صارخة: عبر سبعة نماذج رائدة، نجح الأفضل منها في اجتياز 15% من الـ 100 عنصر في مقياس المهمة الصارم على مستوى المهمة. أما الأسوأ، فلم يجتز سوى 1%. لمجال قضى العامين الماضيين يدعي تحقيق أداء قريب من البشري في فهم المستندات، فإن سقف 15% في أسئلة كتبها متخصصون حقيقيون في المجال حول مستندات مهنية فعلية هو رقم صعب التبرير أو التقليل من شأنه.
من المفيد التأمل في ما تمثله هذه الفجوة. هذه ليست حالات فشل للنماذج في التعرف الضوئي على الحروف (OCR) بالمعنى الكلاسيكي؛ إذ يمكنها في الغالب قراءة النص الموجود على الصفحة بشكل جيد. بل إنها تفشل في طبقة الاستدلال التي تعلو ذلك: ربط رقم في جدول بتحذير موجود في الهامش، ملاحظة أن تعديلاً لاحقاً يلغي بنداً سابقاً، عد الرموز بشكل صحيح في مخطط طابق، أو إدراك أن محور الرسم البياني لا يعني ما يوحي به النظرة السريعة. هذه هي الطبقة التي تعيش فيها ملفات PDF المهنية فعلياً، وهي الطبقة التي لم تُدرَّب النماذج متعددة الوسائط العامة على التعامل معها بشكل جيد، لأن معظم بيانات التدريب والتقييم لا تشبه حزمة مزايا مكونة من 40 صفحة مع ثلاثة تعديلات مثبتة في الخلف.
الطرق الست التي تفشل فيها النماذج باستمرار
تُرجع الورقة البحثية معظم حالات الفشل إلى مجموعة صغيرة ومعروفة من أنماط الخسارة، وهذا هو الجزء الأكثر فائدة لأي شخص يعمل بهذه الأدوات يومياً:
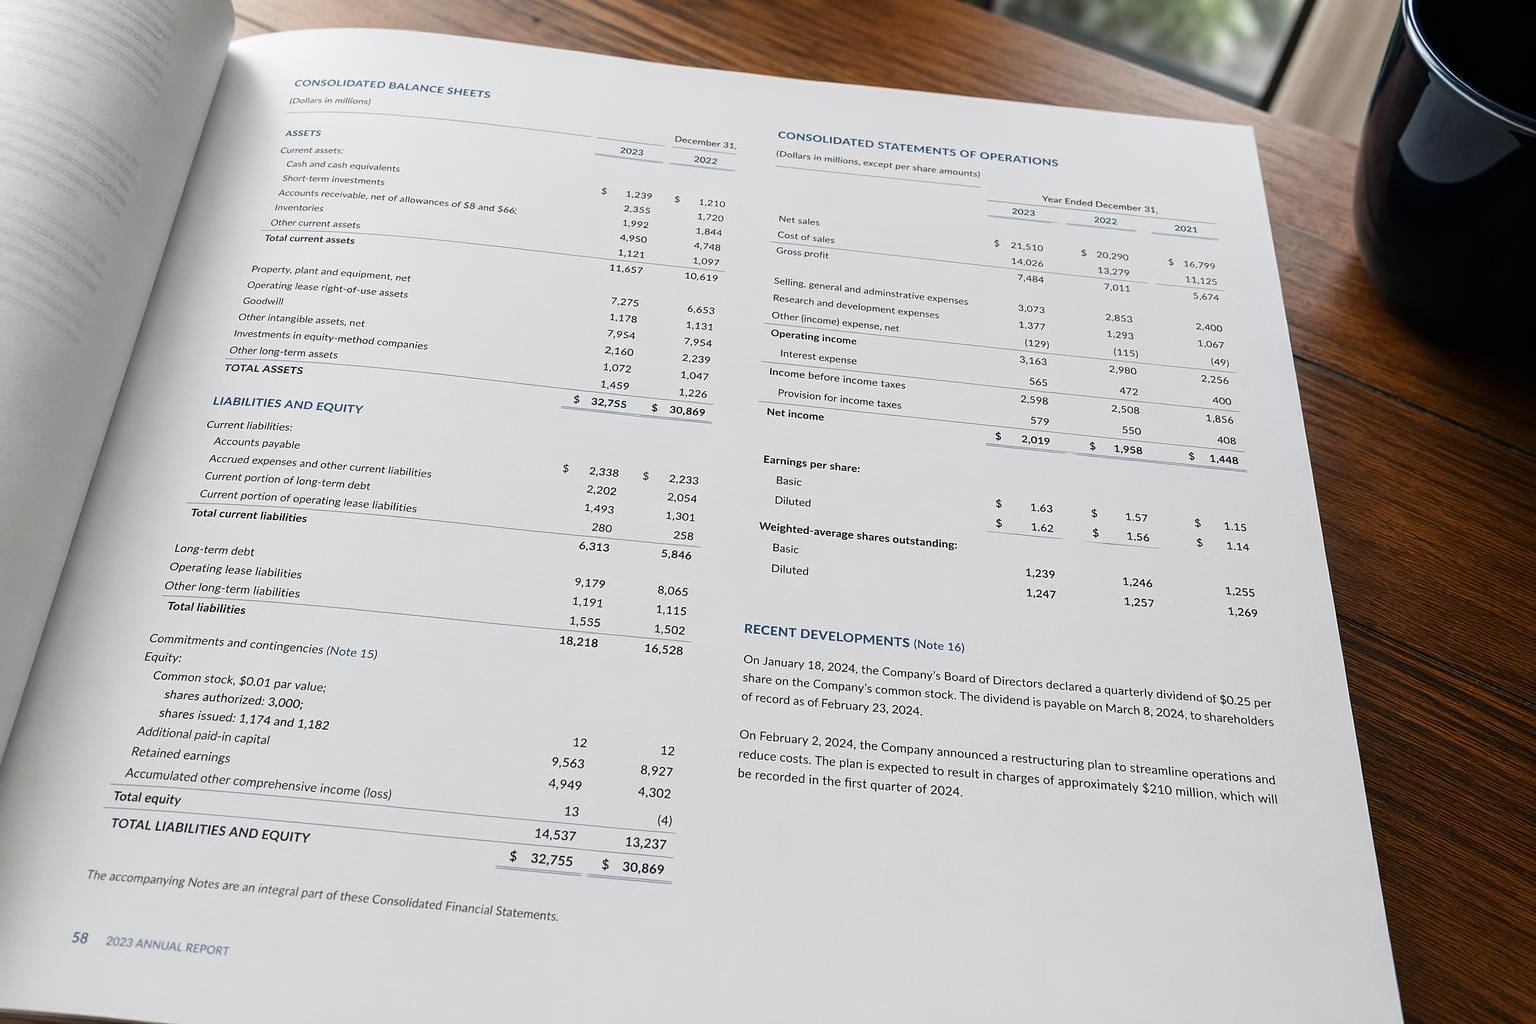
- جداول غير مواءمة. يقرأ النموذج قيمة من الصف أو العمود الخطأ، خاصة عندما تمتد الجدول عبر كسر صفحة أو تحتوي على خلايا مدمجة.
- رسوم بيانية مقروءة بشكل خاطئ. يحصل النموذج على الشكل العام بشكل صحيح لكنه يقرأ قيمة محددة، أو تسمية محور، أو أي سلسلة تنتمي إليها نقطة البيانات بشكل خاطئ.
- تجاهل الهوامش والاستثناءات. يجد النموذج الرقم الرئيسي لكنه يفوت التحذير الذي يغيره، وهو فخ حزمة المزايا الكلاسيكي من المثال الافتتاحي.
- رموز مخططات الطوابق التي تم عدها بشكل خاطئ. في وثائق البناء والهندسة المعمارية، يقلل النموذج أو يزيد من عدد الرموز المتكررة (المآخذ، التركيبات، الأبواب) التي يحسبها الإنسان يدوياً.
- ضوضاء المسح الضوئي. الوثائق الواقعية ليست ملفات PDF نظيفة تم تصديرها من Word. إنها نسخ فوتوكوبية من نسخ فوتوكوبية، ونماذج فاكس، وصور هاتفية لوثائق مادية، وتدهور جودة الصورة يؤثر على دقة النموذج أكثر مما يفترض الناس.
- تعديلات تلغي السابقة. تقول وثيقة شيئاً واحداً في الصفحة 5 وتعديل في الصفحة 30 يغيره. تميل النماذج للإجابة من أي نسخة تصادفها أولاً بدلاً من حل التعارض.
لا شيء من هذه الحالات هو حالات حافة غريبة. إنها النسيج العادي للوثائق المهنية. عقد الإيجار يحتوي على ملاحق. ورقة البيانات تحتوي على سجل مراجعات. دليل سريري يحتوي على مذكرة تحديث. إذا لم يتضمن معيارك وثائق بهذا الشكل، فهو لا يقيس ما يحتاجه الناس فعلياً.
لماذا يهم ذلك أي شخص يبني أو يختار نظام OCR
إذا كنت تبني منتجًا يعتمد على تقنية التعرف الضوئي على الحروف (OCR) أو الذكاء الاصطناعي المستند إلى المستندات، أو تقوم بتقييم الموردين لاختيار أحدهم، فإن مجموعة بيانات GDP.pdf تمثل اختبارًا واقعيًا مفيدًا للمطالبات التسويقية. إن عبارة "أحدث التقنيات في مجال الإجابة على أسئلة المستندات" وعبارة "يمكن الإجابة على سؤال حقيقي حول وثيقة سياسة مكونة من 40 صفحة تتضمن حاشية تغير الإجابة" هما ادعاءان مختلفان، ويظهر هذا البحث أن الفجوة بينهما هائلة وليست هامشية. ومن الجدير بالذكر أن طبيعة النص العربي، مع خطه المتصل واتجاهه من اليمين إلى اليسار وأشكال الحروف الحساسة للسياق، تضيف طبقة إضافية من التعقيد تحديداً في هذه السيناريوهات المعقدة.
الخلاصات العملية:
- لا تثق في معايير الأداء الخاصة بقدرة واحدة كبديل للموثوقية الشاملة. قد تتصدر نموذج ما قائمة تصنيفات الأسئلة والأجوبة الخاصة بالجداول، ومع ذلك قد يفوت الحاشية التي تلغي ما ورد في الجدول. إذا اقتبس مورد ما فقط درجات مهارات معزولة، اسأل عما يحدث عندما يجب على هذه المهارات أن تتكامل معًا.
- إعادة المحاولة باستخدام نماذج متعددة تستحق جهودها هنا. نظرًا لأن أنماط الفشل غير متسقة عبر النماذج (جداول غير محاذاة لأحدها، وتعديلات مفوتة لآخر)، فإن توجيه نفس المستند إلى محرك ثانٍ أو ثالث عندما تبدو الإجابة الأولى غير مؤكدة ليست رفاهية، بل هي شبه ضرورية لأي شيء له مخاطر حقيقية مرتبطة به.
- الامتناع عن الإجابة ميزة يجب اختبارها، وليس افتراضها. قبل أن تثق بإجابة النموذج حول مستند، تحقق مما إذا كان سيذكر فعليًا "غير موجود في هذا المستند" عندما لا تكون الإجابة موجودة، بدلاً من اختلاق إجابة بثقة. يوجد مستوى الامتناع في GDP.pdf لأن هذه نقطة ضعف حاليًا على نطاق واسع.
- عامل جودة المسح الضوئي كجزء من خط الأنابيب، وليس فكرة لاحقة. كان ضوضاء المسح الضوئي أحد أنماط الخسارة المتكررة الستة. إذا لم يقم خط أنابيب الاستيعاب لديك بتنظيف أو تحديد المسح الضوئي منخفض الجودة قبل وصوله إلى النموذج، فأنت ترث مصدر خطأ يمكنك التخلص منه جزئيًا من خلال الهندسة.
- خصص ميزانية للمراجعة البشرية لأي مستند يحتوي على تعديل، استثناء، أو سجل مراجعات. هذه هي بالضبط المستندات التي تفشل فيها النماذج الحالية أكثر من غيرها، وهي بالضبط المستندات التي من المرجح أن يكلف الإجابة الخاطئة فيها شخصًا ما مالًا أو تغطية صحية.
ما لا يخبرك به هذا المعيار
بعض التحفظات الصادقة. مئة سؤال يُعدّ معياراً صغيراً. إنه كافٍ لإثبات نقطة قوية حول طبيعة الفشل (ستة أنماط متكررة عبر عشر مجالات مهنية تُشكّل إشارة ذات معنى)، لكنه غير كافٍ لمنحك نسبة مئوية دقيقة ومستقرة يمكنك اقتباسها كـ "رقم الدقة" النموذجي لأي نموذج معين في هذه الفئة من المهام. المعايير الصغيرة أيضاً أكثر حساسية للوثائق والأسئلة المحددة التي تم اختيارها، حتى مع وجود فلتر "فشل نموذجين".
قاعدة اختيار "فشل نموذجين" ذكية لإبراز الأسئلة الصعبة والمعنى حقاً، لكنها تعني أيضاً أن المعيار مُصمم صراحةً ليكون صعباً على نماذج اليوم. هذه هي الفكرة، لكنها تعني أن أرقام 15%/1% تصف الحد الأقصى للأسئلة المختارة خصيصاً لاختبار النموذج، وليس عينة عشوائية من "الأسئلة التي يطرحها المحترفون عادةً". دقة العالم الحقيقي على المزيج الكامل من الأسئلة السهلة والصعبة التي يطرحها مسؤول المزايا أو مهندس تقدير التكاليف يومياً ستكون أعلى من 15%، لكنها لن تكون عالية كما توحي الحملات التسويقية عادةً.
وسبعة نماذج، تم تقييمها مرة واحدة، على مئة عنصر، هي لقطة سريعة وليست خط اتجاه. النماذج تتحرك بسرعة، ومن المرجح أن يرتفع هذا الحد الأقصى المحدد بنسبة 15%. ما هو أكثر استدامة هو التصنيف: الأحد عشر كفاءة والأنماط الستة للفشل تُشكّل قائمة مراجعة مفيدة حقاً لتقييم أي نظام ذكاء اصطناعي للوثائق، سواء كان نموذج اليوم أو العام المقبل، لأنها تصف الفجوات الهيكلية في كيفية تعامل هذه النماذج مع الاستدلال متعدد الأجزاء والمؤسس على الواقع في التعامل مع الأوراق الحقيقية، وليس مجرد لوحة نتائج ستصبح قديمة خلال ستة أشهر.
الملخص الصادق: ملفات PDF المهنية أكثر صعوبة مما جعلت المعايير تبدو عليه، وقد كان القطاع يصنف الأداء على المحور الخاطئ، وGDP.pdf هو محاولة أولى صلبة لتصنيف الأداء على المحور الصحيح.