الذكاء الاصطناعي الذي يقرأ المخططات الهندسية كمهندس وليس كماسح ضوئي
استنادًا إلى: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
في مكان ما داخل مصنع للصناعات التحويلية الآن، يوجد خزانة ملفات مليئة برسميات لأجزاء لم يعد بإمكان أحد طلبها. دعامة من عام 1994، تم قياسها يدوياً، وتم نسخها بالفاكس مرات عديدة لدرجة أن الخطوط أصبحت ضبابية. الشركة التي صنعت الجزء الأصلي قد اختفت. المهندس الذي رسمه تقاعد منذ عقد من الزمان. لكن عميلاً ما لا يزال بحاجة إلى تلك الدعامة بالضبط، والسجل الوحيد لها هو ورقة مسطحة.
لصنع ذلك الجزء على آلة CNC حديثة أو طابعة ثلاثية الأبعاد، يجب على شخص ما تحويل الرسم مرة أخرى إلى نموذج ثلاثي الأبعاد حي ومعاملات: ليس صورة للجزء، بل مجموعة من التعليمات التي يمكن للحاسوب تغيير حجمها، وتعديلها، وتشغيلها. اليوم، يعني ذلك أن تقني CAD يجلس ويعيد رسم كل شيء يدوياً، قارئاً كل بعد من الورقة وإعادة إدخاله في البرنامج. العملية بطيئة، ومكلفة، وهي بالضبط النوع من المهام الذي ينبغي لنظام ذكاء اصطناعي جيد أن يساعد فيه.
تسعى ورقة بحثية جديدة بعنوان Drawing-Recode، من الباحثين Mingi Kim وYongjun Kim وHyungki Kim، إلى أتمتة تلك السلسلة: أدخل رسمًا ثنائي الأبعاد ممسوحًا ضوئيًا، واحصل على كود CAD قابل للتشغيل. ما يجعلها مثيرة للاهتمام ليس فقط محاولتها لهذا الأمر. بل المشكلة المحددة التي يحددها المؤلفون على أنها الاختناق الحقيقي، وهي مشكلة يتجاهلها معظم الأنظمة المجاورة لـ OCR بصمت.
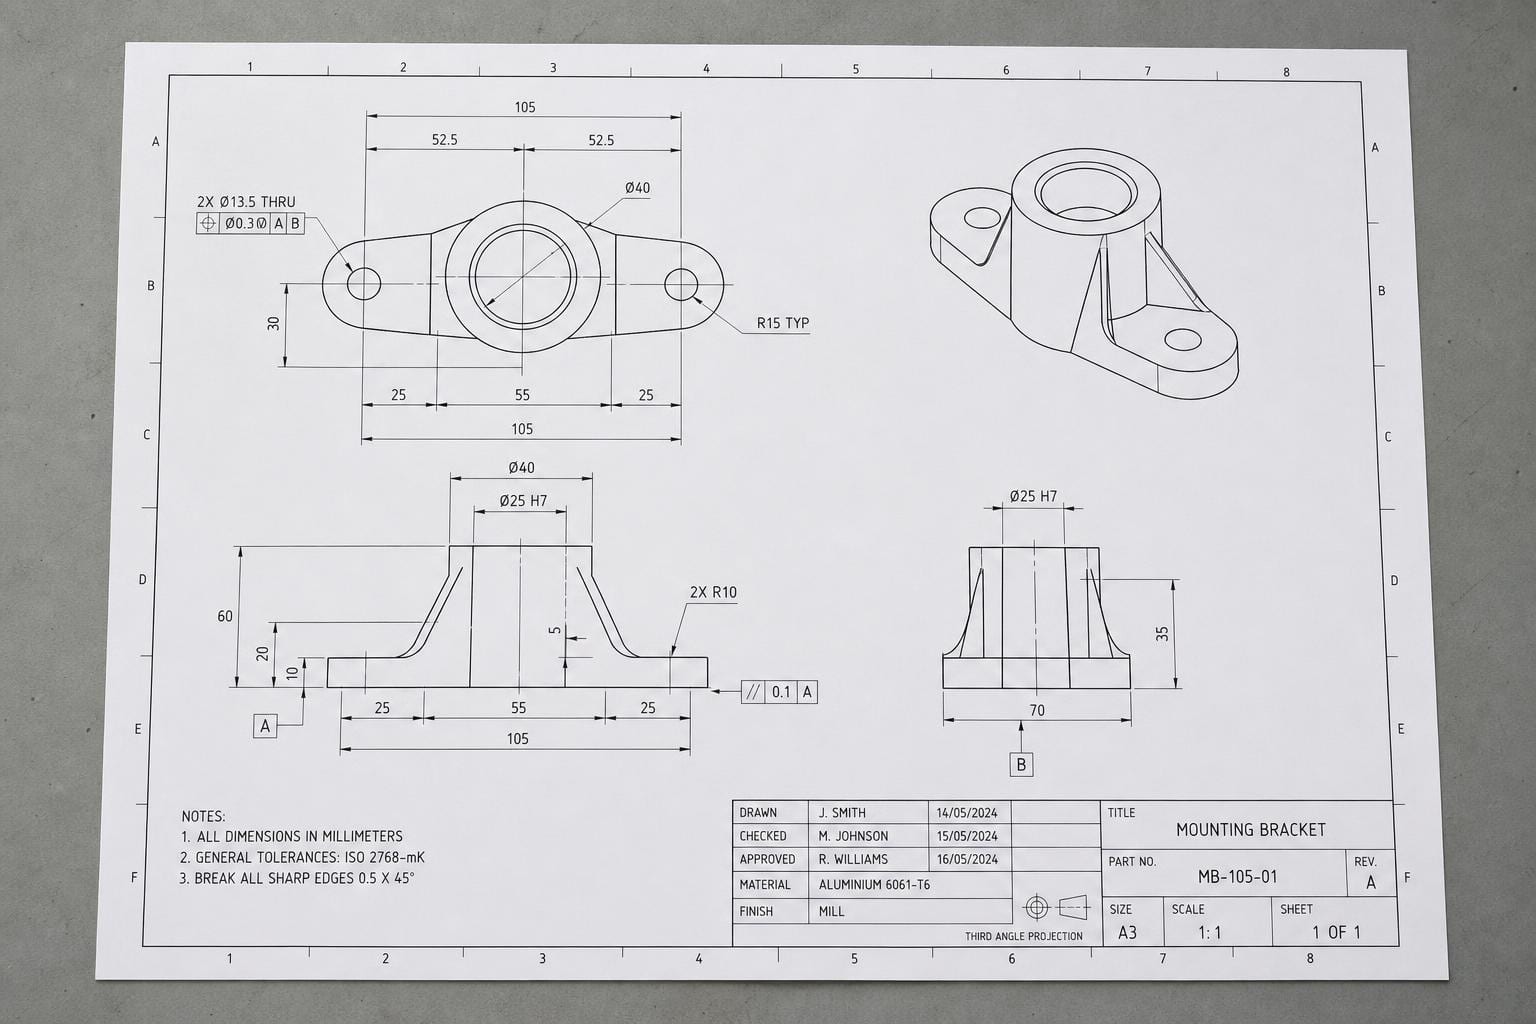
الفجوة بين قراءة رقم وفهم ما يقيسه
ابدأ بتمييز مهم هنا: الصور النقطية (Raster) مقابل الصور المتجهة (Vector). ملف CAD متجه (مثل ملف DXF أو ملف SolidWorks الأصلي، على سبيل المثال) يخزن الهندسة كبيانات منظمة: هذه الخطوط تمتد من النقطة أ إلى النقطة ب، هذا الدائرة لها هذا نصف القطر. صورة نقطية هي مجرد بكسلات. مخطط ممسوح ضوئيًا، صورة فوتوغرافية لمخطط هندسي، ملف PDF هو في الواقع صورة تحت الغطاء، كل هذه هي صور نقطية. لا توجد أي هيكلية فيها على الإطلاق، مجرد نقاط ملونة تبدو للعين البشرية كخطوط ونصوص.
قراءة النص من مخطط CAD نقطي هي مشكلة محلولة إلى حد ما. يمكن لـ OCR استخراج "Ø25" أو "50.5" من الصفحة بشكل معقول، بما في ذلك رموز الأبعاد. هذا ليس ما يدور حوله Drawing-Recode حقًا.
المشكلة الأصعب هي هذه: بمجرد قراءة "50.5" من الصفحة، إلى ماذا ينتمي؟ مخطط CAD ليس نموذجًا به حقول موسومة. إنه صورة لجزء، مع مجموعة من خطوط الأبعاد والأرقام تشير إلى حواف وثقوب وأسطح محددة. "50.5" قريب من مستطيل قد يصف عرضه، لكنه قد يصف القطر، أو تباعد الثقوب، أو شيء على بعد ثلاث خطوط حيث يعبر خط الامتداد فقط. إذا أخطأت في هذه الصلة، فلن تحصل على جزء مختلف قليلاً. ستحصل على جزء خاطئ هيكليًا، لأن نموذج CAD المعاملات هو سلسلة من العمليات (ارسم هذا المستطيل، امدده بهذه المسافة، قطع هذا الثقب) حيث يعتمد كل خطوة على أن الأرقام مرتبطة بالهندسة الصحيحة.
إطار الورقة هو أن الأنظمة السابقة إما تعمل فقط على المخططات المتجهة (التي تحتوي بالفعل على هذه الهيكلية مدمجة، لذا لا يوجد شيء لحل) أو ضيقة، مبنية لنوع واحد من المخططات أو صناعة واحدة، ولا يربط أي منها بشكل صريح التعليق بالهندسة التي يصفها. يعاملون التعرف على النص والتعرف على الهندسة كمهام منفصلة ويأملون أن يتم حل الصلة لاحقًا. عادة لا يحدث ذلك.
كيف يربط Drawing-Recode رقماً بالخط الذي يقيسه
تتكون البنية من عدة أجزاء متميزة، والأكثر إثارة للاهتمام هو الجزء الأوسط.
أولاً، يقوم مُشفِّر الصور (image encoder) بفحص الرسم النقطي واستخراج السمات الهندسية: وهو ما يمثل في الأساس تمثيلاً داخلياً غنياً للخطوط والمنحنيات والأشكال الموجودة على الصفحة، بشكل مستقل عن أي نص. وبشكل منفصل، تقرأ وحدة التعرف على النصوص التعليقات: الأرقام البعدية، والتسامحات، والتسميات المبعثرة عبر الرسم. حتى هذه النقطة، الأمر يمثل الذكاء الاصطناعي المعياري للمستندات، حيث يعمل قارآن متخصصان بالتوازي.
المساهمة الحقيقية تكمن في ما يحدث بعد ذلك. يستخدم Drawing-Recode الانتباه المتقاطع (cross-attention)، وهو آلية تتيح لمجموعة من السمات "النظر" إلى مجموعة أخرى والقرّر بما هو ذي صلة، لربط كل تعليق معترف به بالسمات الهندسية المحددة التي يصفها. فكّر في الأمر على أنه نموذج يتعلم رسم خطوط الامتداد الخاصة به: عند تقديم النص "50.5"، يتعلم النموذج البحث في التمثيل الهندسي عن الحافة التي يقيسها هذا الرقم على الأرجح، بنفس الطريقة التي تتبع بها العين البشرية خط البعد من الرقم عائداً إلى مخطط الجزء.
ولجعل هذا الربط موثوقاً بدلاً من أن يكون تقديرياً، يضيف المؤلفون ما يسمونه خسارة ترسيخ التعليقات (Annotation Grounding Loss - AGL). "الخسارة" في تعلم الآلة هي ببساطة العقوبة التي يتلقاها النموذج أثناء التدريب عندما يكون مخرجه خاطئاً، وهي الإشارة التي يستخدمها للتحسن. قد يعاقب إعداد التدريب النموذجي النموذج فقط على الخطأ في كود CAD النهائي. تضيف AGL عقوبة إضافية وصريحة للخطأ في ربط التعليق بالهندسة، حتى قبل الوصول إلى المخرج النهائي. هذا اختيار تصميمي متعمد: بدلاً من الأمل في أن يظهر الترسيح الصحيح كنتيجة جانبية لتوليد الكود الجيد، يدربون النموذج على الحصول على الترسيح الصحيح بمفرده.
بمجرد دمج الهندسة، والنص المعترف به، والروابط المترسحة بينهما في مجموعة سمات واحدة، يتم إدخالها إلى نموذج لغوي كبير (LLM)، وهو نفس عائلة النماذج الكامنة وراء أدوات مثل ChatGPT، ولكن مُعد هنا لتوليد الكود بدلاً من النثر. المخرج ليس صورة أو مجموعة من الإحداثيات. بل هو كود CAD بما يسميه المؤلفون تنسيق كود CAD المعلمي المهيكلي (Structured Parametric CAD Code - SPCC): وهو تسلسل من العمليات مثل "ارسم هذا الملف، وسّعها 12 ملم، وثقب حفرة 6 ملم هنا" يمكن لبرنامج CAD تنفيذها لإعادة بناء النموذج ثلاثي الأبعاد الفعلي، قابل للتحرير بالكامل، وليس مجرد شكل ثابت.
ما وجدوه، والجزء الذي يهم حقاً للاستخدام الواقعي
تُفيد الورقة البحثية بأن Drawing-Recode يتفوق على طرق الأساس (baseline) الحالية في استعادة تسلسلات CAD البارامترية الصحيحة من الرسومات النقطية (raster). وهذا أمر متوقع. فأي طريقة جديدة تُطرح في ورقة بحثية يجب أن تتفوق على ما سبقها، وإلا فلا داعي للنشر.
لكن النتيجة الأكثر دلالة هي الادعاء الثاني: النظام يحافظ على متانته مع الرسومات الممسوحة ضوئياً التي تحاكي الظروف الصناعية الحقيقية. يستحق هذا الأمر التأمل، لأنه يمثل الفرق بين عرض توضيحي وأداة عملية. فالتصورات عالية الدقة والنظيفة من CAD هي الحالة السهلة. أما الرسومات الواقعية، تلك الموجودة في خزانة الملفات، فهي نسخ فوتوكوبية لنسخ أخرى، باهتة، ومائلة قليلاً، ومغطاة بحلقات قهوة وعلامات قلم رصاص يجب على الذكاء الاصطناعي تجاوزها. فالنظام الذي يعمل بشكل جيد فقط مع المدخلات السليمة يحل مشكلة لا يواجهها أحد فعلياً. صمم المؤلفون نظامهم واختبروه خصيصاً ضد المسحات المتدهورة، مما يشير إلى فهمهم لأن الحالة النظيفة في المختبر لم تكن هي الهدف الأساسي.
ومع ذلك، فإن الملخص لا يقدم الأرقام الصعبة، ونسب الدقة، ومقارنات الأساس الدقيقة، وأحجام مجموعات البيانات، لذا تعامل مع عبارات "يتفوق" و"يحافظ على متانته" كادعاءات اتجاهية مدعومة بتجارب، وليس كجدول نتائج يمكنك الاستشهاد به مباشرة. إذا كنت تقرر البناء على هذا العمل، فإن الآلية (التأريض الصريح عبر الانتباه المتقاطع وخسارة مخصصة) هي الفكرة القابلة للنقل، أكثر من أي رقم محدد في هذه الورقة المبكرة.
لماذا يهم ذلك أي شخص يبني أو يختار نظام التعرف الضوئي على الحروف (OCR)
عندما ننتقل من نطاق رسومات CAD المحدد إلى الصورة الأكبر، نجد درساً ينطبق على معالجة المستندات بالذكاء الاصطناعي بشكل عام، وهو مجال يقع تماماً ضمن اختصاص OpenOCR.
فكمية هائلة من معالجة المستندات في العالم الحقيقي لا تقتصر على "قراءة النص"، بل تكمن في "تحديد النص الذي ينتمي إلى أي عنصر". فعلى سبيل المثال، يجب ربط بند في فاتورة بالرمز التعريفي (SKU) والمجموع الصحيحين. ويجب ربط خانة الاختيار في نموذج طبي بالتسمية المجاورة لها، وليس بالتسمية الموجودة في الصفوف الثلاثة السابقة. كما يجب ربط علامة الهامش في بيان مالي بالرقم الذي يشرحه. في كل هذه الحالات، يمنحك نظام OCR التقليدي الأحرف ولكنه يفشل تماماً في استخلاص العلاقات بينها. وغالباً ما تكمن القيمة الحقيقية في هذه العلاقات.
يُعد Drawing-Recode دراسة حالة واضحة لحل مشكلة العلاقات عمداً، بدلاً من الاعتماد على أمل أن يتعلم نموذج كبير هذه العلاقات بالصدفة. إن الخيار التصميمي الصريح، المتمثل في دالة خسارة مخصصة فقط للتأريض (grounding)، واهتمام متقاطع (cross-attention) مُجبر معمارياً على ربط النمطين، هو الجانب الذي يستحق التذكر حتى لو لم تتعامل أبداً مع رسومات CAD. وعندما تكون تقيّم محرك OCR أو ذكاء اصطناعي للمستندات لمهمة تتضمن تعليقات أو تسميات أو مراجع متقاطعة (وليس مجرد نص متتابع)، اسأل المزود عما إذا كان نظامهم يحدد هذه الروابط صراحةً، أم أنه يستخرج النص والهندسة بشكل منفصل ويترك لك مهمة ربطها معاً. وغالباً ما تكمن مشاكل الدقة في الفجوة بين هاتين الطريقتين.
بالنسبة لمستخدمي OpenOCR تحديداً، يشير هذا أيضاً إلى فئة تستحق المراقبة: المحركات المبنية لمهمة ضيقة ولكن عميقة، مثل رقمنة الأجزاء، تميل إلى التفوق على أنظمة OCR العامة في تلك المهمة، حتى عندما يمتلك النظام العام ميزانية تدريب أكبر. وإذا كنت تقوم برقمنة الأرشيف الهندسي، فإن الخطوة الصحيحة على الأرجح ليست تشغيل محرك OCR عام وكتابة كود ربط مخصص للتخمين حول الأرقام التي تنتمي إلى أي خطوط. بل هو العثور على شيء أقرب إلى نهج Drawing-Recode، حيث يكون الربط جزءاً من النموذج نفسه، وليس فكرة لاحقة تُضاف في مرحلة المعالجة اللاحقة. ومن الجدير بالذكر أن طبيعة خط عربي المتصل، مع أشكاله الحرفية الحساسة للسياق واتجاهه من اليمين إلى اليسار، تجعل التعرف الضوئي على الحروف أكثر تعقيداً، مما يعزز الحاجة إلى نماذج تفهم السياق والعلاقات بدلاً من مجرد استخراج الأحرف المعزولة.
أين لا يزال هذا النهج قصيراً
تبرز بعض الفجوات، بعضها مُقرّ به ضمن صياغة الورقة البحثية، والبعض الآخر متأصل في النهج كما وُصف.
النطاق يقتصر على الرسومات ثنائية الأبعاد لإنتاج متتابعات بارامترية ثلاثية الأبعاد للأجزاء الفردية، وليس للتجميعات الكاملة. أرشيف التصنيع الحقيقي لا يتكون فقط من رسومات أجزاء مفردة؛ بل يشمل رسومات تجميع تحتوي على أجزاء متعددة، وإشارات فرعية، ومراجع متقاطعة بين الصفحات (مثل "انظر التفصيل في الصفحة 3"). لا يشير الملخص إلى أن Drawing-Recode يتعامل مع هذه الحالة الأوسع حتى الآن.
وهناك أيضاً الخطر القياسي المصاحب لأي توليد أكواد قائم على نماذج اللغة الكبيرة (LLM): المخرجات السليمة لغوياً وهيكلياً لا تعني بالضرورة أنها صحيحة من حيث الأبعاد. قد تبدو متتالية SPCC المُولَّدة صحيحة، وتُنتج الشكل المناسب بالاتجاه الصحيح، ومع ذلك تكون مبنية على رقم مُساء قراءته أو قرار ربط (grounding) خاطئ قليلاً. بالنسبة لمنشور مدونة، هذا مجرد فضول تقني. أما بالنسبة لجزء مُصنَّع سيتم ربطه بمسامير في آلة، فهو الفرق بين قطعة بديلة تعمل بكفاءة وخطأ مكلف جداً. لا يصف الملخص أي خطوة تحقق لاحقة تتحقق من الكود المُولَّد مقابل التسامحات الفيزيائية، وهو نوع من الحواجز الوقائية التي يحتاجها هذا النظام قبل أن يُوجَّه نحو أجزاء الإنتاج دون إشراف.
ومثل معظم نماذج التعرف المتخصصة، تشكل جودة بيانات التدريب السقف الأقصى للأداء. نموذج مُعدّ بهذه الدقة لقراءة اصطلاحات التوثيق الخاصة بـ CAD يُفترض أنه مُدرَّب على بيانات خاصة بـ CAD، مما يعني أن أدائه مع أنماط الرسومات، أو اصطلاحات الرموز، أو الصناعات خارج نطاق توزيع التدريب يبقى سؤالاً مفتوحاً لا تدعي الورقة البحثية الإجابة عليه.
لا يقلل أي من ذلك من قيمة الفكرة الأساسية. ربط التوثيق صراحةً بالهندسة، بدلاً من معالجة التعرف على النص والتعرف على الشكل كوظيفتين منفصلتين يحدثان بالصدفة في وقت واحد، هو الحدس الصحيح، وهو نهج يمكن لمجال ذكاء المستندات (Document-AI) أن يستفيد من اقتباسه بشكل أكبر.