最上位のAIモデルでさえPDFで85%の失敗率を示すベンチマーク
元論文: GDP.pdf: Benchmarking Grounded Multimodal Reasoning over Professional PDF Documents — Suhaas Garre, Emily Ritchie, Sushant Mehta, Edwin Chen
文書理解の限界
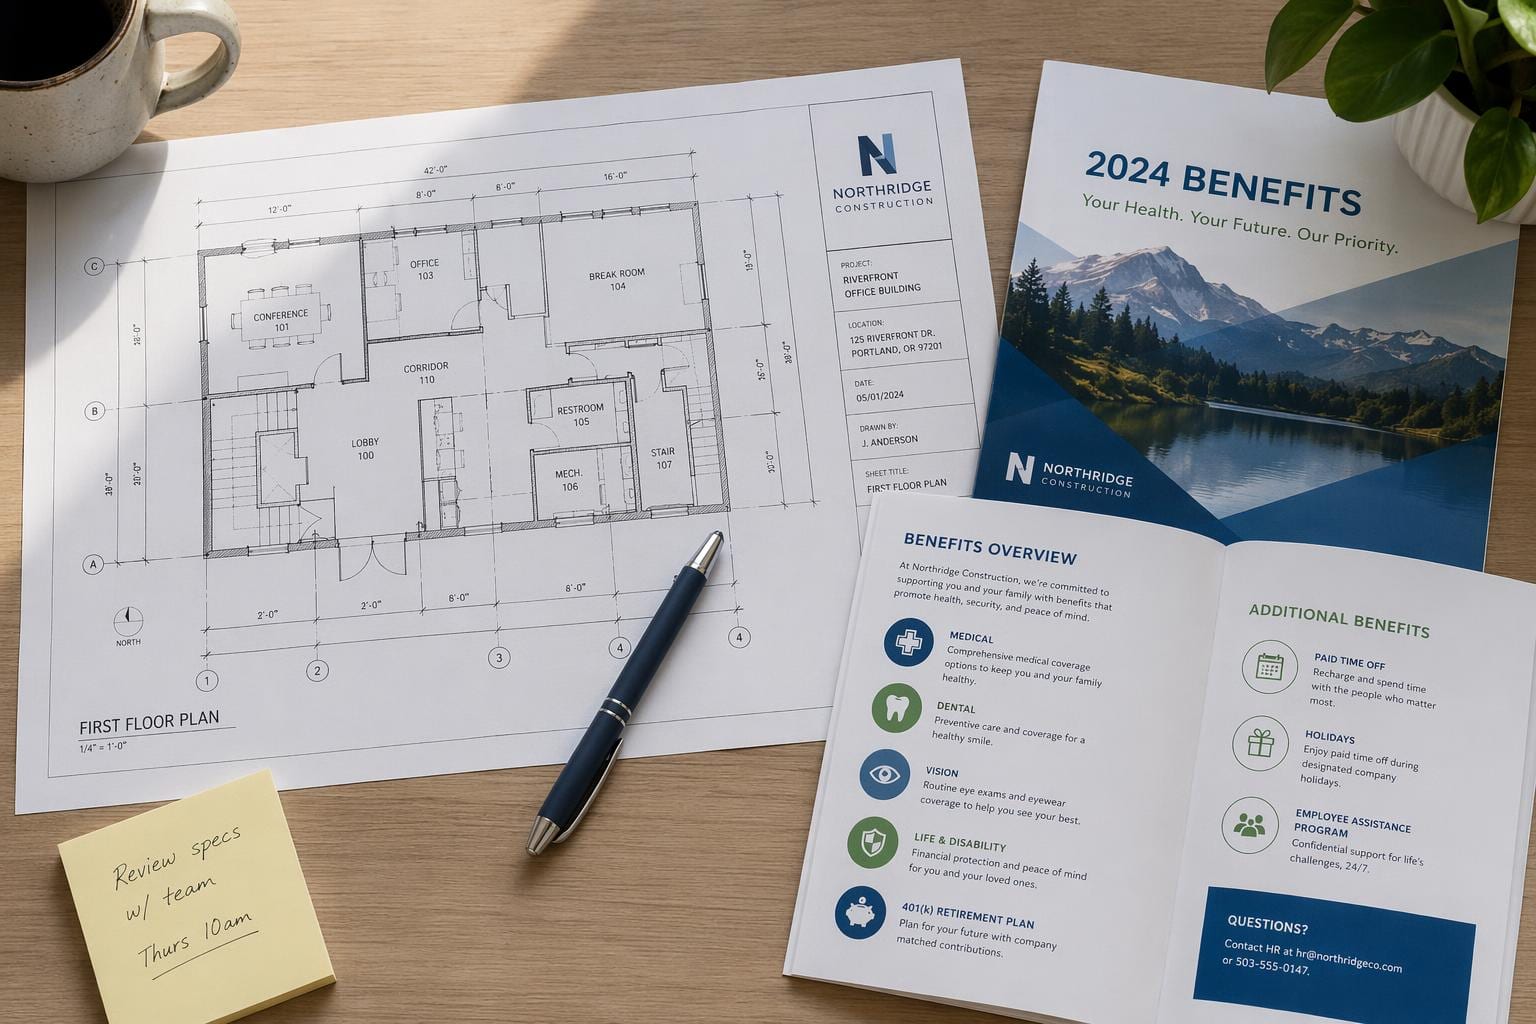
40ページに及ぶPDFを片方のモニターで開き、もう片方には従業員の質問が表示されているベネフィット管理者を想像してみてください。「PPOプランでネットワーク外の専門医を受診した場合、自己負担限度額(アウト・オブ・ポケット・キャップ)は免責金額(デダクタブル)を引いた後、実際にいくらになりますか?」答えは確かにその文書の中にあります。しかし、その情報は12ページの表、特定の専門医の受診を除外する14ページの脚注、そして12ページの数値を静かに上書きする38ページの改正条項にまたがって散在しています。ベネフィットのパケットの読み方が分かっている人なら、数分でその答えを見つけることができます。しかし、新しい論文『GDP.pdf』では、この種の質問を7つの最先端マルチモーダルモデルに投げかけました。最も優秀なモデルでさえ、ベンチマークの100問中15問(15%)しか正解できませんでした。最悪のモデルはわずか1%でした。
これは、モデルがほぼ解決に近づき、最後の数ポイントを引き出そうとしているようなベンチマークではありません。これは、この分野がまだ盤上の駒を置く段階にすら至っていないことを示すベンチマークです。その理由を理解することは重要です。なぜなら、それは「AIは現在、文書を読むことができる」という測定方法について、我々が直面すべき不都合な真実を語っているからです。
なぜあなたのOCRベンチマークは嘘をついているのか
多くのドキュメントAIベンチマークは、一度に一つのスキルしかテストしません。スキャンされたページからテキストを読み取るためのベンチマーク(OCR)、ページ上の要素の位置を理解するためのベンチマーク(レイアウト解析)、棒グラフから値を読み取るためのベンチマーク(チャート推論)、表に関する質問に答えるためのベンチマーク(テーブルQA)、そして「このドキュメントを見て質問に答えよ」という一般的なタスクのためのベンチマーク(ドキュメントVQA)があります。
モデルはこれら5つのスキルを個別に高いスコアを出しながらも、実際のプロフェッショナルが本当に必要としていること、つまり特定のmessyな現実世界のPDFを開き、それについて特定の重要な質問に答えることでは失敗することがあります。GDP.pdfの著者は、論文の枠組みの中で明確に述べています。いかなる一つの孤立した能力で高いスコアを出しても、それが現実的なドキュメントに関する現実的な質問を処理できるかどうかは示しません。表を正しく読んでも、3ページ後の脚注が半数の行を除外していることに気づかなければ意味がありません。チャートを正しく読んでも、チャートが実際に何を測定しているかを説明する段落とクロスリファレンスしなければ意味がありません。
これはOCRベンダーが何年も前から直面してきた罠と同じです。クリーンで独立した請求書を完璧に処理できるエンジンでも、その請求書がコーヒーのシミのついたコピーの漏洩写真であったり、複数ページにわたってフッターで続いたり、途中で列がずれた表を含んでいたりすると、すぐに機能しなくなります。孤立したスキルのベンチマークはクリーンなケースを測定します。しかし、実際の仕事はmessyなケースで行われます。
偽造が難しいベンチマークを構築する方法
GDP.pdfの真の工夫は、ドキュメントそのものではなく、どの質問を含める価値があるかを決定するために使用されたフィルタリング手法にあります。
チームは10の分野にわたる現役の専門家を募集しました。彼らは実際の職務の一環として、福利厚生パッケージ、賃貸契約書、データシート、臨床ガイドライン、建築図面などを扱っている実務者です。これらの専門家が、各自の専門分野における実際のドキュメントに基づいて質問を作成しました。しかし、難しそうな質問を書くことと、能力のあるモデルと能力のないモデルを明確に区別できる質問を書くことは同じではありません。そこで、チームは「ゲート(選別基準)」を追加しました。候補となる質問が最終的なベンチマークに含まれるためには、少なくとも2つの最先端マルチモーダルモデルが、実質的に意味のある方法でその質問に失敗する必要があります。これは、表現の微妙な違いといったスタイル上の問題ではありません。誤答、回答を変更すべき証拠の見落とし、またはドキュメントが支持していない捏造された主張といった、本質的な失敗を指します。
この「2つのモデルが失敗する」というルールは、一見する以上に重要です。これは、ベンチマーク内のすべての質問が、特定のかつ意味のある方法で現在のAIシステムを混乱させることが、経験的に証明済みであることを意味します。ベンチマークには、すべてのモデルが正解して単にスコアを膨らませるだけの「おまけ」や「簡単な質問」は一切含まれていません。100個のアイテムのそれぞれは、まず少なくとも2つの強力なモデルを凌駕したからこそ、そこに存在しています。
また、評価は単純な「合格・不合格」ではありません。各質問には、回答が満たすべき小さく検証可能な要件からなるアトミックな基準(ルーブリック)が添えられており、論文では2つの異なる数値を報告しています。1つは部分的な正解にも点数を与える「ルーブリック採点スコア」、もう1つはモデルが全体を完全に正解したかどうかを示す「厳格なタスクレベルの合格率」です。さらに、各アイテムは3つの階層にわたる11の能力分類体系に基づいてタグ付けされており、テキストの抽出とグラウンディング(正しい箇所を見つけ、正確に引用できるか)、表とグラフの理解、ページ間の相互参照、空間推論(ページ上での要素の相対的な位置関係)、そして「保留(アブステンション)」(ドキュメントが回答を支持していない場合に、推測するのではなくその旨を伝えることができるか)などがカバーされています。
この「保留(アブステンション)」の要素は、特に注目すべき点です。多くのドキュメントAIの評価は、正解が存在する場合にモデルが正解を得られるかどうかのみを検証します。一方、GDP.pdfは、ドキュメントに情報が実際に含まれていない場合に、モデルが回答を捏造するかどうかをチェックします。これは、プロフェッショナルな環境において、より危険な失敗モードであると言えます。モデルが「このドキュメントではそれが見つかりません」と答えることで誰かが危害を受けることはありません。しかし、福利厚生の計算や賃貸契約の条項において、自信に満ちた誤った数値や情報が提供されることで、人々は危害を受けます。
数字が示す深刻な現実
最も注目すべき結果は明白です。7つの最先端モデルの中で、最も性能の高いモデルでさえ、厳格なタスクレベルの指標において100問中わずか15%に合格しました。最も低いモデルの合格率は1%でした。文書理解において人間に近い性能を2年間主張し続けてきた分野にとって、実際の専門家が作成した実際の専門文書に関する質問で15%という天井があるという事実は、容易に説明できる数字ではありません。
このギャップが何を意味するかを深く考える価値があります。これは、従来の意味でのOCR(光学文字認識)で失敗しているわけではありません。モデルはページ上のテキストを概ね正しく読み取ることができます。問題なのは、その上に構築された推論層での失敗です。例えば、表の数値と脚注の但し書きを結びつけたり、後発の修正条項が先発の条項を優越することを認識したり、フロアプランの記号を正しくカウントしたり、グラフの軸が初見で思われる意味とは異なることに気づいたりする能力です。実際の専門的なPDFが機能するのはまさにこの層であり、一般的なマルチモーダルモデルはこの層を適切に処理するように訓練されていません。なぜなら、大多数の訓練データや評価データは、裏に3つの修正条項が綴じられた40ページに及ぶ福利厚生パッケージのようなものではないからです。
モデルが失敗し続ける6つのパターン
この論文では、大部分の失敗がかなり限定的で認識しやすい損失パターンに起因していることを追跡しており、これはこれらのツールを日常的に活用する人々にとって最も有用な部分です:
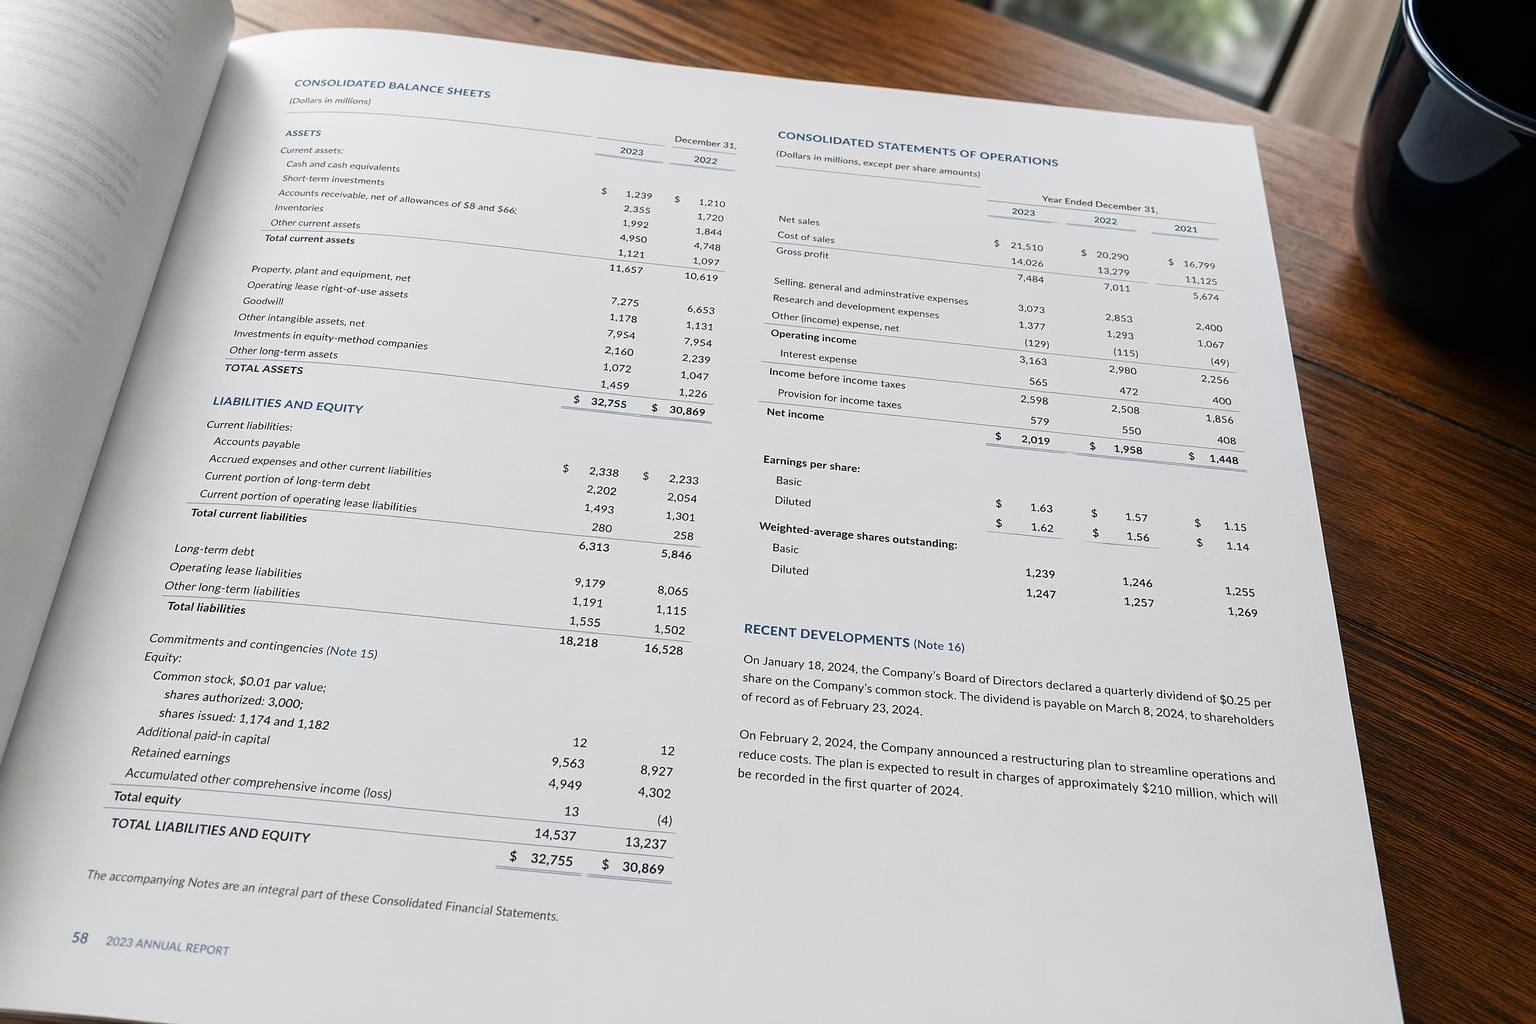
- テーブルの不一致。 モデルが、特にテーブルがページ区切りを跨いでいる場合やセルが結合されている場合に、誤った行や列から値を読み取ります。
- チャートの誤読。 モデルは全体像は正しく捉えていても、特定の値、軸ラベル、またはデータポイントがどの系列に属するかを誤って読み取ります。
- 脚注や除外事項のスキップ。 モデルは目立つ数値を見つけますが、その数値を変更する注意書きを見逃します。冒頭の例で示された典型的な「福利厚生パッケージの罠」です。
- フロアプラン記号の誤カウント。 建築や設計図面において、モデルは人間が手作業で数えるような反復される記号(コンセント、設備、ドア)を過少または過大にカウントします。
- スキャンノイズ。 現実世界の文書は、WordからエクスポートされたクリーンなPDFではありません。それらはコピーのさらにコピー、ファクスされたフォーム、物理的文書のスマートフォン写真であり、画像品質は人々が想定する以上にモデルの精度を低下させます。
- 改正による上書き。 文書が5ページ目に一つのことを述べ、30ページ目の改正でそれを変更します。モデルは、衝突を解決するのではなく、最初に遭遇したバージョンから回答する傾向があります。
これらはどれも異例のエッジケースではありません。これらは専門的な書類の一般的な性質です。賃貸契約には付録があります。データシートには改訂履歴があります。臨床ガイドラインには更新メモがあります。ベンチマークにこのような形状の文書が含まれていない場合、それは人々が実際に必要とするものを測定していません。
OCRの構築・選定においてなぜ重要なのか
OCRやドキュメントAIを基盤としたプロダクトを構築している場合、あるいはベンダーを選定・評価している場合、GDP.pdfはマーケティングの謳い文句に対する現実的なチェックポイントとして有用です。「ドキュメントVQA(視覚的質問応答)で最先端である」と、「脚注が答えを変更する、実際の40ページに及ぶ保険約款に関する実務的な質問に回答できる」という主張は全く異なり、この論文はその間のギャップが僅かなものではなく、極めて巨大であることを示しています。
実務的な教訓は以下の通りです:
- 単一能力ベンチマークをエンドツーエンドの信頼性の代用として信用しないこと。 テーブルQAのリーダーボードで首位のモデルであっても、テーブルを無効にする脚注を見逃す可能性があります。ベンダーが孤立したスキルスコアのみを提示する場合は、複数のスキルが組み合わさった際にどうなるかを問い質すべきです。
- マルチモデルによる再試行は、ここでその価値を証明します。 モデル間の失敗モードは不整合であるため(あるモデルではテーブルの位置合わせがずれる、別のモデルでは改正条項を見逃すなど)、最初の回答が不確かな場合に同じドキュメントを第2または第3のエンジンにルーティングすることは、贅沢ではなく、実務的な利害が関わるあらゆる場面でほぼ必須と言えます。
- 回答拒否(Abstention)は、前提としてではなくテストすべき機能である。 モデルの回答を信頼する前に、答えが存在しない場合に「このドキュメントには記載されていません」と実際に答えるかどうかを確認してください。自信満々に誤った回答を捏造するのではなく、です。GDP.pdfには回答拒否の階層が存在しますが、これは現在、業界全体においてこの点が弱点であるためです。
- スキャン品質をパイプラインの一部として扱い、後回しにしないこと。 スキャンノイズは6つの再発する損失パターンの一つでした。取り込みパイプラインがモデルに到達する前に低品質なスキャンをクリーンアップしたりフラグを立てたりしない場合、部分的に工学的に排除できたはずのエラー源を引き継ぐことになります。
- 改正、除外事項、改訂履歴のあるドキュメントについては、人間のレビュー予算を確保すること。 これらは現在のモデルが最も失敗しやすいドキュメントであり、同時に誤答が誰かに金銭的損失や健康保険の適用拒否をもたらす可能性が最も高いドキュメントです。
特に日本語の文書処理においては、漢字と仮名が混在し、縦書きレイアウトが一般的であることがOCRおよびVLMモデルにとって最も困難なケースの一つとなります。もし対象の論文やモデルが英語のみを対象としており、縦書きテキストを無視している場合、それは日本語読者にとって漢字の識別精度や縦組みレイアウトの解析能力がカバーされていないことを意味し、実務での適用には追加の検証や調整が必要であることを示唆しています。
このベンチマークが教えてくれないこと
いくつかの正直な留保事項を述べておきます。100問という規模は小さなベンチマークです。失敗の傾向(10の専門職分野にわたる6つの再発パターン)について強い主張を立てるには十分ですが、特定のモデルがこのタスククラスで「その」精度数値として引用すべき、正確で安定したパーセンテージを提供するには不十分です。2モデルの失敗フィルタが適用されていても、小さなベンチマークは、どの特定のドキュメントや質問が選択されたかにより敏感に影響を受けます。
2モデルの失敗に基づく選択ルールは、本質的に難しく意味のある質問を浮き彫りにする点では賢明ですが、同時にこのベンチマークは、今日のモデルにとって意図的に難しいものとして構成されていることを意味します。これが目的ですが、15%/1%という数値は、敵対的に選択された質問における上限を示しており、「専門家が日常的に尋ねる質問」のランダムなサンプルを表しているわけではありません。福利厚生管理者や建設見積もり担当者が日常的に尋ねる、簡単な質問から難しい質問までの全体混合に対する現実世界の精度は15%より高くなりますが、マーケティングが通常暗示するほど高くはありません。
また、7つのモデルを100項目に対して1回評価することは、トレンドラインではなくスナップショットです。モデルは急速に進化しており、この特定の15%という上限は上昇する可能性が高いです。より耐久性があるのは分類体系です:11の能力と6つの損失パターンは、これらのモデルが実際の書類に対して根拠のある多段階推論をどのように処理するかという構造的なギャップを記述しており、単に6ヶ月で陳腐化するスコアボードではないため、今日も来年もあらゆるドキュメントAIシステムを評価するための真に有用なチェックリストとなります。
率直なまとめ:専門的なPDFはベンチマークが示すよりも難しく、業界は誤った軸で評価を行ってきました。GDP.pdfは、正しい軸で評価を行うための確かな最初の試みです。