El punto de referencia donde el mejor modelo de IA sigue fallando el 85% de las veces en un PDF
Basado en: GDP.pdf: Benchmarking Grounded Multimodal Reasoning over Professional PDF Documents — Suhaas Garre, Emily Ritchie, Sushant Mehta, Edwin Chen
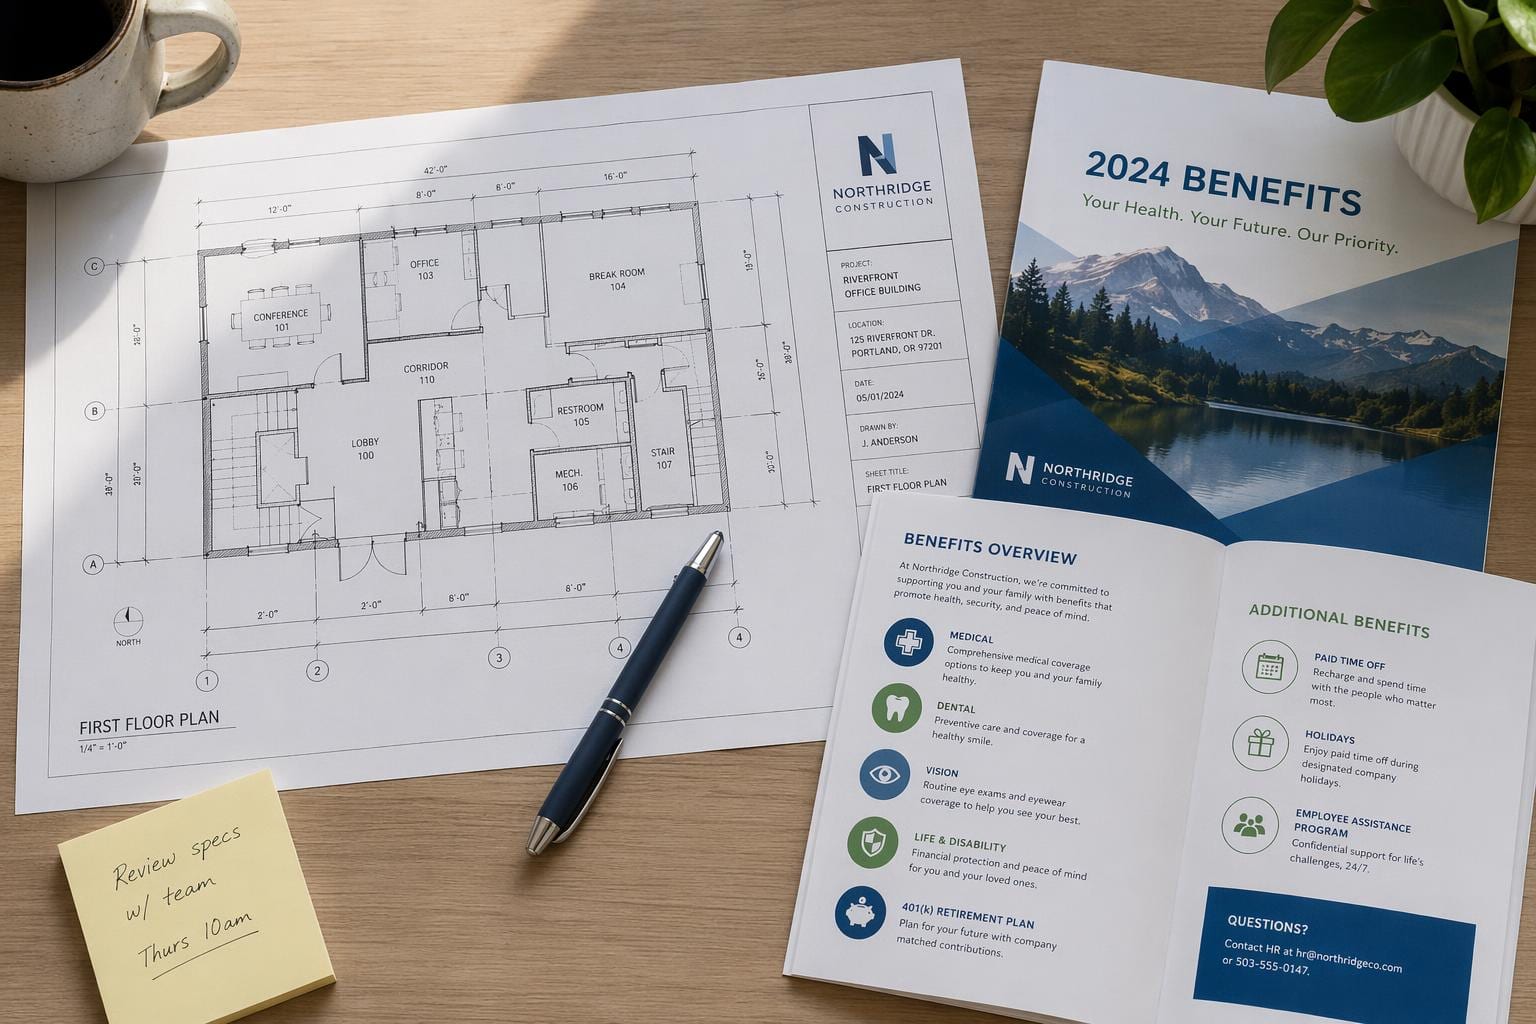
Imagina a un administrador de beneficios con un PDF de 40 páginas abierto en un monitor y la pregunta de un empleado en el otro: "Si tengo el plan PPO y veo a un especialista fuera de la red, ¿cuál es mi límite real de gastos de bolsillo después del deducible?" La respuesta está ahí. Simplemente está dividida entre una tabla en la página 12, una nota al pie en la página 14 que excluye ciertas visitas a especialistas y una enmienda en la página 38 que silenciosamente anula el número de la página 12. Una persona que sepa leer paquetes de beneficios puede encontrarla en unos minutos. Un nuevo artículo llamado GDP.pdf planteó este tipo exacto de pregunta a siete modelos multimodales de vanguardia. El mejor acertó en el 15 % de las 100 preguntas del benchmark. El peor acertó en el 1 %.
Ese no es un benchmark donde los modelos están cerca de resolverlo y exprimiendo los últimos puntos. Es un benchmark donde el campo apenas ha entrado en juego. Y la razón merece ser comprendida, porque dice algo incómodo sobre cómo hemos estado midiendo "la IA puede leer documentos ahora".
Por qué tu benchmark de OCR te está mintiendo
La mayoría de los benchmarks de IA para documentos evalúan una habilidad a la vez. Existe un benchmark para leer texto de una página escaneada (OCR). Otro para comprender la ubicación de los elementos en una página, como qué partida pertenece a qué columna (análisis de diseño). Otro para leer valores de un gráfico de barras (razonamiento de gráficos). Otro para responder preguntas sobre una tabla (QA de tablas). Y otro para tareas generales de "observa este documento y responde una pregunta" (VQA de documentos).
Un modelo puede obtener buenas puntuaciones en estas cinco áreas de forma aislada y, aun así, fallar en lo que un profesional realmente necesita: abrir un PDF específico, desordenado y del mundo real, y responder una pregunta concreta y trascendente sobre él. Los autores de GDP.pdf lo expresaron con claridad en el planteamiento del artículo: una alta puntuación en cualquier capacidad aislada no indica si el modelo puede manejar una pregunta realista sobre un documento real. Leer una tabla correctamente no sirve de nada si el modelo no nota que una nota al pie tres páginas más adelante excluye la mitad de las filas. Leer un gráfico correctamente no ayuda si el modelo no lo cruza con el párrafo que explica qué está midiendo realmente el gráfico.
Este es el mismo problema con el que los proveedores de OCR han lidiado durante años: un motor que procesa perfectamente una factura limpia y aislada puede fallar en cuanto esa factura es una foto filtrada de una fotocopia con una marca de café, o abarca varias páginas con un pie de página de continuación, o tiene una tabla que salta de columna a mitad de página. Los benchmarks de habilidades aisladas miden el caso ideal. El trabajo real ocurre en el caso desordenado.
Cómo construyeron un benchmark difícil de falsificar
La parte ingeniosa de GDP.pdf no son los documentos. Es el filtro que utilizaron para decidir qué preguntas merecían ser incluidas.
El equipo reclutó profesionales activos en diez campos, personas reales que manejan paquetes de beneficios, contratos de arrendamiento, hojas de datos, guías clínicas y planos de construcción como parte de sus trabajos cotidianos, y les pidió que escribieran preguntas sobre documentos reales de su dominio. Pero escribir una pregunta que suene difícil no es lo mismo que escribir una pregunta que realmente distinga a los modelos capaces de los incapaces. Por ello, añadieron una barrera: una pregunta candidata solo pasaba al benchmark final si al menos dos modelos multimodales de vanguardia la fallaban de manera significativa. No se trataba de una discusión estilística sobre la redacción. Se trataba de una respuesta incorrecta, evidencia omitida que debería haber cambiado la respuesta, o una afirmación fabricada que el documento no respalda.
Esa regla de fallo por dos modelos importa más de lo que parece. Significa que cada pregunta del benchmark ha demostrado empíricamente que confunde a los sistemas de IA actuales de una manera específica y significativa. No hay relleno, ni preguntas fáciles que todos los modelos resuelvan correctamente y que solo inflen la puntuación. Cada uno de los 100 elementos está ahí porque primero superó a al menos dos modelos potentes.
Tampoco se limitaron a calificar con aprobado o reprobado. Cada pregunta viene con una rúbrica de criterios atómicos, pequeños requisitos verificables que la respuesta debe cumplir, para que el artículo pueda informar dos números diferentes: una puntuación de rúbrica calificada (crédito parcial por acertar algunas partes) y una tasa de éxito estricta a nivel de tarea (¿el modelo resolvió todo correctamente, sin excepciones?). Además, cada elemento está etiquetado según una taxonomía de once capacidades en tres niveles, que abarca aspectos como la extracción y anclaje de texto (¿puedes encontrar el pasaje correcto y citarlo con precisión?), la comprensión de tablas y gráficos, la referencia cruzada entre páginas, el razonamiento espacial (dónde se sitúan los elementos en relación con otros en la página) y la abstención (¿sabe el modelo cuándo un documento simplemente no respalda una respuesta y lo dice, en lugar de adivinar?).
Este aspecto de la abstención merece una mención especial. Gran parte de la evaluación de IA para documentos solo prueba si el modelo obtiene la respuesta correcta cuando existe. GDP.pdf también verifica si el modelo fabricará una respuesta cuando el documento no contenga realmente la información, lo cual es, argumentablemente, el modo de fallo más peligroso en un entorno profesional. A nadie le hace daño que un modelo diga "no puedo encontrar eso en este documento". La gente se ve perjudicada por un número confiado e incorrecto en un cálculo de beneficios o una cláusula de arrendamiento.
Los números que deberían preocuparte
El resultado principal es contundente: de siete modelos de vanguardia, el mejor superó el 15 % de los 100 elementos en la métrica estricta a nivel de tarea. El peor superó solo el 1 %. Para un campo que durante los últimos dos años ha afirmado alcanzar un rendimiento casi humano en la comprensión de documentos, un techo del 15 % en preguntas redactadas por profesionales del dominio sobre documentos profesionales reales es un número difícil de justificar.
Conviene reflexionar sobre lo que representa esa brecha. Estos modelos no están fallando en el OCR en el sentido clásico; en su mayor parte, pueden leer el texto de la página sin problemas. Están fallando en la capa de razonamiento que se sitúa encima: conectar un número en una tabla con una salvedad en una nota al pie, notar que una enmienda posterior invalida una cláusula anterior, contar símbolos correctamente en un plano arquitectónico o darse cuenta de que el eje de un gráfico no significa lo que una mirada rápida sugiere. Esa es la capa donde realmente residen los PDFs profesionales, y es la capa que los modelos multimodales de propósito general no han sido entrenados para manejar bien, porque la mayor parte de los datos de entrenamiento y evaluación no se parecen a un paquete de beneficios de 40 páginas con tres enmiendas grapadas al final.
Las seis formas en que los modelos siguen fallando
El artículo atribuye la mayoría de los fallos a un conjunto relativamente pequeño y reconocible de patrones de error, y esta es la parte más útil para cualquiera que trabaje con estas herramientas a diario:
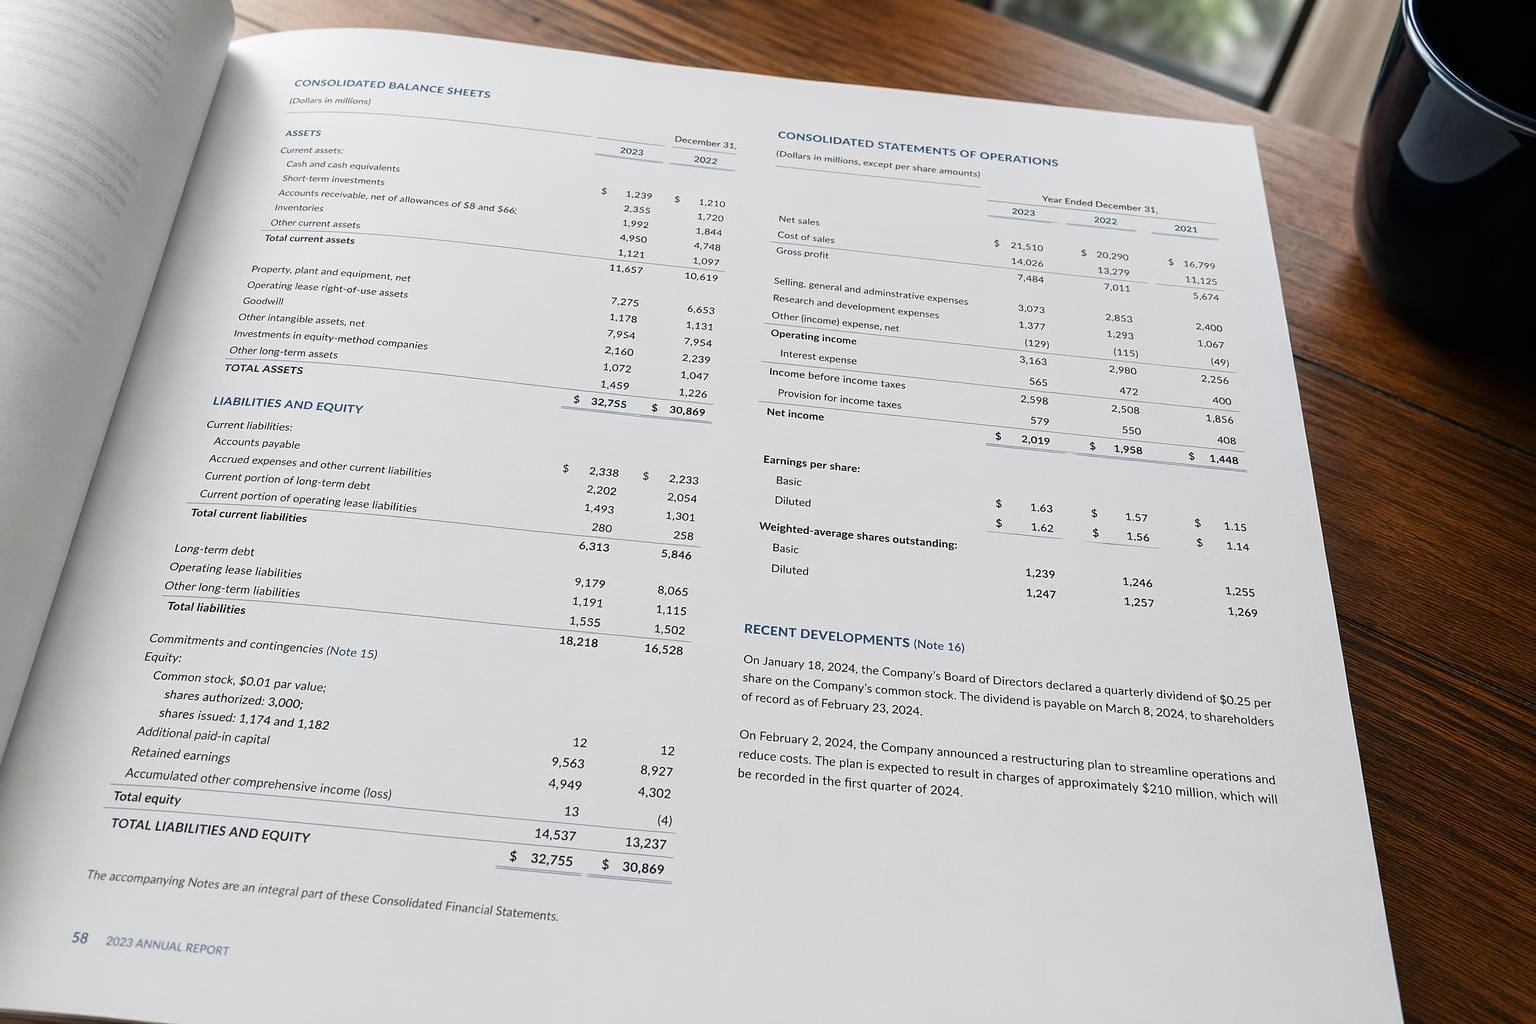
- Tablas desalineadas. El modelo lee un valor desde la fila o columna incorrecta, especialmente cuando una tabla se extiende a través de un salto de página o tiene celdas combinadas.
- Gráficos mal interpretados. El modelo capta la forma general correctamente, pero malinterpreta un valor específico, una etiqueta del eje o a qué serie pertenece un punto de datos.
- Notas al pie y exclusiones omitidas. El modelo encuentra el número principal pero pasa por alto la advertencia que lo modifica, la clásica trampa de los paquetes de beneficios del ejemplo inicial.
- Símbolos de planos mal contados. En documentos de construcción y arquitectura, el modelo subestima o sobrestima símbolos repetidos (enchufes, accesorios, puertas) que un humano contaría manualmente.
- Ruido de escaneo. Los documentos del mundo real no son PDFs limpios exportados desde Word. Son fotocopias de fotocopias, formularios enviados por fax y fotos tomadas con el móvil de documentos físicos, y la calidad de la imagen degrada la precisión del modelo más de lo que la gente suele asumir.
- Enmiendas posteriores. Un documento dice una cosa en la página 5 y una enmienda en la página 30 la cambia. Los modelos tienden a responder basándose en la versión que encuentran primero, en lugar de resolver el conflicto.
Ninguno de estos son casos extremos exóticos. Son la textura ordinaria de la documentación profesional. Un contrato de alquiler tiene adendas. Una hoja de datos tiene un historial de revisiones. Una guía clínica tiene una nota de actualización. Si su conjunto de evaluación no incluye documentos con esta estructura, no está midiendo lo que la gente realmente necesita.
Por qué importa para cualquiera que construya o elija OCR
Si estás construyendo un producto sobre OCR o Document AI, o evaluando proveedores para elegir uno, GDP.pdf es una útil comprobación de realidad frente a las afirmaciones de marketing. "Estado del arte en VQA de documentos" y "puede responder una pregunta real sobre un documento de póliza de 40 páginas con una nota al pie que cambia la respuesta" son afirmaciones diferentes, y este paper muestra que la brecha entre ellas es enorme, no marginal.
Las conclusiones prácticas:
- No confíes en benchmarks de una sola capacidad como proxy para la fiabilidad de extremo a extremo. Un modelo que encabeza un ranking de QA de tablas aún puede pasar por alto la nota al pie que anula la tabla. Si un proveedor solo cita puntuaciones de habilidades aisladas, pregunta qué ocurre cuando las habilidades deben componerse.
- El reintento con múltiples modelos vale la pena aquí. Dado que los modos de fallo son inconsistentes entre modelos (tablas desalineadas para uno, enmiendas pasadas por alto para otro), enrutar el mismo documento a un segundo o tercer motor cuando la primera respuesta parece dudosa no es un lujo, es casi necesario para cualquier cosa con apuestas reales.
- La abstención es una característica a probar, no a asumir. Antes de confiar en la respuesta de un modelo sobre un documento, verifica si realmente dirá "no está en este documento" cuando la respuesta no esté allí, en lugar de inventar una con confianza. La categoría de abstención de GDP.pdf existe porque esto es actualmente un punto débil en general.
- Trata la calidad del escaneo como parte del pipeline, no como una idea posterior. El ruido del escaneo fue uno de los seis patrones recurrentes de pérdida. Si tu pipeline de ingestión no limpia ni marca los escaneos de baja calidad antes de que lleguen al modelo, estás heredando una fuente de error que podrías eliminar parcialmente mediante ingeniería.
- Presupuesta revisión humana para cualquier documento con enmiendas, exclusiones o historial de revisiones. Estos son exactamente los documentos donde los modelos actuales fallan más, y exactamente los documentos donde una respuesta incorrecta es más probable que cueste dinero o cobertura de salud a alguien.
Lo que este benchmark no te dice
Algunas advertencias sinceras. Cien preguntas constituyen un benchmark pequeño. Es suficiente para hacer un punto sólido sobre la naturaleza del fallo (seis patrones recurrentes en diez dominios profesionales son una señal significativa), pero no es suficiente para proporcionarte un porcentaje preciso y estable que debas citar como "el" número de precisión para cualquier modelo dado en esta clase de tareas. Los benchmarks pequeños también son más sensibles a qué documentos y preguntas específicas fueron seleccionados, incluso con el filtro de fallo de dos modelos en su lugar.
La regla de selección de fallo de dos modelos es inteligente para poner de manifiesto preguntas genuinamente difíciles y significativas, pero también significa que el benchmark está explícitamente construido para ser difícil para los modelos actuales. Ese es el punto, pero significa que los números del 15 %/1 % describen el techo en preguntas seleccionadas de forma adversarial, no una muestra aleatoria de "preguntas que los profesionales suelen hacer". La precisión en el mundo real sobre la mezcla completa de preguntas fáciles y difíciles que un administrador de prestaciones o un estimador de construcción hace día a día será mayor que el 15 %, simplemente no tan alta como la publicidad suele implicar.
Y siete modelos, evaluados una vez, en cien elementos, es una instantánea más que una línea de tendencia. Los modelos están avanzando rápidamente, y este techo específico del 15 % probablemente aumentará. Lo que es más duradero es la taxonomía: las once capacidades y los seis patrones de pérdida son una lista de verificación genuinamente útil para evaluar cualquier sistema de IA de documentos, ya sea el de hoy o el del próximo año, porque describen brechas estructurales en cómo estos modelos manejan el razonamiento fundamentado y de múltiples partes sobre documentos reales, no solo un marcador que estará obsoleto en seis meses.
El resumen sincero: los PDFs profesionales son más difíciles de lo que los benchmarks hicieron parecer, la industria ha estado calificando en el eje incorrecto, y GDP.pdf es un primer intento sólido para calificar en el correcto.