O benchmark onde o melhor modelo de IA ainda falha 85% das vezes em um PDF
Baseado em: GDP.pdf: Benchmarking Grounded Multimodal Reasoning over Professional PDF Documents — Suhaas Garre, Emily Ritchie, Sushant Mehta, Edwin Chen
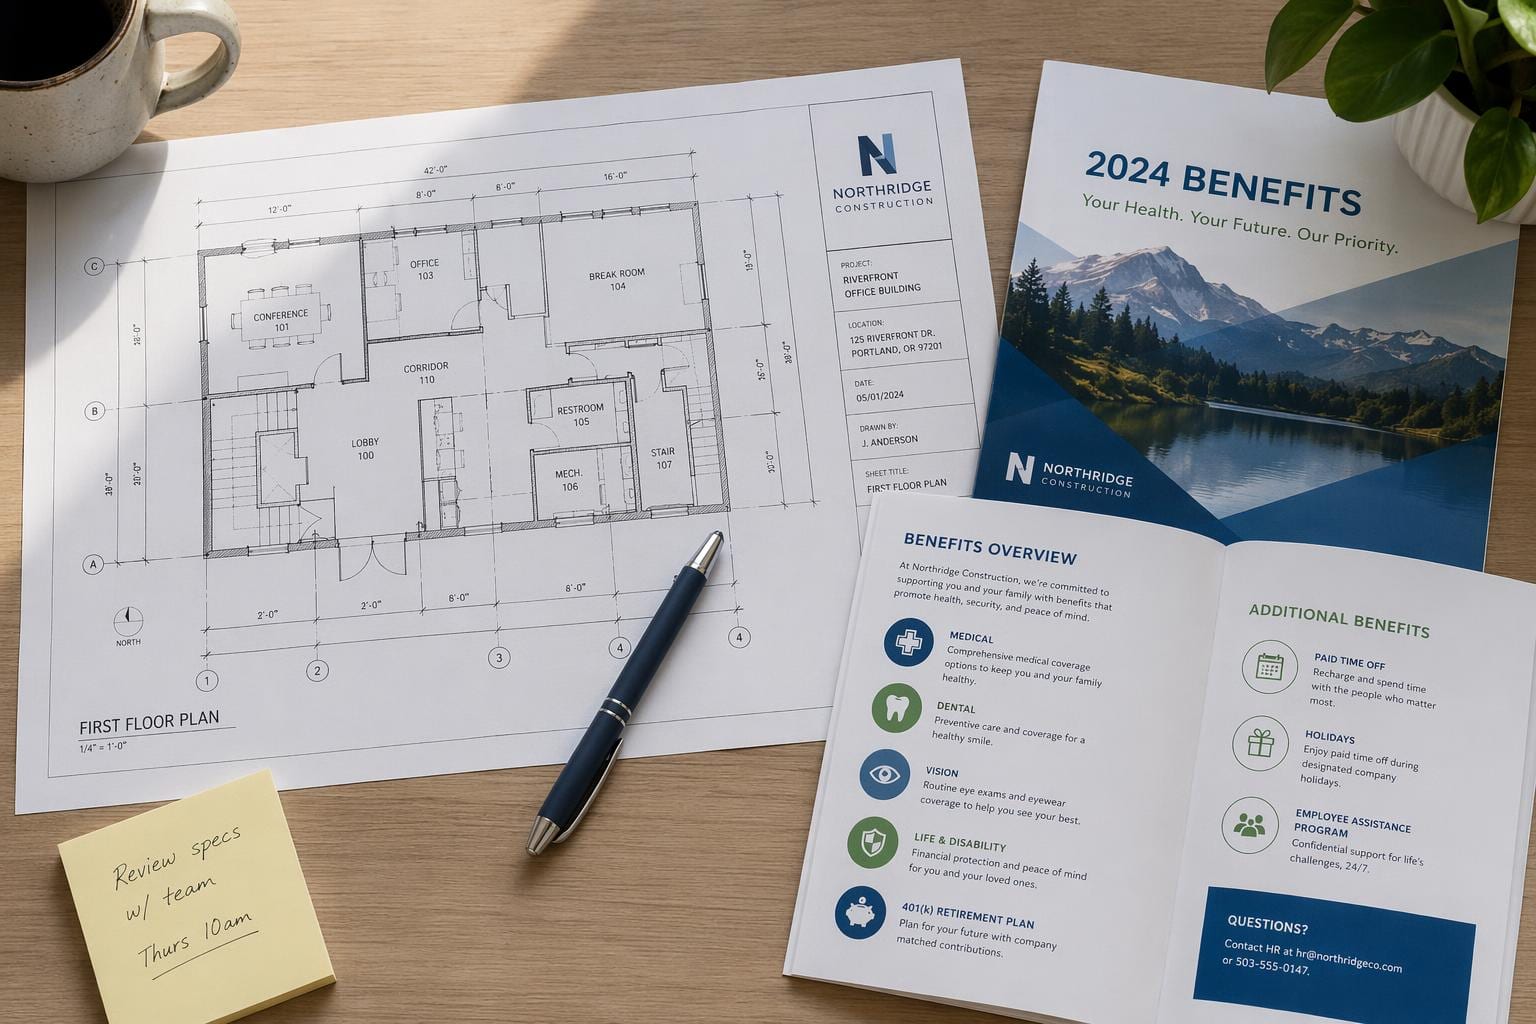
Imagine um administrador de benefícios com um PDF de 40 páginas aberto em um monitor e a pergunta de um funcionário no outro: "Se eu tiver o plano PPO e consultar um especialista fora da rede, qual é meu limite real de gastos próprios após o dedutível?" A resposta está lá. Ela está apenas dividida entre uma tabela na página 12, uma nota de rodapé na página 14 que exclui certas consultas a especialistas e uma emenda na página 38 que silenciosamente anula o número da página 12. Uma pessoa que saiba ler pacotes de benefícios pode encontrá-la em alguns minutos. Um novo artigo chamado GDP.pdf apresentou exatamente esse tipo de pergunta a sete modelos multimodais de ponta. O melhor acertou 15% das 100 perguntas do benchmark. O pior acertou 1%.
Esse não é um benchmark em que os modelos estão perto de resolver o problema e buscando os últimos pontos. É um benchmark em que o campo mal começou. E a razão disso vale a pena entender, porque revela algo desconfortável sobre como temos medido "a IA já consegue ler documentos".
Por que seu benchmark de OCR está mentindo para você
A maioria dos benchmarks de IA para documentos testa uma habilidade de cada vez. Existe um benchmark para ler texto de uma página escaneada (OCR). Outro para entender onde os elementos estão posicionados na página, como qual item de linha pertence a qual coluna (análise de layout). Outro para ler valores de um gráfico de barras (raciocínio com gráficos). Outro para responder perguntas sobre uma tabela (table QA). E outro para tarefas gerais de "olhe este documento e responda uma pergunta" (document VQA).
Um modelo pode obter boas pontuações em todos esses cinco testes isoladamente e ainda assim falhar na tarefa que um profissional realmente precisa: abrir um PDF específico, desorganizado e do mundo real e responder a uma pergunta específica e importante sobre ele. Os autores do GDP.pdf deixaram isso claro na estruturação do artigo: uma alta pontuação em qualquer capacidade isolada não indica se o modelo consegue lidar com uma pergunta realista sobre um documento real. Ler uma tabela corretamente não ajuda se o modelo não perceber que uma nota de rodapé três páginas depois exclui metade das linhas. Ler um gráfico corretamente não ajuda se o modelo não fizer referência cruzada com o parágrafo que explica o que o gráfico está realmente medindo.
Este é o mesmo problema que os fornecedores de OCR vêm enfrentando há anos: um mecanismo que funciona perfeitamente com uma fatura limpa e isolada pode travar no momento em que essa fatura é uma foto vazada de uma fotocópia com uma mancha de café, ou se estende por várias páginas com um rodapé de continuação, ou possui uma tabela que muda de coluna no meio do caminho. Benchmarks de habilidades isoladas medem o caso ideal. O trabalho real acontece no caso desorganizado.
Como construíram um benchmark difícil de falsificar
A parte inteligente do GDP.pdf não são os documentos. É o filtro que usaram para decidir quais perguntas valiam a pena incluir.
A equipe recrutou profissionais atuantes em dez áreas, pessoas reais que lidam com pacotes de benefícios, contratos de aluguel, fichas técnicas, diretrizes clínicas e projetos de construção como parte de seus trabalhos reais, e pediu que escrevessem perguntas sobre documentos reais de seus domínios. Mas escrever uma pergunta que soa difícil não é o mesmo que escrever uma pergunta que realmente separa modelos capazes de incapazes. Então eles adicionaram um filtro: uma pergunta candidata só entrava no benchmark final se pelo menos dois modelos multimodais de ponta falhassem nela de uma maneira que importasse. Não uma questão estilística sobre a formulação. Uma resposta errada, evidência perdida que deveria ter mudado a resposta, ou uma afirmação fabricada que o documento não suporta.
Essa regra de falha de dois modelos importa mais do que pode parecer. Isso significa que cada pergunta no benchmark já foi provada, empiricamente, para enganar os sistemas de IA atuais de uma maneira específica e significativa. Não há preenchimento ali, nenhuma pergunta fácil que todo modelo acerta e que apenas infla a pontuação. Cada um dos 100 itens está lá porque derrotou pelo menos dois modelos fortes primeiro.
Eles também não apenas avaliaram como passou ou falhou. Cada pergunta vem com uma rubrica de critérios atômicos, pequenos requisitos verificáveis que a resposta precisa atingir, para que o artigo possa relatar dois números diferentes: uma pontuação de rubrica graduada (crédito parcial por acertar algumas das partes) e uma taxa de aprovação estrita no nível da tarefa (o modelo acertou tudo, ponto final). E cada item é marcado contra uma taxonomia de onze capacidades em três níveis, cobrindo coisas como extração e ancoragem de texto (você consegue encontrar a passagem certa e citá-la com precisão), compreensão de tabelas e gráficos, cruzamento de referências entre páginas, raciocínio espacial (onde as coisas ficam em relação umas às outras na página) e abstenção (o modelo sabe quando um documento simplesmente não suporta uma resposta, e diz isso, em vez de adivinhar).
Essa peça de abstenção merece sua própria chamada. Muito da avaliação de IA de documentos testa apenas se o modelo acerta a resposta certa quando há uma. O GDP.pdf também verifica se o modelo fabricará uma resposta quando o documento realmente não contém a informação, o que é, argumentavelmente, o modo de falha mais perigoso em um ambiente profissional. Ninguém se machuca por um modelo dizer "não consigo encontrar isso neste documento". As pessoas se machucam por um número confiante e errado em um cálculo de benefícios ou uma cláusula de contrato de aluguel.
Os números que deveriam preocupar você
O resultado principal é contundente: entre sete modelos de ponta, o melhor passou em 15% dos 100 itens na métrica rigorosa de nível de tarefa. O pior passou em apenas 1%. Para um campo que passou os últimos dois anos alegando desempenho próximo ao humano na compreensão de documentos, um teto de 15% em perguntas escritas por profissionais reais da área sobre documentos profissionais reais é um número difícil de justificar.
Vale a pena refletir sobre o que esse abismo representa. Esses modelos não estão falhando no OCR no sentido clássico; eles conseguem, na maioria das vezes, ler o texto na página sem problemas. Eles estão falhando na camada de raciocínio sobreposta a ele: conectar um número em uma tabela a uma ressalva em uma nota de rodapé, perceber que uma emenda posterior revoga uma cláusula anterior, contar símbolos corretamente em um planta baixa ou perceber que o eixo de um gráfico não significa o que uma olhada rápida sugere. É nessa camada que os PDFs profissionais realmente vivem, e é a camada para a qual os modelos multimodais de uso geral não foram treinados para lidar bem, porque a maioria dos dados de treinamento e avaliação não se parece com um pacote de benefícios de 40 páginas com três emendas grampeadas no final.
As seis formas pelas quais os modelos continuam falhando
O artigo atribui a maioria das falhas a um conjunto relativamente pequeno e reconhecível de padrões de erro, e esta é a parte mais útil para quem trabalha com essas ferramentas no dia a dia:
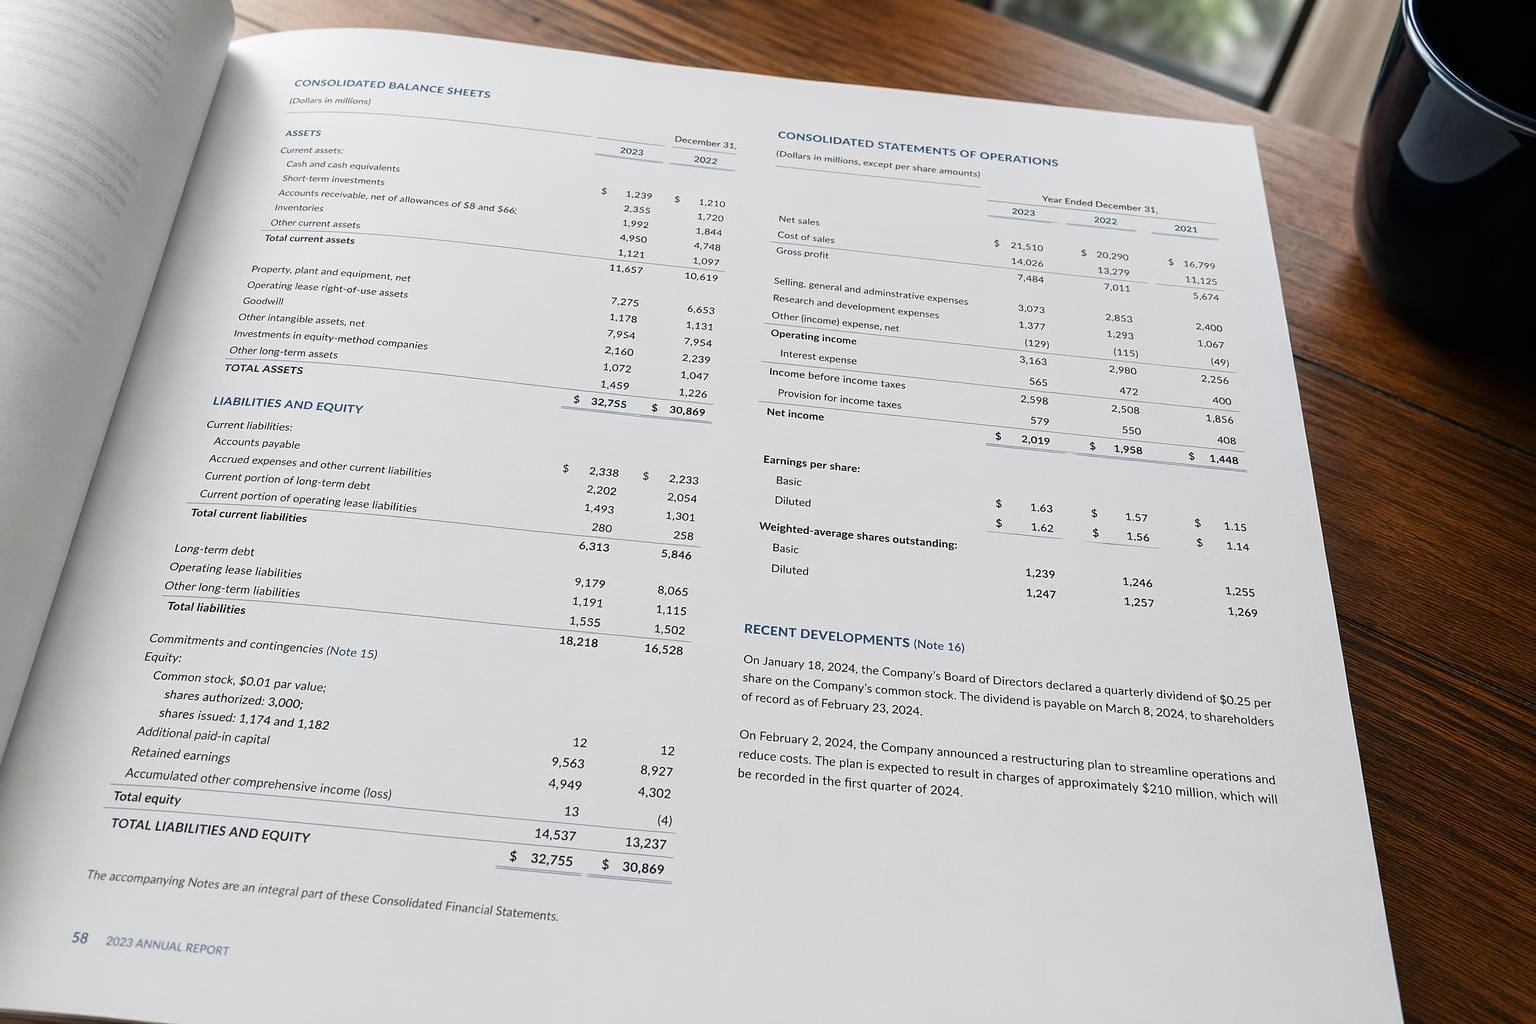
- Tabelas desalinhadas. O modelo lê um valor da linha ou coluna errada, especialmente quando uma tabela se estende por uma quebra de página ou possui células mescladas.
- Gráficos mal lidos. O modelo capta a forma geral corretamente, mas interpreta mal um valor específico, um rótulo do eixo ou a qual série um ponto de dados pertence.
- Notas de rodapé e exclusões ignoradas. O modelo encontra o número principal, mas perde a ressalva que o altera — a clássica armadilha do pacote de benefícios do exemplo inicial.
- Símbolos de plantas baixas mal contados. Em documentos de construção e arquitetura, o modelo subestima ou superestima a contagem de símbolos repetidos (tomadas, fixações, portas) que um humano contaria manualmente.
- Ruído de digitalização. Documentos do mundo real não são PDFs limpos exportados do Word. São cópias de cópias, formulários faxeados e fotos tiradas com celular de documentos físicos, e a qualidade da imagem degrada a precisão do modelo mais do que as pessoas imaginam.
- Emendas posteriores. Um documento afirma algo na página 5 e uma emenda na página 30 o altera. Os modelos tendem a responder com base na versão que encontram primeiro, em vez de resolver o conflito.
Nenhum desses são casos extremos exóticos. Eles são a textura comum da papelada profissional. Um contrato de aluguel tem adendos. Uma ficha técnica tem um histórico de revisões. Uma diretriz clínica tem um memorando de atualização. Se seu benchmark não inclui documentos com essa estrutura, ele não está medindo o que as pessoas realmente precisam.
Por que isso importa para quem está construindo ou escolhendo OCR
Se você está construindo um produto com base em OCR ou Document AI, ou avaliando fornecedores para escolher um, o GDP.pdf é uma verificação de realidade útil contra as alegações de marketing. "Estado da arte em VQA de documentos" e "pode responder a uma pergunta real sobre um documento de política real de 40 páginas com uma nota de rodapé que altera a resposta" são alegações diferentes, e este artigo mostra que a lacuna entre elas é enorme, não marginal.
As conclusões práticas:
- Não confie em benchmarks de capacidade única como um proxy para confiabilidade de ponta a ponta. Um modelo que lidera um ranking de QA de tabelas ainda pode perder a nota de rodapé que invalida a tabela. Se um fornecedor citar apenas pontuações de habilidades isoladas, pergunte o que acontece quando as habilidades precisam se compor.
- A repetição com múltiplos modelos vale a pena aqui. Como os modos de falha são inconsistentes entre os modelos (tabelas desalinhadas para um, emendas perdidas para outro), rotear o mesmo documento para um segundo ou terceiro mecanismo quando a primeira resposta parece instável não é um luxo, é quase necessário para qualquer coisa com riscos reais envolvidos.
- A abstenção é um recurso a ser testado, não assumido. Antes de confiar na resposta de um modelo sobre um documento, verifique se ele realmente dirá "não está neste documento" quando a resposta não estiver lá, em vez de inventar uma com confiança. A camada de abstenção do GDP.pdf existe porque este é atualmente um ponto fraco em geral.
- Trate a qualidade da digitalização como parte do pipeline, não como uma reflexão tardia. O ruído da digitalização foi um dos seis padrões de perda recorrentes. Se seu pipeline de ingestão não limpar ou sinalizar digitalizações de baixa qualidade antes que elas cheguem ao modelo, você está herdando uma fonte de erro que poderia ser parcialmente eliminada por engenharia.
- Orçente para revisão humana em qualquer coisa com emenda, exclusão ou histórico de revisões. Estes são exatamente os documentos onde os modelos atuais falham mais, e exatamente os documentos onde uma resposta errada é mais provável de custar dinheiro ou cobertura de saúde a alguém.
O que este benchmark não diz a você
Algumas ressalvas honestas. Cem perguntas constituem um benchmark pequeno. É suficiente para fazer um ponto forte sobre a natureza do erro (seis padrões recorrentes em dez domínios profissionais são um sinal significativo), mas não é suficiente para fornecer uma porcentagem precisa e estável que você deva citar como "a" taxa de precisão para qualquer modelo específico nesta classe de tarefas. Benchmarks pequenos também são mais sensíveis à seleção de documentos e perguntas específicas, mesmo com o filtro de falha em dois modelos em vigor.
A regra de seleção baseada em falha em dois modelos é inteligente para destacar perguntas genuinamente difíceis e significativas, mas também significa que o benchmark foi explicitamente construído para ser difícil para os modelos atuais. Esse é o objetivo, mas isso implica que os números de 15%/1% descrevem o limite superior em perguntas selecionadas adversarialmente, não uma amostra aleatória de "perguntas que os profissionais fazem tipicamente". A precisão no mundo real, na mistura completa de perguntas fáceis e difíceis que um administrador de benefícios ou um estimador de construção faz no dia a dia, será superior a 15%, apenas não tão alta quanto o marketing geralmente sugere.
E sete modelos, avaliados uma vez, em cem itens, representam um retrato instantâneo, não uma linha de tendência. Os modelos estão evoluindo rapidamente, e esse limite específico de 15% provavelmente aumentará. O que é mais durável é a taxonomia: as onze capacidades e os seis padrões de perda constituem uma lista de verificação genuinamente útil para avaliar qualquer sistema de IA de documentos, seja o de hoje ou o do próximo ano, porque eles descrevem lacunas estruturais na forma como esses modelos lidam com raciocínio fundamentado e multifacetado sobre documentos reais, e não apenas um placar que ficará obsoleto em seis meses.
O resumo honesto: PDFs profissionais são mais difíceis do que os benchmarks faziam parecer, a indústria tem sido avaliada no eixo errado, e o GDP.pdf é uma tentativa inicial sólida de avaliar no eixo correto.