वह बेंचमार्क जहाँ सबसे अच्छा AI मॉडल अभी भी एक PDF पर 85% समय विफल हो जाता है
आधारित शोध-पत्र: GDP.pdf: Benchmarking Grounded Multimodal Reasoning over Professional PDF Documents — Suhaas Garre, Emily Ritchie, Sushant Mehta, Edwin Chen
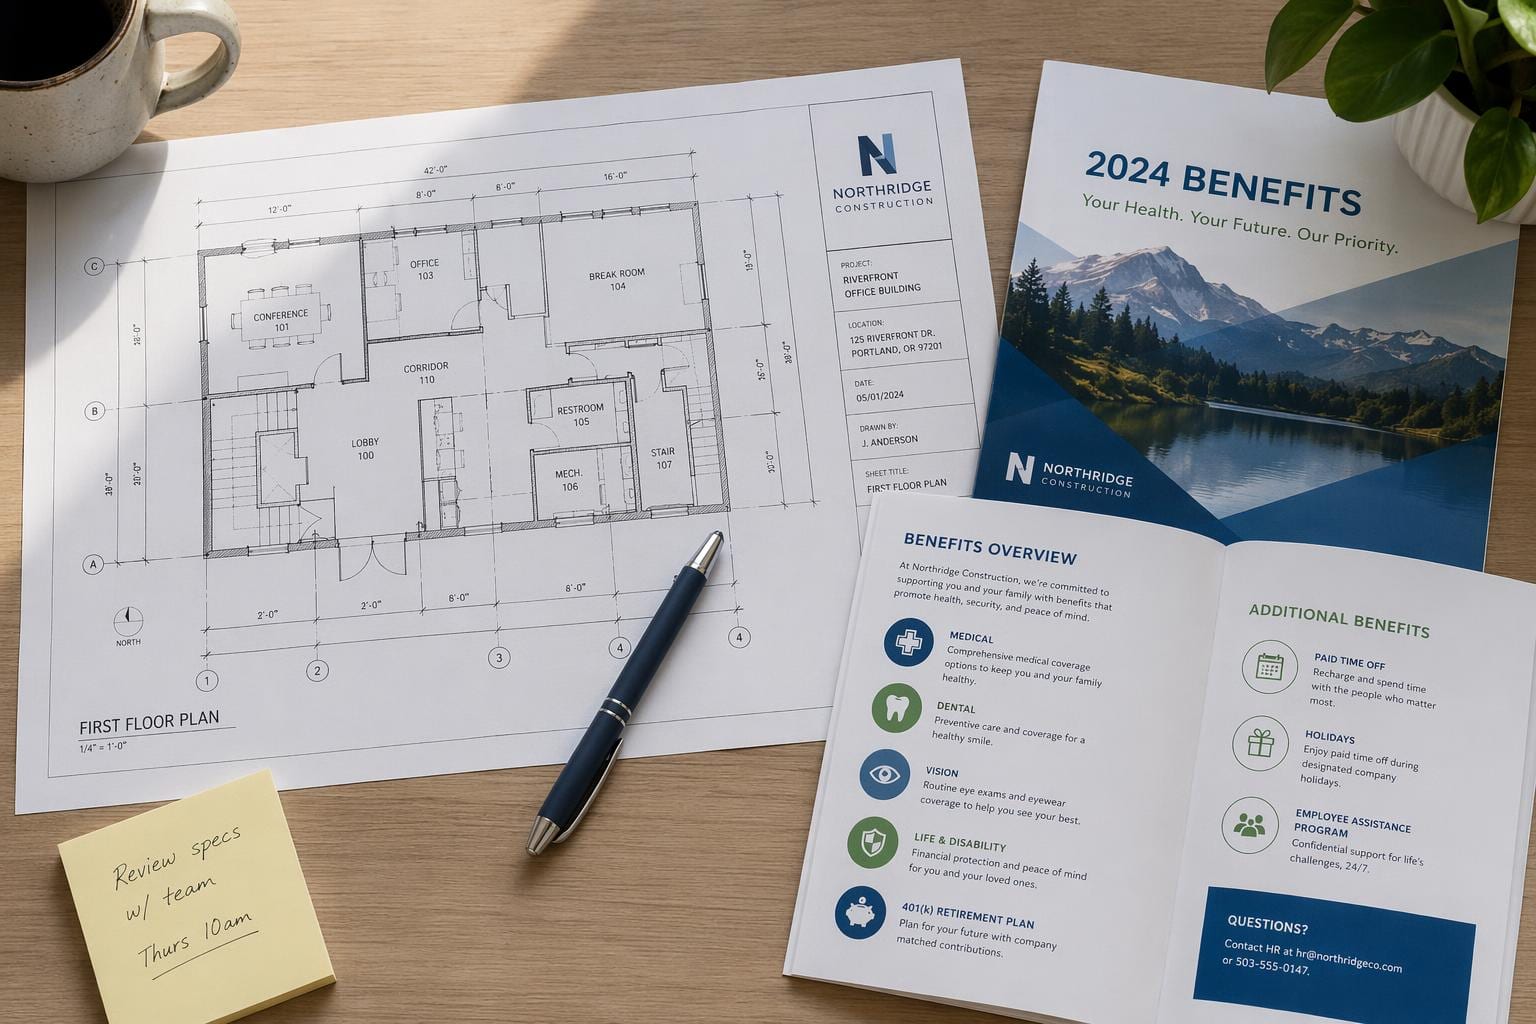
एक फायदे प्रशासक की कल्पना करें जिसके पास एक मॉनिटर पर 40 पृष्ठों का PDF खुला है और दूसरे पर कर्मचारी का सवाल: "अगर मेरे पास PPO योजना है और मैं नेटवर्क के बाहर के विशेषज्ञ से मिलता हूँ, तो डेडक्टिबल के बाद मेरा वास्तविक आउट-ऑफ-पॉकेट कैप क्या है?" जवाब वहाँ मौजूद है। यह बस पृष्ठ 12 पर एक तालिका, पृष्ठ 14 पर एक फुटनोट (जो कुछ विशेषज्ञ भेटी को छोड़ देता है), और पृष्ठ 38 पर एक संशोधन में बिखरा हुआ है जो चुपचाप पृष्ठ 12 पर दी गई संख्या को ओवरराइड कर देता है। जो व्यक्ति फायदे के पैकेट को पढ़ना जानता है, वह इसे कुछ मिनटों में ढूंढ सकता है। एक नई पेपर GDP.pdf ने ठीक इसी तरह के सवालों को सात फ्रंटियर मल्टीमोडल मॉडल दिए। सबसे अच्छे मॉडल ने बेनचमार्क के 100 सवालों में से 15% सही जवाब दिए। सबसे खराब ने 1%।
यह वह बेनचमार्क नहीं है जहाँ मॉडल लगभग हल कर चुके हों और आखिरी कुछ अंक निकालने की कोशिश कर रहे हों। यह वह बेनचमार्क है जहाँ क्षेत्र अभी-अभी बोर्ड पर आया है। और इसका कारण समझना जरूरी है, क्योंकि यह "AI अब दस्तावेज़ पढ़ सकता है" को हम कैसे माप रहे हैं, इसके बारे में कुछ असहज बातें बताता है।
आपका OCR बेचमार्क आपको क्यों झूठ बोल रहा है
ज्यादातर डॉक्यूमेंट AI बेचमार्क एक बार में केवल एक कौशल का परीक्षण करते हैं। स्कैन की गई पेज से पाठ पढ़ने के लिए एक बेचमार्क है (OCR)। पेज पर चीजें कहाँ स्थित हैं, जैसे कि कौन सा लाइन आइटम किस कॉलम से संबंधित है, यह समझने के लिए एक बेचमार्क है (लेआउट एनालिसिस)। बार चार्ट से मान पढ़ने के लिए एक बेचमार्क है (चार्ट रीजनिंग)। टेबल के बारे में प्रश्नों के उत्तर देने के लिए एक बेचमार्क है (टेबल QA)। और सामान्य "इस डॉक्यूमेंट को देखें और एक प्रश्न का उत्तर दें" कार्यों के लिए एक बेचमार्क है (डॉक्यूमेंट VQA)।
एक मॉडल इन पाँचों में से प्रत्येक को अलग-अलग अच्छा स्कोर कर सकता है और फिर भी उस चीज़ में विफल हो सकता है जिसकी एक वास्तविक पेशेवर को वास्तव में आवश्यकता होती है: एक विशिष्ट, अव्यवस्थित, वास्तविक-दुनिया के PDF को खोलना और उसके बारे में एक विशिष्ट, महत्वपूर्ण प्रश्न का उत्तर देना। GDP.pdf के लेखकों ने पेपर के फ्रेमिंग में इसे स्पष्ट रूप से कहा है: किसी भी एक अलग कौशल पर उच्च स्कोर आपको यह नहीं बताता है कि मॉडल एक वास्तविक डॉक्यूमेंट के बारे में एक यथार्थवादी प्रश्न को संभाल सकता है या नहीं। यदि मॉडल यह नहीं ध्यान देता है कि तीन पेज बाद एक फुटनोट आधे पंक्तियों को बाहर करता है, तो टेबल को सही ढंग से पढ़ने से कोई फायदा नहीं है। यदि मॉडल उस पैराग्राफ के खिलाफ इसका क्रॉस-रेफरेंस नहीं करता है जो समझाता है कि चार्ट वास्तव में क्या माप रहा है, तो चार्ट को सही ढंग से पढ़ने से कोई फायदा नहीं है।
यह वही जाल है जिसका सामना OCR विक्रेता वर्षों से कर रहे हैं: एक इंजन जो एक साफ, स्वतंत्र इनवॉइस पर सटीकता से काम कर सकता है, फिर भी उस क्षण पर फंस सकता है जब वह इनवॉइस एक लीक हुई फोटोकॉपी की तस्वीर हो जिस पर कॉफी का दाग हो, या कई पेजों में फैला हो जिसमें निरंतरता फुटर हो, या जिसमें एक टेबल हो जो आधे रास्ते में कॉलम बदल दे। अलग-अलग कौशल बेचमार्क साफ मामले को मापते हैं। वास्तविक कार्य अव्यवस्थित मामले में होता है।
उन्होंने एक ऐसा बेचमार्क कैसे बनाया जिसे फेक करना मुश्किल है
GDP.pdf की चालाकी दस्तावेज़ों में नहीं, बल्कि उन फ़िल्टर में है जिसका उपयोग उन्होंने यह तय करने के लिए किया कि कौन-से सवाल शामिल करने लायक हैं।
टीम ने दस क्षेत्रों में काम करने वाले पेशेवरों को भर्ती किया, ऐसे वास्तविक लोग जो अपने वास्तविक कामों के हिस्से के रूप में बेनिफिट पैकेट, लीज़, डेटाशीट, क्लिनिकल गाइडलाइन और निर्माण योजनाओं से निपटते हैं, और उनसे अपने डोमेन के वास्तविक दस्तावेज़ों के बारे में सवाल लिखवाया। लेकिन एक कठिन लगने वाला सवाल लिखना उस सवाल को लिखने के बराबर नहीं है जो वास्तव में सक्षम मॉडल और असक्षम मॉडल को अलग करता है। इसलिए उन्होंने एक गेट जोड़ा: एक उम्मीदवार सवाल अंतिम बेचमार्क में तभी शामिल हुआ जब कम से कम दो फ्रंटियर मल्टीमोडल मॉडल उसमें ऐसे फेल हुए जिसका महत्व था। शैली संबंधी कोई बहस नहीं। गलत जवाब, वह सबूत छूट जाना जो जवाब को बदलना चाहिए था, या एक काल्पनिक दावा जो दस्तावेज़ द्वारा समर्थित नहीं है।
यह दो-मॉडल-फ़ेलियर नियत उतना ही महत्वपूर्ण है जितना वह लगता है। इसका मतलब है कि बेचमार्क में हर सवाल को पहले से ही प्रयोगात्मक रूप से साबित कर दिया गया है कि यह वर्तमान AI सिस्टम को एक विशिष्ट और अर्थपूर्ण तरीके से उलझाता है। वहां कोई फिलर नहीं है, कोई आसान सवाल नहीं जिसका हर मॉडल सही जवाब देता है और जो केवल स्कोर को बढ़ाता है। 100 आइटमों में से प्रत्येक इसलिए मौजूद है क्योंकि उसने पहले कम से कम दो मजबूत मॉडलों को हराया था।
वे केवल पास या फेल ग्रेड नहीं देते थे। हर सवाल के साथ परमाणु मानदंडों का एक रूब्रिक आता है, छोटे, जांचने योग्य आवश्यकताएं जिन पर जवाब को पूरा करना होता है, ताकि पेपर दो अलग-अलग संख्याओं की रिपोर्ट कर सके: एक ग्रेडेड रूब्रिक स्कोर (कुछ हिस्से सही पाने के लिए आंशिक क्रेडिट) और एक सख्त टास्क-लेवल पास रेट (क्या मॉडल ने पूरा काम सही किया, बिना किसी शर्त के)। और हर आइटम को तीन टियर में ग्यारह क्षमताओं के एक वर्गीकरण के खिलाफ टैग किया गया है, जिसमें टेक्स्ट एक्सट्रैक्शन और ग्राउंडिंग (क्या आप सही पैसाज ढूंढ सकते हैं और सटीक रूप से उद्धृत कर सकते हैं), टेबल और चार्ट समझ, पेजों के बीच क्रॉस-रेफरेंसिंग, स्थानिक तर्क (चीजें एक-दूसरे के सापेक्ष पेज पर कहाँ हैं), और अस्तिनेशन (क्या मॉडल जानता है कि जब दस्तावेज़ जवाब को समर्थित नहीं करता है, तो अनुमान लगाने के बजाय ऐसा कहना) जैसे पहलुओं को कवर किया गया है।
अस्तिनेशन वाले हिस्से को अपनी खुद की कॉलआउट मिलनी चाहिए। दस्तावेज़ AI मूल्यांकन का एक बड़ा हिस्सा केवल यह जांचता है कि जब एक जवाब मौजूद हो तो मॉडल सही जवाब देता है या नहीं। GDP.pdf यह भी जांचता है कि जब दस्तावेज़ में वास्तव में जानकारी न हो तो मॉडल जवाब का निर्माण करेगा या नहीं, जो कि एक पेशेवर सेटिंग में सबसे खतरनाक फेलियर मोड हो सकता है। किसी को चोट नहीं लगती जब मॉडल कहता है "मुझे इस दस्तावेज़ में वह नहीं मिल रहा है।" लोगों को चोट तब लगती है जब बेनिफिट कैलकुलेशन या लीज़ क्लॉज में एक आत्मविश्वास से भरा, गलत नंबर होता है।
आपको चिंता करने के लिए संख्याएँ
मुख्य परिणाम स्पष्ट है: सात फ्रंटियर मॉडल्स में से सबसे अच्छा मॉडल ने सख्त टास्क-लेवल मेट्रिक पर 100 आइटमों में से 15% पास किए। सबसे खराब मॉडल ने 1% पास किए। एक ऐसे क्षेत्र के लिए जिसने पिछले दो वर्षों में डॉक्यूमेंट समझ पर मानव-समान प्रदर्शन का दावा किया है, वास्तविक डोमेन पेशेवरों द्वारा वास्तविक पेशेवर दस्तावेज़ों के बारे में लिखे गए प्रश्नों पर 15% की सीमा को नजरअंदाज करना मुश्किल है।
इस अंतर का क्या अर्थ है, इस पर विचार करना महत्वपूर्ण है। ये मॉडल क्लासिक अर्थ में OCR में विफल नहीं हो रहे हैं; वे पृष्ठ पर पाठ को ज्यादातर ठीक से पढ़ सकते हैं। वे इसके ऊपर तर्क स्तर पर विफल हो रहे हैं: टेबल में एक संख्या को फुटनोट में एक चेतावनी से जोड़ना, यह ध्यान देना कि बाद में संशोधन पिछले प्रावधान को रद्द करता है, फ्लोर प्लान पर प्रतीकों को सही गिनना, या यह समझना कि चार्ट का अक्ष उस अर्थ को नहीं दर्शाता जो त्वरित नज़र से लगता है। यही वह स्तर है जहाँ पेशेवर PDFs वास्तव में मौजूद हैं, और यही वह स्तर है जिसे सामान्य उद्देश्य वाले मल्टीमोडल मॉडल्स को अच्छी तरह संभालने के लिए प्रशिक्षित नहीं किया गया है, क्योंकि अधिकांश प्रशिक्षण और मूल्यांकन डेटा 40 पृष्ठों के लाभ पैकेट जैसा नहीं दिखता जिसके पीछे तीन संशोधन सटीक किए गए हों।
मॉडल हारते रहने के छह तरीके
गवेषणा पत्र अधिकांश विफलताओं को हानि के एक अपेक्षाकृत छोटे, पहचाने जाने योग्य सेट से जोड़ता है, और यह उन लोगों के लिए सबसे उपयोगी हिस्सा है जो इन उपकरणों के साथ रोज़मर्रा के काम करते हैं:
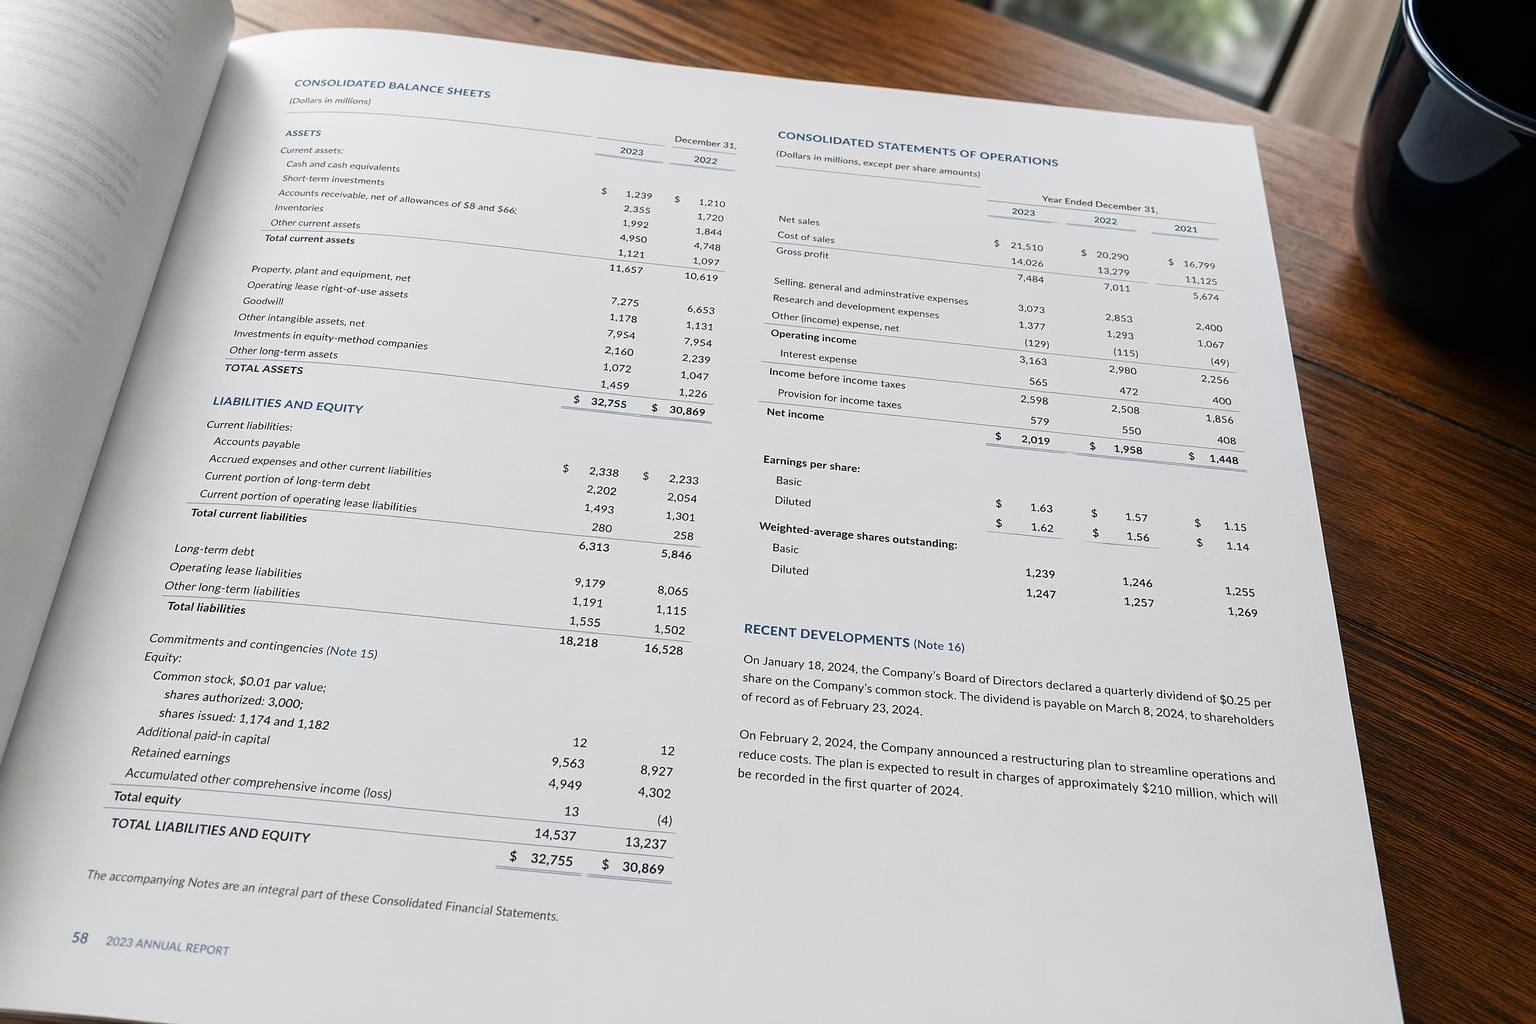
- गलत संरेखित तालिकाएँ। मॉडल गलत पंक्ति या स्तंभ से एक मान पढ़ लेता है, खासकर जब तालिका पृष्ठ विराम (page break) पर फैली होती है या इसमें मिलाए गए सेल (merged cells) होते हैं।
- गलत पढ़े गए चार्ट। मॉडल को सामान्य आकार सही मिल जाता है, लेकिन वह एक विशिष्ट मान, अक्ष लेबल (axis label), या डेटा बिंदु किस श्रृंखला (series) से संबंधित है, इसकी गलत व्याख्या करता है।
- छूटी हुई पादटिप्पणियाँ और अपवर्जन। मॉडल मुख्य संख्या (headline number) तो ढूंढ लेता है, लेकिन उस चेतावनी को छोड़ देता है जो उसे बदल देती है, जो कि प्रारंभिक उदाहरण में वर्णित क्लासिक 'बेनिफिट्स पैकेट' फंदा है।
- गलत गिने गए फ्लोर-प्लान प्रतीक। निर्माण और वास्तुकला दस्तावेज़ों पर, मॉडल दोहराए गए प्रतीकों (आउटलेट, फिक्स्चर, दरवाज़े) की गिनती कम या ज्यादा कर देता है, जिसे एक इंसान हाथ से गिनता।
- स्कैन शोर (Scan noise)। वास्तविक दुनिया के दस्तावेज़ Word से निर्यात किए गए स्वच्छ PDF नहीं होते। वे फोटोकॉपी की फोटोकॉपी, फैक्स किए गए फॉर्म, और भौतिक दस्तावेज़ों के फोन फोटो होते हैं, और इमेज की गुणवत्ता मॉडल की सटीकता को लोगों के अनुमान से ज्यादा कम कर देती है।
- प्रभावी संशोधन। एक दस्तावेज़ पृष्ठ 5 पर एक बात कहता है और पृष्ठ 30 पर एक संशोधन उसे बदल देता है। मॉडल आमतौर पर उस संस्करण से उत्तर देते हैं जो वे पहले देखते हैं, बजाय इस बात के कि वे संघर्ष को हल करें।
इनमें से कोई भी विदेशी किनारे के मामले (exotic edge cases) नहीं हैं। ये पेशेवर कागज़ाती कार्यों की साधारण बनावट हैं। एक लीज़ में ऐडेन्डा (addenda) होते हैं। एक डेटाशीट में रिवीजन इतिहास होता है। एक क्लिनिकल गाइडलाइन में अपडेट मेमो होता है। यदि आपका बेंचमार्क ऐसे आकार के दस्तावेज़ शामिल नहीं करता है, तो यह उस चीज़ को माप नहीं रहा है जिसकी लोगों को वास्तव में आवश्यकता है।
OCR बनाने या चुनने वाले किसी के लिए यह क्यों मायने रखता है
यदि आप OCR या डॉक्यूमेंट AI के ऊपर कोई प्रोडक्ट बना रहे हैं, या किसी वेंडर को चुनने के लिए मूल्यांकन कर रहे हैं, तो GDP.pdf मार्केटिंग दावों के खिलाफ एक उपयोगी वास्तविकता जांच है। "डॉक्यूमेंट VQA पर स्टेट ऑफ द आर्ट" और "एक फुटनोट के साथ एक असली 40-पृष्ठ की पॉलिसी डॉक्यूमेंट के बारे में एक असली सवाल का जवाब देना" अलग-अलग दावे हैं, और यह पेपर दिखाता है कि उनके बीच का अंतर बहुत बड़ा है, न कि मामूली।
प्रैक्टिकल टैकअवे:
- एंड-टू-एंड रिलायबिलिटी के लिए सिंगल-कैपेबिलिटी बेंचमार्क पर भरोसा न करें। एक मॉडल जो टेबल-QA लीडरबोर्ड पर टॉप करता है, फिर भी उस फुटनोट को मिस कर सकता है जो टेबल को ओवरराइड करता है। यदि कोई वेंडर केवल आइसोलेटेड-स्किल स्कोर का हवाला देता है, तो पूछें कि जब स्किल्स को कंपोज करना हो तो क्या होता है।
- मल्टी-मॉडल रीट्राय यहाँ अपना खर्च कमाता है। चूँकि फेलियर मोड मॉडल्स के बीच असंगत हैं (एक के लिए गलत एलाइन की गई टेबल्स, दूसरे के लिए मिस किए गए एमेन्डमेंट), जब पहला जवाब अस्थिर लगता है तो उसी डॉक्यूमेंट को दूसरे या तीसरे इंजन को रूट करना कोई लक्जरी नहीं है, बल्कि किसी भी चीज़ के लिए लगभग आवश्यक है जिस पर असली जोखिम हो।
- अबस्टेंशन (Abstention) टेस्ट करने के लिए एक फीचर है, मानने के लिए नहीं। किसी डॉक्यूमेंट पर मॉडल के जवाब पर भरोसा करने से पहले, जाँचें कि क्या यह वास्तव में "इस डॉक्यूमेंट में नहीं है" बोलता है जब जवाब वहाँ नहीं होता है, बजाय इसके कि आत्मविश्वास के साथ एक बनाता है। GDP.pdf का अबस्टेंशन टियर इसलिए मौजूद है क्योंकि यह वर्तमान में हर जगह एक कमजोर बिंदु है।
- स्कैन क्वालिटी को पाइपलाइन का हिस्सा मानें, न कि बाद की चिंता। स्कैन नॉइस छह बार-बार होने वाले लॉस पैटर्न में से एक था। यदि आपका इंगेस्ट पाइपलाइन मॉडल तक पहुँचने से पहले लो-क्वालिटी स्कैन को साफ़ या फ्लैग नहीं करती है, तो आप एक एरर सोर्स को इनहेरिट कर रहे हैं जिसे आप आंशिक रूप से इंजीनियर करके दूर कर सकते थे।
- एमेन्डमेंट, एक्सक्लूजन, या रिवीजन हिस्ट्री वाली किसी भी चीज़ के लिए ह्यूमन रिव्यू के लिए बजट रखें। ये वही डॉक्यूमेंट हैं जहाँ वर्तमान मॉडल्स सबसे अधिक फेल होते हैं, और वही डॉक्यूमेंट हैं जहाँ गलत जवाब किसी को पैसा या हेल्थ कवरेज खोने का सबसे अधिक खर्च हो सकता है।
मजबूत इंग्लिश OCR का मतलब यह नहीं है कि देवनागरी OCR भी अच्छा होगा; इस पेपर की दायरे में यह अंतर महत्वपूर्ण है।
यह बेचमार्क आपको क्या नहीं बताता
कुछ ईमानदार चेतावनियां। सौ प्रश्न एक छोटा बेचमार्क हैं। यह विफलता के स्वरूप के बारे में एक मजबूत बिंदु रखने के लिए पर्याप्त है (दस पेशेवर क्षेत्रों में छह बार दोहराए जाने वाले पैटर्न एक सार्थक संकेत हैं), लेकिन यह आपको किसी भी दिए गए मॉडल के लिए इस प्रकार की कार्यप्रणाली में "सटीकता" की संख्या के रूप में उद्धृत करने के लिए एक सटीक, स्थिर प्रतिशत देने के लिए पर्याप्त नहीं है। छोटे बेचमार्क भी इस बात के प्रति अधिक संवेदनशील होते हैं कि कौन से विशिष्ट दस्तावेज और प्रश्न चयनित किए गए थे, भले ही दो-मॉडल-विफलता फ़िल्टर लागू हो।
दो-मॉडल-विफलता चयन नियम वास्तव में कठिन, सार्थक प्रश्नों को उजागर करने के लिए समझदार है, लेकिन इसका अर्थ यह भी है कि बेचमार्क आज के मॉडल्स के लिए स्पष्ट रूप से कठिन बनाया गया है। यही उद्देश्य है, लेकिन इसका मतलब यह है कि 15%/1% की संख्याएं प्रतिद्वंद्वी रूप से चयनित प्रश्नों की ऊपरी सीमा का वर्णन करती हैं, न कि "पेशेवरों द्वारा आमतौर पर पूछे जाने वाले प्रश्नों" का यादृच्छिक नमूना। वास्तविक दुनिया में सटीकता, जिसमें एक लाभ प्रशासक या निर्माण अनुमानकर्ता दिन-प्रतिदिन आसान और कठिन प्रश्नों का पूरा मिश्रण पूछता है, 15% से अधिक होगी, बस मार्केटिंग आमतौर पर जो सुझाती है, उतनी नहीं।
और सात मॉडल्स, एक बार मूल्यांकित, सौ आइटमों पर, एक स्नैपशॉट है, ट्रेंड लाइन नहीं। मॉडल्स तेजी से बदल रहे हैं, और यह विशिष्ट 15% की ऊपरी सीमा संभवतः बढ़ेगी। जो अधिक टिकाऊ है वह वर्गीकरण है: ग्यारह क्षमताएं और छह नुकसान के पैटर्न किसी भी दस्तावेज़ AI प्रणाली का मूल्यांकन करने के लिए वास्तव में उपयोगी चेकलिस्ट हैं, चाहे वह आज की हो या अगले साल की, क्योंकि ये उन संरचनात्मक खालियों स्थानों का वर्णन करती हैं जिनमें ये मॉडल्स वास्तविक कागजातों पर आधारित, बहु-भाग तर्क को संभालते हैं, न कि केवल स्कोरबोर्ड जो छह महीने में पुराना हो जाएगा।
ईमानदार सारांश: पेशेवर PDFs बेचमार्क द्वारा दिखाए गए से कठिन हैं, उद्योग गलत अक्ष पर ग्रेडिंग कर रहा था, और GDP.pdf सही अक्ष पर ग्रेडिंग करने की एक ठोस पहली कोशिश है।