تقسيم الكلمات المكتوبة بخط اليد باللغة البنغالية دون تعلم عميق: تحليل متعمق في معالجة الصور
استنادًا إلى: Color Independent Word Segmentation From Transcribed Bangla Passages — Faias Satter, Noor Masrur, Sk. Md. Masudul Ahsan
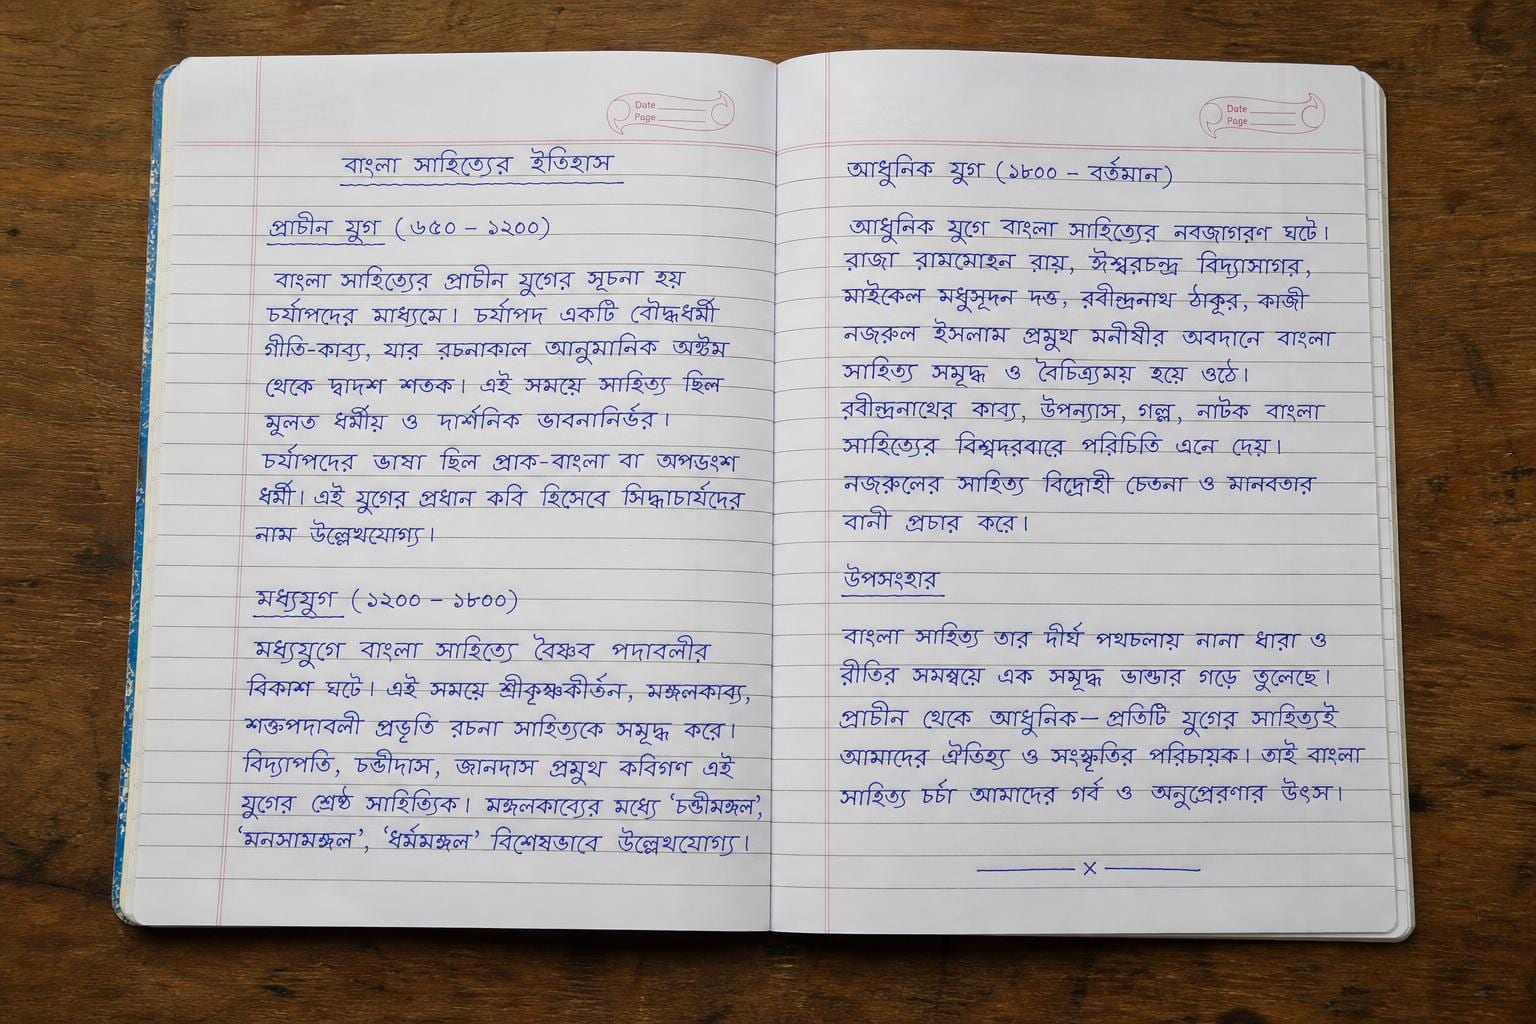
إذا التقطت صورة لنص مكتوب بخط اليد باللغة البنغالية، فإن التحدي الذي تتصدى له هذه الدراسة يظهر حتى قبل الشروع في التعرف على كلمة واحدة؛ إذ يتعين على خوارزمية التقسيم (Segmentation) أن تقرر أي ضربات الحبر تنتمي معًا، وأين تنتهي كل كلمة وأين تبدأ الكلمة التالية. بيد أن الكُتّاب من البشر لا يتركون دائمًا الفواصل والمساحات التي تجعل اتخاذ هذه القرارات أمرًا يسيرًا.
فالكلمات المتقاربة قد تندمج في منطقة كشف واحدة، بينما قد تجعل المحارف والعلامات المنفصلة الكلمة الواحدة تبدو وكأنها كلمات متعددة.
ويشير مؤلفو الورقة البحثية إلى ندرة أنظمة التعرف الضوئي على الحروف (OCR) الموثوقة للخط البنغالي اليدوي. وينصب تركيز أبحاثهم على تقسيم الكلمات (Word segmentation)—وهي المرحلة التي تُجزئ صورة الصفحة إلى مناطق مستقلة لكل كلمة. وأي خطأ يقع هنا قد يجعل مراحل التعرف اللاحقة تتعامل مع كلمات غير مكتملة أو عدة كلمات مدمجة معًا في قصاصة واحدة.
وفي ورقتهم البحثية المعنونة Color Independent Word Segmentation From Transcribed Bangla Passages، يتصدى الباحثون Faias Satter وNoor Masrur وSk. Md. Masudul Ahsan من جامعة Khulna University of Engineering & Technology (KUET) لعنق الزجاجة هذا عبر مسار عمل تكيفي يعتمد على معالجة الصور الكلاسيكية. حيث اختبروا مستندات ملتقطة بكاميرات الهواتف الذكية تتضمن ألوان ورق مختلفة، وأنواع أقلام متعددة، وتداخلات للظلال، مستخرجين مربعات الكلمات (Word boxes) عبر أسلوب ارتيادي يعتمد على العد التكراري للخطوط المحيطية (Contour counting). وقد رُفعت المسوّدة إلى موقع arXiv في 1 أكتوبر 2026، وتُعرّف نفسها بأنها النسخة المقبولة للنشر في مؤتمر 2023 International Conference on Electrical Information and Communication Technology (EICT).
نستعرض هنا تفكيكًا هندسيًا لأسباب تعقيد تقسيم الخط البنغالي اليدوي، وكيف صمم فريق KUET مسار عملهم، وما تُثبته النتائج المُعلنة في بحثهم.
الهندسة البصرية للخط المكتوب بخط اليد
لفهم مشكلة التقسيم، لا بد من النظر في الطوبوغرافيا المادية للخط.
تتصل العديد من المحارف البنغالية داخل الكلمة الواحدة عبر خط أفقي يُعرف باسم الماترا (matra). ورغم أن هذا الاتصال يسهم في تماسك الكلمة كمنطقة صورية متصلة، إلا أن بعض المحارف أو العلامات لا تحتوي على ماترا، كما أن الكتابة اليدوية لا تحافظ دائمًا على اتصال مستمر.
وتفصل الورقة ثلاثة تعقيدات متكررة:
- المحارف والعلامات الخالية من الماترا تُحدث فواصل كلمات خاطئة. يُحدد المؤلفون علامات مثل '◌ঃ' و'◌ং' و'◌ঁ' كمصادر محتملة لأخطاء التجزئة؛ إذ إن الروابط المفقودة أو الفجوات داخل الكلمة قد تؤدي إلى ترك مكوناتها في مناطق كشف متفرقة.
- العلامات المنفصلة تُعقد حدود الكلمات. قد تُصعّب حركات العلة وعلامات التشكيل مثل '◌ু' و'◌ূ' و'ি◌' و'◌ী' و'ৈ◌' و'ে◌ৗ' فصل الكلمات المتجاورة. ويصف الباحثون حالات تُبتلع فيها أجزاء من الكلمة لتنضم إلى كلمة أخرى، بالإضافة إلى استبعاد العلامات المتباعدة عن المربع المحيط بكلمتها الأصلية.
- تفاوت المسافات الفاصلة بين الكلمات. يترك بعض الكُتّاب مسافات ضئيلة للغاية بين الكلمات والسطور، في حين يكتب آخرون بأسلوب متناثر بفجوات واسعة بين محارف الكلمة الواحدة. وعليه، فإن أي ضبط إعدادات ينجح في دمج الحروف المنفصلة لكاتب معين قد يتسبب في دمج الكلمات المتجاورة لكاتب آخر.
وفضلًا عن ديناميكيات الخط ذاته، تُضيف عملية التقاط المستندات فوضى مادية حقيقية؛ إذ تشتمل الدراسة على صور التُقطت بالهواتف الذكية مع تداخل الظلال، وتفاوت أبعاد الصور ودقتها، واستخدام أحبار ملونة وأوراق ذات ألوان وخامات متعددة. هذه الظروف استدعت بناء مسار عمل يحدد إعدادات التصفية وتحديد العتبة ديناميكيًا من الصورة نفسها، بدلًا من تطبيق إعدادات ثابتة على جميع الصفحات.
المرحلة 1: تحويل فوضى كاميرا الهاتف إلى بكسلات مستقرة
نظّم فريق KUET حلهم في مسار عمل متسلسل من ست مراحل، ينتقل بالبيانات من البكسلات الأولية إلى مناطق الكلمات المحددة بمربعات إحاطة، دون تنفيذ مرحلة منفصلة لتقسيم السطور.
تتمثل الخطوة الأولى في تحويل الصورة المدخلة إلى التدرج الرمادي (Grayscale). ويوضح الباحثون أنه على الرغم من أن المسح المباشر بالأبيض والأسود أسرع، إلا أنه قد يؤدي إلى فقدان بعض تفاصيل المحارف. وبناءً على ذلك، يوفر التدرج الرمادي نقطة الانطلاق لمراحل التصفية وتحديد العتبة اللاحقة.
تلي ذلك مرحلة تقليل الضوضاء التكيفي. ونظرًا لاختلاف دقة الصور باختلاف الأجهزة الملتقطة، وتفاوت أحجام المحارف باختلاف الكُتّاب، استخدم المؤلفون مقياسًا خاصًا بكل صورة يُسمى متوسط حجم الخط المحيطي (Average Contour Size - ACS) لتحديد إعدادات التصفية.
ولحساب قيمة ACS الأولية:
- يُجري النظام مرحلة أولية لإزالة الضوضاء باستخدام نواة غاوسية (Gaussian kernel) بحجم 21 × 21 بكسل. وتحدد الورقة الانحراف المعياري في الاتجاه الرأسي بقيمة 21 وعامل قياس قدره 7.
- يطبق عتبة تكيفية أولية بنافذة قياسها 21 × 21.
- يستخرج الخطوط المحيطية الأولية، مستبعدًا الخطوط ذات المساحة الأقل من 50 باعتبارها ضوضاء ملحية (Salt noise).
- تُوفر مساحات الخطوط المحيطية المتبقية قيمة ACS التي تُستخدم لاحقًا لاختيار أحجام النوى.
وبمجرد تحديد قيمة ACS للمستند، تصف الورقة مرحلة التنعيم التالية بأنها إزالة الضوضاء بالمتوسطات غير الموضعية (Non-local Means Denoising). كما تقدم معادلة لنواة التنعيم باستخدام متغيرات الإحداثيات $x$ و$y$، مع تعريف $\sigma$ كجذر تربيعي لحجم النواة. ويُستمد حجم النواة نفسه من جدول بحث تجريبي يعتمد على ACS.
وبدلًا من تثبيت أبعاد النواة، يربط المؤلفون قيمة ACS المحسوبة بأحجام مختلفة:
- إذا كانت قيمة ACS أقل من 200، تُستخدم نواة بحجم 3 × 3.
- من 200 وحتى أقل من 300، تُستخدم نواة بحجم 5 × 5.
- تزداد الأحجام المذكورة بمقدار 2 عبر نطاقات متتالية من ACS بمقدار 100 وحدة حتى 1000، لتصل إلى 19 × 19 لنطاق $900 \le \text{ACS} < 1000$.
- وتستخدم الإدخالات التالية نواة 21 × 21 للنطاق $1000 \le \text{ACS} < 1200$، ونواة 23 × 23 للنطاق $1200 \le \text{ACS} < 1400$.
وللقيم التي تتجاوز الجدول، يوضح المؤلفون زيادة حجم النواة بمقدار 2 لكل 200 وحدة إضافية من ACS.
كما يأخذ الباحثون سطوع خلفية الصفحة في الحسبان؛ إذ أشاروا إلى انخفاض الضوضاء الملحية في الخلفيات الفاتحة ذات قيم البكسل المتراوحة بين 181 و255، وزيادتها كلما أصبحت الخلفية أكثر قتامة. وبالنسبة لقيم الخلفية بين 101 و180، يزيدون حجم النواة المختار بمقدار 2، وللقيم الأقل من 100، يزيدونه بمقدار 4.
تعد هذه الخيارات تجريبية وصُممت خصيصًا للنظام المقترح، وهي تُكيف التصفية وفقًا لمقياس الخط المحيطي المقدر وسطوع الخلفية، دون أن تؤسس لعلاقة شاملة وثابتة بين لون الورق وقوة التنعيم المطلوبة.
المرحلة 2: اختبار الظلال والتحويل الثنائي التكيفي
بعد التنعيم، يجب تحويل الصورة إلى تمثيل ثنائي (Binary representation). ويُوحّد مسار العمل في النهاية هذا التمثيل ليظهر كضربات بيضاء في المقدمة على خلفية سوداء.
يُفاضل الباحثون بين تحديد العتبة الشامل باستخدام طريقة أوتسو (Otsu's method)، وتحديد العتبة التكيفي (Adaptive thresholding). ويُفضلون استخدام أوتسو عندما تكون عتبة واحدة كافية للصورة، بينما يقع الاختيار على العتبة التكيفية في حالات الخلفيات الملونة أو تداخل الظلال.
ينطوي هذا الاختيار على موازنة تقنية؛ حيث تشير الورقة إلى أن تحديد العتبة التكيفي قد يُفتت المحارف نظرًا لعمله ضمن نوافذ محلية، مما قد يؤدي إلى استبعاد أجزاء من الكلمة من خطها المحيطي المكتشف. في المقابل، تُفضل طريقة أوتسو في ظل الظروف المناسبة لأنها تتفادى هذا التفتت وفقًا لرؤية الباحثين.
يُجري مسار عمل KUET فحصًا لتداخل الظلال قبل اعتماد طريقة التحويل الثنائي:
$$\frac{\text{Area of largest contour}}{\text{Average Contour Size}} > 100$$
يطبق النظام عتبة أوتسو ويقيس أكبر خط محيطي ناتج؛ فإذا تجاوزت مساحته 100 ضعف قيمة ACS، يتعامل مسار العمل مع الصورة على أنها تعاني من تداخل الظلال. هذه النسبة هي أسلوب تجريبي اعتمده المؤلفون للكشف، ولا تجزم الورقة بأن كل خط محيطي كبير يمثل بالضرورة ظلًا.
وبناءً على هذا الاختبار وشدة إضاءة بكسلات الخلفية، تتفرع استراتيجية التحويل الثنائي:
- الورق الملون أو الداكن، بقيم بكسل أقل من 180: يُستخدم تحديد العتبة التكيفي.
- الورق الفاتح، بقيم بكسل تبلغ 180 فما فوق: يُستخدم تحديد العتبة التكيفي في حال اكتشاف تداخل الظلال؛ وبخلاف ذلك، يُستخدم تحديد عتبة أوتسو.
ويُستمد حجم نافذة العتبة التكيفية من جدول بحث ACS.
وعقب تحديد العتبة، تُعكس قيم البكسل عند الحاجة، لينتج عن ذلك ضربات بيضاء موحدة في المقدمة فوق خلفية سوداء. ثم تمر الصورة عبر كشف الحواف بمرشح كاني (Canny edge detection) وتحويل هاف (Hough transform) لتحديد البنى المتسامتة (Co-linear structures) المستخدمة في تصحيح ميلان الصفحة (Skew correction).
ولا تقوم مرحلة تصحيح الميلان هذه بتقسيم الصفحة إلى صور أسطر نصية منفصلة، بل يظل كشف الكلمات يعمل دون الحاجة إلى مرحلة مسبقة لتقسيم السطور.
المرحلة 3: التمديد المورفولوجي ونقطة التوقف عند ذروة الخطوط المحيطية
وهنا يبرز التحدي المحوري: تجميع ضربات المحارف المنفصلة والعلامات المتناثرة في كيانات تمثل كلمات مستقلة دون ردم الفجوات الفاصلة بين الكلمات المتجاورة.
يعتمد الباحثون على علم المورفولوجيا الرياضية (Mathematical morphology)—وتحديدًا التمديد (Dilation) باستخدام عنصر هيكلي مربع (Structuring element) ببكسلات بيضاء في المقدمة. يعمل التمديد على توسيع مناطق المقدمة، مما يسهم في دمج أجزاء الكلمة الواحدة، إلا أن الإفراط في التمديد قد يؤدي أيضًا إلى وصل الكلمات المجاورة ببعضها.
ويعد تحديد نقطة التوقف هو التحدي التقني الجوهري، والذي عالجه المؤلفون عبر حد أدنى لمساحة العتبة يُدعى (Minimum Area Threshold - MAT) مقترنًا ببحث قائم على العد التكراري للخطوط المحيطية.
تعريف ما يُعد كلمة
قبل أن يتمكن النظام من حصر الكلمات المرشحة، يحتاج إلى قاعدة للاحتفاظ بالخطوط المحيطية. وتُعد المناطق المتصلة التي تتجاوز مساحتها قيمة MAT مرشحة وتستحق وضع مربعات إحاطة حولها.
ولا يضمن اجتياز عتبة المساحة احتواء المنطقة على كلمة واحدة كاملة بالضبط، وإنما هو مجرد معيار ترشيح يعتمده مسار العمل.
ويعتمد حساب MAT على طريقة التحويل الثنائي التي تم اختيارها مسبقًا:
- بعد تحديد عتبة أوتسو: يحسب المؤلفون قيمة MAT مباشرة من ACS:
$$\text{MAT} = \frac{\text{Average Contour Size}}{1.25}$$
- بعد تحديد العتبة التكيفي: يأخذ الباحثون في الحسبان تفتت الخطوط المحيطية عبر مقياس يُسمى كثافة الكتابة (Writing Density - WD):
$$\text{Writing Density} = \frac{\text{Total area of the page}}{\text{Average Contour Size}}$$
تُفسر الورقة زيادة قيمة WD بأنها تعني كتابة أقل كثافة؛ إذ تعبر صيغتها عن مساحة الصفحة بالنسبة لمتوسط مساحة الخط المحيطي، بدلًا من قياس الفجوات بين الكلمات مباشرة.
ويربط النظام قيمة WD بصيغة تجريبية لحساب MAT. ويتراوح الجدول بين $\text{ACS} - \frac{\text{ACS}}{4}$ عندما تكون $\text{WD} < 1500$، و$\text{ACS} \times 6$ عندما تكون $\text{WD} \ge 10000$. وتستخدم النطاقات البينية مضاعفات وتعديلات كسرية أخرى لـ ACS.
ويطبق جدول ثانٍ تعديلات إضافية لتوافقات معينة بين WD وACS. وتتضمن القواعد المذكورة طرح $\frac{\text{ACS}}{8}$ عندما تكون $\text{WD} > 2000$ و$\text{ACS} > 700$، وإضافة مقادير مستندة إلى ACS في نطاقات محددة تتسم بارتفاع قيم كل من WD وACS معًا.
تعد عمليات الربط هذه أجزاءً مختارة تجريبيًا ضمن المنهجية، والغرض منها هو الموازنة بين الإبقاء على مكونات الكلمة من جهة، وتفادي قبول الشظايا الصغيرة أو دمج المناطق الكبيرة من جهة أخرى.
البحث عن ذروة عدد الخطوط المحيطية
بعد تحديد قيمة MAT، يُحدد النظام الحجم الأولي لنواة التمديد استنادًا إلى قيمة ACS. وتبدأ الإدخالات المجدولة بحجم 1 × 1 لقيم ACS الأقل من 100، وحجم 3 × 3 للنطاق $100 \le \text{ACS} < 1000$. وتحصل نطاقات ACS الأكبر على نوى ابتدائية أكبر، مع وجود بعض الفروق بين مسار أوتسو ومسار العتبة التكيفية.
فعلى سبيل المثال، يخصص الجدول نواة ابتدائية بحجم 9 × 9 بعد أوتسو ونواة 11 × 11 بعد العتبة التكيفية عندما يكون $2000 \le \text{ACS} < 2200$. وتصل إدخالات العتبة التكيفية المدرجة إلى 13 × 13 للنطاق $2400 \le \text{ACS} < 2600$، دون أن يُطرح ذلك كحد أقصى لجميع الصور.
تُمدد الخوارزمية الصورة الثنائية بالنواة الابتدائية لتكرار واحد، وتحصي الخطوط المحيطية التي تتجاوز مساحتها قيمة MAT. ثم تختبر إعدادات أخرى عبر زيادة عدد التكرارات أو حجم النواة، مع إعادة عد الخطوط المحيطية المحتفظ بها.
ويعتمد هذا الأسلوب الارتيادي لعد الخطوط المحيطية على أثرين متزامنين:
- المكونات المنفصلة قد تتحد لتشكل مناطق كبيرة كفاية لتتجاوز عتبة MAT، مما يزيد من عدد الكلمات المرشحة المحتفظ بها.
- مناطق الكلمات المتجاورة قد تندمج مع استمرار التمديد، مما يقلل من إجمالي عدد الخطوط المحيطية.
ويوضح الباحثون أنهم يبحثون عن أقصى عدد من الخطوط المحيطية ويتوقفون قبل أن يتسبب التمديد الإضافي في تصادم الكلمات واندماجها. وهذا الأسلوب يعد حدسًا تجريبيًا لاختيار إعدادات التمديد؛ ولا يضمن بالضرورة اكتمال كل كلمة أو بقاء كل زوج متجاور منفصلًا عند النقطة المختارة.
وفي أحد الأمثلة الموثقة في الشكل 4 من الورقة، تبدأ صورة بقيمة ACS تبلغ 641 بنواة تمديد قياسها 3 × 3. ويؤدي استخدام هذه النواة عبر 3 تكرارات إلى إنتاج 33 كلمة مكتشفة عند الإعداد الأمثل الموضح، في حين أن تطبيق نواة 10 × 10 عبر تكرارين لم ينتج سوى 23 كلمة فقط.
وفي النهاية، تُوضع مربعات إحاطة مستطيلة حول الخطوط المحيطية للكلمات المحتفظ بها عند الإعداد المختار.
المعايير المرجعية: الاختبار على ثلاث مجموعات بيانات متباينة
لتقييم نهجهم، اختبر فريق KUET مسار العمل عبر ثلاث مجموعات وثائق: مجموعة بيانات مخصصة أُنشئت لهذا المشروع، ومجموعة CMATERdb1.1.1، والمجموعة التي تشير إليها الورقة باسم Bangla Writing dataset.
1. مجموعة البيانات المخصصة المكونة من 80 وثيقة
لتقييم ظروف الالتقاط المتنوعة، أنشأ الباحثون مجموعة بيانات تضم 80 وثيقة تغطي أساليب خطية مختلفة، كُتبت على أوراق بيضاء وحمراء وزرقاء وخضراء وسوداء. واستخدموا أقلام جيل، وحبر جاف، وأقلام براقة بألوان مختلفة شملت الأسود والأحمر والأخضر والأزرق.
كما أضافوا تداخلات للظلال واستخدموا أجهزة التقاط متعددة لتتفاوت الصور في الحجم والدقة.
وتفيد الورقة بالنتائج التالية:
- الكلمات الفعلية (Ground truth words): 7,374
- مربعات الإحاطة المُولدة: 7,278
- الكلمات المقسمة بشكل صحيح: 6,681
- أخطاء التقسيم: 527 كلمة، مصنفة كتقسيم ناقص، أو تقسيم مفرط، أو تقسيم معيب
- الكلمات غير المكتشفة: 166
- التذكر (Recall): 90.60%
- الدقة (Precision): 91.80%
- مقياس F1-score: 91.20%
تُظهر هذه النتائج فاعلية المنهجية على مجموعة البيانات التي أعدها الباحثون والتي تتسم بتنوع الألوان ووجود الظلال؛ لكنها لا تؤكد إمكانية التقسيم الموثوق لكل تركيبة محتملة من الورق والحبر والخط اليدوي والإضاءة.
2. معيار CMATERdb1.1.1 المرجعي
شغّل الباحثون مسار العمل على 100 وثيقة من مجموعة CMATERdb1.1.1، حيث تم توليد 15,587 مربع إحاطة من أصل 15,730 كلمة:
- المقسمة بشكل صحيح: 13,552 كلمة
- أخطاء التقسيم: 2,048 كلمة
- غير المكتشفة: 130 كلمة
- التذكر (Recall): 86.15%
- الدقة (Precision): 86.94%
- مقياس F1-score: 86.54%
وعلى سبيل المقارنة، تذكر الورقة أن دراسة Sarkar et al. (2011) حققت نسبة نجاح في تقسيم الكلمات بلغت 86.01%: أي 13,530 كلمة مقسمة بشكل صحيح من أصل 15,730 كلمة، مع وجود 2,200 كلمة عانت إما من تقسيم ناقص أو تقسيم مفرط.
ويكتسب التمايز في مدخلات البيانات أهمية خاصة هنا؛ فوفقًا لورقة KUET، استخدمت دراسة Sarkar et al. صور وثائق مُقسمة مسبقًا إلى أسطر نصية، بينما لا تتطلب الطريقة المقترحة مرحلة المعالجة المسبقة تلك.
ورغم أن معدل التذكر المعلن للطريقة المقترحة أعلى قليلًا من نسبة النجاح السابقة، إلا أن اختلاف ظروف المدخلات يعني أن هذه المقارنة لا تعد إثباتًا قاطعًا لتفوق الأداء في ظل ظروف معيارية متطابقة.
3. مجموعة بيانات Bangla Writing
خضع النظام أيضًا للتقييم على 100 وثيقة من مجموعة بيانات Bangla Writing:
- إجمالي الكلمات الموجودة: 7,400
- مربعات الإحاطة المُولدة: 7,191
- المقسمة بشكل صحيح: 6,380 كلمة
- أخطاء التقسيم: 987 كلمة
- غير المكتشفة: 33 كلمة
- التذكر (Recall): 86.22%
- الدقة (Precision): 88.72%
- مقياس F1-score: 87.45%
وتوضح الورقة أن Das et al. (2023) عملوا على جزء من مجموعة البيانات هذه باستخدام مقاطع الإسقاط الأفقي (Horizontal projection profiles)، ونحت الفواصل (Seam carving)، وتتبع الخطوط المحيطية (Contour tracing). وكانت نتائجهم المعلنة: 88.39% لدقة تقسيم السطور، و95.65% لدقة تقسيم الكلمات، و84.55% لمتوسط الدقة.
وقد وضع جدول المقارنة في ورقة KUET متوسط الدقة البالغ 84.55% إلى جانب مقاييس التذكر، والدقة، ودرجة F1 للطريقة المقترحة. ونظرًا لاختلاف هذه المقاييس واستخدام التقييمات لأجزاء متباينة من مجموعة البيانات، فلا ينبغي اعتبار درجة F1 البالغة 87.45% تحسنًا مباشرًا مقارنة بمتوسط الدقة السابق.
أوجه قصور مسار العمل: أربعة أنماط للأخطاء
نظرًا لأن الخوارزمية تعتمد على الخصائص الهندسية للصورة بدلًا من التعرف على النص ذاته، فإن حالات الفشل المسجلة ترتبط بحالات هندسية حدّية (Edge cases). ويصنف المؤلفون هذه الإخفاقات إلى أربعة أنماط من الأخطاء.
وتتبع التسميات أدناه مصطلحات الورقة البحثية؛ حيث تُطلق على تجزئة الكلمة الواحدة مصطلح التقسيم الناقص (Under-segmentation) وعلى دمج الكلمات مصطلح التقسيم المفرط (Over-segmentation):
- خطأ التقسيم الناقص (تجزئة الكلمة - Word splitting): انقسام الكلمة الواحدة إلى مربعين أو أكثر من مربعات الإحاطة. ويربط الباحثون ذلك بغياب خطوط الماترا الرابطة، أو اتساع الفجوات غير المعتاد بين الحروف الداخلية، والعلامات الخالية من الماترا مثل '◌ঃ' و'◌ং' و'◌ঁ'.
- خطأ التقسيم المفرط (دمج الكلمات - Word merging): احتواء مربع إحاطة واحد على كلمتين أو أكثر. وتزداد احتمالية هذا الخطأ في الكتابة اليدوية الكثيفة التي تفتقر إلى مسافات فاصلة كافية بين الكلمات أو السطور.
- خطأ التقسيم المعيب (استبعاد العلامات - Excluded marks): إحاطة المربع بالكلمة مع ترك جزء منها في الخارج. وتطرح الورقة أمثلة تتضمن حركات العلة وعلامات أخرى مثل '◌া' و'ি◌' و'◌ঁ' و'◌ৃ' و'◌ী'، لا سيما عندما تُكتب بعيدة عن المتن الرئيسي للكلمة.
- خطأ الإغفال (الكلمات المفقودة - Missed words): إسقاط الكلمة بالكامل من المخرجات. ويوضح المؤلفون أن الكلمات ذات المساحة الصغيرة تكون عرضة للاستبعاد عند رفع الحد الأدنى لعتبة المساحة.
وتولد هذه الأخطاء ضغوط ضبط متضاربة؛ إذ قد يساعد استخدام نواة تمديد ابتدائية أصغر أو خفض قيمة MAT في معالجة الصفحات المكتوبة بكثافة، لكن الباحثين يذكرون أن هذه الخيارات قد تزيد من أخطاء التجزئة في الكتابة المتناثرة. كما قد تتسبب نواة التمديد الأصغر في استبعاد العلامات المتباعدة خارج مربع الكلمة.
كما تُمثل علامات الترقيم تعقيدًا آخر؛ حيث توضح الورقة أن علامات مثل علامة نهاية الجملة البنغالية (daari: '।') والفواصل قد تُكتشف مدمجة مع الكلمات المجاورة، بينما قد تحظى بمربعات إحاطة مستقلة في أساليب كتابية أخرى.
وأخيرًا، قد تتسبب الخلفية المحيطة بالورقة في توليد اكتشافات خاطئة عندما تتشابه قيم بكسلاتها مع بكسلات المحارف؛ لذا يقترح المؤلفون قص الصورة لإزالة تلك الخلفية.
أهمية هذا البحث في تحليل المستندات وأنظمة التعرف الضوئي على الحروف (OCR)
تُقدم ورقة KUET نموذجًا تفصيليًا لتقسيم الكلمات مبنيًا على عمليات معالجة الصور الكلاسيكية. وتتمثل مساهمتها في ابتكار منهجية لتوليد مناطق الكلمات، تم تقييمها من خلال تعدادات ومقاييس التقسيم.
ولا تُقيم الورقة مرحلة التعرف على الكلمات داخل تلك المناطق؛ وهو تمايز يكتسب أهمية بالغة عند تفسير النتائج، إذ إن القصاصة المقسمة بدقة تمثل مدخلًا للمراحل اللاحقة من نظام OCR، وليست دليلًا على نسخ النص بنجاح. وتتضاعف هذه التحديات في نصوص كالخط العربي؛ حيث تجعل طبيعته المتصلة من اليمين إلى اليسار، وتغير أشكال حروفه بحسب موقعها وسياقها، والتراكيب الحرفية (Ligatures) وعلامات التشكيل، مهمة التقسيم والتعرف الضوئي أكثر تعقيدًا بكثير.
الاستغناء عن الاعتماد على تقسيم السطور
يمكن لمسار عمل التقسيم التقليدي أن يسير وفق تسلسل هرمي مثل:
$$\text{Page} \longrightarrow \text{Text Lines} \longrightarrow \text{Words} \longrightarrow \text{Characters}$$
وفي مثل هذا المسار، يمكن لأخطاء تقسيم السطور أن تنعكس سلبًا على استخراج الكلمات لاحقًا. وتبرز مناقشة الورقة للدراسات السابقة صعوبات جمّة عند تداخل السطور المكتوبة بخط اليد أو عند تباين امتداداتها بدرجة كبيرة.
وتستخرج الطريقة المقترحة مناطق الكلمات دون تجزئة الوثيقة أولًا إلى أسطر منفصلة؛ إذ يرى الباحثون أن ذلك يجنب استخراج الكلمات التبعية لنجاح مرحلة تقسيم السطور.
ومع ذلك، فإن هذا لا يلغي الأخطاء الناجمة عن تكدس الكلمات والسطور؛ إذ لا تزال تلك الحالات حاضرة في تحليل الإخفاقات بالورقة. وتكمن الفائدة الحقيقية في التخلص من مرحلة المعالجة المسبقة المستقلة تلك، وليس في ضمان حصر أخطاء التقسيم في زوج واحد من الكلمات.
معالجة كلاسيكية دون معيار مرجعي لزمن التشغيل
يستخدم مسار العمل الموصوف التحويل إلى التدرج الرمادي، وإزالة الضوضاء، وتحديد العتبة، وكشف الحواف بمرشح كاني، وتحويل هاف، والتمديد المورفولوجي؛ ولا يشكل أي نموذج للتعلم العميق جزءًا من طريقة التقسيم المقترحة.
وهذا ما يجعل الورقة نموذجًا تطبيقيًا مفيدًا للنهج الكلاسيكي؛ بيد أنها لا تُثبت سرعة معينة في التنفيذ أو تكلفة محددة للنشر والتشغيل.
فالدراسة تُورد نتائج التقسيم، لكنها لا تقدم أي معيار مرجعي لزمن التشغيل (Runtime)، أو استهلاك الذاكرة، أو استخدام الطاقة، أو الأداء على الأجهزة المحمولة. وتُشير صور الهواتف الذكية إلى مصدر المدخلات فقط، ولا تُثبت أن المعالجة أُجريت فعليًا على هاتف ذكي.
وعليه، فإن أي ادعاءات بشأن إمكانية التنفيذ في أجزاء من الثانية، أو ملاءمة الأداء للهواتف منخفضة المواصفات، أو الحفاظ على طاقة البطارية، أو التفوق على الأنظمة العصبية، ستكون بمثابة استنتاجات تتجاوز الأدلة المعروضة في البحث.
حدود جداول البحث التجريبية
تكشف الورقة أيضًا عن متطلبات الضبط المعقدة التي يفرضها هذا النهج.
إذ تربط جداول التعيين قيم ACS وWD بنوى التنعيم، وعتبات المساحة، ونوى التمديد الابتدائية. وتعتمد هذه الجداول على فترات متقطعة (Discrete intervals)؛ فالقيمة 299 لـ ACS تختار نواة تنعيم 5 × 5، بينما تختار القيمة 301 نواة 7 × 7.
ويعني ذلك أن أي تغيير طفيف يعبر حدود الجدول قد يُغير معامل المعالجة بالكامل. ولا تقيس الورقة مدى الحساسية عند تلك الحدود، ولا تُثبت إمكانية نقل جداول التعيين هذه بثقة لتعمل على كل ظرف التقاط جديد.
ويُظهر تحليل الأخطاء الذي قدمه المؤلفون أسباب صعوبة الضبط؛ إذ يمكن لزيادة التمديد أن تدمج الأجزاء المنفصلة من الكلمة الواحدة مع التسبب في دمج الكلمات المتجاورة في الوقت ذاته. كما أن رفع عتبة المساحة قد يؤدي إلى استبعاد الكلمات الأصغر، وتدفع أساليب الخط اليدوي المختلفة بهذه الإعدادات في اتجاهات متضاربة.
وتظل التحسينات المقترحة وثيقة الصلة بحالات الفشل المرصودة؛ إذ يقترح الباحثون معالجة متداخلة لمربعات الإحاطة التي تضم عدة كلمات، مع إجراء ضبط أكثر دقة لأحجام مرشحات العتبة التكيفية والتمديد. وبالنسبة للكلمات التي تكاد تنعدم الفجوات بينها، يقترحون أيضًا نموذج تعلم آلي مدربًا على كلمات القاموس.
وتبقى هذه المقترحات توجهات مستقبلية وليست امتدادات خضعت للتقييم ضمن مسار العمل المنشور.
يقدم Satter وMasrur وAhsan دليلًا عمليًا على قدرة مسار عمل كلاسيكي وتكيفي على تقسيم النصوص البنغالية المكتوبة بخط اليد عبر عدة مجموعات بيانات، بما في ذلك مجموعتهم من الصور الفوتوغرافية التي تتضمن أوراقًا ملونة وظلالًا متداخلة. وتُمثل خوارزمية البحث المعتمدة على عد الخطوط المحيطية، إلى جانب التحليل التفصيلي للإخفاقات، إسهامًا ملموسًا في مجال تقسيم الكلمات—ونقطة انطلاق لمراحل التعرف اللاحقة اللازمة لتحويل تلك المربعات إلى نصوص قابلة للتحرير.