डीप लर्निंग के बिना हस्तलिखित बांग्ला का सेगमेंटेशन: इमेज प्रोसेसिंग का एक गहन तकनीकी विश्लेषण
आधारित शोध-पत्र: Color Independent Word Segmentation From Transcribed Bangla Passages — Faias Satter, Noor Masrur, Sk. Md. Masudul Ahsan
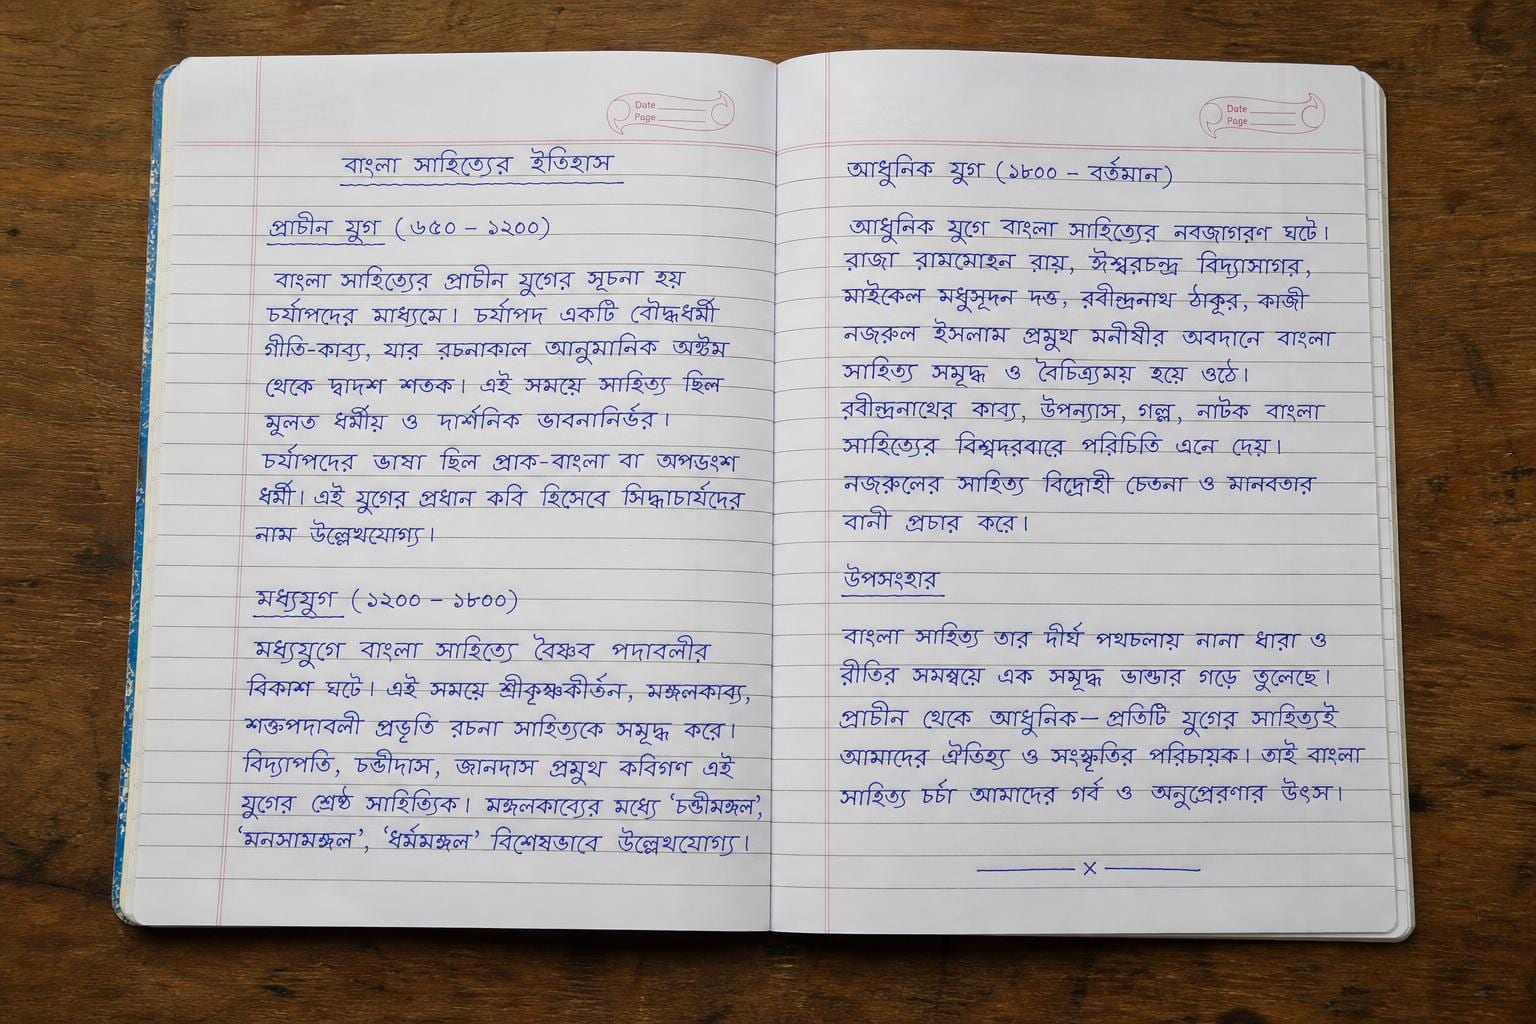
यदि आप हस्तलिखित बांग्ला में लिखे किसी गद्यांश की तस्वीर लेते हैं, तो इस अध्ययन में उठाई गई चुनौती किसी एक शब्द को पहचानने से पहले ही सामने आ जाती है। एक सेगमेंटेशन एल्गोरिदम को यह तय करना होता है कि स्याही के कौन से स्ट्रोक्स एक साथ जुड़े हैं और कहाँ एक शब्द समाप्त होता है तथा अगला शब्द शुरू होता है। इंसान लिखते समय हमेशा ऐसे स्पष्ट अंतराल (gaps) नहीं छोड़ते, जिससे ये निर्णय लेना आसान हो सके।
पास-पास लिखे शब्द आपस में मिलकर एक ही डिटेक्टेड क्षेत्र बन सकते हैं। वहीं, अलग-थलग अक्षर और मात्रा चिह्न एक ही शब्द को कई टुकड़ों जैसा दिखा सकते हैं।
लेखकों के अनुसार हस्तलिखित बांग्ला के लिए एक भरोसेमंद OCR मिलना काफी कठिन है। उनका शोध वर्ड सेगमेंटेशन (word segmentation) पर केंद्रित है—वह चरण जो पूरे पृष्ठ की इमेज को अलग-अलग शब्दों के क्षेत्रों में विभाजित करता है। इस चरण में होने वाली गलतियों के कारण बाद के रिकग्निशन चरणों को अधूरे शब्दों या एक ही क्रॉप में जुड़े कई शब्दों के साथ काम करना पड़ सकता है।
अपने शोध पत्र, Color Independent Word Segmentation From Transcribed Bangla Passages में, Khulna University of Engineering & Technology (KUET) के शोधकर्ता Faias Satter, Noor Masrur, और Sk. Md. Masudul Ahsan ने एक अडैप्टिव, क्लासिकल इमेज-प्रोसेसिंग पाइपलाइन के ज़रिये इस अड़चन को हल करने का प्रयास किया है। वे अलग-अलग रंगों के कागज़, पेन के प्रकारों और परछाई के व्यवधान (shadow interference) वाले स्मार्टफ़ोन से खींचे गए दस्तावेज़ों पर परीक्षण करते हैं और एक इटरेटिव कंटूर-काउंटिंग ह्यूरिस्टिक के माध्यम से वर्ड बॉक्सेज़ (word boxes) निकालते हैं। यह पांडुलिपि 1 अक्टूबर, 2026 को arXiv पर पोस्ट की गई थी, और यह 2023 International Conference on Electrical Information and Communication Technology (EICT) में प्रकाशित एक पेपर के स्वीकृत संस्करण के रूप में अपनी पहचान कराती है।
यहाँ एक इंजीनियरिंग विश्लेषण प्रस्तुत है कि क्यों हस्तलिखित बांग्ला सेगमेंटेशन को जटिल बनाती है, KUET टीम ने अपनी पाइपलाइन कैसे डिज़ाइन की, और उनके द्वारा रिपोर्ट किए गए परिणाम क्या साबित करते हैं।
The visual geometry of a handwritten script
सेगमेंटेशन की समस्या को समझने के लिए आपको लिपि की भौतिक स्थलाकृति (physical topography) को देखना होगा।
बांग्ला के कई अक्षर एक शब्द के भीतर एक क्षैतिज रेखा (horizontal stroke) के ज़रिये जुड़ते हैं जिसे मात्रा (matra / शिरोरेखा) कहा जाता है। यह जुड़ाव किसी शब्द को एक इमेज क्षेत्र के रूप में एकजुट रखने में मदद कर सकता है, लेकिन हर अक्षर या चिह्न में मात्रा नहीं होती, और हस्तलेखन में हमेशा यह निरंतर जुड़ाव बरकरार नहीं रहता।
शोध पत्र में तीन बार-बार आने वाली जटिलताओं का उल्लेख किया गया है:
- मात्रा-रहित अक्षर और चिह्न गलत वर्ड ब्रेक (शब्द विभाजन) पैदा करते हैं। लेखक '◌ঃ', '◌ং', और '◌ঁ' जैसे चिह्नों को स्प्लिटिंग एरर (विभाजन त्रुटियों) के संभावित स्रोत के रूप में पहचानते हैं। किसी शब्द के भीतर गायब कनेक्शन या अंतराल उसके घटकों को अलग-अलग डिटेक्टेड क्षेत्रों में छोड़ सकते हैं।
- अलग-थलग चिह्न शब्द की सीमाओं को जटिल बनाते हैं। स्वर चिह्न (मात्राएँ) जैसे '◌ু', '◌ূ', 'ি◌', '◌ী', 'ৈ◌', और 'ে◌ৗ' पड़ोसी शब्दों को अलग करने की प्रक्रिया को जटिल बना सकते हैं। लेखक बताते हैं कि कई बार एक शब्द के घटक दूसरे शब्द में समाहित हो जाते हैं, या फिर मुख्य शब्द से दूर स्थित चिह्न अपने ही शब्द के बाउंडिंग बॉक्स से बाहर छूट जाते हैं।
- शब्दों के बीच की परिवर्तनशील दूरी (Variable inter-word spacing)। कुछ लेखक शब्दों और पंक्तियों के बीच बहुत कम जगह छोड़ते हैं। वहीं अन्य बिखरी हुई शैली में लिखते हैं, जहाँ शब्द के अंदर ही अक्षरों के बीच बड़े अंतराल होते हैं। ऐसी सेटिंग जो एक लेखक के अलग-थलग अक्षरों को जोड़ती है, वह किसी दूसरे लेखक के अगल-बगल के शब्दों को आपस में मिला सकती है।
लिपि-स्तर की इन चुनौतियों के अलावा, दस्तावेज़ कैप्चर करने की प्रक्रिया भौतिक अव्यवस्था को और बढ़ा देती है। इस अध्ययन में स्मार्टफ़ोन से ली गई ऐसी तस्वीरें शामिल हैं जिनमें परछाई का व्यवधान, अलग-अलग इमेज आकार और रिज़ॉल्यूशन, रंगीन स्याही और रंगीन कागज़ शामिल हैं। ये स्थितियाँ एक ऐसी पाइपलाइन की आवश्यकता को जन्म देती हैं जो प्रत्येक पृष्ठ पर एक निश्चित सेटिंग लागू करने के बजाय सीधे इमेज से अपनी फ़िल्टरिंग और थ्रेशोल्डिंग सेटिंग्स का चयन करे।
Stage 1: Converting phone camera chaos into stable pixels
KUET टीम ने अपने समाधान को एक क्रमिक छह-चरणीय (six-stage) पाइपलाइन के रूप में संरचित किया, जो एक अलग लाइन-सेगमेंटेशन पास चलाए बिना सीधे रॉ पिक्सल से बाउंडेड वर्ड क्षेत्रों की ओर बढ़ती है।
पहला कदम इनपुट इमेज को ग्रेस्केल (grayscale) में बदलना है। लेखक बताते हैं कि हालांकि सीधे ब्लैक एंड व्हाइट में स्कैन करना तेज़ होता है, लेकिन इससे अक्षरों की कुछ जानकारी नष्ट हो सकती है। इसलिए ग्रेस्केल बाद के फ़िल्टरिंग और थ्रेशोल्डिंग चरणों के लिए प्रारंभिक बिंदु प्रदान करता है।
इसके बाद अडैप्टिव नॉइज़ रिडक्शन (noise reduction) आता है। अलग-अलग डिवाइस अलग-अलग रिज़ॉल्यूशन पर इमेज बनाते हैं, और अलग-अलग लेखक अलग-अलग पैमानों (scales) पर अक्षर लिखते हैं। लेखक फ़िल्टरिंग सेटिंग्स निर्धारित करने के लिए एवरेज कंटूर साइज (ACS - Average Contour Size) नामक एक इमेज-विशिष्ट मीट्रिक का उपयोग करते हैं।
प्रारंभिक ACS की गणना करने के लिए:
- सिस्टम 21 गुणा 21 पिक्सल आकार के गॉसियन कर्नेल (Gaussian kernel) के साथ एक प्रारंभिक डीनॉइज़िंग पास चलाता है। पेपर ऊर्ध्वाधर दिशा (vertical direction) में 21 का मानक विचलन (standard deviation) और 7 का स्केलिंग फैक्टर निर्दिष्ट करता है।
- यह 21 गुणा 21 विंडो का उपयोग करके एक प्रारंभिक अडैप्टिव थ्रेशोल्ड लागू करता है।
- यह प्रारंभिक कंटूर निकालता है, और 50 से कम क्षेत्रफल वाले कंटूर को सॉल्ट नॉइज़ (salt noise) मानकर हटा देता है।
- शेष कंटूर क्षेत्र बाद के कर्नेल आकारों के चयन के लिए उपयोग किए जाने वाले ACS प्रदान करते हैं।
एक बार जब सिस्टम को दस्तावेज़ का ACS पता चल जाता है, तो पेपर अगले स्मूथिंग चरण को नॉन-लोकल मीन्स डीनॉइज़िंग (Non-local Means Denoising) के रूप में वर्णित करता है। यह निर्देशांक चर $x$ और $y$ का उपयोग करके एक स्मूथिंग-कर्नेल समीकरण भी प्रदान करता है, जिसमें $\sigma$ को कर्नेल आकार के वर्गमूल के रूप में परिभाषित किया गया है। कर्नेल का आकार स्वयं एक अनुभवजन्य (empirical) ACS लुकअप टेबल से आता है।
कर्नेल के आयामों को निश्चित करने के बजाय, लेखक परिकलित ACS को विभिन्न आकारों में मैप करते हैं:
- 200 से कम ACS के लिए 3 गुणा 3 कर्नेल का उपयोग किया जाता है।
- 200 से लेकर 300 से कम ACS के लिए 5 गुणा 5 कर्नेल का उपयोग किया जाता है।
- सूचीबद्ध आकार 1000 तक लगातार 100-यूनिट ACS बैंड में 2 की वृद्धि करते हैं, जो $900 \le \text{ACS} < 1000$ के लिए 19 गुणा 19 तक पहुँच जाते हैं।
- अगली प्रविष्टियाँ $1000 \le \text{ACS} < 1200$ के लिए 21 गुणा 21 और $1200 \le \text{ACS} < 1400$ के लिए 23 गुणा 23 का उपयोग करती हैं।
तालिका से आगे विस्तार के लिए, लेखक ACS की प्रत्येक अतिरिक्त 200 इकाइयों के लिए कर्नेल आकार को 2 बढ़ाने का वर्णन करते हैं।
लेखक पृष्ठ की पृष्ठभूमि की ब्राइटनेस (background brightness) को भी ध्यान में रखते हैं। वे 181 और 255 के बीच पिक्सल मान वाले हल्के बैकग्राउंड के लिए कम सॉल्ट नॉइज़ की रिपोर्ट करते हैं, और जैसे-जैसे बैकग्राउंड गहरा होता जाता है, नॉइज़ बढ़ता जाता है। 101 और 180 के बीच के बैकग्राउंड मानों के लिए, वे चयनित कर्नेल आकार में 2 की वृद्धि करते हैं। 100 से कम मानों के लिए, वे इसे 4 बढ़ाते हैं।
प्रस्तावित प्रणाली के लिए ये अनुभवजन्य चयन (empirical choices) किए गए हैं। वे कागज़ के रंग और आवश्यक स्मूथिंग क्षमता के बीच कोई सार्वभौमिक संबंध स्थापित करने के बजाय, अनुमानित कंटूर स्केल और बैकग्राउंड ब्राइटनेस के अनुसार फ़िल्टरिंग को अनुकूलित करते हैं।
Stage 2: The shadow test and adaptive binarization
स्मूथ होने के बाद, इमेज को बाइनरी निरूपण (binary representation) में बदला जाना चाहिए। पाइपलाइन अंततः इस निरूपण को काले बैकग्राउंड पर सफेद अग्रभूमि (foreground) स्ट्रोक के रूप में मानकीकृत करती है।
लेखक ओत्सु पद्धति (Otsu's method) का उपयोग करके ग्लोबल थ्रेशोल्डिंग और अडैप्टिव थ्रेशोल्डिंग के बीच चयन करते हैं। उनकी प्राथमिकता यह है कि जब इमेज के लिए एक ही थ्रेशोल्ड पर्याप्त हो तो ओत्सु का उपयोग किया जाए, जबकि रंगीन बैकग्राउंड या परछाई के व्यवधान के लिए अडैप्टिव थ्रेशोल्डिंग को चुना जाए।
इस चयन में एक ट्रेड-ऑफ शामिल है। पेपर रिपोर्ट करता है कि अडैप्टिव थ्रेशोल्डिंग अक्षरों को खंडित (fragment) कर सकती है क्योंकि यह स्थानीय विंडो (local windows) के भीतर काम करती है। ऐसे में किसी शब्द के कुछ हिस्से उसके डिटेक्टेड कंटूर से बाहर छूट सकते हैं। लेखकों के अनुसार उपयुक्त परिस्थितियों में ओत्सु को प्राथमिकता दी जाती है क्योंकि यह इस विखंडन से बचाता है।
KUET पाइपलाइन किसी बाइनराइजेशन विधि को तय करने से पहले एक शैडो-इंटरफेरेंस (परछाई के व्यवधान की) जाँच करती है:
$$\frac{\text{Area of largest contour}}{\text{Average Contour Size}} > 100$$
सिस्टम ओत्सु थ्रेशोल्डिंग लागू करता है और परिणामी सबसे बड़े कंटूर को मापता है। यदि इसका क्षेत्रफल ACS के 100 गुना से अधिक हो जाता है, तो पाइपलाइन इमेज को परछाई के व्यवधान से प्रभावित मानती है। यह अनुपात लेखकों का एक डिटेक्शन ह्यूरिस्टिक है; पेपर यह स्थापित नहीं करता कि हर बड़ा कंटूर अनिवार्य रूप से एक परछाई ही होगा।
इस परीक्षण और बैकग्राउंड पिक्सल इंटेंसिटी के आधार पर, बाइनराइजेशन रणनीति दो शाखाओं में बँट जाती है:
- रंगीन या गहरा कागज़, जिसमें पिक्सल मान 180 से कम हों: अडैप्टिव थ्रेशोल्डिंग का उपयोग करें।
- हल्का कागज़, जिसमें पिक्सल मान 180 या उससे अधिक हों: यदि परछाई का व्यवधान पाया जाता है तो अडैप्टिव थ्रेशोल्डिंग का उपयोग करें; अन्यथा, ओत्सु थ्रेशोल्डिंग का उपयोग करें।
अडैप्टिव-थ्रेशोल्डिंग विंडो का आकार ACS लुकअप टेबल से निर्धारित होता है।
थ्रेशोल्डिंग के बाद, जहाँ आवश्यक हो वहाँ पिक्सल मानों को उलट (invert) दिया जाता है, जिससे काले बैकग्राउंड पर एक समान सफेद अग्रभूमि स्ट्रोक प्राप्त होते हैं। इसके बाद इमेज स्क्यू करेक्शन (तिरछेपन के सुधार) के लिए उपयोग की जाने वाली सह-रेखीय संरचनाओं (co-linear structures) की पहचान करने के लिए कैनी एज डिटेक्शन (Canny edge detection) और हॉफ ट्रांसफ़ॉर्म (Hough transform) से होकर गुजरती है।
यह स्क्यू-करेक्शन चरण पृष्ठ को अलग-अलग टेक्स्ट-लाइन इमेजेस में विभाजित नहीं करता है। वर्ड डिटेक्शन अब भी बिना किसी पूर्ववर्ती लाइन-सेगमेंटेशन पास के संचालित होता है।
Stage 3: Morphological dilation and the peak-contour stopping point
अब मुख्य चुनौती सामने आती है: अलग-थलग अक्षरों के स्ट्रोक और अलग छूटे मात्रा चिह्नों को पास के शब्दों के बीच के अंतराल को मिटाए बिना शब्द इकाइयों में समूहीकृत करना।
लेखक गणितीय मॉर्फोलॉजी (mathematical morphology)—विशेष रूप से सफेद अग्रभूमि पिक्सल वाले एक वर्गाकार स्ट्रक्चरिंग तत्व (square structuring element) का उपयोग करके डाइलेशन (dilation) पर भरोसा करते हैं। डाइलेशन अग्रभूमि क्षेत्रों का विस्तार करता है। यह एक शब्द के भीतर के घटकों को जोड़ सकता है, लेकिन अत्यधिक विस्तार पड़ोसी शब्दों को भी आपस में जोड़ सकता है।
स्टॉपिंग पॉइंट (रुकने का बिंदु) निर्धारित करना ही मुख्य तकनीकी चुनौती है। लेखक न्यूनतम क्षेत्रफल सीमा यानी मिनिमम एरिया थ्रेशोल्ड (MAT - Minimum Area Threshold) और पुनरावृत्त कंटूर-काउंटिंग सर्च के संयोजन के माध्यम से इसे हल करते हैं।
Defining what counts as a word
इससे पहले कि सिस्टम शब्द उम्मीदवारों (word candidates) की गिनती कर सके, उसे कंटूर को बनाए रखने के लिए एक नियम की आवश्यकता होती है। MAT से बड़े क्षेत्रफल वाले जुड़े हुए क्षेत्रों (connected regions) को उम्मीदवारों के रूप में गिना जाता है और उन्हें बाउंडिंग बॉक्स मिल सकते हैं।
क्षेत्रफल सीमा को पार करना इस बात की गारंटी नहीं देता कि किसी क्षेत्र में ठीक एक ही पूरा शब्द है। यह केवल पाइपलाइन का फ़िल्टरिंग नियम है।
MAT की गणना इस बात पर निर्भर करती है कि पहले कौन सी बाइनराइजेशन विधि चुनी गई थी:
- ओत्सु थ्रेशोल्डिंग के बाद: लेखक सीधे ACS से MAT की गणना करते हैं:
$$\text{MAT} = \frac{\text{Average Contour Size}}{1.25}$$
- अडैप्टिव थ्रेशोल्डिंग के बाद: लेखक राइटिंग डेंसिटी (WD - Writing Density) नामक एक मीट्रिक का उपयोग करके खंडित कंटूर का हिसाब रखते हैं:
$$\text{Writing Density} = \frac{\text{Total area of the page}}{\text{Average Contour Size}}$$
पेपर बड़े WD की व्याख्या कम सघन लेखन (less dense writing) के रूप में करता है। इसका फॉर्मूला सीधे शब्दों के बीच के अंतराल को मापने के बजाय औसत कंटूर क्षेत्र के सापेक्ष पृष्ठ क्षेत्र को व्यक्त करता है।
सिस्टम WD को MAT के लिए एक अनुभवजन्य सूत्र (empirical formula) में मैप करता है। यह तालिका $\text{WD} < 1500$ होने पर $\text{ACS} - \frac{\text{ACS}}{4}$ से लेकर $\text{WD} \ge 10000$ होने पर $\text{ACS} \times 6$ तक विस्तृत है। मध्यवर्ती बैंड ACS के अन्य गुणकों और भिन्नात्मक समायोजनों (fractional adjustments) का उपयोग करते हैं।
एक दूसरी तालिका WD और ACS के संयोजनों के लिए और समायोजन लागू करती है। इसके सूचीबद्ध नियमों में $\text{WD} > 2000$ और $\text{ACS} > 700$ होने पर $\frac{\text{ACS}}{8}$ घटाना, और निर्दिष्ट उच्च-WD, उच्च-ACS सीमाओं में ACS-आधारित मात्राएँ जोड़ना शामिल है।
ये मैपिंग विधि के अनुभवजन्य रूप से चुने गए भाग हैं। इनका उद्देश्य छोटे टुकड़ों को स्वीकार करने या बड़े क्षेत्रों को आपस में मिलाने के जोखिम के सामने शब्द घटकों को बनाए रखने के बीच संतुलन बनाना है।
The peak contour search
MAT परिभाषित होने के बाद, सिस्टम ACS से अपने प्रारंभिक डाइलेशन कर्नेल का आकार निर्धारित करता है। सूचीबद्ध प्रविष्टियाँ 100 से कम ACS के लिए 1 गुणा 1 से और $100 \le \text{ACS} < 1000$ के लिए 3 गुणा 3 से शुरू होती हैं। बड़े ACS बैंड को बड़े शुरुआती कर्नेल मिलते हैं, जिसमें ओत्सु और अडैप्टिव-थ्रेशोल्डिंग शाखाओं के बीच कुछ अंतर होते हैं।
उदाहरण के लिए, जब $2000 \le \text{ACS} < 2200$ हो, तो तालिका ओत्सु के बाद 9 गुणा 9 शुरुआती कर्नेल और अडैप्टिव थ्रेशोल्डिंग के बाद 11 गुणा 11 कर्नेल निर्दिष्ट करती है। सूचीबद्ध अडैप्टिव-थ्रेशोल्डिंग प्रविष्टियाँ $2400 \le \text{ACS} < 2600$ के लिए 13 गुणा 13 तक पहुँचती हैं; इसे सभी छवियों के लिए अधिकतम के रूप में प्रस्तुत नहीं किया गया है।
एल्गोरिदम प्रारंभिक कर्नेल के साथ एक पुनरावृत्ति (iteration) के लिए बाइनरी इमेज को डाइलेट करता है और उन कंटूरों की गणना करता है जिनका क्षेत्रफल MAT से अधिक है। इसके बाद यह पुनरावृत्ति संख्या या कर्नेल आकार को बढ़ाकर आगे की सेटिंग्स का परीक्षण करता है, और बचे हुए कंटूरों की दोबारा गणना करता है।
कंटूर-काउंटिंग ह्यूरिस्टिक दो प्रभावों पर आधारित है:
- अलग-थलग घटक इतने बड़े क्षेत्रों में जुड़ सकते हैं कि वे MAT को पार कर जाएँ, जिससे बरकरार रखे गए शब्द उम्मीदवारों की संख्या बढ़ जाती है।
- आगे के डाइलेशन के दौरान पड़ोसी शब्द क्षेत्र आपस में मिल सकते हैं, जिससे कंटूरों की संख्या घट जाती है।
लेखक अधिकतम कंटूर संख्या की खोज करने और आगे के डाइलेशन से शब्दों के आपस में टकराने से ठीक पहले रुकने का वर्णन करते हैं। यह डाइलेशन सेटिंग चुनने के लिए एक ह्यूरिस्टिक है। यह इस बात की गारंटी नहीं देता कि हर शब्द पूरा है या चुने गए बिंदु पर प्रत्येक पड़ोसी जोड़ी अलग ही रहती है।
पेपर के चित्र 4 (Figure 4) में प्रलेखित एक उदाहरण में, 641 ACS वाली एक इमेज 3 गुणा 3 डाइलेशन कर्नेल से शुरू होती है। 3 पुनरावृत्तियों (iterations) के लिए उस कर्नेल का उपयोग करने पर सचित्र इष्टतम सेटिंग पर 33 डिटेक्टेड शब्द प्राप्त होते हैं। वहीं 2 पुनरावृत्तियों के लिए लागू किया गया 10 गुणा 10 कर्नेल केवल 23 शब्द उत्पन्न करता है।
अंत में, चयनित सेटिंग पर बरकरार रखे गए शब्द कंटूरों के चारों ओर आयताकार बाउंडिंग बॉक्स फिट किए जाते हैं।
Benchmarks: Testing on three distinct datasets
अपने दृष्टिकोण का मूल्यांकन करने के लिए, KUET टीम ने तीन दस्तावेज़ संग्रहों पर पाइपलाइन का परीक्षण किया: इस परियोजना के लिए बनाया गया एक विशेष (bespoke) डेटासेट, CMATERdb1.1.1, और वह संग्रह जिसे पेपर में बांग्ला राइटिंग (Bangla Writing) डेटासेट कहा गया है।
1. The custom 80-document dataset
विविध कैप्चर स्थितियों का मूल्यांकन करने के लिए, लेखकों ने सफेद, लाल, नीले, हरे और काले कागज़ पर विभिन्न हस्तलेखन शैलियों में लिखे गए 80 दस्तावेज़ों का एक डेटासेट तैयार किया। उन्होंने काले, लाल, हरे और नीले सहित विभिन्न रंगों में जेल, बॉलपॉइंट और ग्लिटर पेन का इस्तेमाल किया।
उन्होंने परछाई का व्यवधान भी शामिल किया और विभिन्न कैप्चर डिवाइसों का उपयोग किया ताकि छवियों का आकार और रिज़ॉल्यूशन अलग-अलग हो।
पेपर रिपोर्ट करता है:
- Ground truth words: 7,374
- Bounding boxes generated: 7,278
- Correctly segmented words: 6,681
- Segmentation errors: 527 शब्द, जिन्हें अंडर-सेगमेंटेड, ओवर-सेगमेंटेड या डिफेक्ट-सेगमेंटेड के रूप में वर्गीकृत किया गया
- Undetected words: 166
- Recall: 90.60%
- Precision: 91.80%
- F1-score: 91.20%
ये परिणाम लेखकों के रंग-विविधता और परछाई वाले संग्रह पर इस पद्धति का प्रदर्शन करते हैं। वे कागज़, स्याही, हस्तलेखन और प्रकाश व्यवस्था के हर संभावित संयोजन के लिए विश्वसनीय सेगमेंटेशन स्थापित नहीं करते हैं।
2. CMATERdb1.1.1 benchmark
लेखकों ने CMATERdb1.1.1 के 100 दस्तावेज़ों पर पाइपलाइन चलाई, जिससे 15,730 शब्दों पर 15,587 बाउंडिंग बॉक्स उत्पन्न हुए:
- Correctly segmented: 13,552 शब्द
- Segmentation errors: 2,048 शब्द
- Undetected: 130 शब्द
- Recall: 86.15%
- Precision: 86.94%
- F1-score: 86.54%
तुलना के लिए, पेपर रिपोर्ट करता है कि Sarkar et al. (2011) ने 86.01% की वर्ड-सेगमेंटेशन सफलता दर प्राप्त की थी: 15,730 में से 13,530 सही ढंग से सेगमेंट किए गए शब्द, जिसमें 2,200 शब्द या तो अंडर-सेगमेंटेड थे या ओवर-सेगमेंटेड।
इनपुट का यह अंतर महत्वपूर्ण है। KUET पेपर के अनुसार, Sarkar et al. ने पहले से ही टेक्स्ट लाइनों में सेगमेंट किए गए दस्तावेज़ छवियों का उपयोग किया था, जबकि प्रस्तावित विधि को उस प्री-प्रोसेसिंग चरण की आवश्यकता नहीं होती है।
प्रस्तावित विधि का रिपोर्ट किया गया रिकॉल पहले की सफलता दर से थोड़ा अधिक है। हालांकि, अलग-अलग इनपुट स्थितियों का मतलब है कि यह समग्र प्रदर्शन लाभ का कोई नियंत्रित प्रदर्शन (controlled demonstration) नहीं है।
3. Bangla Writing dataset
इस प्रणाली का मूल्यांकन बांग्ला राइटिंग (Bangla Writing) डेटासेट के 100 दस्तावेज़ों पर भी किया गया:
- Total words present: 7,400
- Bounding boxes generated: 7,191
- Correctly segmented: 6,380 शब्द
- Segmentation errors: 987 शब्द
- Undetected: 33 शब्द
- Recall: 86.22%
- Precision: 88.72%
- F1-score: 87.45%
पेपर में बताया गया है कि Das et al. (2023) ने हॉरिजॉन्टल प्रोजेक्शन प्रोफाइल, सीम कार्विंग और कंटूर ट्रेसिंग का उपयोग करके इस डेटासेट के एक हिस्से पर काम किया था। उनके रिपोर्ट किए गए परिणाम 88.39% लाइन-सेगमेंटेशन सटीकता, 95.65% वर्ड-सेगमेंटेशन सटीकता और 84.55% औसत सटीकता थे।
KUET तुलना तालिका उस 84.55% औसत सटीकता को प्रस्तावित विधि के रिकॉल, प्रिसिजन और F1-स्कोर के बगल में रखती है। ये अलग-अलग मीट्रिक्स हैं, और मूल्यांकनों में डेटासेट के अलग-अलग हिस्सों का उपयोग किया गया है। इसलिए 87.45% F1-स्कोर को पहले की औसत सटीकता पर सीधे तौर पर तुलनीय सुधार के रूप में नहीं देखा जाना चाहिए।
How the pipeline breaks down: four error modes
चूंकि एल्गोरिदम टेक्स्ट को पहचानने के बजाय इमेज ज्योमेट्री का उपयोग करता है, इसलिए इसकी रिपोर्ट की गई विफलताएं ज्यामितीय एज-केसेस (geometric edge cases) का अनुसरण करती हैं। लेखक इन्हें चार प्रकार की त्रुटियों में वर्गीकृत करते हैं।
नीचे दिए गए लेबल पेपर की शब्दावली का पालन करते हैं: यह शब्द विभाजन (word splitting) को अंडर-सेगमेंटेशन और शब्दों के आपस में मिलने (word merging) को ओवर-सेगमेंटेशन कहता है।
- Under-segmentation error (word splitting): एक ही शब्द दो या दो से अधिक बाउंडिंग बॉक्सों में विभाजित हो जाता है। लेखक इसे गायब मात्रा कनेक्शनों, आंतरिक अक्षरों के बीच असामान्य रूप से बड़े अंतराल और '◌ঃ', '◌ং', और '◌ঁ' जैसे मात्रा-रहित चिह्नों से जोड़ते हैं।
- Over-segmentation error (word merging): एक ही बाउंडिंग बॉक्स में दो या दो से अधिक शब्द समा जाते हैं। शब्दों या पंक्तियों के बीच अपर्याप्त अंतराल वाला सघन हस्तलेखन इस त्रुटि की संभावना को बढ़ाता है।
- Defect-segmentation error (excluded marks): एक बाउंडिंग बॉक्स शब्द को घेरता तो है लेकिन उसके किसी हिस्से को बाहर छोड़ देता है। पेपर में स्वर चिह्नों और अन्य मात्राओं के उदाहरण दिए गए हैं, जिनमें '◌ा', 'ি◌', '◌ঁ', '◌ৃ', और '◌ী' शामिल हैं, विशेषकर तब जब वे मुख्य शब्द से दूर लिखे गए हों।
- Overlooking error (missed words): आउटपुट से किसी शब्द का पूरी तरह छूट जाना। लेखक छोटे क्षेत्रफल वाले शब्दों को उस समय संवेदनशील मानते हैं जब न्यूनतम क्षेत्रफल सीमा (MAT) बढ़ा दी जाती है।
ये त्रुटियाँ ट्यूनिंग के दौरान विरोधाभासी दबाव पैदा करती हैं। एक छोटा शुरुआती डाइलेशन कर्नेल या छोटा MAT सघन रूप से लिखे गए पृष्ठों में मदद कर सकता है, लेकिन लेखक बताते हैं कि ऐसे विकल्प बिखरे हुए हस्तलेखन में विभाजन त्रुटियों (splitting errors) को बढ़ा सकते हैं। एक छोटा डाइलेशन कर्नेल दूर स्थित चिह्नों को भी शब्द के बॉक्स से बाहर छोड़ सकता है।
विराम चिह्न एक और जटिलता पेश करते हैं। पेपर रिपोर्ट करता है कि बांग्ला वाक्य-समाप्ति दारी ('।') और कॉमा जैसे चिह्न पड़ोसी शब्दों के साथ डिटेक्ट हो सकते हैं। कुछ हस्तलेखन शैलियों में, उन्हें इसके बजाय अलग बाउंडिंग बॉक्स मिल जाते हैं।
अंत में, कागज़ के चारों ओर का बैकग्राउंड भी गलत डिटेक्शन उत्पन्न कर सकता है जब उसके पिक्सल मान अक्षरों के मानों से मिलते-जुलते हों। लेखक उस बैकग्राउंड को हटाने के लिए इमेज को क्रॉप करने का प्रस्ताव देते हैं।
Why it matters for document parsing and OCR systems
KUET पेपर क्लासिकल इमेज-प्रोसेसिंग ऑपरेशन्स से निर्मित वर्ड सेगमेंटेशन का एक विस्तृत उदाहरण प्रस्तुत करता है। इसका योगदान वर्ड क्षेत्रों को निकालने की एक विधि है, जिसका मूल्यांकन सेगमेंटेशन काउंट और मीट्रिक्स के माध्यम से किया गया है।
यह उन क्षेत्रों के भीतर के शब्दों की पहचान (recognition) का मूल्यांकन नहीं करता है। परिणामों की व्याख्या करते समय यह अंतर काफी मायने रखता है: सही ढंग से सेगमेंट किया गया एक क्रॉप बाद के OCR चरणों के लिए केवल एक इनपुट होता है, इस बात का प्रमाण नहीं कि उसके टेक्स्ट को सही ढंग से ट्रांसक्राइब कर लिया गया है। वैसे भी, अंग्रेज़ी में मजबूत OCR प्रदर्शन होने का यह मतलब कतई नहीं है कि वह देवनागरी जैसी जटिल लिपियों के लिए भी उतना ही प्रभावी साबित होगा, जहाँ शिरोरेखा, मात्राओं और संयुक्ताक्षरों की अपनी अनूठी चुनौतियाँ होती हैं।
Eliminating the line segmentation dependency
एक सेगमेंटेशन वर्कफ़्लो इस तरह के पदानुक्रम (hierarchy) के माध्यम से आगे बढ़ सकता है:
$$\text{Page} \longrightarrow \text{Text Lines} \longrightarrow \text{Words} \longrightarrow \text{Characters}$$
ऐसे वर्कफ़्लो में, लाइन सेगमेंटेशन में होने वाली त्रुटियाँ बाद के शब्द निष्कर्षण (word extraction) को प्रभावित कर सकती हैं। संबंधित कार्यों पर पेपर की चर्चा उन कठिनाइयों की पहचान करती है जब हस्तलिखित पंक्तियाँ एक दूसरे पर ओवरलैप होती हैं या जब उनका विस्तार काफी भिन्न होता है।
प्रस्तावित विधि दस्तावेज़ को पहले अलग-अलग पंक्तियों में विभाजित किए बिना ही सीधे शब्द क्षेत्रों को निकालती है। लेखकों का तर्क है कि इससे शब्द निष्कर्षण को एक सफल लाइन-सेगमेंटेशन चरण पर निर्भर होने से बचाया जा सकता है।
यह भीड़भाड़ वाले शब्दों और पंक्तियों के कारण होने वाली त्रुटियों को पूरी तरह समाप्त नहीं करता है। वे स्थितियाँ अभी भी पेपर के विफलता विश्लेषण में दिखाई देती हैं। इसका वास्तविक लाभ उस अलग प्री-प्रोसेसिंग निर्भरता को हटाना है, न कि यह गारंटी देना कि सेगमेंटेशन त्रुटियाँ केवल एक ही शब्द युग्म तक सीमित रहेंगी।
Classical processing, without a runtime benchmark
वर्णित पाइपलाइन ग्रेस्केल रूपांतरण, डीनॉइज़िंग, थ्रेशोल्डिंग, कैनी एज डिटेक्शन, हॉफ ट्रांसफ़ॉर्म और मॉर्फोलॉजिकल डाइलेशन का उपयोग करती है। प्रस्तावित सेगमेंटेशन पद्धति में कोई भी डीप-लर्निंग मॉडल शामिल नहीं है।
यह इस पेपर को एक क्लासिकल दृष्टिकोण के व्यावहारिक उदाहरण के रूप में उपयोगी बनाता है। हालांकि, यह किसी विशेष निष्पादन गति (execution speed) या परिनियोजन लागत (deployment cost) को स्थापित नहीं करता है।
अध्ययन में सेगमेंटेशन परिणामों की रिपोर्ट तो दी गई है लेकिन इसमें रनटाइम, मेमोरी, ऊर्जा खपत या ऑन-डिवाइस निष्पादन का कोई बेंचमार्क नहीं दिया गया है। स्मार्टफ़ोन से ली गई छवियां केवल इनपुट स्रोत का वर्णन करती हैं; वे यह साबित नहीं करतीं कि प्रोसेसिंग वास्तव में स्मार्टफ़ोन पर ही की गई थी।
इसलिए मिलीसेकंड में निष्पादन, कम क्षमता वाले स्मार्टफ़ोन पर प्रदर्शन, बैटरी की खपत, या न्यूरल सिस्टम पर इसके फायदों के बारे में दावे रिपोर्ट किए गए साक्ष्यों से परे होंगे।
The limits of empirical lookup tables
यह पेपर इस दृष्टिकोण की व्यापक ट्यूनिंग मांगों को भी उजागर करता है।
इसकी मैपिंग टेबल ACS और WD को स्मूथिंग कर्नेल, एरिया थ्रेशोल्ड और शुरुआती डाइलेशन कर्नेल से जोड़ती हैं। ये टेबल असतत अंतरालों (discrete intervals) का उपयोग करती हैं: 299 का ACS 5 गुणा 5 स्मूथिंग कर्नेल का चयन करता है, जबकि 301 का ACS 7 गुणा 7 कर्नेल का चयन करता है।
इसका अर्थ यह है कि तालिका की सीमा पर एक मामूली सा बदलाव भी प्रोसेसिंग पैरामीटर को बदल सकता है। पेपर इन सीमाओं पर संवेदनशीलता को नहीं मापता है और न ही यह स्थापित करता है कि ये मैपिंग हर नई कैप्चर स्थिति में विश्वसनीय रूप से स्थानांतरित (transfer) हो सकती हैं।
लेखकों का त्रुटि विश्लेषण दर्शाता है कि ट्यूनिंग इतनी कठिन क्यों है। डाइलेशन बढ़ाने से किसी शब्द के अलग-थलग हिस्से जुड़ सकते हैं, लेकिन साथ ही अगल-बगल के शब्द भी आपस में मिल सकते हैं। एरिया थ्रेशोल्ड बढ़ाने से छोटे शब्द बाहर हो सकते हैं। अलग-अलग हस्तलेखन शैलियाँ इन सेटिंग्स को अलग-अलग दिशाओं में खींचती हैं।
प्रस्तावित सुधार इन देखी गई विफलताओं के समाधान के करीब रहते हैं। लेखक कई शब्दों वाले बाउंडिंग बॉक्स के नेस्टेड प्रोसेसिंग और अडैप्टिव-थ्रेशोल्डिंग तथा डाइलेशन फ़िल्टर आकारों के अधिक सटीक समायोजन का सुझाव देते हैं। लगभग बिना किसी अंतराल वाले शब्दों के लिए, वे शब्दकोश के शब्दों पर प्रशिक्षित मशीन-लर्निंग मॉडल का भी प्रस्ताव करते हैं।
ये भविष्य की दिशाएँ हैं, न कि रिपोर्ट की गई पाइपलाइन के मूल्यांकित विस्तार।
Satter, Masrur, और Ahsan दिखाते हैं कि कैसे एक अडैप्टिव क्लासिकल पाइपलाइन कई डेटासेट्स में हस्तलिखित बांग्ला को सेगमेंट कर सकती है, जिसमें रंगीन कागज़ और परछाई से प्रभावित तस्वीरों का उनका संग्रह भी शामिल है। इसका कंटूर-काउंटिंग सर्च और विस्तृत विफलता विश्लेषण वर्ड सेगमेंटेशन में एक ठोस योगदान देता है—और उन बॉक्सों को एडिटेबल टेक्स्ट में बदलने के लिए आवश्यक बाद के रिकग्निशन चरणों के लिए एक ठोस प्रारंभिक बिंदु प्रदान करता है।