ディープラーニングを用いない手書きベンガル語の単語領域分割:画像処理パイプラインの徹底解説
元論文: Color Independent Word Segmentation From Transcribed Bangla Passages — Faias Satter, Noor Masrur, Sk. Md. Masudul Ahsan
手書きのベンガル語文書を撮影した際、本研究が挑む課題は個々の単語を認識する以前の段階で生じる。領域分割(セグメンテーション)アルゴリズムは、どのインクの筆跡が同一単語に属し、どこで単語が終わり次の単語が始まるのかを判別しなければならない。だが人間が書く文字には、そうした判別を容易にする隙間が常に空いているとは限らない。
単語同士の間隔が狭ければ1つの領域として誤統合され、離れ離れになった文字や記号があれば1つの単語が複数の単語のように見えてしまう。
著者らは、高信頼な手書きベンガル語OCRは未だ得難い存在であると指摘する。彼らの研究は単語分割(word segmentation)――ページ画像から個々の単語領域を切り出す処理フェーズ――に焦点を当てている。この段階でエラーが発生すると、後続の認識処理には不完全な単語や、複数単語がひとまとめに切り抜かれた画像が渡されることになる。
論文『Color Independent Word Segmentation From Transcribed Bangla Passages』において、クルナ工科大学(Khulna University of Engineering & Technology: KUET)の研究者である Faias Satter、Noor Masrur、Sk. Md. Masudul Ahsan は、適応型の古典的画像処理パイプラインによってこのボトルネックの解決を試みた。彼らは、多様な用紙の色、ペンの種類、影の影響を含むスマートフォン撮影画像を対象に、反復的な輪郭カウントヒューリスティックを通じて単語バウンディングボックスを抽出している。本稿は2026年10月1日にarXivに投稿されたもので、2023年の「International Conference on Electrical Information and Communication Technology(EICT)」で採択・発表された論文のアクセプト版と明記されている。
本稿では、手書きベンガル語がなぜ単語分割を困難にするのか、KUETチームがどのようにパイプラインを設計したのか、そして報告された実験結果が何を実証しているのかについて、技術的な観点から詳細に解説する。
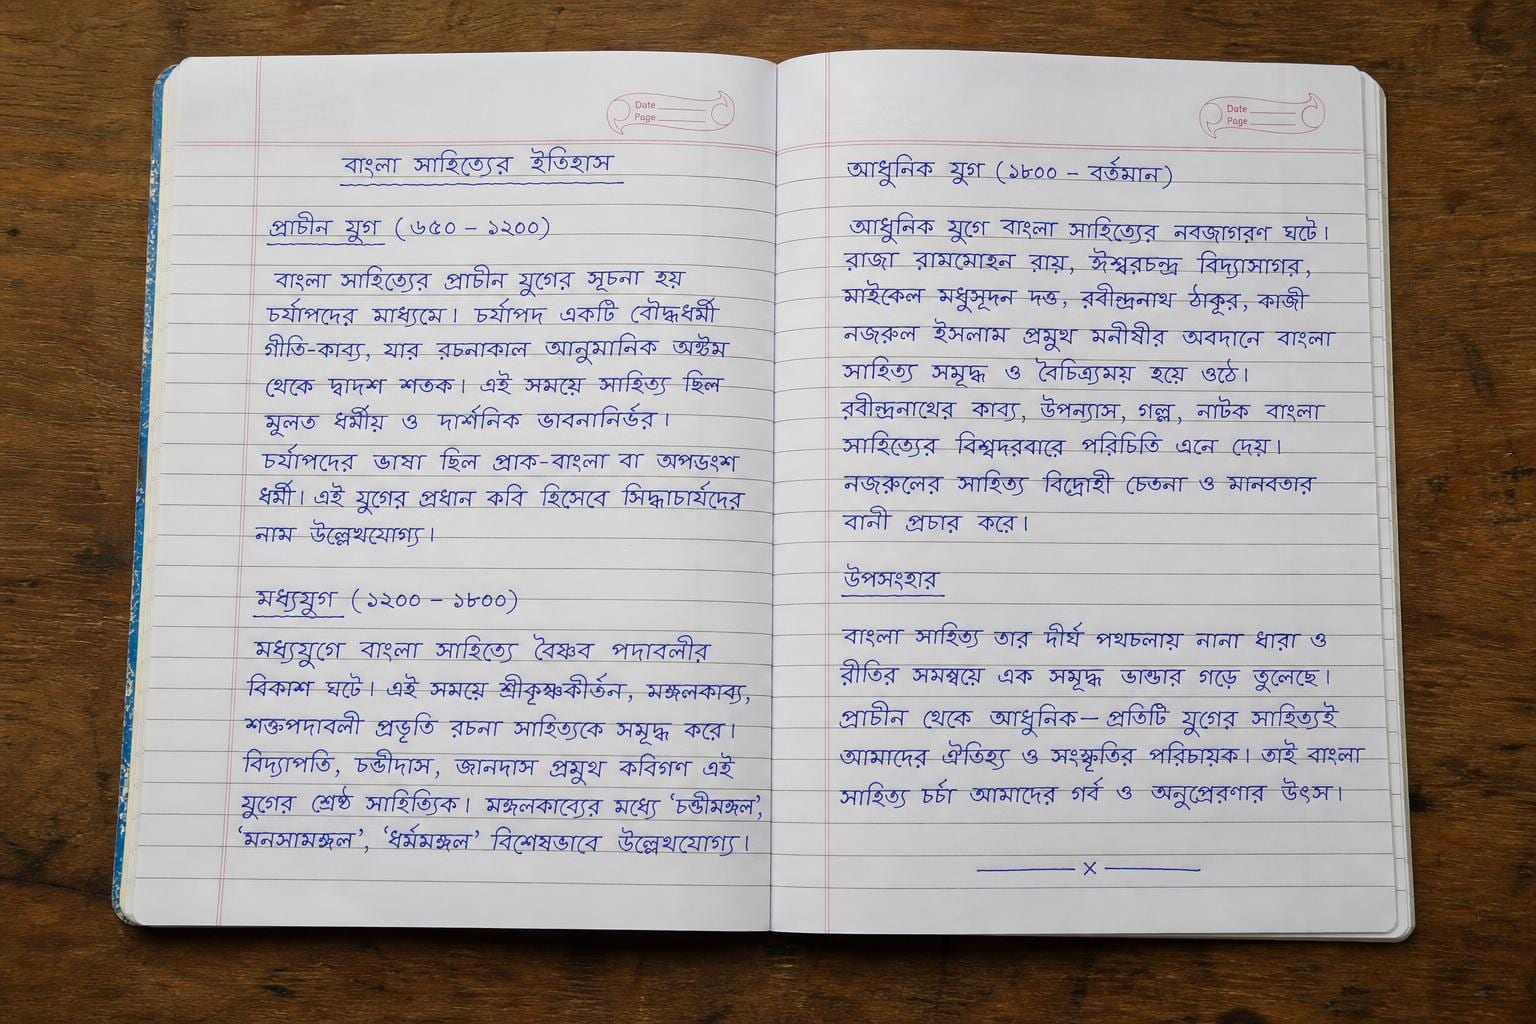
手書き文字の視覚的幾何構造
領域分割の課題を理解するには、この文字体系の物理的なトポロジー(配置構造)に目を向ける必要がある。
ベンガル文字の多くは、「マトラ(matra)」と呼ばれる上部の水平な横線によって単語内で連結している。この連結は画像領域として単語のまとまりを保持するのに役立つが、すべての文字や記号にマトラがあるわけではなく、手書きでは連続した連結が常に維持されるとは限らない。
論文では、頻発する3つの難点が挙げられている。
- マトラを持たない文字や記号が誤った単語分割を引き起こす: 著者らは、「◌ঃ」「◌ং」「◌ঁ」などの記号を誤分割の潜在的要因として挙げている。単語内の連結の欠如や隙間によって、同一単語の構成要素が別々の領域として検出されてしまう。
- 離れた位置にある母音記号が単語境界を複雑にする: 「◌ু」「◌ূ」「ি◌」「◌ী」「ৈ◌」「ে◌ৗ」といった母音記号は、隣接する単語との分離を難しくする。論文では、単語の一部が隣の単語に吸収されたり、本体から離れた記号が本来の単語のバウンディングボックスから除外されたりするケースが報告されている。
- 筆者による単語間隔のばらつき: 単語間や行間のスペースをほとんど空けずに書く筆者もいれば、単語内の文字間隔を大きく空けた散在的な筆跡の筆者もいる。ある筆者の離れた文字同士を結合するためのパラメータ設定が、別の筆者では隣接する単語同士を誤って結合してしまう原因となる。
こうした文字体系自体の特徴に加え、文書の撮影環境による物理的なノイズも加わる。本研究では、影の影響、画像サイズや解像度の差異、カラーインク、色付き用紙などを含むスマートフォン撮影画像を対象としている。これらの多様な条件こそが、すべてのページに単一の固定設定を適用するのではなく、画像自体の特性からフィルタリングや二値化のパラメータを動的に決定するパイプラインを設計する動機となった。
第1ステージ:スマートフォンの撮影ノイズを安定したピクセルへ変換する
KUETチームは、独立した行分割処理を挟むことなく、生のピクセルから単語のバウンディングボックス領域へと変換するシーケンシャルな6段階のパイプラインを構築した。
最初のステップでは、入力画像をグレースケールに変換する。著者らは、最初から白黒画像としてスキャンする方が高速ではあるものの、文字情報の一部が失われる可能性があると説明している。そのため、グレースケール化が後続のフィルタリングおよび二値化処理の起点となる。
続いて適応型ノイズ除去を行う。撮影デバイスによって解像度は異なり、筆者によって文字の大きさ(スケール)も異なる。そこで著者らは、フィルタリング設定を決定するために「平均輪郭サイズ(Average Contour Size: ACS)」という画像固有の指標を導入した。
初期ACSの算出手順は以下の通りである。
- 21×21ピクセルのガウシアンカーネルを用いて初期のノイズ除去を実行する。論文では垂直方向の標準偏差を21、スケーリング係数を7と規定している。
- 21×21のウィンドウサイズで初期の適応型閾値処理を適用する。
- 予備的な輪郭を抽出し、面積が50未満の微小な輪郭をごま塩ノイズ(salt noise)として破棄する。
- 残った輪郭の面積からACSを算出し、以降の処理におけるカーネルサイズの選定に用いる。
文書のACSが求まると、次の平滑化ステージとしてNon-local Means Denoising(非局所平均ノイズ低減法)が適用される。論文では座標変数 $x$ および $y$ を用いた平滑化カーネルの数式も提示されており、$\sigma$ はカーネルサイズの平方根として定義されている。カーネルサイズ自体は、ACSに基づく経験的なルックアップテーブルから取得される。
カーネルサイズを固定するのではなく、算出されたACSに応じて以下のようにサイズを割り当てている。
- $\text{ACS} < 200$ の場合:3×3カーネル
- $200 \le \text{ACS} < 300$ の場合:5×5カーネル
- 以降、1000未満まではACSが100増加するごとにサイズが2ずつ増加し、$900 \le \text{ACS} < 1000$ では19×19に達する。
- さらに $1000 \le \text{ACS} < 1200$ では21×21、$1200 \le \text{ACS} < 1400$ では23×23を使用する。
テーブルで定義された範囲を超える場合は、ACSが200増加するごとにカーネルサイズを2ずつ大きくすると説明されている。
また、著者らはページの背景の明るさも考慮に入れている。画素値が181〜255の明るい背景ではごま塩ノイズが少なく、背景が暗くなるほどノイズが増加すると報告している。そのため、背景の画素値が101〜180の場合は選択されたカーネルサイズを2増やし、100以下の場合は4増やす補正を行っている。
これらは提案システムのために設定された経験的な選択肢である。用紙の色と必要な平滑化強度との間に普遍的な関係性を確立しているわけではなく、推定された輪郭スケールや背景輝度に合わせてフィルタリングを適応させている。
第2ステージ:影の判定テストと適応型二値化
平滑化された画像は、二値表現に変換される必要がある。このパイプラインでは最終的に、黒い背景の上に白い前景色で文字ストロークが描かれる形式に統一される。
二値化の手法として、大津の二値化(Otsu's method)による大域的閾値処理と、適応型閾値処理(adaptive thresholding)のいずれかが選択される。画像全体に単一の閾値で十分な場合は大津の方法を優先し、色付き背景や影の影響がある場合には適応型閾値処理を選択する設計となっている。
この選択にはトレードオフが存在する。論文によると、適応型閾値処理は局所ウィンドウ内で動作するため文字を断片化させやすく、単語の一部が検出輪郭から脱落してしまうことがあるという。一方、大津の方法は適切な条件下であればこの断片化を回避できるため、好んで採用されている。
KUETのパイプラインでは、二値化手法を決定する前に影の影響をチェックするテストを実施する。
$$\frac{\text{Area of largest contour}}{\text{Average Contour Size}} > 100$$
システムは大津の二値化を一度適用し、得られた最大の輪郭の面積を測定する。その面積がACSの100倍を超える場合、画像に影の影響が存在すると判定する。この比率は著者らが定めた検出ヒューリスティックであり、巨大な輪郭のすべてが必ず影であると理論的に証明されているわけではない。
この判定テストと背景の画素強度に基づき、二値化戦略は次のように分岐する。
- 画素値が180未満のカラー用紙または暗い用紙: 適応型閾値処理を使用。
- 画素値が180以上の明るい用紙: 影の影響が検出された場合は適応型閾値処理を使用し、それ以外は大津の閾値処理を使用。
適応型閾値処理におけるウィンドウサイズは、ACSルックアップテーブルから取得される。
二値化後、必要に応じて画素値が反転され、黒背景に白文字の統一表現が生成される。その後、画像はCannyエッジ検出およびHough変換へと送られ、共線構造を特定して傾き補正(skew correction)が行われる。
この傾き補正ステージにおいても、ページ画像を個別のテキスト行画像へと分割することはない。単語検出は依然として事前の行分割処理を行わずに動作する。
第3ステージ:モルフォロジー膨張とピーク輪郭数による停止条件
ここからが最大の難関となる。離れた文字ストロークや独立した記号を単語単位へと統合しつつ、隣接する単語同士の隙間を埋めて結合してしまわないようにすることだ。
著者らは数理モルフォロジー、具体的には白の前景ピクセルを持つ正方形の構造要素を用いた膨張(dilation)処理を採用した。膨張処理は前景領域を拡張する。これにより単語内の構成要素を結合できるが、さらに拡張を続けると隣接する単語同士まで繋がってしまう。
どの時点で膨張を止めるかという「停止点」の決定こそが、中核となる技術的課題である。著者らは、最小面積閾値(Minimum Area Threshold: MAT)と反復的な輪郭カウント探索を組み合わせることでこの問題にアプローチした。
何をもって「単語」とみなすかの定義
システムが単語候補をカウントする前に、どの輪郭を残すべきかのルールが必要となる。MATより大きな面積を持つ連結成分が単語候補としてカウントされ、バウンディングボックスの付与対象となる。
面積閾値を通過したからといって、その領域が正確に1つの完全な単語を含んでいることが保証されるわけではない。これはあくまでパイプラインのフィルタリング基準である。
MATの算出方法は、それ以前に選択された二値化手法によって異なる。
- 大津の閾値処理の後: 著者らはACSから直接MATを算出する。
$$\text{MAT} = \frac{\text{Average Contour Size}}{1.25}$$
- 適応型閾値処理の後: 断片化した輪郭を考慮するため、「筆記密度(Writing Density: WD)」という指標を用いる。
$$\text{Writing Density} = \frac{\text{Total area of the page}}{\text{Average Contour Size}}$$
論文中では、WDが大きいほど「筆記の密度が低い(疎である)」と解釈されている。この式は単語間の隙間を直接計測しているのではなく、平均輪郭面積に対するページ全体の面積比率を表している。
システムはWDをMATの経験式へとマッピングする。テーブルでは、$\text{WD} < 1500$ のときの $\text{ACS} - \frac{\text{ACS}}{4}$ から、$\text{WD} \ge 10000$ のときの $\text{ACS} \times 6$ まで定義されている。その中間の範囲では、ACSに対する他の倍率や分数による調整値が用いられる。
さらに2つ目のテーブルによって、WDとACSの組み合わせに応じた追加の補正が行われる。記載されている規則には、$\text{WD} > 2000$ かつ $\text{ACS} > 700$ の場合に $\frac{\text{ACS}}{8}$ を減算する処理や、WD・ACSがともに大きい特定の範囲でACSに基づく値を加算する処理などが含まれる。
これらのマッピングは、提案手法において経験的に選定された要素である。単語の構成要素を保持しつつ、微小な断片の混入を防ぎ、かつ巨大な領域への誤統合を抑制するバランスを取ることを意図している。
ピーク輪郭探索
MATが定まると、システムはACSに基づいて初期の膨張カーネルサイズを決定する。規定された値は、$\text{ACS} < 100$ の場合の1×1から始まり、$100 \le \text{ACS} < 1000$ では3×3となる。ACSが大きくなるにつれて開始カーネルも大きくなり、大津の二値化ブランチと適応型閾値処理ブランチの間で若干の差異が設けられている。
例えば、$2000 \le \text{ACS} < 2200$ の場合、テーブルでは大津の処理後に9×9、適応型閾値処理後には11×11の初期カーネルが割り当てられる。適応型閾値処理の項目では $2400 \le \text{ACS} < 2600$ で13×13に達するが、これは全画像に対する最大値として提示されているわけではない。
アルゴリズムは、初期カーネルを用いて二値画像を1回膨張させ、面積がMATを超える輪郭の数をカウントする。その後、反復回数またはカーネルサイズのいずれかを増やしながら追加の条件をテストし、残った輪郭の数を再カウントしていく。
この輪郭カウントヒューリスティックは、以下の2つの効果に基づいている。
- 孤立していた構成要素同士が結合してMATを超える大きさの領域となり、保持される単語候補の数が増加する。
- 膨張をさらに進めると隣接する単語領域同士が結合(マージ)し、輪郭の数が減少する。
著者らは、輪郭数が最大となるピークを探索し、それ以上の膨張によって単語同士が衝突・結合してしまう前の段階で処理を停止すると述べている。これは膨張パラメータを決定するためのヒューリスティックである。選択された時点で、すべての単語が過不足なく完全に抽出されていることや、すべての隣接単語が正しく分離されたままであることを保証するものではない。
論文のFigure 4に示された一例では、ACSが641の画像に対して3×3の膨張カーネルから開始している。このカーネルを3回反復適用した最適な設定では、検出された単語数は33個となった。一方、10×10カーネルを2回適用した場合は、結合が生じて23個にまで減少した。
最終的に、選定された最適設定において、保持された単語輪郭を囲む長方形のバウンディングボックスが出力される。
ベンチマーク:3つの異なるデータセットでの検証
提案アプローチを評価するため、KUETチームは3つの文書コレクションでパイプラインを検証した。本プロジェクトのために独自作成されたデータセット、CMATERdb1.1.1、そして論文中で「Bangla Writing dataset」と呼ばれるコレクションである。
1. 独自作成の80文書データセット
多様な撮影条件下での性能を評価するため、著者らは白、赤、青、緑、黒の用紙に様々な筆跡で書かれた80文書のデータセットを構築した。筆記具には、黒、赤、緑、青のゲルインクペン、ボールペン、ラメペン(glittering pen)が使用された。
さらに影の干渉をあえて発生させ、異なる撮影デバイスを用いることで、画像のサイズや解像度にもばらつきを持たせている。
論文で報告された結果は以下の通りである。
- 正解単語数(Ground truth words): 7,374
- 生成されたバウンディングボックス数: 7,278
- 正しく分割された単語数: 6,681
- 分割エラー: 527単語(過少分割・過剰分割・欠損分割に分類)
- 未検出単語数: 166
- 再現率(Recall): 90.60%
- 適合率(Precision): 91.80%
- F1スコア: 91.20%
これらの結果は、著者らが収集した用紙色や影のバリエーションを含むコレクションにおける本手法の有効性を示している。ただし、用紙、インク、筆跡、照明のあらゆる組み合わせに対して高信頼な単語分割を保証するものではない。
2. CMATERdb1.1.1 ベンチマーク
著者らはCMATERdb1.1.1から100件の文書に対してパイプラインを実行し、全15,730単語に対して15,587個のバウンディングボックスを生成した。
- 正しく分割された単語: 13,552
- 分割エラー: 2,048
- 未検出: 130
- 再現率(Recall): 86.15%
- 適合率(Precision): 86.94%
- F1スコア: 86.54%
比較として、Sarkar et al. (2011) は15,730単語中13,530単語を正しく分割し、86.01%の単語分割成功率(2,200単語が過少分割または過剰分割)を達成したと論文中で言及されている。
ここで入力条件の違いが重要となる。KUETの論文によれば、Sarkar et al. は事前にテキスト行へと分割済みの文書画像を入力としていたのに対し、本提案手法はそのような前処理ステージを必要としない。
提案手法の報告された再現率は先行研究の成功率をわずかに上回っている。しかし、入力条件が異なるため、これが全体的な性能優位性を厳密に統制された形で実証した比較であるとは言えない。
3. Bangla Writing データセット
Bangla Writingデータセットの100件の文書に対しても評価が行われた。
- 総単語数: 7,400
- 生成されたバウンディングボックス数: 7,191
- 正しく分割された単語: 6,380
- 分割エラー: 987
- 未検出: 33
- 再現率(Recall): 86.22%
- 適合率(Precision): 88.72%
- F1スコア: 87.45%
論文によると、Das et al. (2023) は本データセットの一部に対し、水平投影プロファイル、シームカービング、輪郭追跡を用いてアプローチした。彼らの報告した結果は、行分割精度88.39%、単語分割精度95.65%、平均精度84.55%であった。
KUETの比較表では、その平均精度84.55%が提案手法の再現率、適合率、F1スコアの横に並べられている。しかし、これらは評価指標自体が異なり、評価に使用されたデータセットのサブセットも異なっている。したがって、87.45%のF1スコアを先行研究の平均精度に対する直接的な性能向上として受け取るべきではない。
パイプラインが破綻する仕組み:4つのエラーモード
本アルゴリズムはテキストを認識するのではなく画像の幾何構造を利用しているため、報告された失敗例も幾何学的なエッジケースに起因している。著者らはこれらを4つのエラータイプに分類している。
なお、以下の分類ラベルは原論文の用語法に準拠している。原論文では、単語の分断を「under-segmentation」、単語の誤統合を「over-segmentation」と呼んでいる。
- 過少分割エラー(単語の分断 / Under-segmentation error): 1つの単語が2つ以上のバウンディングボックスに分断される。著者らは、マトラの欠落、文字間の異常な隙間、マトラを持たない記号(「◌ঃ」「◌ং」「◌ঁ」など)をその主な原因として挙げている。
- 過剰分割エラー(単語の誤結合 / Over-segmentation error): 1つのバウンディングボックスに2つ以上の単語が含まれてしまう。単語間や行間の間隔が不十分な密集した筆跡の場合に、このエラーの発生率が高まる。
- 欠損分割エラー(記号の除外 / Defect-segmentation error): バウンディングボックスが単語を囲んでいるものの、その一部が枠外に取り残される。論文では、「◌া」「ি◌」「◌ঁ」「◌ৃ」「◌ী」などの母音記号やその他の記号が、特に単語本体から離れて書かれた場合の例が挙げられている。
- 見落としエラー(単語の未検出 / Overlooking error): 単語が出力から完全に脱落する。著者らは、最小面積閾値(MAT)を引き上げた際に、面積の小さな単語が除外されやすくなると指摘している。
これらのエラーは、パラメータチューニングにおいて相反するトレードオフをもたらす。開始時の膨張カーネルやMATを小さく設定すれば密集した筆記ページには有効だが、散在的な筆跡では単語の分断エラーが増加してしまうと著者らは報告している。また、膨張カーネルを小さくしすぎると、離れた位置にある記号が単語枠の外に取り残されやすくなる。
句読点もまた別の問題を引き起こす。ベンガル語の文末記号であるダーリ(daari: '।')やカンマなどの記号は、隣接する単語と一緒に検出されてしまうことがあると報告されている。筆跡のスタイルによっては、それらが独立した単語枠として誤認識される場合もある。
さらに、用紙の周囲の背景の画素値が文字の画素値と類似している場合、誤検出が発生することがある。著者らは、背景を除去するために画像の事前クロッピングを提案している。
文書解析およびOCRシステムにとっての意義
KUETの論文は、古典的な画像処理手法によって構築された単語領域分割の具体的な実装例を提示している。その貢献は、単語領域を生成する手法を確立し、領域分割のカウント数と評価指標によってその有効性を検証した点にある。
ただし本研究は、切り出された領域内部の単語のテキスト認識までは評価していない。正しく切り出された画像は後続のOCRステージへの入力データに過ぎず、文字が正しく転写されたことの証明ではないという点は、結果を解釈する上で極めて重要である。また、日本語文書の処理を念頭に置く読者にとっては、本作が横書きのベンガル語のみを対象としており、多くのOCR/VLMモデルにとって最大の難関となる縦書き配置や、分かち書きのない漢字・かな混じり文の構造には言及していない点に留意が必要だ。
行分割処理への依存の排除
一般的な文書の領域分割ワークフローは、以下のような階層構造で進められることが多い。
$$\text{Page} \longrightarrow \text{Text Lines} \longrightarrow \text{Words} \longrightarrow \text{Characters}$$
このようなワークフローでは、行分割で生じたエラーが後続の単語抽出に直接悪影響を及ぼす。論文の関連研究の議論でも、手書きの行同士が重複している場合や、行の長さ・傾きが大きく異なる場合の難しさが指摘されている。
提案手法は、文書をあらかじめ個別のテキスト行へと分割することなく単語領域を直接抽出する。著者らは、これにより単語抽出が行分割の成否に依存するリスクを回避できると主張している。
もっとも、これによって密集した単語や行によるエラーが完全に排除されるわけではない。そうした条件下での失敗例は論文のエラー分析にも依然として現れている。得られる利点は、あくまで事前の行分割という前処理への依存を排除できたことであり、分割エラーが特定の単語ペアのみに留まることを保証するものではない。
ディープラーニングを用いない古典的処理と実行時間ベンチマークの不在
提示されたパイプラインは、グレースケール変換、ノイズ除去、二値化、Cannyエッジ検出、Hough変換、そしてモルフォロジー膨張で構成されている。提案された単語分割手法の中にディープラーニングモデルは一切含まれていない。
この点は、古典的アプローチの実践的な実例として本論文を興味深いものにしている。しかしながら、具体的な実行速度やデプロイコストが実証されているわけではない。
本研究は領域分割の精度結果を報告しているものの、実行時間、メモリ消費量、消費電力、あるいはオンデバイスでの実行ベンチマークは一切提示していない。「スマートフォンで撮影された画像」というのは入力ソースの説明に過ぎず、処理自体がスマートフォン上で実行されたことを示すものではない。
したがって、ミリ秒単位の実行速度やローエンド端末での動作性能、バッテリー消費量、さらにはニューラルネットワークに対する優位性といった主張は、論文で示された実証の範囲を超えている。
経験的ルックアップテーブルの限界
また本論文は、このアプローチに求められるチューニングの難しさも浮き彫りにしている。
マッピングテーブルは、ACSやWDを平滑化カーネル、面積閾値、初期膨張カーネルへと対応付けている。これらのテーブルは離散的な閾値で区切られているため、例えばACSが299であれば5×5の平滑化カーネルが選択され、ACSが301になれば7×7のカーネルが選択される。
つまり、テーブルの境界値をわずかに跨ぐだけで処理パラメータが変化してしまう。論文ではこうした境界付近での感度分析は行われておらず、これらのマッピングが新たな撮影条件に対しても堅牢に汎化するかどうかは確立されていない。
著者らによるエラー分析は、なぜチューニングが困難であるのかを如実に示している。膨張を強めれば単語内の離れた部分を結合できるが、同時に隣接する単語まで結合してしまう。面積閾値を引き上げれば、小さな単語が除外されてしまう。筆跡スタイルの違いによって、最適な設定値の方向性が相反するのである。
提案されている改善策も、観察された失敗例に直結している。著者らは、複数の単語を含むバウンディングボックスに対する入れ子状の再処理や、適応型閾値処理および膨張フィルタサイズのより精密な調整を提案している。さらに、単語間にほとんど隙間がないケースに対しては、辞書データで学習した機械学習モデルの導入も挙げている。
ただしこれらは将来の展望であり、報告されたパイプライン上で検証された拡張機能ではない。
Satter、Masrur、Ahsan は、適応的な古典的パイプラインによって、色付き用紙や影の影響を受けた写真を含む複数のデータセットにおいて手書きベンガル語の単語分割が可能であることを示した。輪郭カウント探索と詳細なエラー分析は、単語分割分野に対する具体的な貢献であり、それらの領域ボックスを編集可能なテキストへと変換するために不可欠な後続の認識ステージへの確かな足がかりを提供している。