Segmentación de bengalí manuscrito sin deep learning: análisis en profundidad de procesamiento de imágenes
Basado en: Color Independent Word Segmentation From Transcribed Bangla Passages — Faias Satter, Noor Masrur, Sk. Md. Masudul Ahsan
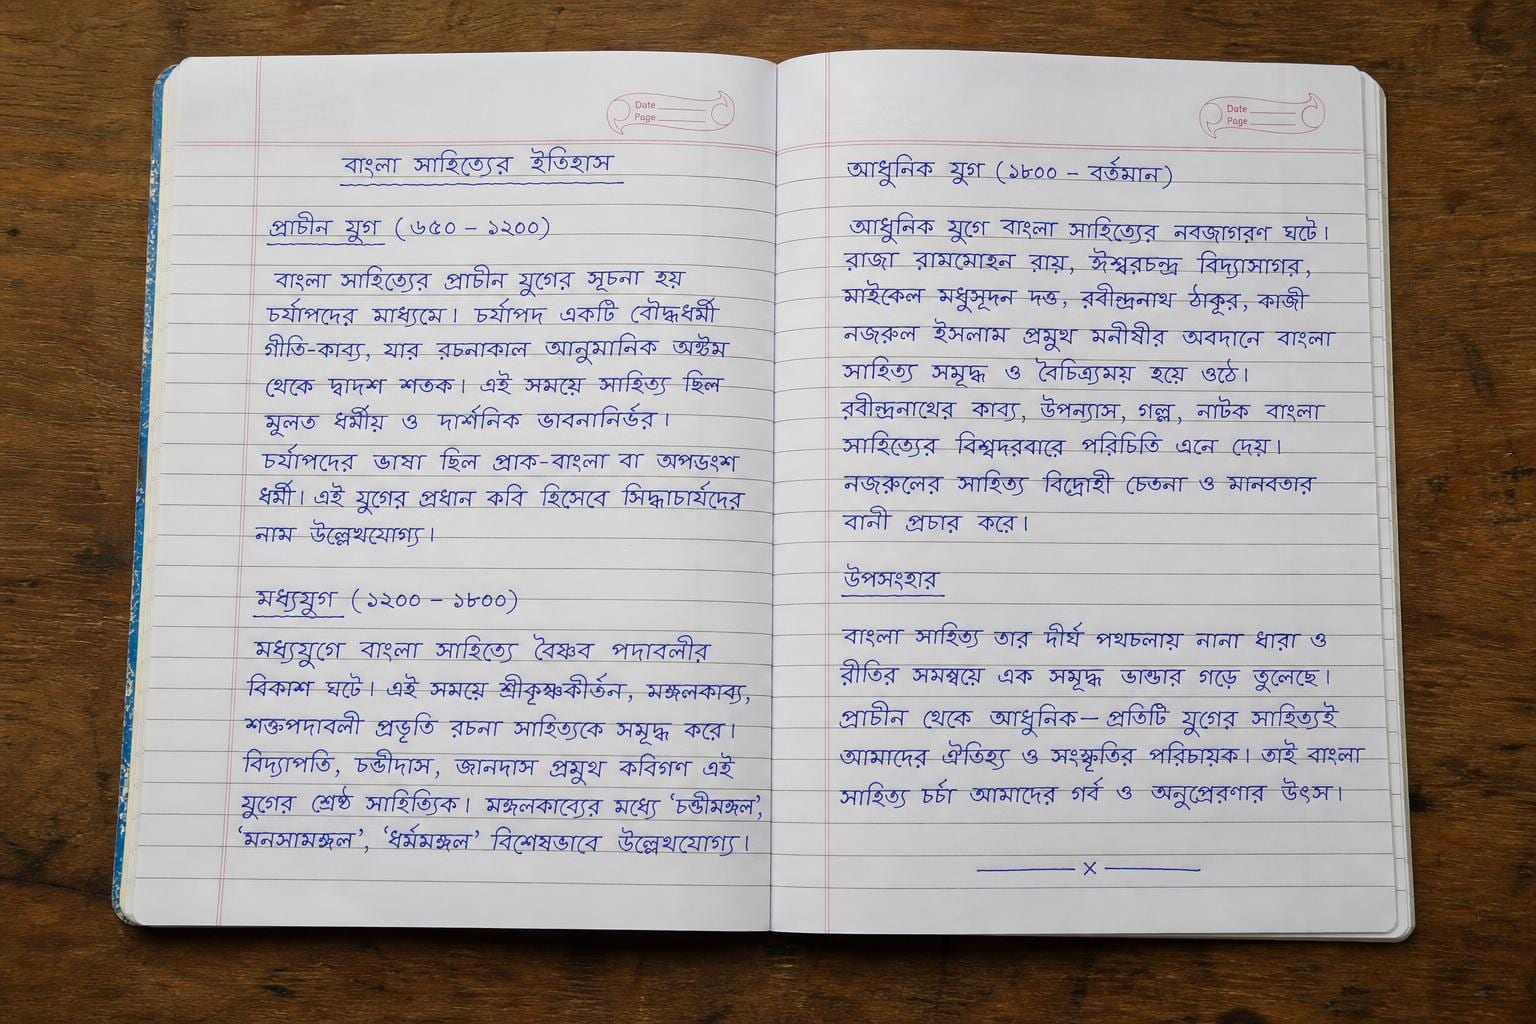
Si tomas una fotografía de un fragmento manuscrito en bengalí, el desafío que aborda este estudio se presenta antes de reconocer una sola palabra. Un algoritmo de segmentación debe decidir qué trazos de tinta van juntos y dónde termina una palabra y comienza la siguiente. Quienes escriben a mano no siempre dejan los espacios que facilitarían esas decisiones.
Las palabras muy próximas entre sí pueden fusionarse en una única región detectada. Los caracteres y marcas desconectados pueden hacer que una sola palabra parezca varias.
Los autores señalan que un OCR fiable para bengalí manuscrito es difícil de encontrar. Su investigación se centra en la segmentación de palabras: la fase que divide la imagen de una página en regiones de palabras individuales. Los errores en esta etapa pueden hacer que las fases posteriores de reconocimiento trabajen con palabras incompletas o con varias palabras agrupadas en un solo recorte.
En su artículo, Color Independent Word Segmentation From Transcribed Bangla Passages, los investigadores Faias Satter, Noor Masrur y Sk. Md. Masudul Ahsan de la Khulna University of Engineering & Technology (KUET) abordan este cuello de botella mediante un pipeline clásico y adaptativo de procesamiento de imágenes. Prueban documentos capturados con smartphones bajo diferentes colores de papel, tipos de bolígrafo e interferencias de sombras, extrayendo cuadros delimitadores de palabras mediante una heurística iterativa de conteo de contornos. El manuscrito se publicó en arXiv el 1 de octubre de 2026 y se identifica como la versión aceptada de un artículo publicado en la 2023 International Conference on Electrical Information and Communication Technology (EICT).
A continuación se detalla el análisis técnico de por qué el bengalí manuscrito complica la segmentación, cómo diseñó su pipeline el equipo de la KUET y qué establecen los resultados reportados.
La geometría visual de una escritura manuscrita
Para comprender el problema de la segmentación, es necesario observar la topografía física de la escritura.
Muchos caracteres en bengalí se conectan dentro de una misma palabra mediante un trazo horizontal superior conocido como matra. Esta unión puede ayudar a mantener agrupada una palabra como una sola región en la imagen, pero no todos los caracteres o marcas poseen matra, y la escritura manual no siempre conserva una conexión continua.
El artículo describe tres complicaciones recurrentes:
- Los caracteres y marcas sin matra generan divisiones erróneas de palabras. Los autores identifican signos como '◌ঃ', '◌ং' y '◌ঁ' como posibles fuentes de errores de división. La falta de conexiones o los espacios dentro de una palabra pueden provocar que sus partes queden repartidas en regiones detectadas independientes.
- Las marcas desprendidas complican la delimitación de palabras. Los signos vocálicos como '◌ু', '◌ূ', 'ি◌', '◌ী', 'ৈ◌' y 'ে◌ৗ' pueden entorpecer la separación entre palabras contiguas. Los autores describen componentes de palabras absorbidos por palabras vecinas, así como marcas distantes que quedan excluidas del cuadro delimitador de su propia palabra.
- Espaciado interpalabra variable. Algunos autores dejan muy poco espacio entre palabras y líneas. Otros escriben con un estilo disperso, dejando grandes huecos entre caracteres de una misma palabra. Un ajuste que logre conectar las letras separadas de un autor puede terminar fusionando las palabras adyacentes de otro.
Sumado a las particularidades del sistema de escritura, la captura de documentos introduce factores físicos adversos. El estudio incluye imágenes de smartphones con interferencias de sombras, distintas resoluciones y tamaños, tintas de diversos colores y papeles de tonos variados. Estas circunstancias justifican un pipeline que adapte sus ajustes de filtrado y umbralización a cada imagen en lugar de aplicar parámetros fijos a todas las páginas.
Etapa 1: Convertir el caos de la cámara del teléfono en píxeles estables
El equipo de la KUET estructuró su solución como un pipeline secuencial de seis etapas que pasa de los píxeles brutos a regiones delimitadas de palabras sin requerir una fase previa de segmentación de líneas.
El primer paso convierte la imagen entrante a escala de grises. Los autores explican que, aunque escanear directamente en blanco y negro resulta más rápido, puede perderse información de los caracteres. La escala de grises ofrece así el punto de partida óptimo para las fases posteriores de filtrado y umbralización.
A continuación se realiza una reducción adaptativa de ruido. Distintos dispositivos capturan imágenes a diferentes resoluciones y distintos autores escriben caracteres a diversas escalas. Los autores emplean una métrica propia de la imagen llamada Average Contour Size (ACS) para determinar los parámetros del filtrado.
Para calcular el ACS inicial:
- El sistema ejecuta una pasada inicial de eliminación de ruido con un kernel gaussiano de 21 por 21 píxeles. El artículo especifica una desviación estándar en el eje vertical de 21 y un factor de escala de 7.
- Aplica una umbralización adaptativa inicial con una ventana de 21 por 21.
- Extrae contornos preliminares, descartando como ruido de sal aquellos cuya área sea inferior a 50.
- El promedio del área de los contornos restantes define el ACS, utilizado posteriormente para seleccionar el tamaño de los kernels.
Una vez determinado el ACS del documento, el artículo describe la siguiente fase de suavizado mediante Non-local Means Denoising. También define la ecuación del kernel de suavizado a partir de las coordenadas $x$ e $y$, estableciendo $\sigma$ como la raíz cuadrada del tamaño del kernel. Las dimensiones de este kernel se obtienen de una tabla empírica de consulta indexada por el ACS.
En vez de fijar las medidas del kernel, los autores asignan el ACS calculado a diferentes tamaños:
- Un ACS inferior a 200 emplea un kernel de 3 por 3.
- Un ACS de 200 hasta, pero sin incluir, 300 utiliza un kernel de 5 por 5.
- Los tamaños aumentan de 2 en 2 a través de intervalos sucesivos de 100 unidades de ACS hasta 1000, alcanzando 19 por 19 para $900 \le \text{ACS} < 1000$.
- Los siguientes intervalos usan 21 por 21 para $1000 \le \text{ACS} < 1200$ y 23 por 23 para $1200 \le \text{ACS} < 1400$.
Para valores superiores a los de la tabla, los autores indican aumentar el tamaño del kernel en 2 por cada 200 unidades adicionales de ACS.
Los investigadores también consideran el brillo del fondo de la página. Indican que existe menor ruido de sal en fondos claros con valores de píxel entre 181 y 255, y que el ruido se incrementa en fondos oscuros. Con valores de fondo de 101 a 180, aumentan el tamaño del kernel seleccionado en 2. Para valores por debajo de 100, lo aumentan en 4.
Estas decisiones empíricas se diseñaron específicamente para el sistema propuesto. Permiten adaptar el filtrado a la escala estimada de los contornos y al brillo del fondo, sin pretender establecer una ley universal entre el color del papel y la intensidad de suavizado necesaria.
Etapa 2: La prueba de sombras y la binarización adaptativa
Tras el suavizado, la imagen debe convertirse a una representación binaria. El pipeline estandariza finalmente esta representación en trazos de primer plano blancos sobre un fondo negro.
Los autores eligen entre umbralización global (método de Otsu) y umbralización adaptativa. Optan por Otsu cuando un único umbral resulta suficiente para la imagen, reservando la umbralización adaptativa para fondos con color o interferencias de sombras.
Esta elección supone un compromiso técnico. El artículo señala que la umbralización adaptativa tiende a fragmentar caracteres al operar en ventanas locales, lo que puede provocar que partes de una palabra queden excluidas de su contorno. Según los autores, Otsu es preferible bajo condiciones favorables porque evita dicha fragmentación.
El pipeline de la KUET realiza una comprobación de sombras antes de determinar el método de binarización:
$$\frac{\text{Area of largest contour}}{\text{Average Contour Size}} > 100$$
El sistema aplica umbralización de Otsu y mide el contorno resultante más grande. Si su área supera 100 veces el ACS, el pipeline asume que la imagen presenta interferencia de sombras. Esta relación es una heurística de detección propuesta por los autores; el artículo no afirma que todo contorno grande corresponda necesariamente a una sombra.
A partir de esta prueba y de la intensidad de los píxeles del fondo, la binarización se bifurca:
- Papel de color u oscuro, con valores de píxel inferiores a 180: Se aplica umbralización adaptativa.
- Papel claro, con valores de píxel iguales o superiores a 180: Se aplica umbralización adaptativa si se detectan sombras; de lo contrario, se aplica umbralización de Otsu.
El tamaño de la ventana para la umbralización adaptativa se obtiene de la tabla de consulta del ACS.
Finalizada la umbralización, los píxeles se invierten donde sea necesario para conseguir trazos blancos sobre fondo negro. Posteriormente, la imagen se procesa con detección de bordes de Canny y una transformada de Hough para identificar estructuras colineales empleadas en la corrección de inclinación (skew correction).
Esta etapa de corrección no divide la página en imágenes individuales de líneas de texto. La detección de palabras sigue funcionando sin una fase intermedia de segmentación por líneas.
Etapa 3: Dilatación morfológica y el punto de parada por pico de contornos
Llegados a este punto surge el problema central: agrupar trazos sueltos de caracteres y marcas separadas en palabras completas sin llegar a unir palabras adyacentes.
Los autores recurren a la morfología matemática, concretamente a la dilatación con un elemento estructurante cuadrado sobre los píxeles blancos del primer plano. La dilatación expande las regiones activas: puede consolidar componentes dentro de una palabra, pero una expansión excesiva provocará la fusión de palabras vecinas.
Identificar el punto de parada exacto constituye el núcleo del desafío técnico. Los autores lo resuelven mediante un umbral de área mínima (Minimum Area Threshold, MAT) junto con una búsqueda iterativa basada en el conteo de contornos.
Definir qué cuenta como una palabra
Antes de contabilizar candidatos a palabras, el sistema necesita un criterio para conservar contornos. Las regiones conexas con un área superior al MAT se consideran candidatas y reciben cuadros delimitadores (bounding boxes).
Superar este umbral de área no asegura que la región contenga con exactitud una única palabra completa: constituye únicamente la regla de filtrado del pipeline.
El cálculo del MAT depende del método de binarización utilizado previamente:
- Tras umbralización de Otsu: El MAT se calcula directamente desde el ACS:
$$\text{MAT} = \frac{\text{Average Contour Size}}{1.25}$$
- Tras umbralización adaptativa: Para compensar la fragmentación de contornos, los autores introducen la métrica Writing Density (WD):
$$\text{Writing Density} = \frac{\text{Total area of the page}}{\text{Average Contour Size}}$$
El artículo interpreta un valor alto de WD como una caligrafía menos densa. La fórmula relaciona el área total de la página con el área promedio del contorno, en lugar de medir directamente la separación física entre palabras.
El sistema asigna el valor de WD a una fórmula empírica para fijar el MAT. La tabla varía desde $\text{ACS} - \frac{\text{ACS}}{4}$ cuando $\text{WD} < 1500$ hasta $\text{ACS} \times 6$ cuando $\text{WD} \ge 10000$. Los rangos intermedios aplican otros múltiplos y fracciones del ACS.
Una segunda tabla introduce correcciones adicionales según combinaciones de WD y ACS. Entre sus reglas se incluye restar $\frac{\text{ACS}}{8}$ cuando $\text{WD} > 2000$ y $\text{ACS} > 700$, así como añadir incrementos proporcionales al ACS en rangos con valores elevados de ambos parámetros.
Estas reglas de correspondencia son elecciones empíricas del método, diseñadas para equilibrar la conservación de las partes de cada palabra frente a la retención de pequeños fragmentos o la fusión indebida de regiones grandes.
La búsqueda del pico de contornos
Una vez definido el MAT, el sistema determina el tamaño inicial del kernel de dilatación a partir del ACS. La tabla comienza en 1 por 1 para un ACS menor a 100 y 3 por 3 para $100 \le \text{ACS} < 1000$. Los rangos mayores de ACS reciben kernels iniciales más grandes, con variaciones entre las ramas de Otsu y de umbralización adaptativa.
Por ejemplo, la tabla asigna un kernel inicial de 9 por 9 tras Otsu y de 11 por 11 tras umbralización adaptativa cuando $2000 \le \text{ACS} < 2200$. Para la umbralización adaptativa, las entradas listadas alcanzan 13 por 13 en el intervalo $2400 \le \text{ACS} < 2600$, sin que esto constituya un límite superior estricto para todas las imágenes.
El algoritmo dilata la imagen binaria con el kernel inicial durante una iteración y cuenta los contornos cuya área sobrepasa el MAT. A continuación prueba nuevas configuraciones —incrementando las iteraciones o el tamaño del kernel— y vuelve a contar los contornos que superan el umbral.
Esta heurística de conteo de contornos descansa en dos efectos antagónicos:
- Los elementos desconectados se agrupan en regiones de tamaño suficiente para superar el MAT, elevando el recuento de candidatos a palabra.
- Con dilataciones mayores, las palabras contiguas empiezan a fusionarse entre sí, reduciendo el recuento total de contornos.
Los autores buscan el número máximo de contornos detectados y detienen el proceso antes de que dilataciones adicionales provoquen la colisión de palabras. Se trata de un método heurístico para seleccionar la dilatación; no garantiza que cada palabra esté íntegra ni que todas las palabras contiguas permanezcan separadas en el punto de corte.
En un ejemplo documentado en la Figura 4 del artículo, una imagen con un ACS de 641 parte de un kernel de dilatación de 3 por 3. Aplicar dicho kernel durante 3 iteraciones produce 33 palabras detectadas en el ajuste óptimo mostrado. En contraste, un kernel de 10 por 10 con 2 iteraciones detecta solo 23.
Finalmente, se ajustan cuadros delimitadores rectangulares alrededor de los contornos conservados en la configuración seleccionada.
Benchmarks: pruebas en tres conjuntos de datos distintos
Para evaluar el rendimiento del pipeline, el equipo de la KUET lo sometió a prueba en tres colecciones de documentos: un conjunto de datos propio creado para el proyecto, CMATERdb1.1.1 y la colección denominada en el artículo como Bangla Writing dataset.
1. El dataset personalizado de 80 documentos
Con el objetivo de probar condiciones de captura heterogéneas, los autores compilaron un dataset de 80 documentos que engloba diversos estilos caligráficos sobre papeles blancos, rojos, azules, verdes y negros. Se utilizaron bolígrafos de gel, tradicionales y con purpurina en tinta negra, roja, verde y azul.
Asimismo, introdujeron sombras y emplearon diferentes dispositivos de captura para obtener imágenes de variadas dimensiones y resoluciones.
El artículo reporta:
- Ground truth words: 7,374
- Bounding boxes generated: 7,278
- Correctly segmented words: 6,681
- Segmentation errors: 527 palabras, clasificadas como under-segmented, over-segmented o defect-segmented
- Undetected words: 166
- Recall: 90.60%
- Precision: 91.80%
- F1-score: 91.20%
Estos resultados demuestran la viabilidad del método en la colección de prueba de los autores con sombras y papeles de colores, pero no garantizan una segmentación infalible ante cualquier combinación de papel, tinta, estilo manuscrito e iluminación.
2. CMATERdb1.1.1 benchmark
Los autores ejecutaron el pipeline sobre 100 documentos de CMATERdb1.1.1, generando 15,587 cuadros delimitadores para un total de 15,730 palabras:
- Correctly segmented: 13,552 palabras
- Segmentation errors: 2,048 palabras
- Undetected: 130 palabras
- Recall: 86.15%
- Precision: 86.94%
- F1-score: 86.54%
A modo de referencia, el artículo indica que Sarkar et al. (2011) alcanzaron una tasa de acierto en segmentación de palabras del 86.01%: 13,530 palabras correctamente segmentadas de 15,730, con 2,200 palabras subsegmentadas o sobresegmentadas.
La diferencia en los datos de entrada es clave: según el estudio de la KUET, Sarkar et al. utilizaron imágenes previamente segmentadas en líneas de texto, mientras que el método propuesto prescinde de dicha fase preliminar.
El recall reportado por la propuesta es ligeramente superior a la tasa de acierto del trabajo previo. No obstante, las distintas condiciones de entrada impiden considerar esta comparación como una demostración concluyente de superioridad global.
3. Bangla Writing dataset
El sistema también se evaluó sobre 100 documentos del Bangla Writing dataset:
- Total words present: 7,400
- Bounding boxes generated: 7,191
- Correctly segmented: 6,380 palabras
- Segmentation errors: 987 palabras
- Undetected: 33 palabras
- Recall: 86.22%
- Precision: 88.72%
- F1-score: 87.45%
El artículo indica que Das et al. (2023) trabajaron sobre una sección de este dataset aplicando perfiles de proyección horizontal, seam carving y trazado de contornos. Reportaron una exactitud en segmentación de líneas del 88.39%, una exactitud en segmentación de palabras del 95.65% y una exactitud media del 84.55%.
La tabla comparativa de la KUET sitúa esa exactitud media del 84.55% junto al recall, precision y F1-score de su propio método. Al tratarse de métricas diferentes evaluadas sobre partes distintas del dataset, el F1-score de 87.45% no debe interpretarse como una mejora directa sobre la exactitud media del trabajo precedente.
Cómo falla el pipeline: cuatro modos de error
Dado que el algoritmo se basa en la geometría de la imagen y no en el reconocimiento del texto, los errores documentados responden a casos límite geométricos. Los autores los dividen en cuatro tipos.
La clasificación utiliza la terminología del artículo original, donde la división indebida de una palabra se denomina under-segmentation y la fusión de varias se denomina over-segmentation:
- Error de subsegmentación (under-segmentation / división de palabras): Una misma palabra queda repartida en dos o más cuadros delimitadores. Los autores lo atribuyen a la ausencia de matra, a separaciones inusualmente amplias entre caracteres internos y a signos sin matra como '◌ঃ', '◌ং' y '◌ঁ'.
- Error de sobresegmentación (over-segmentation / fusión de palabras): Un solo cuadro delimitador agrupa dos o más palabras. Es común en escrituras densas donde los espacios entre palabras o líneas son mínimos.
- Error de segmentación defectuosa (defect-segmentation / marcas excluidas): El cuadro delimitador rodea la palabra pero deja fuera parte de ella. El artículo cita ejemplos con signos vocálicos y otras marcas como '◌া', 'ি◌', '◌ঁ', '◌ৃ' y '◌ী', especialmente cuando se trazan apartadas del cuerpo principal.
- Error de omisión (overlooking / palabras no detectadas): Una palabra no aparece en el resultado final. Los autores observan que palabras de reducida superficie son proclives a desaparecer si se incrementa el umbral de área mínima.
Estos errores generan tensiones contrapuestas durante el ajuste del sistema. Un kernel inicial de dilatación más pequeño o un MAT más reducido ayudan en documentos densos, pero los autores advierten que incrementan las fragmentaciones en caligrafías dispersas. Un kernel pequeño también tiende a dejar marcas distantes fuera del cuadro de su palabra.
La puntuación añade dificultades adicionales. El texto indica que signos como el daari de fin de frase en bengalí ('।') o las comas pueden acabar integrados en palabras contiguas o, en otros estilos caligráficos, recibir cuadros delimitadores independientes.
Por último, el área circundante al documento puede dar lugar a falsas detecciones si sus valores de píxel se asemejan a los trazos de los caracteres. Los autores sugieren recortar los márgenes de la imagen para descartar ese fondo.
Por qué es relevante para el análisis de documentos y los sistemas de OCR
El artículo de la KUET proporciona un ejemplo detallado de segmentación de palabras fundamentado exclusivamente en operaciones clásicas de procesamiento de imágenes. Su aportación consiste en un método para aislar regiones de palabras, validado cuantitativamente mediante métricas y recuentos de segmentación.
El trabajo no evalúa el reconocimiento del texto dentro de estas regiones. Conviene remarcar esta diferencia: un recorte correctamente segmentado sirve como entrada para fases posteriores de OCR, pero no acredita que el texto haya sido transcrito con éxito.
Eliminar la dependencia de la segmentación de líneas
Un flujo convencional de segmentación suele seguir una estructura jerárquica:
$$\text{Page} \longrightarrow \text{Text Lines} \longrightarrow \text{Words} \longrightarrow \text{Characters}$$
Bajo este esquema, cualquier fallo en la segmentación de líneas se arrastra a la extracción de palabras. La revisión bibliográfica del artículo destaca los problemas que surgen cuando las líneas manuscritas se solapan o cuando sus longitudes varían considerablemente.
El método propuesto obtiene las regiones de las palabras directamente, sin segmentar previamente el documento en líneas. Los autores sostienen que este diseño desacopla la extracción de palabras del éxito de una fase de división por líneas.
Esto no elimina los fallos causados por palabras o renglones muy abarrotados, situaciones que siguen apareciendo en el análisis de errores. La ventaja radica en suprimir esa etapa previa de preprocesamiento, no en evitar que los errores de segmentación afecten a palabras contiguas.
Procesamiento clásico, sin benchmarks de rendimiento en tiempo real
El pipeline descrito recurre a la conversión a escala de grises, reducción de ruido, umbralización, detección de bordes de Canny, transformada de Hough y dilatación morfológica. No incluye ningún modelo de deep learning en su proceso de segmentación.
Esto convierte al artículo en una valiosa referencia práctica sobre métodos clásicos. No obstante, no aporta datos sobre velocidad de ejecución ni costes computacionales de despliegue.
El estudio presenta métricas de segmentación, pero no incluye evaluaciones de tiempo de procesamiento, consumo de memoria, gasto energético ni rendimiento en dispositivos embebidos. Que las imágenes provengan de teléfonos móviles describe el origen de los datos, pero no prueba que el algoritmo se ejecutara en un smartphone.
Por tanto, asumir tiempos de ejecución en milisegundos, viabilidad en teléfonos de gama baja, bajo consumo de batería o ventajas competitivas frente a modelos neuronales constituiría una extrapolación sin respaldo en la evidencia reportada.
Los límites de las tablas de consulta empíricas
El trabajo pone igualmente de relieve la dificultad de calibrar este tipo de sistemas.
Las tablas de correspondencia asocian el ACS y el WD con los kernels de suavizado, los umbrales de área y los kernels de dilatación iniciales mediante escalones discretos: por ejemplo, un ACS de 299 asigna un kernel de suavizado de 5 por 5, mientras que un ACS de 301 pasa a seleccionar uno de 7 por 7.
Esto implica que variaciones mínimas en torno a los umbrales de la tabla alteran los parámetros del procesamiento. El artículo no evalúa la sensibilidad del método en estos límites ni garantiza que las correspondencias funcionen de manera consistente ante nuevas condiciones de captura.
El análisis de errores muestra la complejidad de este equilibrio: aumentar la dilatación puede unir partes fragmentadas de una palabra al tiempo que fusiona palabras contiguas; subir el umbral de área puede omitir palabras pequeñas; y los distintos estilos de escritura exigen configuraciones contradictorias.
Las propuestas de mejora de los autores se ajustan a estos problemas observados: plantean procesamientos anidados para cuadros delimitadores que agrupen varias palabras, ajustes más finos de las ventanas de filtrado y dilatación, y el uso de un modelo de machine learning entrenado con diccionarios para resolver casos sin separación visual entre palabras.
Se trata de líneas de trabajo futuro y no de extensiones evaluadas en el pipeline presentado.
Satter, Masrur y Ahsan demuestran que un pipeline clásico adaptativo puede segmentar bengalí manuscrito en varios conjuntos de datos, incluyendo documentos sobre papeles de colores y con interferencia de sombras. Su método de búsqueda por conteo de contornos y su pormenorizado análisis de fallos aportan una contribución tangible a la segmentación de palabras, sirviendo de base para los módulos posteriores de reconocimiento que transformarán esos recortes en texto editable.