Segmentação de Bangla manuscrito sem deep learning: uma análise aprofundada de processamento de imagens
Baseado em: Color Independent Word Segmentation From Transcribed Bangla Passages — Faias Satter, Noor Masrur, Sk. Md. Masudul Ahsan
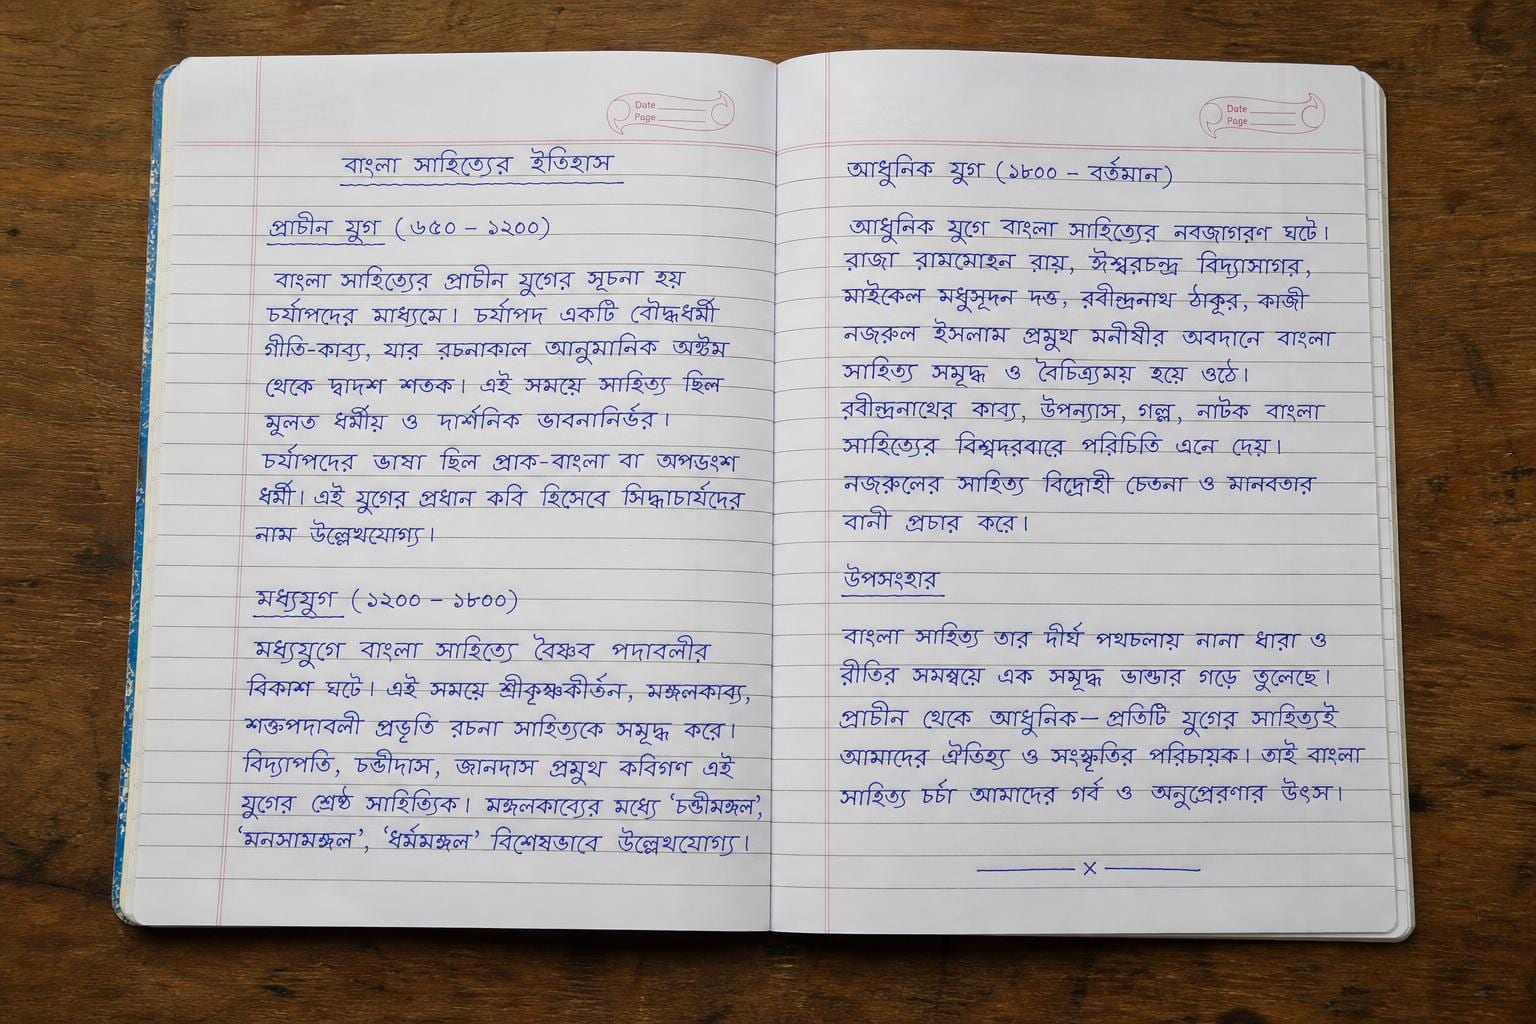
Se você tirar uma foto de um texto manuscrito em Bangla, o desafio abordado por este estudo surge antes mesmo do reconhecimento de uma única palavra. Um algoritmo de segmentação precisa decidir quais traços de tinta pertencem ao mesmo grupo e onde uma palavra termina e a próxima começa. Escritores humanos nem sempre deixam os espaçamentos que tornariam essas decisões fáceis.
Palavras muito próximas podem se fundir em uma única região detectada. Caracteres e sinais desconectados podem fazer com que uma única palavra pareça ser várias.
Os autores descrevem sistemas confiáveis de OCR para Bangla manuscrito como algo difícil de encontrar. A pesquisa concentra-se na segmentação de palavras — a etapa que divide a imagem da página em regiões de palavras individuais. Erros nessa fase podem fazer com que as etapas posteriores de reconhecimento tenham que lidar com palavras incompletas ou com várias palavras agrupadas em um único recorte.
Em seu artigo, Color Independent Word Segmentation From Transcribed Bangla Passages, os pesquisadores Faias Satter, Noor Masrur e Sk. Md. Masudul Ahsan, da Khulna University of Engineering & Technology (KUET), enfrentam esse gargalo com um pipeline clássico e adaptativo de processamento de imagens. Eles testam documentos capturados por smartphones com diferentes cores de papel, tipos de caneta e interferência de sombras, extraindo caixas delimitadoras de palavras por meio de uma heurística iterativa de contagem de contornos. O manuscrito foi publicado no arXiv em 1º de outubro de 2026 e identifica-se como a versão aceita de um artigo publicado na 2023 International Conference on Electrical Information and Communication Technology (EICT).
A seguir, apresentamos uma análise técnica detalhada de por que o Bangla manuscrito complica a segmentação, como a equipe da KUET projetou seu pipeline e o que os resultados relatados comprovam.
A geometria visual de uma escrita manuscrita
Para compreender o problema da segmentação, é preciso analisar a topografia física dessa escrita.
Muitos caracteres em Bangla conectam-se dentro de uma palavra por meio de um traço horizontal conhecido como matra. Essa conexão pode ajudar a manter a palavra unida como uma região de imagem, mas nem todo caractere ou sinal possui uma matra, e a escrita manual nem sempre preserva uma conexão contínua.
O artigo descreve três complicações recorrentes:
- Caracteres e sinais sem matra criam falsas quebras de palavras. Os autores identificam sinais como '◌ঃ', '◌ং' e '◌ঁ' como fontes potenciais de erros de divisão. Conexões ausentes ou espaçamentos dentro de uma palavra podem fazer com que seus componentes fiquem em regiões detectadas separadas.
- Sinais desconectados complicam os limites das palavras. Sinais vocálicos como '◌ু', '◌ূ', 'ি◌', '◌ী', 'ৈ◌' e 'ে◌ৗ' podem dificultar a separação de palavras vizinhas. Os autores relatam tanto componentes de uma palavra sendo absorvidos por outra quanto sinais distantes sendo excluídos da caixa ao redor de sua própria palavra.
- Espaçamento entre palavras variável. Alguns autores deixam pouquíssimo espaço entre palavras e linhas. Outros escrevem de forma espaçada, com grandes lacunas entre os caracteres dentro da mesma palavra. Uma configuração que una as letras desconectadas de um escritor pode fundir palavras adjacentes de outro.
Além dessa dinâmica própria do sistema de escrita, a captura de documentos introduz ruídos físicos. O estudo inclui imagens feitas por smartphones com interferência de sombras, diferentes tamanhos e resoluções de imagem, tintas coloridas e tipos variados de papel colorido. Essas condições motivam um pipeline que seleciona seus parâmetros de filtragem e limiarização a partir da própria imagem, em vez de aplicar uma configuração fixa a todas as páginas.
Etapa 1: Convertendo o caos da câmera do celular em pixels estáveis
A equipe da KUET estruturou sua solução como um pipeline sequencial de seis etapas, avançando de pixels brutos até regiões delimitadas de palavras sem executar uma etapa separada de segmentação de linhas.
O primeiro passo converte a imagem de entrada para escala de cinza. Os autores explicam que, embora a digitalização direta em preto e branco seja mais rápida, algumas informações dos caracteres podem ser perdidas. A escala de cinza, portanto, serve como ponto de partida para as etapas subsequentes de filtragem e limiarização.
Em seguida, vem a redução adaptativa de ruído. Dispositivos diferentes geram imagens em resoluções diferentes, e autores diferentes escrevem caracteres em escalas distintas. Os autores utilizam uma métrica específica da imagem chamada Average Contour Size (ACS) para determinar os parâmetros de filtragem.
Para calcular o ACS inicial:
- O sistema executa uma etapa inicial de remoção de ruído com um kernel gaussiano de 21 por 21 pixels. O artigo especifica um desvio padrão de 21 na direção vertical e um fator de escala de 7.
- Aplica uma limiarização adaptativa inicial utilizando uma janela de 21 por 21.
- Extrai contornos preliminares, descartando contornos com área inferior a 50 como ruído do tipo sal (salt noise).
- As áreas dos contornos restantes fornecem o ACS utilizado para selecionar os tamanhos de kernel posteriores.
Assim que o sistema obtém o ACS do documento, o artigo descreve a etapa de suavização seguinte como Non-local Means Denoising. O trabalho também fornece uma equação para o kernel de suavização usando as variáveis de coordenadas $x$ e $y$, com $\sigma$ definido como a raiz quadrada do tamanho do kernel. O tamanho do kernel em si é obtido a partir de uma tabela de consulta empírica baseada no ACS.
Em vez de fixar as dimensões do kernel, os autores mapeiam o ACS calculado para diferentes tamanhos:
- Um ACS abaixo de 200 utiliza um kernel de 3 por 3.
- Um ACS de 200 até, mas não incluindo, 300 utiliza um kernel de 5 por 5.
- Os tamanhos listados aumentam em 2 a cada faixa sucessiva de 100 unidades de ACS até 1000, atingindo 19 por 19 para $900 \le \text{ACS} < 1000$.
- As entradas seguintes utilizam 21 por 21 para $1000 \le \text{ACS} < 1200$ e 23 por 23 para $1200 \le \text{ACS} < 1400$.
Para extensões além da tabela, os autores descrevem o aumento do tamanho do kernel em 2 para cada 200 unidades adicionais de ACS.
Os autores também levam em consideração o brilho do fundo da página. Eles relatam menos ruído sal para fundos claros com valores de pixel entre 181 e 255, e mais ruído conforme o fundo se torna mais escuro. Para valores de fundo entre 101 e 180, eles aumentam em 2 o tamanho do kernel selecionado. Para valores abaixo de 100, aumentam em 4.
Essas são escolhas empíricas feitas para o sistema proposto. Elas adaptam a filtragem à escala estimada dos contornos e ao brilho do fundo, em vez de estabelecer uma relação universal entre a cor do papel e a intensidade de suavização necessária.
Etapa 2: O teste de sombra e a binarização adaptativa
Uma vez suavizada, a imagem precisa ser convertida em uma representação binária. O pipeline padroniza essa representação com traços em primeiro plano brancos sobre um fundo preto.
Os autores escolhem entre limiarização global, usando o método de Otsu, e limiarização adaptativa. A preferência é usar Otsu quando um único limiar é suficiente para a imagem, selecionando a limiarização adaptativa para fundos coloridos ou interferência de sombras.
Essa escolha envolve um compromisso (trade-off). O artigo relata que a limiarização adaptativa pode fragmentar caracteres por atuar em janelas locais. Partes de uma palavra podem, assim, ser excluídas do contorno detectado. O método de Otsu é preferido sob condições adequadas porque, segundo os autores, evita essa fragmentação.
O pipeline da KUET realiza uma verificação de interferência de sombra antes de definir o método de binarização:
$$\frac{\text{Area of largest contour}}{\text{Average Contour Size}} > 100$$
O sistema aplica a limiarização de Otsu e mede o maior contorno resultante. Se a área desse contorno exceder 100 vezes o ACS, o pipeline trata a imagem como tendo interferência de sombra. Essa razão é uma heurística de detecção dos autores; o artigo não comprova que todo contorno grande seja necessariamente uma sombra.
Com base nesse teste e na intensidade dos pixels de fundo, a estratégia de binarização se divide:
- Papel colorido ou escuro, com valores de pixel abaixo de 180: Utiliza limiarização adaptativa.
- Papel claro, com valores de pixel iguais ou superiores a 180: Utiliza limiarização adaptativa se for detectada interferência de sombra; caso contrário, utiliza a limiarização de Otsu.
O tamanho da janela de limiarização adaptativa é obtido a partir da tabela de consulta do ACS.
Após a limiarização, os valores dos pixels são invertidos quando necessário, gerando traços brancos uniformes de primeiro plano sobre um fundo preto. A imagem passa então pela detecção de bordas de Canny e por uma transformada de Hough para identificar estruturas colineares usadas na correção de inclinação (skew correction).
Essa etapa de correção de inclinação não divide a página em imagens separadas de linhas de texto. A detecção de palavras continua operando sem uma etapa prévia de segmentação de linhas.
Etapa 3: Dilatação morfológica e o ponto de parada por pico de contornos
Chega-se então ao desafio central: agrupar traços desconectados de caracteres e sinais isolados em entidades de palavras sem unir os espaços entre palavras adjacentes.
Os autores recorrem à morfologia matemática — especificamente à dilatação utilizando um elemento estruturante quadrado com pixels brancos de primeiro plano. A dilatação expande as regiões de primeiro plano. Ela pode unir componentes dentro de uma palavra, mas uma expansão excessiva também pode conectar palavras vizinhas.
Determinar o ponto de parada é o principal desafio técnico. Os autores o abordam por meio de um Limiar Mínimo de Área (Minimum Area Threshold - MAT) combinado com uma busca iterativa baseada na contagem de contornos.
Definindo o que conta como uma palavra
Antes que o sistema possa contar candidatas a palavras, ele precisa de uma regra para retenção de contornos. Regiões conectadas com área maior que o MAT são contabilizadas como candidatas e podem receber caixas delimitadoras (bounding boxes).
Superar o limiar de área não garante que uma região contenha exatamente uma palavra completa. Trata-se da regra de filtragem do pipeline.
O cálculo do MAT depende de qual método de binarização foi selecionado anteriormente:
- Após a limiarização de Otsu: Os autores calculam o MAT diretamente a partir do ACS:
$$\text{MAT} = \frac{\text{Average Contour Size}}{1.25}$$
- Após a limiarização adaptativa: Os autores compensam os contornos fragmentados por meio de uma métrica chamada Writing Density (WD):
$$\text{Writing Density} = \frac{\text{Total area of the page}}{\text{Average Contour Size}}$$
O artigo interpreta um WD maior como uma escrita menos densa. Sua fórmula expressa a área da página em relação à área média dos contornos, em vez de medir diretamente os espaços entre as palavras.
O sistema mapeia o WD para uma fórmula empírica de MAT. A tabela varia de $\text{ACS} - \frac{\text{ACS}}{4}$ quando $\text{WD} < 1500$ até $\text{ACS} \times 6$ quando $\text{WD} \ge 10000$. Faixas intermediárias usam outros múltiplos e ajustes fracionários do ACS.
Uma segunda tabela aplica ajustes adicionais para combinações de WD e ACS. As regras listadas incluem subtrair $\frac{\text{ACS}}{8}$ quando $\text{WD} > 2000$ e $\text{ACS} > 700$, e somar quantias baseadas no ACS em intervalos específicos de alto WD e alto ACS.
Esses mapeamentos são componentes selecionados empiricamente no método. Seu objetivo é equilibrar a retenção de partes de palavras com a rejeição de fragmentos pequenos ou a fusão indevida de regiões maiores.
A busca pelo pico de contornos
Com o MAT definido, o sistema determina o tamanho inicial do kernel de dilatação a partir do ACS. As entradas listadas começam em 1 por 1 para um ACS abaixo de 100 e 3 por 3 para $100 \le \text{ACS} < 1000$. Faixas maiores de ACS recebem kernels iniciais maiores, com algumas diferenças entre os ramos de Otsu e de limiarização adaptativa.
Por exemplo, a tabela atribui um kernel inicial de 9 por 9 após Otsu e um kernel de 11 por 11 após limiarização adaptativa quando $2000 \le \text{ACS} < 2200$. As entradas listadas para limiarização adaptativa chegam a 13 por 13 para $2400 \le \text{ACS} < 2600$; isso não é apresentado como um valor máximo para todas as imagens.
O algoritmo dilata a imagem binária com o kernel inicial por uma iteração e conta os contornos cujas áreas excedem o MAT. Em seguida, testa configurações adicionais, aumentando o número de iterações ou o tamanho do kernel, e reconta os contornos retidos.
A heurística de contagem de contornos apoia-se em dois efeitos:
- Componentes desconectados podem se unir em regiões grandes o suficiente para superar o MAT, aumentando o número de candidatas a palavras retidas.
- Regiões de palavras vizinhas podem se fundir durante uma dilatação adicional, reduzindo a contagem de contornos.
Os autores descrevem a busca pela contagem máxima de contornos, interrompendo o processo antes que uma dilatação adicional faça as palavras colidirem. Trata-se de uma heurística para selecionar uma configuração de dilatação. Ela não garante que todas as palavras estejam completas nem que todos os pares vizinhos permaneçam separados no ponto escolhido.
Em um exemplo documentado na Figura 4 do artigo, uma imagem com ACS de 641 começa com um kernel de dilatação de 3 por 3. Usar esse kernel por 3 iterações produz 33 palavras detectadas na configuração considerada ideal ilustrada. Um kernel de 10 por 10 aplicado por 2 iterações produz apenas 23.
Por fim, caixas delimitadoras retangulares (bounding boxes) são ajustadas em torno dos contornos de palavras retidos na configuração selecionada.
Benchmarks: Testes em três conjuntos de dados distintos
Para avaliar sua abordagem, a equipe da KUET testou o pipeline em três coleções de documentos: um conjunto de dados personalizado criado para o projeto, o CMATERdb1.1.1 e a coleção que o artigo denomina conjunto de dados Bangla Writing.
1. O conjunto de dados personalizado de 80 documentos
Para avaliar condições de captura variadas, os autores criaram um conjunto de dados de 80 documentos abrangendo diferentes estilos de caligrafia, escritos em papéis branco, vermelho, azul, verde e preto. Eles utilizaram canetas em gel, esferográficas e com glitter em diversas cores, incluindo preto, vermelho, verde e azul.
Eles também introduziram interferência de sombras e usaram diferentes dispositivos de captura para que as imagens variassem em tamanho e resolução.
O artigo relata:
- Ground truth words: 7,374
- Bounding boxes generated: 7,278
- Correctly segmented words: 6,681
- Segmentation errors: 527 palavras, classificadas como under-segmented, over-segmented ou defect-segmented
- Undetected words: 166
- Recall: 90.60%
- Precision: 91.80%
- F1-score: 91.20%
Esses resultados demonstram o método na coleção dos autores, que apresenta variações de cor e presença de sombras. Eles não comprovam uma segmentação confiável para todas as combinações possíveis de papel, tinta, caligrafia e iluminação.
2. Benchmark no CMATERdb1.1.1
Os autores executaram o pipeline em 100 documentos do CMATERdb1.1.1, gerando 15,587 bounding boxes em um total de 15,730 palavras:
- Correctly segmented: 13,552 palavras
- Segmentation errors: 2,048 palavras
- Undetected: 130 palavras
- Recall: 86.15%
- Precision: 86.94%
- F1-score: 86.54%
Para efeito de comparação, o artigo relata que Sarkar et al. (2011) obtiveram uma taxa de sucesso na segmentação de palavras de 86.01%: 13,530 palavras segmentadas corretamente de um total de 15,730, com 2,200 palavras classificadas como under-segmented ou over-segmented.
A diferença na entrada é importante. De acordo com o artigo da KUET, Sarkar et al. utilizaram imagens de documentos já segmentadas em linhas de texto, ao passo que o método proposto dispensa essa etapa de pré-processamento.
O recall reportado para o método proposto é ligeiramente superior à taxa de sucesso anterior. No entanto, as diferentes condições de entrada significam que essa não é uma demonstração controlada de vantagem global de desempenho.
3. Conjunto de dados Bangla Writing
O sistema também foi avaliado em 100 documentos do conjunto de dados Bangla Writing:
- Total words present: 7,400
- Bounding boxes generated: 7,191
- Correctly segmented: 6,380 palavras
- Segmentation errors: 987 palavras
- Undetected: 33 palavras
- Recall: 86.22%
- Precision: 88.72%
- F1-score: 87.45%
O artigo relata que Das et al. (2023) trabalharam em uma parcela desse conjunto de dados utilizando perfis de projeção horizontal, seam carving e rastreamento de contornos. Os resultados relatados por eles foram 88.39% de acurácia na segmentação de linhas, 95.65% de acurácia na segmentação de palavras e 84.55% de acurácia média.
A tabela comparativa da KUET coloca essa acurácia média de 84.55% ao lado do recall, da precision e do F1-score do método proposto. Trata-se de medidas distintas, e as avaliações utilizam porções diferentes do conjunto de dados. Portanto, o F1-score de 87.45% não deve ser interpretado como uma melhoria diretamente comparável em relação à acurácia média anterior.
Como o pipeline falha: quatro modos de erro
Como o algoritmo utiliza a geometria da imagem em vez de reconhecer o texto, as falhas relatadas decorrem de casos limites geométricos. Os autores as classificam em quatro tipos de erro.
As denominações a seguir seguem a terminologia do artigo: ele chama a divisão de palavras de under-segmentation e a fusão de palavras de over-segmentation.
- Erro de under-segmentation (divisão de palavras): Uma única palavra é dividida em duas ou mais bounding boxes. Os autores associam isso a conexões de matra ausentes, espaçamentos anormalmente amplos entre caracteres internos e sinais sem matra como '◌ঃ', '◌ং' e '◌ঁ'.
- Erro de over-segmentation (fusão de palavras): Uma única bounding box contém duas ou mais palavras. Caligrafia densa, com espaçamento insuficiente entre palavras ou linhas, aumenta a probabilidade desse erro.
- Erro de defect-segmentation (sinais excluídos): Uma bounding box envolve uma palavra, mas deixa parte dela de fora. O artigo traz exemplos envolvendo sinais vocálicos e outros sinais, incluindo '◌া', 'ি◌', '◌ঁ', '◌ৃ' e '◌ী', especialmente quando escritos afastados do corpo principal da palavra.
- Erro de overlooking (palavras omitidas): Uma palavra é omitida do resultado final. Os autores apontam que palavras com áreas pequenas ficam vulneráveis quando o limiar mínimo de área é aumentado.
Esses erros criam pressões de ajuste conflitantes. Um kernel inicial de dilatação menor ou um MAT mais baixo pode ajudar em páginas escritas densamente, mas os autores relatam que essas escolhas podem aumentar os erros de divisão em caligrafias mais espaçadas. Um kernel de dilatação menor também pode deixar sinais distantes de fora da caixa da palavra.
A pontuação apresenta outra complicação. O artigo relata que sinais como o daari ('।'), que finaliza sentenças em Bangla, e vírgulas podem ser detectados junto a palavras vizinhas. Em certos estilos de caligrafia, por outro lado, eles recebem bounding boxes individuais.
Por fim, o fundo ao redor do papel pode gerar detecções falsas quando seus valores de pixel se assemelham aos dos caracteres. Os autores propõem recortar a imagem para remover esse fundo.
Por que isso é relevante para análise de documentos e sistemas de OCR
O artigo da KUET oferece um exemplo detalhado de segmentação de palavras construído a partir de operações clássicas de processamento de imagens. Sua contribuição reside em um método para gerar regiões de palavras, avaliado por meio de métricas e contagens de segmentação.
Ele não avalia o reconhecimento das palavras dentro dessas regiões. Essa distinção é fundamental ao interpretar os resultados: um recorte segmentado corretamente é uma entrada para fases posteriores de OCR, e não uma evidência de que seu texto tenha sido transcrito com sucesso.
Eliminando a dependência da segmentação de linhas
Um fluxo de trabalho de segmentação pode seguir uma hierarquia como:
$$\text{Page} \longrightarrow \text{Text Lines} \longrightarrow \text{Words} \longrightarrow \text{Characters}$$
Em um fluxo desse tipo, erros na segmentação de linhas podem comprometer a extração subsequente de palavras. A discussão de trabalhos relacionados no artigo identifica dificuldades quando linhas manuscritas se sobrepõem ou quando suas extensões diferem substancialmente.
O método proposto extrai regiões de palavras sem dividir previamente o documento em linhas separadas. Os autores argumentam que isso evita condicionar a extração de palavras ao sucesso de uma etapa de segmentação de linhas.
Isso não elimina erros causados por palavras e linhas excessivamente próximas. Tais condições ainda aparecem na análise de falhas do artigo. O benefício está na remoção dessa dependência de um pré-processamento separado, e não na garantia de que os erros de segmentação fiquem restritos a um único par de palavras.
Processamento clássico, sem benchmark de tempo de execução
O pipeline descrito utiliza conversão para escala de cinza, denoising, limiarização, detecção de bordas de Canny, transformada de Hough e dilatação morfológica. Nenhum modelo de deep learning faz parte do método de segmentação proposto.
Isso torna o artigo útil como um exemplo prático detalhado de uma abordagem clássica. No entanto, o estudo não estabelece uma velocidade específica de execução ou custo de implantação.
O estudo relata resultados de segmentação, mas não fornece benchmarks de tempo de execução, memória, consumo de energia ou execução no próprio dispositivo (on-device). Imagens capturadas por smartphones descrevem a origem das entradas; elas não demonstram que o processamento tenha sido executado em um smartphone.
Afirmações sobre execução em milissegundos, desempenho em celulares básicos, consumo de bateria ou vantagens sobre sistemas neurais extrapolariam, portanto, as evidências relatadas.
Os limites das tabelas de consulta empíricas
O artigo também expõe as exigências de calibração dessa abordagem.
Suas tabelas de mapeamento vinculam ACS e WD a kernels de suavização, limiares de área e kernels iniciais de dilatação. Essas tabelas usam intervalos discretos: um ACS de 299 seleciona um kernel de suavização de 5 por 5, enquanto um ACS de 301 seleciona um kernel de 7 por 7.
Isso significa que uma pequena variação no limite de uma faixa da tabela pode alterar um parâmetro de processamento. O artigo não avalia a sensibilidade nesses limites nem comprova que os mapeamentos se transfiram de forma confiável para qualquer nova condição de captura.
A análise de erros dos autores evidencia por que o ajuste fino é desafiador. Aumentar a dilatação pode unir partes desconectadas de uma palavra e, ao mesmo tempo, fundir palavras adjacentes. Elevar o limiar de área pode excluir palavras menores. Estilos de caligrafia diferentes puxam esses parâmetros em direções opostas.
As melhorias propostas mantêm-se alinhadas a essas falhas observadas. Os autores sugerem o processamento aninhado de bounding boxes que contenham múltiplas palavras e um ajuste mais preciso dos tamanhos dos filtros de limiarização adaptativa e de dilatação. Para palavras praticamente sem espaçamento de separação, eles também propõem um modelo de machine learning treinado com palavras de dicionário.
Essas são direções futuras, e não extensões avaliadas do pipeline apresentado.
Satter, Masrur e Ahsan mostram como um pipeline clássico adaptativo é capaz de segmentar Bangla manuscrito em múltiplos conjuntos de dados, incluindo sua própria coleção de fotografias com papéis coloridos e sombras. Sua busca baseada na contagem de contornos e a detalhada análise de falhas oferecem uma contribuição concreta para a segmentação de palavras — além de um ponto de partida para as etapas posteriores de reconhecimento necessárias para transformar essas caixas em texto editável.