نظرة متعمقة على مسار المعالجة الذي بنته هارفارد لـ 22.6 مليون صورة لاكتشاف الرسوم التي يتجاهلها الـ OCR
استنادًا إلى: Institutional Books - Visual Elements: An open-source pipeline for extracting, classifying, deduplicating, and captioning visual elements from digital book collections — Jimmy Mendez, Matteo Cargnelutti, David Lowry-Duda, Catherine Brobston, Salwa Ismail, Greg Leppert, Amanda Watson, Jonathan Zittrain
في مكان ما داخل المجموعة الرقمية لمكتبة هارفارد، يقبع مجلد واحد—وهو كتالوج مرجعي فني للتماثيل اليونانية والرومانية—أنتج بمفرده 5,260 عملية رصد لصور منفصلة؛ أي عناصر بصرية مميزة تفوق ما تفهرسه معظم المتاحف الصغيرة في عقد من الزمان، وكلها مستخرجة من كتاب واحد فقط. وقد لاحظ الفريق القائم على المشروع أن هذا المجلد يشوه متوسطات البيانات بشدة لدرجة أنهم أطلقوا عليه اسماً مستعاراً: "سبايدرز جورج" (Spiders Georg)، تيمناً بطرفة شهيرة على الإنترنت عن شخص يمتلك 100,000 عنكبوت وتسبب في تخريب متوسط عدد العناكب في قريته. تبدو هذه طرفة طريفة، لكنها في الوقت ذاته نافذة تطل على جوهر الموضوع الحقيقي: ما الذي يتطلبه الأمر لاكتشاف كل رسم توضيحي، ونقش، وصورة فوتوغرافية، وزخرفة جمالية مختبئة داخل 983,004 كتب ممسوحة ضوئياً، وبتكلفة لا تفلس ميزانية المكتبة؟
هذا تحديداً هو المشروع الذي نشره مؤخراً فريق من مبادرة البيانات المؤسسية (Institutional Data Initiative) في مكتبة كلية الحقوق بجامعة هارفارد تحت عنوان: Institutional Books - Visual Elements، ليكون مكملاً لإصدارهم السابق الخاص بالنصوص والبيانات الوصفية (Metadata) للمجموعة ذاتها. يطبق هذا العمل الجديد مسار معالجة مفتوح المصدر على ما يقارب 400 مليون صفحة ممسوحة ضوئياً ناتجة عن شراكة هارفارد مع Google Books، ويستخرج منها 22.6 مليون عنصر بصري؛ خضع كل منها للكشف، والتصنيف، وإزالة التكرار، بالإضافة إلى توليد تسميات توضيحية (Captions) لمجموعة فرعية كبيرة منها. مجموعة البيانات ومسار المعالجة متاحان للعامة على منصتي Hugging Face وGitHub، ويستحقان الاطلاع من جانب أي متخصص يعمل في مجالات الذكاء الاصطناعي للمستندات (Document AI)، أو التعرف الضوئي على الحروف (OCR)، أو الأرشيفات الرقمية.
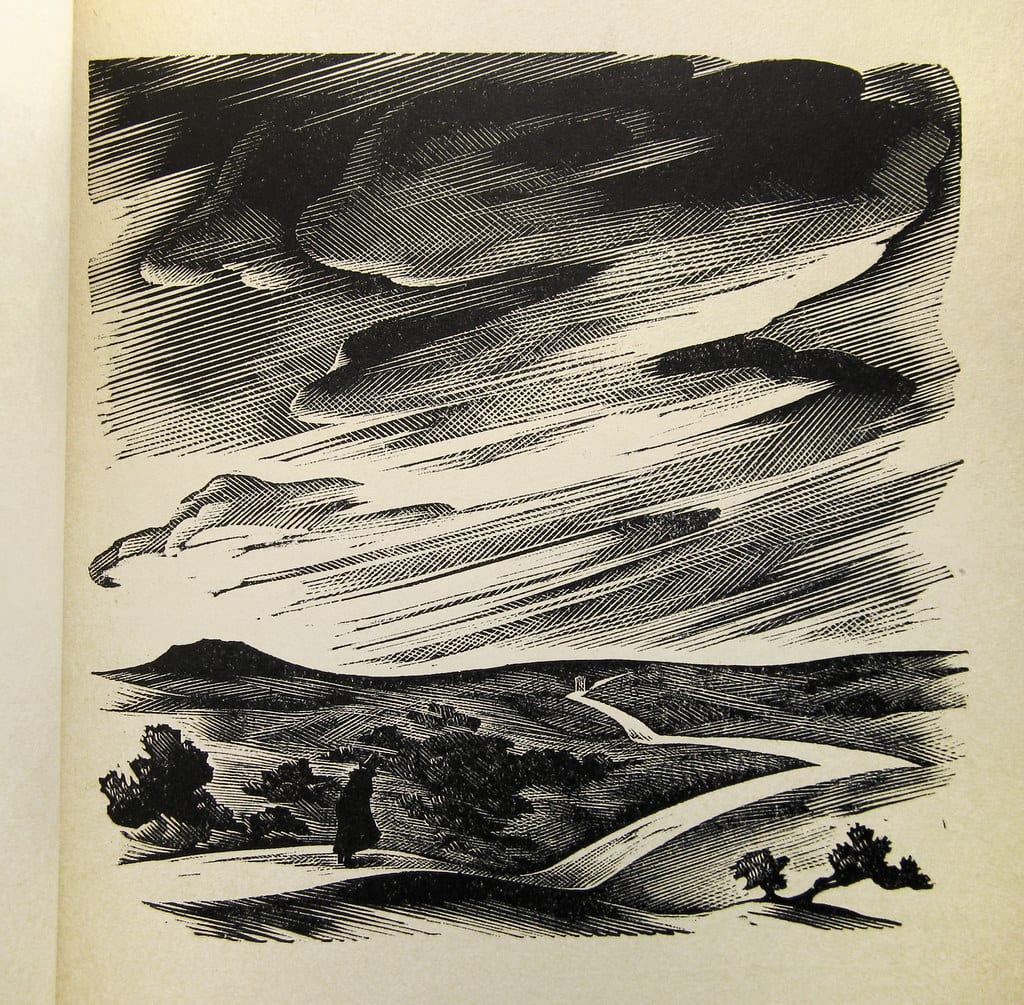
آغنيس ميلر باركر (Agnes Miller Parker) - نقش خشبي لرواية 'The Return of The Native' — تصوير توماس شاهان 3 عبر flickr، ترخيص BY 2.0.
المشكلة التي تتجاهلها تقنيات OCR بصمت
لقد بلغت تقنية التعرف الضوئي على الحروف (OCR) كفاءة عالية للغاية في أداء مهمة محددة: تحويل بكسلات النصوص إلى نصوص قابلة للقراءة آلياً، وتعتمد عليها كل جهود رقمنة الكتب واسعة النطاق. غير أن الصفحة الممسوحة ضوئياً لا تقتصر على النص فحسب؛ فالكتب القديمة تعج بالنقوش الخشبية، والمحفورات، والمطبوعات الحجرية (Lithographs)، واللوحات الملونة يدوياً، والنوتات الموسيقية، والمخططات التوضيحية، بل وحتى الإبهام العابر الذي يظهر بالخطأ أثناء المسح. كل هذه العناصر لا يمسها مسار معالجة النصوص، بل تبقى قابعة في صورة الصفحة دون فهرسة ودون إمكانية للبحث عنها.
وباتت هذه الفجوة تكتسب أهمية اليوم تفوق ما كانت عليه في السابق؛ فالنماذج البصرية اللغوية (Vision-Language Models - VLMs)، وهي أنظمة الذكاء الاصطناعي القادرة على معاينة الصور ووصفها والاستدلال بشأنها، دُرّبت في معظمها على المحتوى البصري المعاصر للإنترنت: الميمز (Memes)، وصور المنتجات، ولقطات الشاشة، والفن الحديث. وتستشهد الورقة بأبحاث حديثة توضح أن هذه النماذج تواجه صعوبة بالغة في التعامل مع الصور التاريخية، وتتراجع كفاءتها في ظل ما يسميه الباحثون "انزياح التوزيع الزمني" (Temporal Distribution Shift)—وهو التباين الناتج عن تغذية نموذج بنقش خشبي من القرن التاسع عشر في حين أنه تدرّب في الغالب على صور فوتوغرافية حديثة—كما أنها معرضة للوقوع في استدلالات تناقض التسلسل الزمني (Anachronistic Reasoning)، مثل وصف محرك بخاري كما لو كان قطاراً حديثاً. وإذا لم يعمل أحد على استخراج هذه المواد البصرية التاريخية وتقديمها بصيغة يمكن للنماذج التعلم منها، فلن تختفي تلك النقطة العمياء من تلقاء نفسها.
وحجم البيانات المعنية هنا ليس بالهين؛ فنحن نتحدث عما يقارب 400 مليون مسح ضوئي لصفحات بحجم إجمالي يصل إلى 60 تيرابايت، أغلبها لا يحتوي على أي رسوم توضيحية على الإطلاق، بينما يحتوي عدد محدود منها—مثل كتالوج التماثيل—على الآلاف. إن غربلة هذا الحجم الهائل دون تفويت العناصر البصرية الحقيقية أو الغرق في الإيجابيات الكاذبة (False Positives) الناتجة عن فقرة ذات تنسيق غريب، تمثل معضلة هندسية معقدة على مستوى الأنظمة حتى قبل أن تصبح مشكلة ذكاء اصطناعي.
نموذج صغير لمجموعة ضخمة
هنا يكمن الخيار الأكثر حسماً وجرأة في التقرير بأكمله. فالنماذج البصرية اللغوية (VLMs) قادرة، من حيث المبدأ، على اكتشاف العناصر البصرية ووصفها في آنٍ واحد في تمريرة واحدة، فلماذا إذن لم يوجه الباحثون نموذجاً منها نحو الـ 400 مليون صفحة ويتركوه ليعمل؟ إجابة المؤلفين كانت: التكلفة، وعدم التوافق بين نقاط قوة نماذج VLMs ومتطلبات هذه المهمة بالذات. فتشغيل نموذج VLM معتمد على المحولات (Transformers) على مجموعة بهذا الحجم سيكون—بحسب تعبيرهم—خارج متناول معظم المكتبات. كما أن المزايا الأساسية لنماذج VLM، مثل التعلم بعدد قليل من الأمثلة (Few-shot learning) والمتانة في التعامل مع المدخلات غير المألوفة، لا تقدم فائدة تُذكر عندما تتبع بياناتك قواعد بصرية وطباعية قوية ومتسقة، وهو بالضبط ما تتسم به صفحات الكتب الممسوحة ضوئياً. ولذلك، دربوا بدلاً من ذلك نموذج كشف صغيراً ومخصصاً للمهمة: نموذج YOLO26n بـ 2.4 مليون معلمة فقط، وهو جزء ضئيل جداً من حجم حتى أصغر النماذج اللغوية المتواضعة.
بدأ الباحثون بـ 109 صفحات مُعلّمة يدوياً، ثم وسعوا مجموعة التدريب لتصل إلى 4,528 صفحة موزعة على 271 مجلداً، وتعمّدوا تضمين صفحات خالية تماماً من أي عناصر بصرية، نظراً لأن معظم صفحات المجموعة عبارة عن نصوص خالصة، وكان على النموذج أن يتعلم كيف يقرر بثقة أنه "لا يوجد شيء هنا". استغرق تدريب النموذج النهائي 1.4 ساعة على أربع وحدات معالجة رسومية (GPUs). وعلى مجموعة اختبار منفصلة (Held-out test set) مؤلفة من 453 صفحة، حقق النموذج دقة (Precision) بلغت 0.95 ومعدل استدعاء (Recall) بلغ 0.96 في المهمة الثنائية: "هل يوجد عنصر بصري هنا أم لا؟". هذا أداء قوي من نموذج صغير حقاً، وخير دليل على فلسفة "الحوسبة المقتصدة" (Frugal Computing) التي أعلنها المؤلفون منذ البداية: ابدأ بأصغر حل ممكن وقابل للتطبيق، ولا تستهلك المزيد من الموارد الحاسوبية إلا عندما يثبت عجز الحل الصغير عملياً.
ولم تكن عنق الزجاجة في مرحلة الإنتاج تكمن في النموذج أصلاً، بل في عمليات إدخال وإخراج القرص (Disk I/O). فعلى مدار 16 يوماً من التشغيل المتواصل لاكتشاف العناصر عبر 394 مليون صفحة ممسوحة ضوئياً، استُهلك 89.5% من وقت المعالجة لكل صفحة في تحميل ملفات الصور وفك تشفيرها من القرص، مقابل أقل من 10% لعمليات الاستدلال (Inference) الخاصة بالشبكة العصبية نفسها، مما جعل أربع وحدات معالجة رسومية مخصصة تعمل بأقل من نصف طاقتها الإنتاجية النظرية. وهذا تذكير مفيد بأنه في مسارات معالجة المستندات الضخمة، نادراً ما يكون النموذج هو المكان الذي يضيع فيه معظم الوقت.
ملاحظة جانبية دالة: أظهرت الخرائط الحرارية (Heatmaps) لانتباه كاشف العناصر أنه يعتمد اعتماداً كبيراً على المساحات البيضاء والفراغات حول هوامش الصفحة لتحديد ما إذا كان هناك شيء غير معتاد، نظراً لأن الكتل النصية تتمتع بتناسق بصري منتظم، في حين أن الرسوم التوضيحية تكسر هذا النمط.
خمس فئات، ومواضع ارتباك النموذج
بمجرد تحديد منطقة ما، يتولى نموذج صغير ثانٍ فرزها إلى واحدة من خمس فئات: صورة/رسم توضيحي (Image/Illustration)، موسيقى (Music)، شوائب مسح (Artifact)، شارات تملك كتب/زخارف (Ex Libris/Decorative)، ومخطط/رسم بياني (Chart/Graph). وتعد فئة "الشوائب" الفئة الجامعة لكل ضوضاء المسح الضوئي: مثل الأيدي التي تظهر أثناء التقليب، ومشابك الصفحات المعدنية، والحواف الممزقة. وكانت الدقة لكل فئة قوية عموماً؛ إذ حقق النموذج دقة 0.98 في فئة الصور/الرسوم، و0.99 في فئة الموسيقى، باستثناء نقطة ضعف واحدة: حيث بلغت الدقة في فئة المخططات/الرسوم البيانية 0.87، وجاءت 12.9% من تنبؤات شارات الكتب/الزخارف بدرجة ثقة منخفضة مما استدعى إعادة تصنيفها.
وقد كانت الورقة صريحة بشأن السبب: فلوحات الكتب (Bookplates)، وعلامات المطابع، والإطارات الزخرفية تتشابه هيكلياً وبصرياً إلى حد كبير مع الرسوم التوضيحية الصغيرة، ويتحتم على النموذج أن يخمن، استناداً إلى سياق محدود، الفئة التي تنتمي إليها زخرفة معينة. ومن الأمثلة على ذلك: ثلاث شارات تملك كتب (Ex Libris) مزخرفة ومأخوذة من مسابقة للمكتبات اكتُشفت بنجاح، لكنها صُنفت خطأً ضمن فئة "صورة/رسم توضيحي" (Image/Illustration)، نظراً لتشابه شارة الكتب والرسم التوضيحي الصغير عند النظر إليهما بمعزل عن السياق.
أما فئة النوتات الموسيقية فحظيت بحل خاص؛ إذ واصل المصنف الخلط بين أي عنصر يحتوي على علامات صغيرة كثيفة أو خطوط تشبه المدرج الموسيقي وبين فئة الموسيقى، لذا أضاف الفريق إشارة ثانوية داعمة: اعتماد التنبؤ مباشرة إذا تجاوزت درجة الثقة 0.99، وإذا كانت أدنى من ذلك، فلا يُعتمد تصنيف "موسيقى" إلا إذا تضمنت التسمية التوضيحية المولدة بالذكاء الاصطناعي للقطعة المقتطعة كلمة مفتاحية صريحة مرتبطة بالموسيقى. وقد أدت هذه القاعدة إلى إعادة تصنيف 12,502 تنبؤ من أصل ما يقارب 1.2 مليون تنبؤ في فئة الموسيقى وتخفيضها إلى فئة "أخرى" (Other). هذا تفصيل تشغيلي صغير، لكنه جوهري: فأحياناً لا يكمن علاج خطأ تصنيفي مستعصٍ في استخدام نموذج أفضل، بل في إضافة إشارة ثانية وأقل تكلفة تلتقط ما فات الإشارة الأولى.
العثور على الباركود نفسه 418,436 مرة
ينتج عن رقمنة مليون كتاب قدر هائل من التكرارات: الرسم التوضيحي نفسه يُعاد استخدامه عبر طبعات متعددة، وحواف زخرفية يطبعها الناشر عند ترويسة كل فصل، إضافة إلى أمر أقل بريقاً، وهو ملصقات الباركود الفعلية التي وضعتها مكتبة وايدنر (Widener Library) التابعة لهارفارد على حوامل أجهزة المسح الضوئي، والتي رصدها كاشف الصور بأمانة فائقة كعناصر بصرية في كل مرة ظهرت فيها داخل الكادر.
يتعامل مسار المعالجة مع هذه المشكلة عبر مرحلتين: أولاً، الترميز التجزئي الإدراكي (Perceptual Hashing) غير المكلف للصور شبه المتطابقة، وهي التكرارات المتطابقة بكسلاً ببكسل والناتجة عن مسح الصفحة مرتين عن طريق الخطأ؛ ثم ثانياً، التضمينات الكثيفة (Dense Embeddings) عبر نموذج SSCD، وهو نموذج صُمم خصيصاً لاكتشاف النسخ المكررة، لمعالجة المحتوى المتشابه بصرياً دون أن يكون متطابقاً تماماً، كالرسم نفسه حين يُعاد طبعه بدقة وضوح مختلفة. اختبر الباحثون نموذج SSCD في مواجهة أربعة نماذج تضمين متعددة الوسائط عامة الأغراض، من بينها CLIP وSigLIP 2، وتفوق SSCD بوضوح: محققاً دقة بلغت 0.93 واستدعاءً بلغ 0.82 في معيار التقييم الخاص بهم، متقدماً بفارق كبير على أقرب بديل متعدد الأغراض. وتجدر الإشارة هنا إلى تفوق نموذج متخصص ومحدود النطاق على نماذج أكبر حظيت بضجة أوسع.
عند تطبيقه منفرداً، قلص التجزئة الإدراكية (Hashing) إجمالي الـ 43.7 مليون قطعة مقتطعة ومكتشفة بنسبة 22%؛ بينما كان تشابه التضمينات (Embedding similarity) أكثر جرأة واختزلها بنسبة 31%. واختار الفريق المسار الأكثر تحفظاً للإصدار النهائي: عدم دمج أي قطعتين مقتطعتين في مجموعة مكررة إلا إذا اتفقت الطريقتان معاً، وهو ما خفّض الإجمالي بنسبة 19.6%، ليستقر العدد عند 22,622,060 عنصراً بصرياً فريداً. وكانت أكبر مجموعتين متطابقتين عُثر عليهما هما: 824,599 نسخة شبه متطابقة من الزخرفة الإطارية نفسها، و418,436 حالة لملصق باركود مكتبة وايدنر ذاته. في مكان ما داخل غرفة المسح، وضع أحدهم باركود على مئات الآلاف من حوامل الكتب، فقام مسار مخصص لاستخراج الرسوم التاريخية برصد كل واحد منها بأمانة مطلقة.
الجزء التجريبي: إسناد كتابة التسميات التوضيحية إلى نموذج لغوي كبير
يمثل توليد التسميات التوضيحية (Captioning) الجزء الأكثر إثارة للاهتمام، والأكثر إحاطة بالتحفظات، في مسار المعالجة بأكمله. فبالنسبة لـ 18.5 مليون عنصر من أصل 22.6 مليون عنصر—بعد استبعاد شارات الكتب/الزخارف والشوائب نظراً لأن شارة الكتاب أو مشبك المسح لا يحتاجان إلى وصف—استخدم الفريق نموذج GPT-4.1-nano من OpenAI، حيث زُوّد بالصورة المقتطعة والنص المستخرج بالـ OCR من الصفحة المحيطة بها كسياق، وطُلب منه تقديم وصف في حدود 50 كلمة أو أقل، وبلغة الكتاب الأصلية.
حجم العمليات هنا يستحق التوقف عنده والتأمل فيه: 34.263 مليون طلب عبر واجهة برمجة التطبيقات (API)، و66.994 مليار توكن مدخل (Input tokens)، بتكلفة إجمالية بلغت 4,441.42 دولاراً فقط بفضل تقنية التخزين المؤقت للمطالبات (Prompt caching). إنها وسيلة زهيدة التكلفة بشكل لافت لتوليد ما يقارب 767 مليون توكن من البيانات الوصفية، وهي تحديداً نوعية الأرقام التي ينبغي أن تدفع أي شخص إلى التريث قبل قبول المخرجات على علاتها وتصديق دقتها بمجرد النظر.
ويُحسب للمؤلفين أنهم لم يبالغوا في ترويج هذا الجزء؛ بل وصفوا هذا المكون بصراحة بأنه "تجريبي"، تمييزاً له عن مراحل الكشف والتصنيف وإزالة التكرار، وهي تقنيات راسخة استطاعوا قياس أدائها بدقة ومقارنتها بالحقيقة الأرضية (Ground truth). فتوليد التوصيفات للصور التاريخية باستخدام النماذج اللغوية الكبيرة يظل مسألة بحثية مفتوحة؛ فالنماذج البصرية اللغوية عامة الأغراض تفتقر على الأرجح إلى المعرفة المتخصصة بتقنيات الطباعة في العصور التاريخية المختلفة، كما أن الهلوسة (Hallucination)—أي تقديم وصف يبدو معقولاً ومنطقياً في ظاهره ولكنه خاطئ تماماً—تمثل خطراً حقيقياً لم يتمكنوا من استبعاده. وقد كشفت الاختبارات الأولية أن النموذج كان أحياناً يلخص النص المحيط بالصفحة بدلاً من وصف الصورة نفسها، وهي مشكلة قاموا بتصفيتها في المراحل اللاحقة إلى حد كبير، ولكن دون ثقة مطلقة.
كما حاول الباحثون تشغيل نماذج سلامة المحتوى (Content-safety models) على التسميات التوضيحية الناتجة لرصد أي محتوى ضار، غير أن النتائج لم تكن موثوقة بما يكفي للاعتماد عليها؛ فما يُعد مسيئاً أو صياغة غير دقيقة يختلف باختلاف عصر الوثيقة وسياقها التاريخي بطرق تعجز المرشحات العامة عن استيعابها. لذا، طُرحت التسميات التوضيحية "كما هي"، كطبقة تجريبية تستند إلى أساس متين، لا كحقيقة أرضية موثقة.
لماذا يهم هذا كل من يطور أو يختار أنظمة OCR
إذا كنت بصدد تقييم أدوات OCR أو الذكاء الاصطناعي للمستندات لمشروع عملي حقيقي، فهناك ثلاثة دروس مستفادة هنا تظل قيّمة ومفيدة، بغض النظر عما إذا كنت ستتعامل يوماً ما مع مجموعة كتب تاريخية أم لا.
استخراج النصوص واستخراج العناصر البصرية مشكلتان منفصلتان، وتختلف فيهما أنماط الخطأ. إذا كان مسار العمل لديك يقتصر على الـ OCR، فأنت تفترض ضمنياً أن كل ما هو غير نصي في الوثيقة غير موجود أصلاً. قد يكون هذا مقبولاً في العقود والمستندات القانونية حيث لا تتعدى الرسوم دوراً ثانوياً، لكنه يمثل فجوة حقيقية في الأرشيفات الممسوحة ضوئياً: مثل استمارة تحمل توقيعاً، أو دفتر مختبر يحتوي على رسم يدوي، أو سجل قديم مرفق به صورة فوتوغرافية. وتتضاعف هذه التحديات في حالة المخطوطات والوثائق العربية، حيث تجعل الطبيعة المتصلة للخط العربي، واتجاهه من اليمين إلى اليسار، وأشكاله المتغيرة سياقياً، فضلاً عن التشكيل والتراكيب الخطية، من التعرف الضوئي مهمة أشد تعقيداً تزيد من صعوبة الفصل بين النص والزخارف البصرية المحيطة به. يجدر بك أن تسأل أي مزود لخدمات الـ OCR مباشرة عما يحدث لأجزاء الصفحة غير النصية.
نموذج صغير ومخصص للمهمة تفوق بوضوح على غريزة "توجيه نموذج VLM وحسب للمشكلة"، تفوقاً حاسماً من حيث التكلفة والدقة. يتكرر هذا النمط مراراً وتكراراً في بيئات الإنتاج للذكاء الاصطناعي للمستندات؛ فإذا كانت مستنداتك تتمتع بهيكل متسق—كنموذج إيصال، أو تخطيط استمارة، أو نوع مستند يرفعه المستخدمون بانتظام—فإن نموذجاً صغيراً ومضبوطاً بدقة (Fine-tuned) سيتفوق غالباً على النماذج متعددة الأغراض بجزء ضئيل جداً من تكلفة الاستدلال. وفر النموذج الباهظ للحالات الغامضة، وهو تحديداً النهج الهجين الذي أشار إليه المؤلفون كمسار واعد: كاشف منخفض التكلفة للـ 95% من الحالات السهلة، ونموذج VLM فقط للحالات الحدية الملتبسة.
أي مرحلة في مسار المعالجة تضيف بيانات وصفية مولدة بنماذج LLM تحتاج إلى إشارة ثقة خاصة بها، ولا ينبغي أن ترث مستوى الثقة للمراحل الحتمية (Deterministic) التي سبقتها. لقد تتبع الباحثون الاحتمالات اللوغاريتمية على مستوى التوكن (Token-level log probabilities) لكل تسمية توضيحية، وميزوا مخرجات التسميات التوضيحية بأكملها بأنها "تجريبية" في مخطط مجموعة البيانات، لتكون منفصلة بوضوح عن الحقول المستمدة مباشرة من بيانات المكتبة الأصلية. وهذه ممارسة ممتازة لكل من يقدم بيانات وصفية للمستندات مولدة بالذكاء الاصطناعي: لا تسمح لمرحلة معرضة للهلوسة بأن ترث بهدوء موثوقية المراحل المستقرة المحيطة بها.
ما لا يمكن لمجموعة البيانات أن تخبرك به
القسم الأكثر صراحة ونزاهة في الورقة لا يتعلق بالنماذج، بل بالفئات التي حظيت بالتمثيل في البيانات في نهاية المطاف. فنظراً لأن طباعة الكتب المصورة شهدت طفرة هائلة بفضل تقنيات القرن التاسع عشر مثل النقش على الخشب والطباعة الحجرية، فإن مجموعة البيانات البصرية تنحاز بشدة نحو القرنين التاسع عشر والعشرين (64% و33% من المجلدات الغنية بالرسوم على التوالي) وتبتعد عن الأعمال الأقدم المقتصرة على النصوص. كما تحظى الكتب باللغة الإنجليزية بتمثيل مفرط مقارنة بحصتها في المجموعة النصية الأساسية، نظراً لأن المجلدات الإنجليزية هنا تميل إلى أن تكون أكثر كثافة بالصور. وحظيت الفنون الجميلة والعلوم بتمثيل جارف؛ بينما أسهمت كتب القانون، على الرغم من أنها تشكل 13% من مجموعة النصوص الأصلية، بنسبة 4.2% فقط من المجلدات التي اكتُشفت فيها عناصر بصرية، إذ كانت النصوص القانونية في ذلك العصر نثرية بالكامل تقريباً.
لا يُعد أي من هذا عيباً بالمعنى الحرفي، بل هو قياس نزيه لتحيز هيكلي حقيقي وواقعي لما كان يُرسم ويوثق بصرياً في المقام الأول، ويُصَفّى لاحقاً بناءً على اللغات والتخطيطات التي يجيد نموذج الكشف التعامل معها. غير أنه يمثل تحذيراً صريحاً لكل من يخطط لتدريب نموذج على هذه البيانات: ستكون بصدد تدريب نموذجك على سجل بصري ينحاز بصورة غير متكافئة إلى اللغة الإنجليزية، وإلى العصور الحديثة، ومستمد من مجالات تصادف أنها اعتمدت تاريخياً على الصور. كما يلفت المؤلفون الانتباه إلى محاذير اعتيادية أخرى: فتحديد حقوق الملكية الفكرية، المستند إلى حالة الملكية العامة في HathiTrust، "معرض للخطأ في بعض الأحيان"، كما تترك المجلدات المكررة احتمالية متبقية لوصول الصورة نفسها إلى مجموعتي التدريب والاختبار في المراحل اللاحقة.
إنه تقرير تقني يتسم بشفافية استثنائية لهذا السبب تحديداً. فمعظم مجموعات البيانات التي تُنشر تستعرض الأرقام المبهرة وتدفن التحيزات في ملاحق لا يقرؤها أحد؛ أما هذا التقرير فيضعها في قسم مخصص ومستقل، مع النسب المئوية الفعلية، ويشرح بوضوح ما لا ينبغي استخلاصه من استنتاجات. وهذه النزاهة في الإقرار بحدود مجموعة البيانات جديرة بأن تبقى في الذاكرة طويلاً، حتى بعد أن يتلاشى أثر طرفة "سبايدرز جورج" وتكف عن كونها التفصيلة الأكثر رسوخاً في الأذهان في هذا التقرير.