Por dentro do pipeline de 22,6 milhões de imagens criado por Harvard para encontrar as ilustrações que o OCR ignora
Baseado em: Institutional Books - Visual Elements: An open-source pipeline for extracting, classifying, deduplicating, and captioning visual elements from digital book collections — Jimmy Mendez, Matteo Cargnelutti, David Lowry-Duda, Catherine Brobston, Salwa Ismail, Greg Leppert, Amanda Watson, Jonathan Zittrain
Em algum lugar da coleção digitalizada da Harvard Library repousa um único volume — um catálogo de referência artística de estatuária grega e romana — que gerou, sozinho, 5.260 detecções de imagens distintas: mais elementos visuais do que a maioria dos pequenos museus cataloga em uma década, tudo extraído de um único livro. A equipe responsável pelo projeto percebeu que ele distorcia tanto as médias que lhe deu um apelido: "Spiders Georg", em referência à velha piada da internet sobre um sujeito com 100.000 aranhas que arruína a média de contagem de aranhas da sua aldeia. É um detalhe divertido, mas também uma prévia do verdadeiro tema em questão: o que é necessário para encontrar cada ilustração, gravura, fotografia e floreio decorativo escondido em 983.004 livros digitalizados, a um custo que não leve uma biblioteca à falência.
Esse é o projeto que uma equipe da Institutional Data Initiative da Harvard Law School Library acaba de publicar: Institutional Books - Visual Elements, um complemento ao lançamento anterior de texto e metadados da mesma coleção. O novo trabalho executa um pipeline de código aberto sobre cerca de 400 milhões de páginas digitalizadas da parceria de Harvard com o Google Books e extrai 22,6 milhões de elementos visuais, cada um detectado, classificado, deduplicado e, para um grande subconjunto, legendado. O dataset e o pipeline estão públicos no Hugging Face e no GitHub, valendo a pena conferir para qualquer pessoa que trabalhe com document AI, OCR ou arquivos digitais.
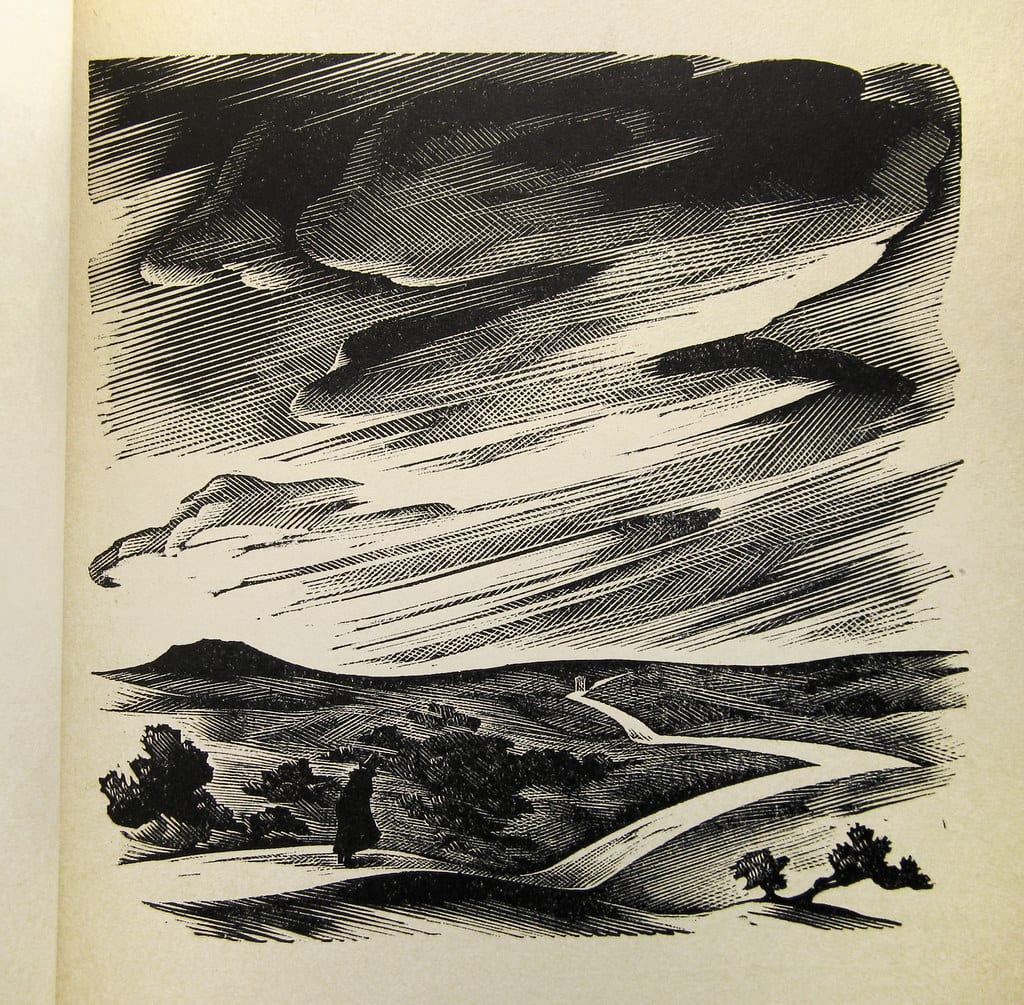
Agnes Miller Parker - Gravura em madeira para 'The Return of The Native' — por Thomas Shahan 3 via flickr, BY 2.0.
O problema que o OCR silenciosamente ignora
O reconhecimento óptico de caracteres tornou-se muito bom em uma tarefa específica: transformar pixels de texto em texto legível por máquina. Todo esforço de digitalização de livros em larga escala depende dele. Mas uma página digitalizada não é apenas texto. Livros mais antigos estão repletos de xilogravuras, gravuras, litografias, estampas coloridas à mão, partituras, diagramas e o ocasional polegar intruso capturado durante a digitalização. Nada disso é tocado por um pipeline de texto. Fica simplesmente ali, na imagem da página, sem indexação e sem possibilidade de busca.
Essa lacuna importa mais hoje do que no passado. Os vision-language models (VLMs), sistemas de IA capazes de analisar uma imagem e descrevê-la ou raciocinar sobre ela, são treinados principalmente com a dieta visual contemporânea da internet: memes, fotos de produtos, capturas de tela, arte moderna. O artigo cita trabalhos recentes que mostram que esses modelos têm dificuldades com imagens históricas, degradam-se sob o que os pesquisadores chamam de "temporal distribution shift" (o descompasso ao fornecer a um modelo uma xilogravura do século XIX quando ele aprendeu quase tudo com fotos modernas) e são propensos a raciocínios anacrônicos, como descrever uma máquina a vapor como se fosse um trem moderno. Se ninguém trouxer à tona o material visual histórico em um formato a partir do qual os modelos possam aprender, esse ponto cego não se fechará sozinho.
A escala envolvida também não é modesta: cerca de 400 milhões de páginas digitalizadas totalizando 60 terabytes, a maioria sem nenhuma ilustração, e um punhado delas, como o catálogo de estatuária, contendo milhares. Peneirar tudo isso sem perder elementos visuais reais nem se afogar em falsos positivos decorrentes de parágrafos com formatação incomum é um problema difícil de engenharia de sistemas antes mesmo de ser um problema de IA.
Modelo pequeno, grande coleção
Eis a escolha de projeto mais contundente de todo o relatório. Em princípio, vision-language models podem tanto encontrar quanto descrever elementos visuais em uma única passagem; então por que não apontar um deles para 400 milhões de páginas e deixá-lo trabalhar? A resposta dos autores: o custo e a incompatibilidade entre aquilo em que os VLMs se destacam e o que essa tarefa exige. Executar um VLM baseado em transformers em uma coleção desse porte estaria, nas palavras dos autores, fora do alcance da maioria das bibliotecas. Além disso, as principais vantagens de um VLM — few-shot learning e robustez a entradas incomuns — não trazem grande benefício quando os dados possuem convenções visuais e tipográficas fortes e consistentes, como é o caso de páginas de livros digitalizados. Em vez disso, eles treinaram um detector pequeno e feito sob medida: um modelo YOLO26n com 2,4 milhões de parâmetros, uma fração do tamanho de até mesmo um modelo de linguagem modesto.
Eles começaram com 109 páginas anotadas manualmente, expandiram o conjunto de treino para 4.528 páginas distribuídas por 271 volumes e incluíram deliberadamente páginas sem nenhum elemento visual, já que a maioria das páginas da coleção é puro texto e o modelo precisava aprender a dizer "nada aqui" com segurança. O treinamento do modelo final levou 1,4 hora em quatro GPUs. Em um conjunto de teste retido (held-out) de 453 páginas, ele atingiu 0,95 de precisão e 0,96 de recall na tarefa binária de "existe um elemento visual aqui ou não". Um desempenho expressivo para um modelo genuinamente minúsculo, e a prova mais clara da filosofia de "frugal computing" declarada pelos autores logo de início: comece com a menor intervenção viável e gaste mais capacidade computacional apenas quando a solução enxuta comprovadamente falhar.
O gargalo em produção nem sequer foi o modelo: foi o I/O de disco. Ao longo dos 16 dias de execução da detecção sobre 394 milhões de páginas digitalizadas, 89,5% do tempo de processamento por página foi gasto no carregamento e decodificação dos arquivos de imagem a partir do disco, contra menos de 10% na inferência da rede neural em si — deixando quatro GPUs dedicadas ociosas a menos da metade de sua capacidade teórica. Um lembrete útil de que, em grandes pipelines de documentos, o modelo muitas vezes não é onde seu tempo é consumido.
Uma observação reveladora: os mapas de calor da atenção do detector mostraram que ele depende fortemente dos espaços em branco ao redor das margens da página para decidir se há algo fora do comum, uma vez que blocos de texto são visualmente uniformes e as ilustrações quebram esse padrão.
Cinco categorias e onde o modelo se confunde
Uma vez delimitada uma região, um segundo modelo pequeno a classifica em uma de cinco categorias: Image/Illustration, Music, Artifact, Ex Libris/Decorative e Chart/Graph. "Artifact" funciona como categoria geral para ruídos de digitalização: mãos capturadas acidentalmente, clipes metálicos para prender páginas, cantos rasgados. A acurácia por classe é consistente em geral — 0,98 de precisão em Image/Illustration, 0,99 em Music —, com exceção de um ponto vulnerável: Chart/Graph fica em 0,87, e 12,9% das predições de Ex Libris/Decorative retornaram com baixa confiança e foram reclassificadas.
O artigo é sincero quanto ao motivo: ex-líbris, marcas de tipógrafo e bordas decorativas costumam ser, estruturalmente, muito parecidos com pequenas ilustrações, e o modelo precisa deduzir, a partir de um contexto limitado, a qual classe determinado ornamento pertence. Um exemplo: três ex-líbris ornamentados de um concurso de biblioteca foram detectados corretamente, mas acabaram classificados como "Image/Illustration", já que, isoladamente, um ex-líbris e uma pequena ilustração são bastante semelhantes.
A categoria Music recebeu um ajuste próprio. O classificador vivia confundindo qualquer elemento com marcas densas e pequenas ou linhas parecidas com pautas musicais com a classe Music. Por isso, a equipe adicionou um segundo sinal: confiar cegamente em valores de confiança acima de 0,99 e, abaixo disso, manter o rótulo Music apenas se a legenda do recorte gerada por IA contivesse uma palavra-chave explicitamente relacionada a música. Essa regra reclassificou 12.502 de cerca de 1,2 milhão de predições de Music para "Other". Um detalhe operacional modesto, porém concreto: às vezes, o remédio para um erro persistente de classificação não é um modelo melhor, mas um segundo sinal mais barato que captura o que o primeiro deixou passar.
Encontrando o mesmo código de barras 418.436 vezes
Digitalizar um milhão de livros gera uma quantidade enorme de duplicatas: a mesma ilustração reutilizada em diferentes tiragens, bordas decorativas que a editora carimbava no cabeçalho de cada capítulo e, de forma menos glamorosa, as etiquetas físicas com códigos de barras que a própria Widener Library de Harvard colou nos suportes de digitalização — as quais o detector pontualmente sinalizava como elementos visuais sempre que apareciam no enquadramento.
O pipeline lida com isso em dois estágios: hashing perceptivo de baixo custo para imagens quase idênticas — o tipo de duplicata pixel a pixel resultante de uma página digitalizada duas vezes por engano —, seguido por embeddings densos via SSCD, um modelo projetado especificamente para detecção de cópias, para conteúdos visualmente semelhantes, mas não idênticos, como a mesma ilustração reimpressa em resolução diferente. Os autores testaram o SSCD contra quatro modelos multimodais de embedding de uso geral, incluindo CLIP e SigLIP 2, e o SSCD venceu com folga: 0,93 de precisão e 0,82 de recall no benchmark avaliado, bem à frente da alternativa generalista mais próxima. Vale notar: um modelo especializado superando um concorrente maior e mais badalado.
Aplicado isoladamente, o hashing reduziu os 43,7 milhões de recortes brutos detectados em 22%; a similaridade por embeddings foi mais agressiva, reduzindo-os em 31%. Para a versão final, a equipe escolheu a abordagem conservadora: mesclar dois recortes em um grupo de duplicatas somente se ambos os métodos concordarem, o que reduziu o total em 19,6%, estabelecendo a contagem em 22.622.060 elementos visuais únicos. Os dois maiores clusters de duplicatas identificados foram 824.599 cópias quase idênticas do mesmo ornamento de borda decorativa e 418.436 instâncias daquela etiqueta de código de barras da Widener Library. Em alguma sala de digitalização, alguém colou um código de barras em centenas de milhares de suportes, e um pipeline construído para encontrar ilustrações históricas fez questão de notar cada uma delas.
A parte experimental: deixar um LLM escrever as legendas
A etapa mais interessante — e cercada de mais ressalvas — de todo o pipeline é a geração de legendas. Para 18,5 milhões dos 22,6 milhões de elementos (ignorando recortes de Ex Libris/Decorative e Artifact, já que um ex-líbris ou um clipe de digitalização não precisam de descrição), a equipe usou o GPT-4.1-nano da OpenAI, fornecendo como contexto tanto a imagem recortada quanto o texto de OCR da página ao redor, e solicitou uma legenda de até 50 palavras no idioma original do livro.
A escala impressiona: 34,263 milhões de requisições de API, 66,994 bilhões de tokens de entrada, a um custo total de US$ 4.441,42 graças ao prompt caching. Uma forma surpreendentemente barata de gerar quase 767 milhões de tokens de metadados descritivos — e exatamente o tipo de número que deveria fazer qualquer um hesitar antes de aceitar os resultados sem ressalvas.
Para seu crédito, os autores não vendem gato por lebre. Eles classificam esse componente explicitamente como "experimental", distinguindo-o das etapas de detecção, classificação e deduplicação, que são técnicas bem estabelecidas e passíveis de medição clara contra um ground truth. Legendar imagens históricas com um LLM é um problema de pesquisa em aberto: VLMs de uso geral provavelmente carecem de conhecimento especializado sobre técnicas de impressão de épocas específicas, e a alucinação — descrever algo com tom plausível, mas incorreto — é um risco real que eles não puderam descartar. Testes preliminares constataram que o modelo às vezes resumia o texto da página ao redor em vez de descrever a imagem em si, o que foi amplamente filtrado nas etapas posteriores, mas sem total certeza.
Eles também tentaram rodar modelos de moderação de conteúdo (content-safety) sobre as legendas geradas para interceptar qualquer coisa nociva, mas os resultados não foram confiáveis o suficiente: o que conta como enquadramento ofensivo ou impreciso muda conforme a época e o contexto do documento de maneiras que um filtro genérico não é capaz de captar. Portanto, as legendas foram disponibilizadas "no estado em que se encontram" (as is): uma camada experimental construída sobre uma base sólida, e não como um ground truth verificado.
Por que isso importa para quem constrói ou escolhe soluções de OCR
Se você está avaliando ferramentas de OCR ou de IA para documentos em um projeto real, três pontos aqui são úteis, independentemente de você algum dia vir a lidar com um acervo de livros históricos.
A extração de texto e a extração visual são problemas distintos, com modos de falha diferentes. Se o seu pipeline realiza apenas OCR, você está decidindo implicitamente que tudo o que não é texto em um documento simplesmente não existe. Isso não é um problema para contratos e petições judiciais, onde diagramas são coadjuvantes. Mas é uma lacuna grave para um arquivo digitalizado: um formulário com assinatura, um caderno de laboratório com uma figura desenhada à mão, um registro antigo com uma fotografia anexada. Vale a pena perguntar diretamente a qualquer fornecedor de OCR o que acontece com as partes da página que não são texto.
Um modelo pequeno e específico para a tarefa superou de forma decisiva o instinto de "simplesmente jogar um VLM em cima", tanto em custo quanto em acurácia. Esse padrão se repete com frequência em document AI em produção. Se os seus documentos têm estrutura consistente — o modelo de um recibo, o layout de um formulário, um tipo de documento que os usuários enviam repetidamente —, um modelo pequeno com fine-tuning costuma superar um modelo de uso geral por uma fração do custo de inferência. Guarde o modelo caro para os casos ambíguos, exatamente a abordagem híbrida que os autores apontam como um caminho promissor: detector barato para os 95% mais fáceis, VLM apenas para as decisões limítrofes.
Qualquer estágio do pipeline que adicione metadados gerados por LLM precisa de seu próprio sinal de confiança, e não do nível de confiabilidade dos estágios determinísticos anteriores. Os autores rastrearam probabilidades logarítmicas por token (log probabilities) para cada legenda e rotularam toda a saída de legendagem como experimental no schema do dataset, distinguindo-a dos campos originados diretamente dos metadados da biblioteca. Uma boa prática para quem distribui metadados de documentos gerados por IA: não deixe uma etapa propensa a alucinações herdar silenciosamente a credibilidade das etapas ao redor.
O que o dataset não pode dizer a você
A seção mais honesta do artigo não trata dos modelos, mas de quem acabou representado no conjunto de dados. Como a impressão ilustrada explodiu com as tecnologias do século XIX, como a xilogravura e a litografia, o dataset visual pende fortemente para os anos 1800 e 1900 (64% e 33% dos volumes densamente ilustrados, respectivamente) e se afasta de obras mais antigas compostas apenas por texto. Livros em língua inglesa estão sobrerrepresentados em relação à sua participação no corpus de texto original, uma vez que os volumes em inglês nessa coleção costumam ter maior densidade de imagens. Belas Artes e Ciências estão altamente sobrerrepresentadas; o Direito, apesar de representar 13% da coleção textual de base, contribui com apenas 4,2% dos volumes com elementos visuais detectados, visto que os textos jurídicos daquela época eram quase exclusivamente em prosa.
Nada disso é exatamente um defeito. Trata-se de uma medição honesta de um viés estrutural real sobre o que era ilustrado na época, filtrado adicionalmente por quais idiomas e layouts o modelo de detecção processa com eficácia. Mas serve como sinal de alerta para qualquer um que pretenda treinar um modelo com esses dados: o treinamento usará um registro visual desproporcionalmente em inglês, recente e extraído de áreas que calharam de depender mais de figuras. Os autores também destacam ressalvas cotidianas: determinações de direitos autorais, baseadas no status de domínio público do HathiTrust, estão "ocasionalmente sujeitas a erros", e volumes duplicados deixam um risco residual de a mesma imagem cair tanto no split de treino quanto no split de teste em etapas posteriores.
É um relatório técnico extraordinariamente transparente exatamente por esse motivo. A maioria dos datasets publicados exibe números impressionantes e esconde as distorções em um apêndice que ninguém lê. Este aqui as expõe em uma seção dedicada, com as porcentagens reais, e afirma com clareza quais conclusões não se devem tirar. Esse tipo de honestidade quanto aos próprios limites de um dataset merece ser lembrado muito depois que "Spiders Georg" deixar de ser o detalhe mais memorável do relatório.