OCR जिन तस्वीरों को नज़रअंदाज़ कर देता है, उन्हें खोजने के लिए Harvard द्वारा बनाई गई 22.6-मिलियन-इमेज पाइपलाइन की आंतरिक पड़ताल
आधारित शोध-पत्र: Institutional Books - Visual Elements: An open-source pipeline for extracting, classifying, deduplicating, and captioning visual elements from digital book collections — Jimmy Mendez, Matteo Cargnelutti, David Lowry-Duda, Catherine Brobston, Salwa Ismail, Greg Leppert, Amanda Watson, Jonathan Zittrain
Harvard Library के डिजिटाइज़्ड संग्रह में एक अकेली किताब मौजूद है—ग्रीक और रोमन मूर्तिकला (Greek and Roman statuary) का एक आर्ट-रेफरेंस कैटलॉग—जिसने अकेले ही 5,260 अलग-अलग इमेज डिटेक्शन उत्पन्न किए। यह किसी भी छोटे संग्रहालय द्वारा एक दशक में कैटलॉग किए जाने वाले विज़ुअल एलिमेंट्स से कहीं अधिक है, जो सिर्फ एक ही किताब से निकलकर सामने आए। इस प्रोजेक्ट के पीछे की टीम ने जब देखा कि यह किताब उनके औसत को बुरी तरह बिगाड़ रही है, तो उन्होंने इसे एक उपनाम दे दिया: "Spiders Georg"—उस पुराने इंटरनेट जोक के नाम पर, जिसमें 100,000 मकड़ियों वाला एक व्यक्ति अपने गाँव में मकड़ियों की औसत संख्या के आँकड़ों को बिगाड़ देता है। यह एक मज़ेदार किस्सा है, और साथ ही इस बात की एक झलक भी कि 983,004 स्कैन की गई किताबों के भीतर छिपे हर चित्र (illustration), नक्काशी (engraving), तस्वीर और सजावटी आकृतियों (decorative flourishes) को खोजने में क्या कुछ लगता है—वह भी ऐसी लागत पर जिससे किसी लाइब्रेरी का बजट न बिगड़े।
यही वह प्रोजेक्ट है जिसे Harvard Law School Library की Institutional Data Initiative की एक टीम ने हाल ही में प्रकाशित किया है: Institutional Books - Visual Elements, जो इसी संग्रह के उनके पिछले टेक्स्ट-एंड-मेटाडेटा रिलीज़ का एक पूरक (companion) है। यह नया काम Harvard की Google Books साझेदारी के लगभग 400 मिलियन पेज स्कैन्स पर एक ओपन-सोर्स पाइपलाइन चलाता है और 22.6 मिलियन विज़ुअल एलिमेंट्स को बाहर निकालता है, जिनमें से प्रत्येक को डिटेक्ट, क्लासिफाई, डिडुप्लिकेट (deduplicate) और एक बड़े सबसेट के लिए कैप्शन भी दिया गया है। यह डेटासेट और पाइपलाइन Hugging Face और GitHub पर सार्वजनिक रूप से उपलब्ध हैं, और document AI, OCR या डिजिटल आर्काइव्स के क्षेत्र में काम करने वाले किसी भी व्यक्ति के लिए देखने लायक हैं।
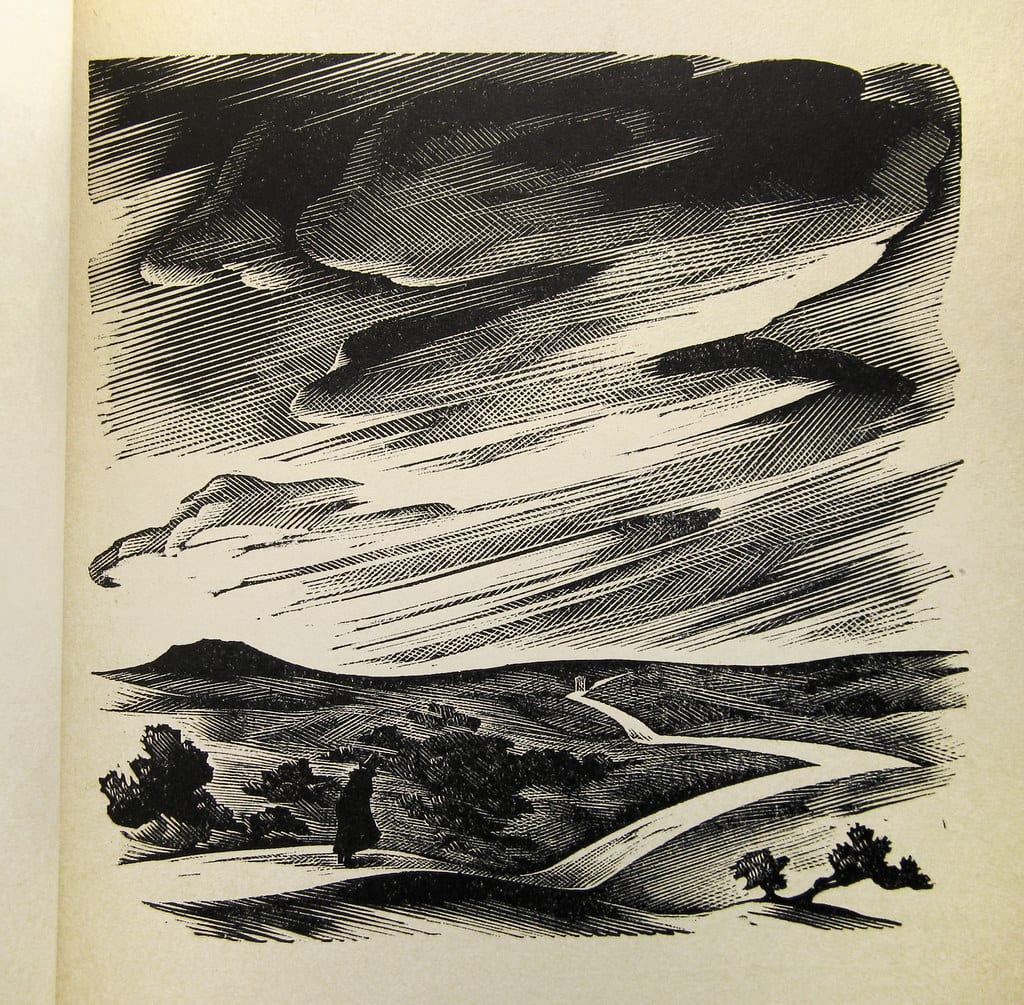
Agnes Miller Parker - 'The Return of The Native' के लिए वुड एनग्रेविंग — Thomas Shahan 3 द्वारा flickr के माध्यम से, BY 2.0।
वह समस्या जिसे OCR खामोशी से नज़रअंदाज़ कर देता है
ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) एक खास काम में बेहद माहिर हो चुका है: टेक्स्ट के पिक्सल को मशीन-पठनीय टेक्स्ट में बदलना। बड़े पैमाने पर किताबों के डिजिटलीकरण का हर प्रयास इसी पर निर्भर करता है। लेकिन एक स्कैन किया गया पेज सिर्फ टेक्स्ट नहीं होता। पुरानी किताबें वुडकट्स (woodcuts), नक्काशी (engravings), लिथोग्राफ, हाथ से रंगे गए प्लेट्स, शीट म्यूज़िक, आरेख (diagrams), और कभी-कभार स्कैनिंग के दौरान गलती से कैमरे में आ जाने वाले अँगूठे से भरी होती हैं। टेक्स्ट पाइपलाइन इनमें से किसी को भी छू तक नहीं पाती। यह सब पेज की इमेज में यूँ ही पड़ा रहता है—अनइंडेक्स्ड और बिना सर्च किए जा सकने वाला।
यह अंतर अब पहले की तुलना में कहीं अधिक मायने रखता है। विज़न-लैंग्वेज मॉडल्स (VLMs)—वे AI सिस्टम जो किसी इमेज को देखकर उसका वर्णन कर सकते हैं या उसके बारे में तार्किक निष्कर्ष निकाल सकते हैं—ज़्यादातर इंटरनेट की समकालीन विज़ुअल सामग्री पर प्रशिक्षित होते हैं: मीम्स, प्रोडक्ट्स की तस्वीरें, स्क्रीनशॉट्स, आधुनिक कला। यह पेपर हालिया शोध का हवाला देता है जो दिखाता है कि ये मॉडल्स ऐतिहासिक छवियों (historical imagery) के साथ संघर्ष करते हैं और जिसे शोधकर्ता "टेम्पोरल डिस्ट्रीब्यूशन शिफ्ट" (temporal distribution shift) कहते हैं, उसके तहत उनका प्रदर्शन गिर जाता है (यानी जब किसी मॉडल को, जिसने ज़्यादातर आधुनिक तस्वीरों से सीखा है, 19वीं सदी का कोई वुडकट दिया जाए तो यह मिसमैच पैदा होता है)। इसके अलावा, वे कालभ्रमित तर्क (anachronistic reasoning) करने लगते हैं, जैसे किसी भाप के इंजन का वर्णन ऐसे करना मानो वह कोई आधुनिक ट्रेन हो। यदि कोई भी ऐतिहासिक विज़ुअल सामग्री को ऐसे रूप में सामने नहीं लाएगा जिससे मॉडल्स सीख सकें, तो यह ब्लाइंड स्पॉट अपने आप खत्म नहीं होने वाला।
इसमें शामिल पैमाना भी छोटा नहीं है: लगभग 400 मिलियन पेज स्कैन्स, जिनका कुल आकार 60 terabytes है। इनमें से अधिकांश में एक भी चित्र नहीं है, जबकि कुछ—जैसे कि वह मूर्तिकला कैटलॉग—में हज़ारों चित्र मौजूद हैं। वास्तविक विज़ुअल एलिमेंट्स को छोड़े बिना या किसी अजीब तरह से फॉर्मेट किए गए पैराग्राफ से आने वाले फॉल्स पॉजिटिव्स (गलत पहचान) में डूबे बिना इस सब को छांटना, AI की समस्या बनने से पहले एक कठिन सिस्टम्स (systems) समस्या है।
छोटा मॉडल, बड़ा कलेक्शन
पूरी रिपोर्ट में यह सबसे शांत लेकिन दृढ़ राय वाला फैसला है। सिद्धांत रूप में, विज़न-लैंग्वेज मॉडल्स एक ही पास (pass) में विज़ुअल एलिमेंट्स को खोज भी सकते हैं और उनका वर्णन भी कर सकते हैं, तो फिर किसी VLM को सीधे 400 मिलियन पेजों पर लगाकर काम क्यों न करवाया जाए? लेखकों का जवाब है: लागत, और इस बात का मिसमैच कि VLMs किस चीज़ में अच्छे हैं और इस टास्क की क्या ज़रूरतें हैं। इस आकार के संग्रह पर ट्रांसफॉर्मर-आधारित VLM चलाना, उनके शब्दों में, अधिकांश पुस्तकालयों की पहुँच से बाहर होगा। और VLM के मुख्य लाभ—जैसे फ्यू-शॉट लर्निंग (few-shot learning) और अजीब इनपुट्स के प्रति मजबूती (robustness)—यहाँ ज़्यादा काम नहीं आते जब आपके डेटा में मजबूत और सुसंगत विज़ुअल व टाइपोग्राफिक नियम मौजूद हों, जैसा कि डिजिटाइज़्ड किताबों के पेजों में होता है। इसलिए इसके बजाय उन्होंने एक छोटा, विशेष प्रयोजन से बनाया गया डिटेक्टर प्रशिक्षित किया: 2.4 मिलियन पैरामीटर्स वाला एक YOLO26n मॉडल, जो एक सामान्य लैंग्वेज मॉडल के आकार का भी एक छोटा सा हिस्सा है।
उन्होंने 109 मैन्युअल रूप से एनोटेट किए गए पेजों से शुरुआत की, ट्रेनिंग सेट को 271 वॉल्यूम्स के 4,528 पेजों तक बढ़ाया, और जानबूझकर ऐसे पेजों को शामिल किया जिनमें कोई भी विज़ुअल एलिमेंट नहीं था। ऐसा इसलिए किया गया क्योंकि संग्रह के अधिकांश पेज केवल टेक्स्ट वाले हैं और मॉडल को आत्मविश्वास के साथ "यहाँ कुछ नहीं है" कहना सीखने की ज़रूरत थी। अंतिम मॉडल को चार GPUs पर प्रशिक्षित करने में 1.4 घंटे लगे। 453 पेजों के एक अलग रखे गए (held-out) टेस्ट सेट पर, इसने "क्या यहाँ कोई विज़ुअल एलिमेंट है या नहीं" के बाइनरी टास्क पर 0.95 precision और 0.96 recall हासिल किया। वास्तव में एक बेहद छोटे मॉडल का यह ज़बरदस्त प्रदर्शन है, और यह लेखकों के उस "फ्रूगल कंप्यूटिंग" (frugal computing) दर्शन का सबसे स्पष्ट प्रमाण है जिसका उन्होंने शुरुआत में ही उल्लेख किया है: सबसे छोटे व्यावहारिक समाधान से शुरुआत करें, और अधिक कंप्यूट तभी खर्च करें जब वह छोटा तरीका स्पष्ट रूप से विफल हो जाए।
प्रोडक्शन में सबसे बड़ी बाधा (bottleneck) मॉडल भी नहीं था। यह डिस्क I/O था। 394 मिलियन पेज स्कैन्स पर चले 16 दिनों के डिटेक्शन रन के दौरान, प्रति पेज प्रोसेसिंग समय का 89.5% हिस्सा डिस्क से इमेज फाइलों को लोड और डिकोड करने में चला गया, जबकि न्यूरल नेटवर्क इनफेरेंस के लिए 10% से भी कम समय लगा। इसके चलते चार समर्पित GPUs अपने सैद्धांतिक थ्रूपुट के आधे से भी कम पर सुस्त (idle) पड़े रहे। यह एक उपयोगी सबक है कि बड़ी डॉक्यूमेंट पाइपलाइनों में, आपका समय अक्सर मॉडल की प्रोसेसिंग में नहीं जाता।
एक ध्यान देने योग्य दिलचस्प बात: डिटेक्टर के अटेंशन के हीटमैप्स ने दिखाया कि यह तय करने के लिए कि क्या पेज पर कुछ असामान्य मौजूद है, वह पेज के मार्जिन के चारों ओर मौजूद खाली जगह (whitespace) पर काफी हद तक निर्भर करता है, क्योंकि टेक्स्ट ब्लॉक्स दिखने में एक समान होते हैं और चित्र उस पैटर्न को तोड़ते हैं।
पाँच श्रेणियाँ, और मॉडल कहाँ भ्रमित होता है
एक बार जब किसी क्षेत्र को फ्लैग (चिह्नित) कर लिया जाता है, तो दूसरा छोटा मॉडल उसे पाँच श्रेणियों में से एक में छाँटता है: Image/Illustration, Music, Artifact, Ex Libris/Decorative, और Chart/Graph। "Artifact" स्कैनिंग के शोर (noise) के लिए एक सामान्य श्रेणी है: स्कैन के दौरान आ गए हाथ, मेटल पेज क्लिप्स, या फटे हुए कोने। हर श्रेणी के लिए सटीकता (per-class accuracy) सभी स्तरों पर मजबूत है—Image/Illustration पर 0.98 precision, Music पर 0.99—सिवाय एक कमजोर बिंदु के: Chart/Graph 0.87 पर अटका रहा, और Ex Libris/Decorative के 12.9% प्रेडिक्शन्स कम कॉन्फिडेंस वाले रहे और उन्हें फिर से वर्गीकृत (reclassified) करना पड़ा।
पेपर इस कारण को लेकर पूरी तरह स्पष्ट है: बुकप्लेट्स (bookplates), प्रिंटर के निशान और सजावटी बॉर्डर संरचनात्मक रूप से अक्सर छोटे चित्रों की तरह ही दिखते हैं, और मॉडल को सीमित संदर्भ (context) से यह अनुमान लगाना पड़ता है कि कोई खास सजावटी आकृति किस श्रेणी में आती है। एक उदाहरण: लाइब्रेरी प्रतियोगिता की तीन अलंकृत एक्स लिब्रिस (ex libris) बुकप्लेट्स सही ढंग से डिटेक्ट तो हो जाती हैं, लेकिन वे "Image/Illustration" श्रेणी में चली जाती हैं, क्योंकि अलग से देखने पर एक बुकप्लेट और एक छोटा चित्र बिल्कुल एक जैसे लगते हैं।
म्यूज़िक के लिए एक अलग समाधान निकाला गया। क्लासिफायर घने छोटे निशानों या स्टाफ (staff) जैसी रेखाओं वाली किसी भी चीज़ को बार-बार Music श्रेणी समझ बैठता था। इसलिए टीम ने एक दूसरा सिग्नल जोड़ा: 0.99 से ऊपर के कॉन्फिडेंस पर सीधे भरोसा करें, और उससे नीचे केवल तभी Music लेबल बनाए रखें जब उस क्रॉप के AI-जनरेटेड कैप्शन में संगीत से जुड़ा कोई वास्तविक कीवर्ड मौजूद हो। इस नियम ने लगभग 1.2 मिलियन Music प्रेडिक्शन्स में से 12,502 को "Other" में पुनः वर्गीकृत कर दिया। यह एक छोटा सा ऑपरेशनल विवरण है, लेकिन बेहद वास्तविक है: कभी-कभी किसी जिद्दी क्लासिफिकेशन त्रुटि का हल कोई बेहतर मॉडल नहीं होता, बल्कि एक दूसरा और सस्ता सिग्नल होता है जो वह पकड़ लेता है जो पहला मॉडल छोड़ गया था।
एक ही बारकोड को 418,436 बार खोजना
दस लाख किताबों को डिजिटाइज़ करने से भारी मात्रा में डुप्लिकेट्स पैदा होते हैं: अलग-अलग प्रिंट रन में दोबारा इस्तेमाल किए गए वही चित्र, प्रकाशक द्वारा हर अध्याय के शीर्षक पर मुहरबंद किए गए सजावटी बॉर्डर, और—कम ग्लैमरस रूप में—वे भौतिक बारकोड स्टिकर जो Harvard की अपनी Widener Library ने स्कैनिंग क्रैडल्स पर लगाए थे, जिन्हें फ्रेम में आते ही डिटेक्टर ने पूरी निष्ठा से हर बार विज़ुअल एलिमेंट्स के रूप में फ्लैग कर दिया।
पाइपलाइन इसे दो चरणों में संभालती है: लगभग समान छवियों के लिए सस्ता पर्सेप्चुअल हैशिंग (perceptual hashing)—उस तरह के पिक्सेल-दर-पिक्सेल डुप्लिकेट्स जो गलती से दो बार स्कैन किए गए पेज से आते हैं; और फिर उन सामग्रियों के लिए जो दिखने में समान हैं लेकिन बिल्कुल एक जैसी नहीं हैं (जैसे अलग रिज़ॉल्यूशन पर दोबारा छापा गया वही चित्र), कॉपी डिटेक्शन के लिए विशेष रूप से बनाए गए मॉडल SSCD के माध्यम से डेंस एम्बेडिंग्स (dense embeddings)। लेखकों ने CLIP और SigLIP 2 सहित चार सामान्य-उद्देश्यीय मल्टीमॉडल एम्बेडिंग मॉडल्स के मुकाबले SSCD का परीक्षण किया, और SSCD स्पष्ट रूप से जीता: उनके बेंचमार्क पर 0.93 precision और 0.82 recall, जो निकटतम सामान्य-उद्देश्यीय विकल्प से काफी आगे था। ध्यान देने योग्य बात: एक संकीर्ण (narrow) मॉडल ने एक बड़े और अधिक चर्चित मॉडल को मात दी।
अकेले लागू करने पर, हैशिंग ने डिटेक्ट किए गए कुल 43.7 मिलियन क्रॉप्स को 22% तक घटा दिया; एम्बेडिंग समानता अधिक आक्रामक थी, जिसने इसे 31% कम किया। टीम ने अंतिम रिलीज़ के लिए रूढ़िवादी (conservative) विकल्प चुना: दो क्रॉप्स को केवल तभी एक डुप्लिकेट समूह में मर्ज किया जाए जब दोनों तरीके सहमत हों। इसने कुल संख्या को 19.6% कम कर दिया, जिससे यह 22,622,060 यूनिक विज़ुअल एलिमेंट्स पर आ टिकी। पाए गए दो सबसे बड़े डुप्लिकेट क्लस्टर्स में एक ही सजावटी बॉर्डर आभूषण की 824,599 लगभग समान प्रतियां, और उस Widener Library बारकोड स्टिकर के 418,436 उदाहरण शामिल थे। कहीं किसी स्कैनिंग रूम में, किसी ने सैकड़ों हज़ारों क्रैडल्स पर एक बारकोड लगाया था, और ऐतिहासिक चित्रों को खोजने के लिए बनाई गई पाइपलाइन ने कर्तव्यनिष्ठा से उन सभी को चिह्नित कर लिया।
प्रायोगिक हिस्सा: LLM से कैप्शन लिखवाना
पाइपलाइन का सबसे दिलचस्प और सबसे संकोच भरा (hedged) हिस्सा कैप्शनिंग है। 22.6 मिलियन में से 18.5 मिलियन एलिमेंट्स के लिए—Ex Libris/Decorative और Artifact क्रॉप्स को छोड़ते हुए, क्योंकि किसी बुकप्लेट या स्कैनिंग क्लिप को विवरण की आवश्यकता नहीं होती—टीम ने OpenAI के GPT-4.1-nano का उपयोग किया। इसमें क्रॉप की गई इमेज और आसपास के पेज के OCR टेक्स्ट दोनों को कॉन्टेक्स्ट के रूप में दिया गया, और किताब की मूल भाषा में 50 या उससे कम शब्दों का कैप्शन माँगा गया।
इस पैमाने पर ज़रा गौर कीजिए: 34.263 मिलियन API अनुरोध, 66.994 बिलियन इनपुट टोकन, और प्रॉम्प्ट कैशिंग की बदौलत कुल लागत मात्र $4,441.42। लगभग 767 मिलियन टोकन का विवरणात्मक मेटाडेटा उत्पन्न करने का यह उल्लेखनीय रूप से सस्ता तरीका है, और यह ठीक उसी तरह का आँकड़ा है जो आउटपुट पर आँख मूँद कर भरोसा करने से पहले किसी को भी सोचने पर मजबूर कर दे।
लेखकों की सराहना करनी होगी कि वे इसे बढ़ा-चढ़ाकर पेश नहीं करते। वे इस घटक को स्पष्ट रूप से "प्रायोगिक" (experimental) कहते हैं, जो डिटेक्शन, क्लासिफिकेशन और डिडुप्लिकेशन चरणों से अलग है—क्योंकि वे स्थापित तकनीकें थीं जिन्हें वे ग्राउंड ट्रुथ (ground truth) के सापेक्ष सटीकता से माप सकते थे। किसी LLM द्वारा ऐतिहासिक छवियों को कैप्शन देना एक खुला शोध प्रश्न (open research problem) है: सामान्य-उद्देश्यीय VLMs में संभवतः काल-विशिष्ट छपाई तकनीकों के विशेष ज्ञान की कमी होती है, और हैल्यूसिनेशन (hallucination)—यानी कुछ ऐसा कहना जो सुनने में तो सही लगे पर वास्तव में गलत हो—एक वास्तविक जोखिम था जिसे वे पूरी तरह नकार नहीं सकते थे। शुरुआती परीक्षणों में पाया गया कि मॉडल कभी-कभी छवि का वर्णन करने के बजाय आसपास के पेज टेक्स्ट का ही सार प्रस्तुत कर देता था, जिसे उन्होंने डाउनस्ट्रीम में काफी हद तक फ़िल्टर कर दिया, लेकिन पूरी तरह से आश्वस्त होकर नहीं।
उन्होंने किसी भी हानिकारक सामग्री को पकड़ने के लिए जनरेट किए गए कैप्शन्स पर कंटेंट-सेफ्टी मॉडल्स चलाने की भी कोशिश की, लेकिन परिणाम इतने भरोसेमंद नहीं रहे: किसी दस्तावेज़ के दौर और संदर्भ के साथ आपत्तिजनक या गलत फ्रेमिंग की परिभाषा इस तरह बदल जाती है जिसे एक सामान्य फ़िल्टर नहीं पकड़ पाता। इसलिए कैप्शन "जैसे हैं वैसे ही" (as is) जारी किए गए हैं—एक ठोस आधार पर एक प्रायोगिक परत के रूप में, न कि सत्यापित ग्राउंड ट्रुथ के तौर पर।
OCR बनाने या चुनने वाले किसी भी व्यक्ति के लिए यह क्यों मायने रखता है
यदि आप किसी वास्तविक प्रोजेक्ट के लिए OCR या document-AI टूल्स का मूल्यांकन कर रहे हैं, तो यहाँ तीन बातें बेहद काम की हैं—चाहे आपका ऐतिहासिक किताबों के संग्रह से कभी पाला पड़े या न पड़े।
टेक्स्ट एक्सट्रैक्शन और विज़ुअल एक्सट्रैक्शन अलग-अलग समस्याएँ हैं, और उनके एरर मोड्स (error modes) भी अलग हैं। यदि आपकी पाइपलाइन केवल OCR करती है, तो आप परोक्ष रूप से यह तय कर रहे हैं कि दस्तावेज़ में जो कुछ भी टेक्स्ट नहीं है, उसका अस्तित्व ही नहीं है। अनुबंधों और कानूनी कागजी कार्रवाई के लिए यह ठीक है, जहाँ आरेख केवल सहायक भूमिका में होते हैं। लेकिन किसी स्कैन किए गए संग्रह के लिए यह एक बड़ा अंतर (gap) है: हस्ताक्षर वाला कोई फॉर्म, हाथ से बनाए गए चित्र वाली कोई लैब नोटबुक, या तस्वीर लगा कोई पुराना रिकॉर्ड। किसी भी OCR वेंडर से सीधे यह पूछना उचित होगा कि पेज के उन हिस्सों का क्या होता है जो टेक्स्ट नहीं हैं। वैसे, दस्तावेज़ों के मूल्यांकन में यह भी याद रखना चाहिए कि अंग्रेज़ी में मजबूत OCR होने का यह मतलब कतई नहीं है कि वह देवनागरी की शिरोरेखा, मात्राओं और संयुक्ताक्षरों के साथ भी उतना ही सटीक काम करेगा।
एक छोटे, टास्क-विशिष्ट मॉडल ने "बस इस पर कोई VLM झोंक दो" की स्वाभाविक प्रवृत्ति को लागत और सटीकता दोनों में निर्णायक रूप से मात दी। प्रोडक्शन डॉक्यूमेंट AI में यह पैटर्न बार-बार सामने आता है। यदि आपके दस्तावेज़ों की संरचना सुसंगत है—जैसे कोई रसीद टेम्पलेट, फॉर्म लेआउट, या कोई ऐसा डॉक्यूमेंट प्रकार जिसे यूज़र्स बार-बार अपलोड करते हैं—तो एक छोटा फाइन-ट्यून्ड मॉडल अक्सर इनफेरेंस लागत के एक छोटे से हिस्से में सामान्य-उद्देश्यीय मॉडल से बेहतर प्रदर्शन करेगा। महंगे मॉडल को अस्पष्ट मामलों के लिए बचाकर रखें; ठीक यही वह हाइब्रिड दृष्टिकोण है जिसे लेखक एक आशाजनक दिशा के रूप में इंगित करते हैं: आसान 95% के लिए सस्ता डिटेक्टर, और केवल बॉर्डरलाइन मामलों के लिए VLM।
पाइपलाइन का कोई भी चरण जो LLM-जनरेटेड मेटाडेटा जोड़ता है, उसे अपने स्वयं के कॉन्फिडेंस सिग्नल की आवश्यकता होती है, न कि उससे पहले के डिटरमिनिस्टिक चरणों के विश्वास स्तर की। लेखकों ने प्रत्येक कैप्शन के लिए टोकन-स्तरीय लॉग संभावनाओं (log probabilities) को ट्रैक किया और पूरे कैप्शनिंग आउटपुट को डेटासेट स्कीमा में 'प्रायोगिक' के रूप में लेबल किया, जो सीधे मूल लाइब्रेरी मेटाडेटा से लिए गए फ़ील्ड्स से बिल्कुल अलग था। AI-जनरेटेड दस्तावेज़ मेटाडेटा शिप करने वाले किसी भी व्यक्ति के लिए यह एक बेहतरीन अभ्यास है: हैल्यूसिनेशन-प्रोन (hallucination-prone) चरण को अपने आस-पास के चरणों की विश्वसनीयता चुपचाप हासिल न करने दें।
वह सब जो यह डेटासेट आपको नहीं बता सकता
पेपर का सबसे ईमानदार हिस्सा मॉडल्स के बारे में नहीं है, बल्कि इस बारे में है कि इसमें किसका प्रतिनिधित्व हुआ। चूँकि 19वीं सदी की तकनीकों—जैसे वुड एनग्रेविंग और लिथोग्राफी—के साथ सचित्र छपाई में भारी उछाल आया, इसलिए यह विज़ुअल डेटासेट मुख्य रूप से 1800 और 1900 के दशकों की ओर झुक जाता है (भारी मात्रा में सचित्र वॉल्यूम्स का क्रमशः 64% और 33%) और पुराने, केवल-टेक्स्ट वाले कार्यों से दूर हो जाता है। मूल टेक्स्ट कॉर्पस में अपने हिस्से की तुलना में अंग्रेज़ी भाषा की किताबों का प्रतिनिधित्व अत्यधिक है, क्योंकि यहाँ अंग्रेज़ी भाषा के वॉल्यूम्स में छवियों का घनत्व अधिक है। ललित कला (Fine Arts) और विज्ञान का प्रतिनिधित्व अत्यधिक है; वहीं कानून (Law), अंतर्निहित टेक्स्ट संग्रह का 13% होने के बावजूद, डिटेक्ट किए गए विज़ुअल एलिमेंट्स वाले वॉल्यूम्स में केवल 4.2% का योगदान देता है, क्योंकि उस युग के कानूनी ग्रंथ लगभग पूरी तरह से गद्य (prose) थे।
यह वास्तव में कोई खामी नहीं है। यह इस बात का एक ईमानदार मापन है कि शुरुआत में किन चीज़ों का चित्रण किया गया था, जिसमें एक वास्तविक और संरचनात्मक पूर्वाग्रह (structural bias) था, जो इस बात से और फ़िल्टर हो गया कि डिटेक्शन मॉडल किन भाषाओं और लेआउट्स को अच्छी तरह संभालता है। लेकिन इस डेटा पर मॉडल को प्रशिक्षित करने की योजना बनाने वाले किसी भी व्यक्ति के लिए यह एक चेतावनी लेबल है: आप एक ऐसे विज़ुअल रिकॉर्ड पर ट्रेनिंग कर रहे होंगे जो असंगत रूप से अंग्रेज़ी, हालिया दौर का, और ऐसे क्षेत्रों से लिया गया है जो संयोगवश चित्रों पर अधिक निर्भर थे। लेखक कुछ सामान्य सावधानियों को भी इंगित करते हैं: HathiTrust की पब्लिक-डोमेन स्थिति पर आधारित अधिकारों का निर्धारण "कभी-कभार त्रुटि के अधीन" होता है, और डुप्लिकेट वॉल्यूम्स यह अवशिष्ट जोखिम (residual risk) छोड़ते हैं कि वही छवि डाउनस्ट्रीम में ट्रेनिंग स्प्लिट और टेस्ट स्प्लिट दोनों में पहुँच सकती है।
ठीक इसी कारण से यह एक असामान्य रूप से पारदर्शी तकनीकी रिपोर्ट है। अधिकांश जारी किए गए डेटासेट्स प्रभावशाली आँकड़े दिखाते हैं और इस झुकाव (skew) को किसी ऐसे परिशिष्ट (appendix) में दफन कर देते हैं जिसे कोई नहीं पढ़ता। यह रिपोर्ट इसे वास्तविक प्रतिशतों के साथ एक समर्पित अनुभाग में रखती है, और स्पष्ट रूप से बताती है कि कौन से निष्कर्ष नहीं निकाले जाने चाहिए। किसी डेटासेट की अपनी सीमाओं के बारे में इस तरह की ईमानदारी को लंबे समय तक याद रखा जाना चाहिए—तब भी जब "Spiders Georg" इस रिपोर्ट का सबसे यादगार विवरण न रह जाए।