Dentro del pipeline de 22.6 millones de imágenes que Harvard construyó para encontrar las ilustraciones que el OCR ignora
Basado en: Institutional Books - Visual Elements: An open-source pipeline for extracting, classifying, deduplicating, and captioning visual elements from digital book collections — Jimmy Mendez, Matteo Cargnelutti, David Lowry-Duda, Catherine Brobston, Salwa Ismail, Greg Leppert, Amanda Watson, Jonathan Zittrain
En algún lugar de la colección digitalizada de Harvard Library descansa un único volumen, un catálogo de referencia artística sobre estatuaria griega y romana, que por sí solo generó 5,260 detecciones de imágenes independientes: más elementos visuales distintos de los que la mayoría de los pequeños museos catalogan en una década, todos extraídos de un solo libro. El equipo detrás de este proyecto notó que distorsionaba tanto sus promedios que le pusieron un apodo: "Spiders Georg", en alusión al clásico chiste de internet sobre aquel tipo con 100,000 arañas que arruinaba el promedio de arañas en su aldea. Es un detalle divertido y, al mismo tiempo, un anticipo del tema de fondo: lo que se necesita para encontrar cada ilustración, grabado, fotografía y floritura decorativa oculta en 983,004 libros escaneados, a un costo que no lleve a la quiebra a una biblioteca.
Ese es el proyecto que acaba de publicar un equipo de la Institutional Data Initiative de la Harvard Law School Library: Institutional Books - Visual Elements, un complemento de su publicación previa de texto y metadatos sobre la misma colección. Este nuevo trabajo ejecuta un pipeline de código abierto sobre aproximadamente 400 millones de páginas escaneadas provenientes de la alianza de Harvard con Google Books y extrae 22.6 millones de elementos visuales, cada uno detectado, clasificado, deduplicado y, en un amplio subconjunto, dotado de descripciones textuales (captioned). Tanto el dataset como el pipeline son públicos en Hugging Face y GitHub, y merecen una revisión por parte de cualquiera que trabaje en IA de documentos, OCR o archivos digitales.
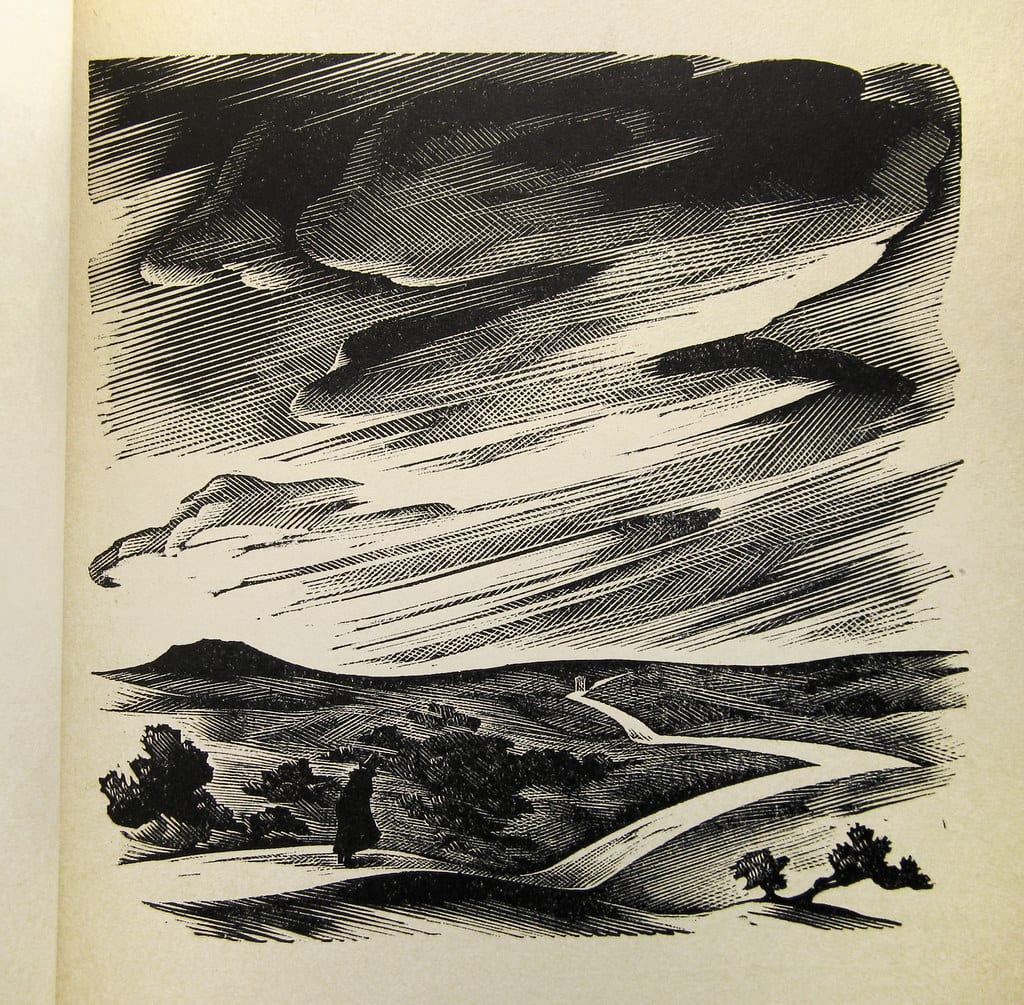
Agnes Miller Parker - Grabado en madera para 'The Return of The Native' — por Thomas Shahan 3 vía flickr, BY 2.0.
El problema que el OCR ignora en silencio
El reconocimiento óptico de caracteres se ha vuelto sumamente eficaz en una tarea muy concreta: transformar píxeles de texto en texto legible por máquina. Todos los proyectos de digitalización de libros a gran escala dependen de él. Sin embargo, una página escaneada no contiene únicamente texto. Los libros antiguos están repletos de xilografías, grabados, litografías, láminas coloreadas a mano, partituras, diagramas y, de vez en cuando, algún pulgar rezagado capturado en pleno escaneo. Nada de esto pasa por un pipeline de texto; simplemente permanece allí en la imagen de la página, sin indexar e imposible de buscar.
Esa brecha importa hoy mucho más que antes. Los modelos de visión y lenguaje (VLM), los sistemas de IA capaces de observar una imagen, describirla y razonar sobre ella, se entrenan principalmente con la dieta visual contemporánea de internet: memes, fotos de productos, capturas de pantalla y arte moderno. El artículo cita investigaciones recientes que demuestran que estos modelos tienen dificultades con las imágenes históricas, se degradan bajo lo que los investigadores denominan "desplazamiento de distribución temporal" (temporal distribution shift, el desajuste que ocurre al alimentar a un modelo con un grabado en madera del siglo XIX cuando aprendió principalmente de fotografías modernas) y son propensos a razonamientos anacrónicos, como describir una máquina de vapor como si fuera un tren moderno. Si nadie saca a la luz el material visual histórico en un formato del que los modelos puedan aprender, ese punto ciego no desaparecerá por sí solo.
La escala en cuestión tampoco es menor: alrededor de 400 millones de páginas escaneadas que suman 60 terabytes, la mayoría de las cuales no contiene ninguna ilustración, mientras que un puñado —como el catálogo de estatuas— contiene miles. Filtrar todo eso sin perder elementos visuales reales ni ahogarse en falsos positivos provocados por un párrafo con un formato extraño es un problema complejo de ingeniería de sistemas antes de ser siquiera un problema de IA.
Modelo pequeño, gran colección
Esta es la decisión de diseño más sutilmente determinante de todo el informe. En principio, los modelos de visión y lenguaje pueden tanto localizar como describir elementos visuales en una sola pasada, así que ¿por qué no apuntar uno hacia 400 millones de páginas y dejarlo trabajar? La respuesta de los autores: el costo y el desajuste entre aquello en lo que los VLM destacan y lo que esta tarea realmente necesita. Ejecutar un VLM basado en transformers sobre una colección de este tamaño estaría, en sus propias palabras, fuera del alcance de la mayoría de las bibliotecas. Además, las principales ventajas de un VLM —el aprendizaje few-shot y la robustez ante entradas atípicas— no aportan demasiado cuando los datos siguen convenciones visuales y tipográficas sólidas y consistentes, tal como ocurre con las páginas de libros digitalizados. Por eso, en su lugar, entrenaron un detector pequeño y diseñado específicamente para este fin: un modelo YOLO26n con 2.4 millones de parámetros, una fracción del tamaño de cualquier modelo de lenguaje, incluso modesto.
Comenzaron con 109 páginas anotadas manualmente, ampliaron el conjunto de entrenamiento a 4,528 páginas distribuidas en 271 volúmenes e incluyeron deliberadamente páginas sin ningún elemento visual, ya que la mayor parte de la colección es puro texto y el modelo debía aprender a decir "aquí no hay nada" con seguridad. El entrenamiento del modelo final tomó 1.4 horas en cuatro GPU. En un conjunto de prueba independiente (held-out) de 453 páginas, alcanzó una precisión de 0.95 y un recall de 0.96 en la tarea binaria de "¿hay o no un elemento visual aquí?". Un rendimiento sobresaliente para un modelo genuinamente diminuto y la prueba más contundente de la filosofía de "computación frugal" que los autores plantean desde el inicio: comenzar con la intervención viable más pequeña y solo invertir más cómputo cuando la solución simple falle de manera comprobable.
El cuello de botella en producción ni siquiera fue el modelo; fue la E/S de disco (I/O). A lo largo de los 16 días que tomó la ejecución de detección sobre 394 millones de páginas escaneadas, el 89.5% del tiempo de procesamiento por página se consumió en cargar y decodificar archivos de imagen desde el disco, frente a menos del 10% dedicado a la inferencia de la red neuronal propiamente dicha, lo que dejó a cuatro GPU dedicadas funcionando a menos de la mitad de su rendimiento teórico. Un recordatorio muy útil de que, en los grandes pipelines de procesamiento de documentos, el tiempo rara vez se va en el modelo.
Un detalle revelador: los mapas de calor de la atención del detector mostraron que este se apoya fuertemente en el espacio en blanco de los márgenes de la página para determinar si hay algo inusual presente, dado que los bloques de texto son visualmente uniformes y las ilustraciones rompen ese patrón.
Cinco categorías, y dónde se confunde el modelo
Una vez delimitada una región, un segundo modelo pequeño la clasifica en una de cinco categorías: Image/Illustration, Music, Artifact, Ex Libris/Decorative y Chart/Graph. "Artifact" funciona como el comodín para el ruido propio del escaneo: manos capturadas en plena digitalización, clips metálicos para sujetar hojas o esquinas rotas. La exactitud por clase es sólida en general: una precisión de 0.98 en Image/Illustration y de 0.99 en Music, con un único punto débil: Chart/Graph se queda en 0.87, y el 12.9% de las predicciones para Ex Libris/Decorative arrojaron baja confianza y tuvieron que reclasificarse.
El artículo es honesto sobre el motivo: los exlibris, las marcas tipográficas de impresor y los bordes decorativos a menudo se parecen estructuralmente mucho a pequeñas ilustraciones, y el modelo debe deducir a partir de un contexto limitado a qué categoría corresponde una floritura ornamental específica. Un ejemplo: tres ornamentados exlibris de un certamen de bibliotecas se detectan correctamente, pero terminan clasificados en "Image/Illustration", ya que, de forma aislada, un exlibris y una pequeña ilustración son visualmente indistinguibles.
La música requirió una solución propia. El clasificador confundía constantemente cualquier elemento con marcas pequeñas y densas o líneas semejantes a un pentagrama con la categoría Music, por lo que el equipo incorporó una segunda señal: confiar a ciegas en puntuaciones de confianza superiores a 0.99 y, por debajo de ese umbral, mantener la etiqueta Music únicamente si la descripción generada por IA para el recorte contenía alguna palabra clave vinculada a la música. Esta regla reclasificó 12,502 de las aproximadamente 1.2 millones de predicciones de Music hacia la categoría "Other". Un detalle operativo menor, pero muy ilustrativo: a veces, la solución a un error de clasificación persistente no radica en un modelo mejor, sino en una segunda señal, más económica, que atrape lo que la primera pasó por alto.
Encontrar el mismo código de barras 418,436 veces
Digitalizar un millón de libros produce una enorme cantidad de duplicados: la misma ilustración reutilizada en distintas tiradas, cenefas decorativas que una editorial estampaba en el encabezado de cada capítulo y, en un plano menos glamuroso, las etiquetas físicas con códigos de barras que la propia Widener Library de Harvard colocó en las cunas de escaneo, las cuales el detector identificaba rigurosamente como elementos visuales cada vez que aparecían en el encuadre.
El pipeline resuelve esto en dos etapas: primero, un hashing perceptual de bajo costo para imágenes casi idénticas (el típico duplicado píxel por píxel de una página escaneada dos veces por error); luego, embeddings densos mediante SSCD —un modelo diseñado expresamente para la detección de copias— para contenido visualmente similar pero no idéntico, como una misma ilustración reimpresa a distinta resolución. Los autores evaluaron SSCD frente a cuatro modelos multimodales de embeddings de propósito general, incluidos CLIP y SigLIP 2, y SSCD se impuso con claridad: 0.93 de precisión y 0.82 de recall en su benchmark, muy por delante de la alternativa general más cercana. Vale la pena destacarlo: un modelo especializado superando a otro más grande y con más notoriedad mediática.
Aplicado de manera aislada, el hashing redujo los 43.7 millones de recortes detectados brutos en un 22%; la similitud por embeddings fue más agresiva, recortándolos en un 31%. Para la versión final, el equipo optó por la alternativa más conservadora: fusionar dos recortes en un grupo de duplicados solo si ambos métodos coinciden, lo que redujo el total en un 19.6%, situándose en 22,622,060 elementos visuales únicos. Los dos grupos de duplicados más voluminosos fueron 824,599 copias casi idénticas del mismo adorno de borde decorativo y 418,436 apariciones de aquella etiqueta con código de barras de la Widener Library. En algún taller de escaneo, alguien colocó un código de barras en cientos de miles de soportes, y un pipeline desarrollado para hallar ilustraciones históricas registró minuciosamente cada uno de ellos.
La parte experimental: dejar que un LLM escriba las descripciones
La pieza más fascinante —y sobre la que más reservas se guardan— de todo el pipeline es la generación de descripciones (captioning). Para 18.5 millones de los 22.6 millones de elementos (omitiendo los recortes clasificados como Ex Libris/Decorative y Artifact, dado que un exlibris o una pinza de escaneo no requieren descripción), el equipo empleó GPT-4.1-nano de OpenAI, alimentándolo tanto con la imagen recortada como con el texto OCR de la página circundante como contexto, y solicitándole una descripción de 50 palabras o menos en el idioma original del libro.
Vale la pena detenerse a asimilar la magnitud de estas cifras: 34.263 millones de solicitudes a la API y 66.994 mil millones de tokens de entrada, a un costo total de $4,441.42 gracias al almacenamiento en caché de prompts (prompt caching). Una vía asombrosamente económica para generar cerca de 767 millones de tokens de metadatos descriptivos, y precisamente la clase de cifra que debería hacer reflexionar a cualquiera antes de asumir ciegamente la validez de los resultados.
En honor a la verdad, los autores no exageran sus virtudes. Califican este componente explícitamente de "experimental", distinguiéndolo con claridad de las fases de detección, clasificación y deduplicación, que constituyen técnicas consolidadas y evaluables con precisión frente a un ground truth. Generar descripciones de imágenes históricas con un LLM sigue siendo un problema de investigación abierto: los VLM de propósito general probablemente carecen de conocimientos especializados sobre las técnicas de impresión de cada época, y las alucinaciones —describir algo verosímil pero falso— representan un riesgo tangible que no pudieron descartar. Las pruebas iniciales revelaron que el modelo a veces resumía el texto de la página circundante en lugar de describir la imagen en sí, un sesgo que lograron filtrar en su mayor parte en etapas posteriores, aunque sin una certeza absoluta.
También intentaron aplicar modelos de moderación de contenido sobre las descripciones generadas para detectar elementos perjudiciales, pero el resultado no fue lo suficientemente fiable como para confiar en él: lo que califica como ofensivo o como un encuadre inexacto cambia con la época y el contexto de cada documento de modos que un filtro genérico no es capaz de captar. De modo que las descripciones se entregan "tal cual" (as is): una capa experimental sobre una base sólida, no un ground truth verificado.
Por qué esto es importante para quien construya o elija herramientas de OCR
Si estás evaluando herramientas de OCR o de IA documental para un proyecto real, hay tres conclusiones de este trabajo que resultan útiles sin importar si alguna vez trabajas con una colección de libros históricos.
La extracción de texto y la extracción visual son problemas distintos, con modos de error diferentes. Si tu pipeline solo realiza OCR, estás asumiendo implícitamente que todo lo que no sea texto en un documento simplemente no existe. Esto resulta aceptable en contratos o presentaciones formales, donde los diagramas desempeñan un papel secundario. Sin embargo, constituye un vacío grave en un archivo digitalizado: un formulario con una firma, un cuaderno de laboratorio con figuras dibujadas a mano, un expediente antiguo con una fotografía adjunta. Vale la pena preguntarle directamente a cualquier proveedor de OCR qué ocurre con las partes de la página que no contienen texto.
Un modelo pequeño y especializado en la tarea superó de forma contundente el impulso de «simplemente arrojarle un VLM», tanto en costo como en precisión. Este patrón se repite constantemente en la IA documental en entornos de producción. Si tus documentos poseen una estructura coherente —la plantilla de un recibo, el diseño de un formulario o un tipo de documento que los usuarios suben con frecuencia—, un modelo pequeño ajustado (fine-tuned) superará a menudo a un modelo de propósito general por una fracción de su costo de inferencia. Reserva el modelo costoso para los casos ambiguos: exactamente el enfoque híbrido que los autores señalan como una línea prometedora: un detector económico para el 95% sencillo y el VLM reservado únicamente para las decisiones límite.
Cualquier fase del pipeline que incorpore metadatos generados por un LLM necesita su propia señal de confianza, en lugar de heredar el nivel de fiabilidad de las etapas deterministas previas. Los autores registraron las log-probabilidades a nivel de token de cada descripción y etiquetaron la totalidad del contenido generado como experimental en el esquema del dataset, distinguiéndolo de los campos extraídos directamente de los metadatos originales de la biblioteca. Una excelente práctica para cualquiera que despliegue metadatos documentales generados por IA: no permitas que una fase propensa a alucinaciones herede en silencio la credibilidad de las etapas que la rodean.
Lo que el dataset no puede decirte
La sección más franca del artículo no trata sobre los modelos, sino sobre quién terminó estando representado. Dado que la impresión ilustrada experimentó una explosión gracias a tecnologías del siglo XIX como el grabado en madera y la litografía, el dataset visual se inclina fuertemente hacia los siglos XIX y XX (el 64% y el 33% de los volúmenes densamente ilustrados, respectivamente), alejándose de obras más antiguas compuestas exclusivamente por texto. Los libros en inglés están sobrerrepresentados en comparación con su proporción en el corpus textual de base, ya que los volúmenes en inglés aquí tienden a concentrar una mayor densidad de imágenes. Las bellas artes y las ciencias están sumamente sobrerrepresentadas; el derecho, a pesar de constituir el 13% de la colección de texto subyacente, solo aporta el 4.2% de los volúmenes con elementos visuales detectados, dado que los textos jurídicos de aquella época eran casi íntegramente prosa.
Nada de esto constituye un defecto en sí mismo. Es una cuantificación honesta de un sesgo estructural real en aquello que se ilustraba originalmente, filtrado además por los idiomas y formatos de maquetación que el modelo de detección procesa con solvencia. Sin embargo, funciona como una etiqueta de advertencia para quien planee entrenar un modelo con estos datos: estaría entrenando sobre un registro visual desproporcionadamente anglófono, reciente y extraído de disciplinas que, por su naturaleza, dependían de imágenes. Los autores también señalan advertencias más terrenales: las determinaciones de derechos de autor, basadas en el estado de dominio público de HathiTrust, están "sujetas a errores ocasionales", y los volúmenes duplicados dejan un riesgo residual de que una misma imagen termine tanto en el conjunto de entrenamiento (training split) como en el de prueba (test split) en aplicaciones posteriores.
Es un informe técnico inusualmente transparente precisamente por esta razón. La mayoría de los datasets publicados presumen de cifras impresionantes y sepultan sus sesgos en un apéndice que nadie lee. Este, en cambio, lo expone en una sección dedicada, con los porcentajes reales, y declara con total franqueza qué conclusiones no deben extraerse. Esa clase de honestidad sobre los propios límites de un dataset merece ser recordada mucho después de que "Spiders Georg" deje de ser el detalle más memorable del reporte.