ハーバード大学が構築した2260万枚の画像抽出パイプライン:OCRが見落とす図版を発見する技術の内幕
元論文: Institutional Books - Visual Elements: An open-source pipeline for extracting, classifying, deduplicating, and captioning visual elements from digital book collections — Jimmy Mendez, Matteo Cargnelutti, David Lowry-Duda, Catherine Brobston, Salwa Ismail, Greg Leppert, Amanda Watson, Jonathan Zittrain
ハーバード大学図書館のデジタルコレクションの中に、ギリシャ・ローマ彫像の美術参考目録という、ある1冊の書籍が収蔵されています。この本だけで実に5,260件もの画像検出結果を生み出しました。1冊の本から、小規模な美術館が10年間に目録化するよりも多くの視覚要素が抽出されたのです。プロジェクトチームはこの本があまりにも平均値を歪めていることに気づき、村のクモの平均消費数を1人で10万匹食べて台無しにするという昔のインターネットジョークにちなんで、「Spiders Georg(クモのジョージ)」というニックネームを付けました。これは微笑ましいエピソードですが、同時に本稿の真のテーマを予告するものでもあります。すなわち、図書館を破産させないコストで、スキャンされた983,004冊の書籍に潜むあらゆる挿絵、版画、写真、装飾的あしらいを見つけ出すには何が必要か、という問いです。
これこそが、ハーバード大学ロースクール図書館のInstitutional Data Initiativeチームが発表したプロジェクト『Institutional Books - Visual Elements』です。これは、同コレクションについて先行して公開されていたテキストおよびメタデータのリリースに続く姉妹編となります。この新たな研究では、ハーバード大学とGoogle Booksの提携によってスキャンされた約4億ページに対してオープンソースのパイプラインを実行し、2260万件の視覚要素を抽出しました。それぞれの要素は検出、分類、重複排除が行われ、その大部分にはキャプションが付与されています。データセットとパイプラインはHugging FaceおよびGitHubで一般公開されており、Document AI、OCR、デジタルアーカイブに携わる人にとって一見の価値があります。
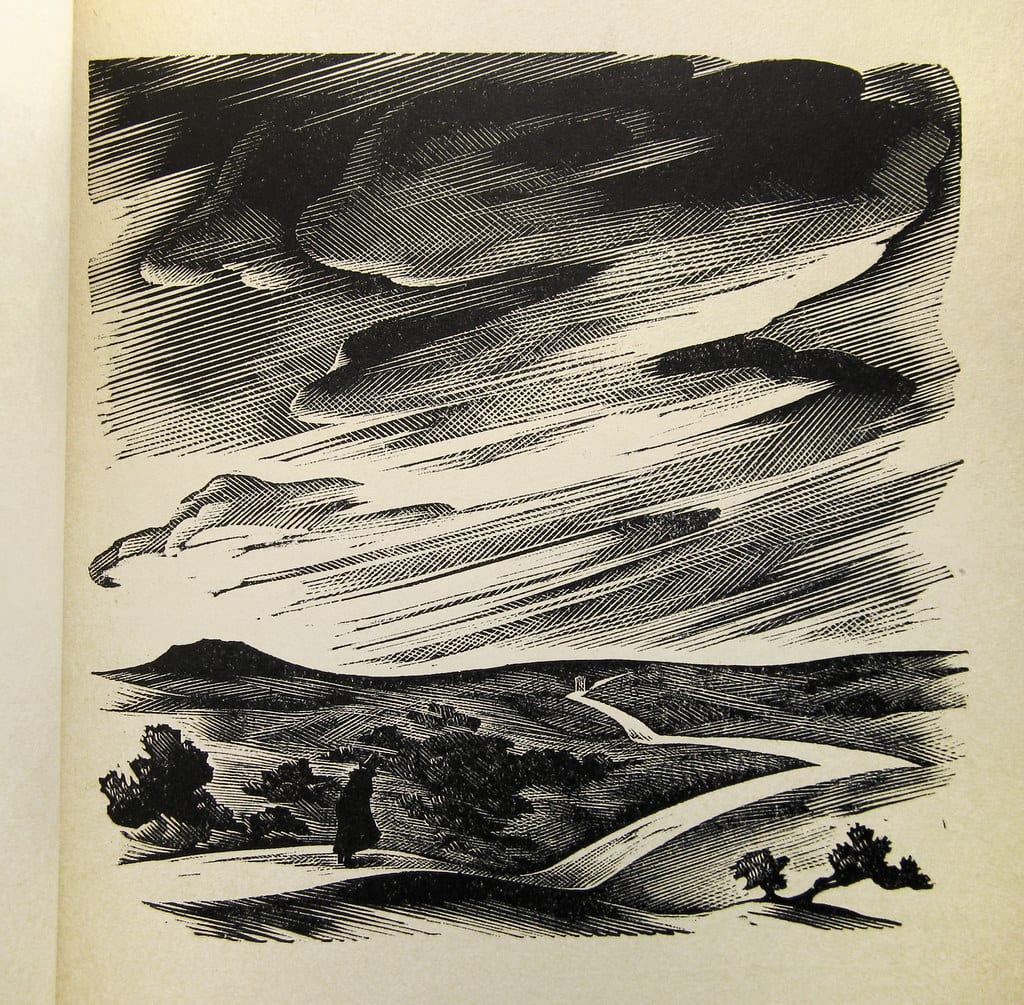
アグネス・ミラー・パーカー(Agnes Miller Parker) - 『帰郷(The Return of The Native)』のための木口木版画 — Thomas Shahan 3(flickr経由)、CC BY 2.0
OCRが暗黙のうちに見落としている課題
光学文字認識(OCR)は、テキストのピクセルを機械可読なテキストへと変換するという、特定の処理において極めて高い精度を誇るようになりました。大規模な書籍デジタル化の取り組みは、例外なくこのOCRに依存しています。しかし、スキャンされたページに含まれているのはテキストだけではありません。古い書籍には、木版画、エングレービング(銅版画)、リトグラフ、手彩色図版、楽譜、図表、さらにはスキャン時にうっかり写り込んだ指などが無数に存在します。テキスト処理パイプラインでは、それらは一切処理されません。インデックスも作成されず、検索もできないまま、ページ画像の中にただ放置されてしまうのです。
このギャップは、以前にも増して重要性を増しています。画像を認識して説明や推論を行うAIシステムであるビジョン言語モデル(VLM)は、主に現代のインターネット上の視覚データ(ミーム、商品写真、スクリーンショット、現代アートなど)によってトレーニングされています。同論文が引用する最近の研究によると、こうしたモデルは歴史的な画像データの処理を苦手とし、研究者が「時間的分布シフト(temporal distribution shift)」(現代の写真を中心に学習したモデルに19世紀の木版画を入力した際に生じる不一致)と呼ぶ現象によって性能が低下するほか、蒸気機関車を現代の列車のように説明してしまうといった時代錯誤な推論に陥りやすいことが示されています。歴史的な視覚資料をモデルが学習できる形で表出させなければ、この盲点が自ずと解消されることはありません。
対象となる規模も決して小さくありません。合計60テラバイト、約4億ページに及ぶスキャン画像であり、その大半にはイラストが1つも含まれていない一方で、前述の彫像目録のように数千点もの図版を含むものもごく一部存在します。実際の視覚要素を見落とすことなく、また特殊なフォーマットの段落による誤検知(偽陽性)に埋もれることもなく、そのすべてを選別することは、AIの問題である以前に難度の高いシステム設計の課題です。
小さなモデル、巨大なコレクション
この報告書全体の中で、最も静かに、しかし明確な主張が込められている選択がここにあります。原理的には、ビジョン言語モデル(VLM)を使えば1つのパスで視覚要素の検出とキャプション記述の両方を実行できます。ではなぜ、4億ページに対して単にVLMを実行しなかったのでしょうか。著者らの回答は「コスト」、そして「VLMが得意とすることと、このタスクに求められる要件とのミスマッチ」でした。TransformerベースのVLMをこの規模のコレクションに対して実行することは、著者らの言葉を借りれば「大半の図書館にとって手の届かないもの」です。また、VLMの最大の強みであるフューショット学習(few-shot learning)や変則的な入力に対する頑健性も、デジタル化された書籍ページのように視覚的・タイポグラフィ的な規則性が明確で一貫しているデータに対しては、それほど大きな利点をもたらしません。そこで著者らは、汎用VLMの代わりにタスク特化型の軽量検出モデルをトレーニングしました。それはパラメータ数わずか240万(2.4 million)のYOLO26nモデルであり、控えめな規模の言語モデルと比べてもほんのわずかなサイズにすぎません。
研究チームは手動でアノテーションされた109ページから着手し、271巻にまたがる4,528ページへとトレーニングセットを拡大しました。その際、視覚要素がまったく含まれないページを意図的に含めました。コレクション内の大半のページは純粋なテキストのみであり、モデルは「ここには何もない」と確信を持って判定することを学習する必要があったためです。最終モデルのトレーニングは、4基のGPUでわずか1.4時間で完了しました。ホールドアウトされた453ページのテストセットにおいて、このモデルは「視覚要素が存在するか否か」という二値分類タスクで適合率(precision)0.95、再現率(recall)0.96を達成しました。真に軽量なモデルとしては際立った性能であり、著者らが冒頭で掲げた「倹約的コンピューティング(frugal computing)」の哲学——すなわち、実現可能な最小限の介入から始め、軽量なアプローチが明らかに失敗した場合にのみ計算資源を追加する——を最も明瞭に示す証拠となっています。
本番環境におけるボトルネックは、モデルですらありませんでした。原因はディスクI/Oです。3億9400万ページのスキャンに対する16日間の検出処理において、1ページあたりの処理時間の89.5%はディスクからの画像ファイルの読み込みとデコードに費やされ、ニューラルネットワークの推論そのものに費やされた時間は10%未満でした。その結果、4基の専用GPUは理論スループットの半分未満でアイドル状態を余儀なくされました。大規模なドキュメント処理パイプラインにおいて、時間が消費されるのはモデル推論とは限らないという有益な教訓です。
興味深い付記事項として、検出モデルのアテンションヒートマップを分析したところ、通常とは異なる要素が存在するかどうかを判断するにあたり、ページ余白のホワイトスペース(空白領域)に大きく依存していることが分かりました。テキストブロックは視覚的に均一であるのに対し、図版はその規則的なパターンを崩すためです。
5つのカテゴリとモデルが混同しやすいポイント
領域が検出されると、2つ目の小型モデルがそれを5つのカテゴリ(Image/Illustration[画像/挿絵]、Music[楽譜]、Artifact[アーティファクト]、Ex Libris/Decorative[蔵書票/装飾]、Chart/Graph[図表/グラフ])のいずれかに分類します。「Artifact」は、スキャン時に写り込んだ手、ページの金属クリップ、破れた角など、スキャン時のノイズを総括するカテゴリです。クラスごとの精度は全体として高く、Image/Illustrationの適合率は0.98、Musicは0.99に達しています。ただし弱点も1つあり、Chart/Graphの適合率は0.87にとどまり、Ex Libris/Decorativeの予測の12.9%は確信度が低かったため再分類されました。
論文ではその理由が率直に明かされています。蔵書票(bookplate)や印刷業者マーク(printer's mark)、装飾的な飾り枠は、構造的に小さなイラストと酷似していることが多く、特定の装飾要素がどのカテゴリに属するかを、モデルは限られたコンテキストから推測しなければなりません。一例として、図書館コンペティションの華麗な蔵書票3点が、検出自体は正しかったものの「Image/Illustration」に分類されてしまいました。単体で見れば、蔵書票と小さな挿絵は見分けがつかないためです。
楽譜(Music)の誤分類には独自の手当が施されました。分類器が密集した細かな記号や五線譜に似た線を持つあらゆるものをMusicカテゴリと誤認し続けたため、チームは第2のシグナルを組み合わせました。確信度が0.99を上回る場合はそのまま信頼し、それを下回る場合は、AIが生成した切り抜き画像のキャプションに実際の音楽関連キーワードが含まれている場合にのみMusicラベルを維持するというルールです。このルールにより、約120万件のMusic予測のうち12,502件が「Other」へと再分類されました。これは運用上のささやかな工夫ですが、極めて実用的です。解決困難な分類エラーに対する処方箋は、必ずしもより高度なモデルとは限らず、最初のモデルが見落とした要素を拾い上げる安価な第2のシグナルである場合もあるのです。
同じバーコードを41万8436回検出する
100万冊の書籍をデジタル化すると、膨大な数の重複が生じます。版を重ねる中で再利用された同一の挿絵や、出版元が各章の見出しに配置した飾り枠、そして身も蓋もない例としては、ハーバード大学のワイドナー図書館(Widener Library)がスキャン用クレードルに貼っていた物理的なバーコードシールなどが挙げられます。検出器は、それが画面に現れるたびに忠実に視覚要素として検出していました。
パイプラインではこれを2段階で処理します。まず、誤って2度スキャンされたページのようなピクセル単位でほぼ同一の画像に対しては、計算コストの低い知覚ハッシュ(perceptual hashing)を適用します。次に、異なる解像度で再印刷された同一の挿絵のように、視覚的には類似しているものの完全一致ではないコンテンツに対しては、コピー検出専用モデルであるSSCDによる高密度埋め込み(dense embeddings)を用います。著者らはCLIPやSigLIP 2を含む4つの汎用マルチモーダル埋め込みモデルとSSCDを比較検証しましたが、SSCDが明確に優位性を示しました。ベンチマークにおいて適合率0.93、再現率0.82を記録し、最も成績の良かった汎用モデルを大きく引き離したのです。特化型モデルが、より巨大で脚光を浴びている汎用モデルを打ち負かした好例として注目に値します。
単独で適用した場合、ハッシュ処理によって検出された4370万件の未加工クロップが22%削減され、埋め込み類似度はさらにアグレッシブに31%を削減しました。チームは最終リリースに向けて保守的な選択を採用しました。両方の手法が一致した場合にのみ2つのクロップを重複グループとして統合するという基準です。これにより全体で19.6%削減され、最終的に22,622,060件のユニークな視覚要素に落ち着きました。発見された重複クラスタの上位2つは、同一の装飾枠オーナメントのほぼ同一のコピー824,599件と、例のワイドナー図書館のバーコードシール418,436件でした。どこかのスキャン室で、誰かが数十万回使われるクレードルにバーコードを貼り、歴史的挿絵を探すために構築されたパイプラインがその一つひとつを律儀に検出し続けたのです。
実験的アプローチ:キャプション生成をLLMに委ねる
このパイプラインの中で最も興味深く、かつ最も慎重に予防線が張られているのがキャプション生成です。全2260万件中1850万件の要素(蔵書票やスキャンクリップに説明は不要であるため、Ex Libris/DecorativeとArtifactのクロップは除外)に対し、チームはOpenAIのGPT-4.1-nanoを採用しました。切り抜かれた画像とその周囲のページのOCRテキストをコンテキストとして与え、書籍の原言語で50単語以下のキャプションを生成するよう指示しました。
その処理規模は刮目に値します。3426万3000件のAPIリクエスト、669億9400万の入力トークンを処理し、プロンプトキャッシング(prompt caching)のおかげで総コストはわずか4,441.42ドルに抑えられました。約7億6700万トークンもの説明メタデータを生成する方法としては驚異的な安さですが、同時にその出力結果を額面通りに受け取る前に誰もが立ち止まって考えるべき数字でもあります。
称賛すべきことに、著者らはこの成果を過大にアピールしていません。正解データ(ground truth)に照らして客観的に精度を測定できる確立された技術である検出、分類、重複排除の各段階とは明確に区別し、このコンポーネントを明示的に「実験的(experimental)」と位置づけています。歴史的な図版にLLMでキャプションを付けることは現在も未解決の研究課題です。汎用VLMには特定の時代特有の印刷技法に関する専門知識が不足している可能性が高く、もっともらしく聞こえるが実際には誤っている説明を出力する「ハルシネーション(幻覚)」は、排除しきれない現実的なリスクでした。初期のテストでは、画像そのものを説明するのではなく周囲のページテキストを要約してしまうケースも見られ、後段の処理でその大半をフィルタリングしたものの、完全な確証が得られたわけではありません。
生成されたキャプションに対してコンテンツ安全性モデルを適用し、有害な表現を検出することも試みられましたが、信頼に足る結果は得られませんでした。何が攻撃的であるか、あるいは不正確な描写であるかは文書の時代や文脈によって変化するため、汎用的なフィルターでは捉えきれないからです。したがって、これらのキャプションは検証済みの正解データではなく、堅固な基盤の上に構築された実験的なレイヤーとして「現状のまま(as is)」提供されています。
OCRの開発や選定に携わる人にとって重要な理由
実際のプロジェクトでOCRやDocument AIツールを評価する場合、歴史的な書籍コレクションを扱うかどうかにかかわらず、本研究から得られる以下の3つの知見が役立ちます。
テキスト抽出と視覚要素の抽出は、それぞれ固有のエラーモードを持つ別の問題である。 パイプラインでOCRしか実行しない場合、それはドキュメント内のテキスト以外のすべてが存在しないと暗黙のうちに見なしていることになります。図表が補足にすぎない契約書や提出書類ならそれでも問題ありません。しかし、署名のある帳票、手描きの図がある実験ノート、写真が添付された古い記録など、スキャンされたアーカイブでは大きな欠落となります。テキスト以外の領域がどう処理されるのか、OCRベンダーに直接確認してみる価値があります。(なお、本研究は欧文の横書き文献を前提としており、漢字・かなの混在や縦書き配置といった、多くのOCRやVLMにとって最も難関とされる日本語特有の組版・表記体系は対象外である点には留意が必要です。)
「とりあえずVLMを適用する」という安易なアプローチに対し、タスク特化型の小型モデルがコストと精度の両面で圧倒的な勝利を収めた。 このパターンは、プロダクション環境のDocument AIにおいて繰り返し見られます。レシートのフォーマット、帳票レイアウト、ユーザーが頻繁にアップロードする特定の文書形式など、ドキュメントに一貫した構造がある場合、ファインチューニングされた小型モデルは汎用モデルを上回る性能を、ごくわずかな推論コストで発揮することがよくあります。高価なモデルは判断の難しいケースのために温存すべきです。これはまさに著者らが有望な方向性として挙げているハイブリッドアプローチであり、容易な95%は安価な検出器で処理し、判断の分かれる境界線上のケースにのみVLMを投入します。
LLM生成のメタデータを追加するパイプラインの工程には、先行する決定論的工程の信頼度とは独立した、固有の信頼性シグナルが必要である。 著者らはすべてのキャプションについてトークンレベルの対数確率(log probabilities)を記録し、元の図書館メタデータから直接取得されたフィールドとは明確に区別して、データセットスキーマ内でキャプション出力全体に「実験的」のラベルを付与しました。これはAI生成のドキュメントメタデータを提供する誰にとっても模範的なプラクティスです。ハルシネーションを起こしやすい工程が、前後の安定した工程の信頼性を暗黙のうちに引き継いでしまう事態は避けなければなりません。
このデータセットから読み取れないこと
この論文で最も誠実なセクションは、モデルに関するものではなく、最終的にどのような資料がデータセットに反映されたかに関する部分です。木口木版やリトグラフといった19世紀の技術によって図版印刷が爆発的に普及したため、この視覚データセットは1800年代と1900年代(図版の多い巻のそれぞれ64%と33%)に大きく偏っており、それ以前のテキスト中心の著作は少なくなっています。また、英語の書籍は画像密度が高い傾向があるため、元のテキストコーパスにおける割合に比べて過剰に代表されています。美術や自然科学分野は圧倒的に多くを占める一方で、法学分野は元のテキストコレクションの13%を占めているにもかかわらず、視覚要素が検出された巻のわずか4.2%にすぎません。当時の法学文献はほぼ全編が散文テキストだったためです。
これらは必ずしもデータセットの欠陥というわけではありません。そもそも何に図版が用いられていたかという歴史的・構造的なバイアスと、検出モデルがどの言語やレイアウトを良好に処理できるかによる絞り込みを、率直に測定した結果です。しかし、このデータを使ってモデルをトレーニングしようとする人にとっては、重要な警告表示となります。偏って英語が多く、時代が新しく、たまたま図版に依存していた分野から抽出された視覚記録を学習させることになるからです。著者らはまた、日常的な注意点も指摘しています。HathiTrustのパブリックドメインステータスに基づく権利判定には「時に誤りが生じる」ことや、重複した書籍が存在することで、後段の処理において同じ画像がトレーニングセットとテストセットの両方に混入してしまう潜在的リスクが残されている点です。
まさにこの理由から、本報告書は異例なほど透明性の高いテクニカルレポートとなっています。公開されるデータセットの多くは見栄えの良い数字ばかりを並べ立て、データの偏りは誰も読まない付録に埋もれさせてしまいがちです。しかし本レポートは専用のセクションを設け、実際のパーセンテージを示しながら、どのような結論を導くべきではないかを率直に述べています。データセット自体の限界に対するこうした誠実さは、「Spiders Georg」が本稿で最も印象的なエピソードではなくなった後も、長く記憶に留める価値があります。