تقديم OpenOCR Stratify
يتطلب المستند المعقد من محرك التعرف الضوئي على الحروف (OCR) ما هو أكثر بكثير من مجرد التعرف على الكلمات؛ فقد يحتاج إلى تتبع عمودين متوازيين، وإعادة بناء جدول، وقراءة تصحيح مكتوب بخط اليد، وإبقاء التعليق التوضيحي بجانب الشكل الذي يفسره. ويمكن أن تجتمع كل هذه المهام في الصفحة ذاتها، في حين قد تختلف الطريقة المثلى لقراءة جزء ما عن الجزء الذي يليه.
نعمل على تصميم OpenOCR Stratify لمعالجة هذه المهام على مراحل مجزأة. حيث يقوم Stratify بتحديد المناطق المختلفة داخل المستند، وإرسالها إلى أدوات القراءة التي يختارها العميل، ثم إعادة تجميع النتائج مع الحفاظ الكامل على إسنادها إلى مصادرها الأصلية. وبذلك يمكن معالجة جدول معقد في جولة تدقيق ثانية دون الحاجة إلى إعادة معالجة المستند بأكمله من البداية.
ويعكس الاسم فلسفة هذا النهج: تقسيم المستند المعقد إلى طبقات وأجزاء يمكن التعامل مع كل منها على حدة، مع تتبع كيفية ترابطها وتكاملها معاً. ويتألف سير العمل من أربع مراحل: تحديد المناطق، واختيار أدوات القراءة، واستخراج المحتوى، وإعادة تجميع المستند.
تتيح OpenOCR للعملاء حالياً اختيار محرك OCR عبر واجهة برمجة تطبيقات (API) موحدة. وسيعمل Stratify على توسيع نطاق هذا الخيار ليشمل المناطق الفردية داخل المستند. تجدر الإشارة إلى أن طبقة المعالجة المشتركة، وخيارات الـ API، وأدوات التحكم في منصة العمل (workbench) ما زالت قيد التصميم والتخطيط، وليست متاحة اليوم.
لماذا تعد بنية المستندات أمراً جوهرياً
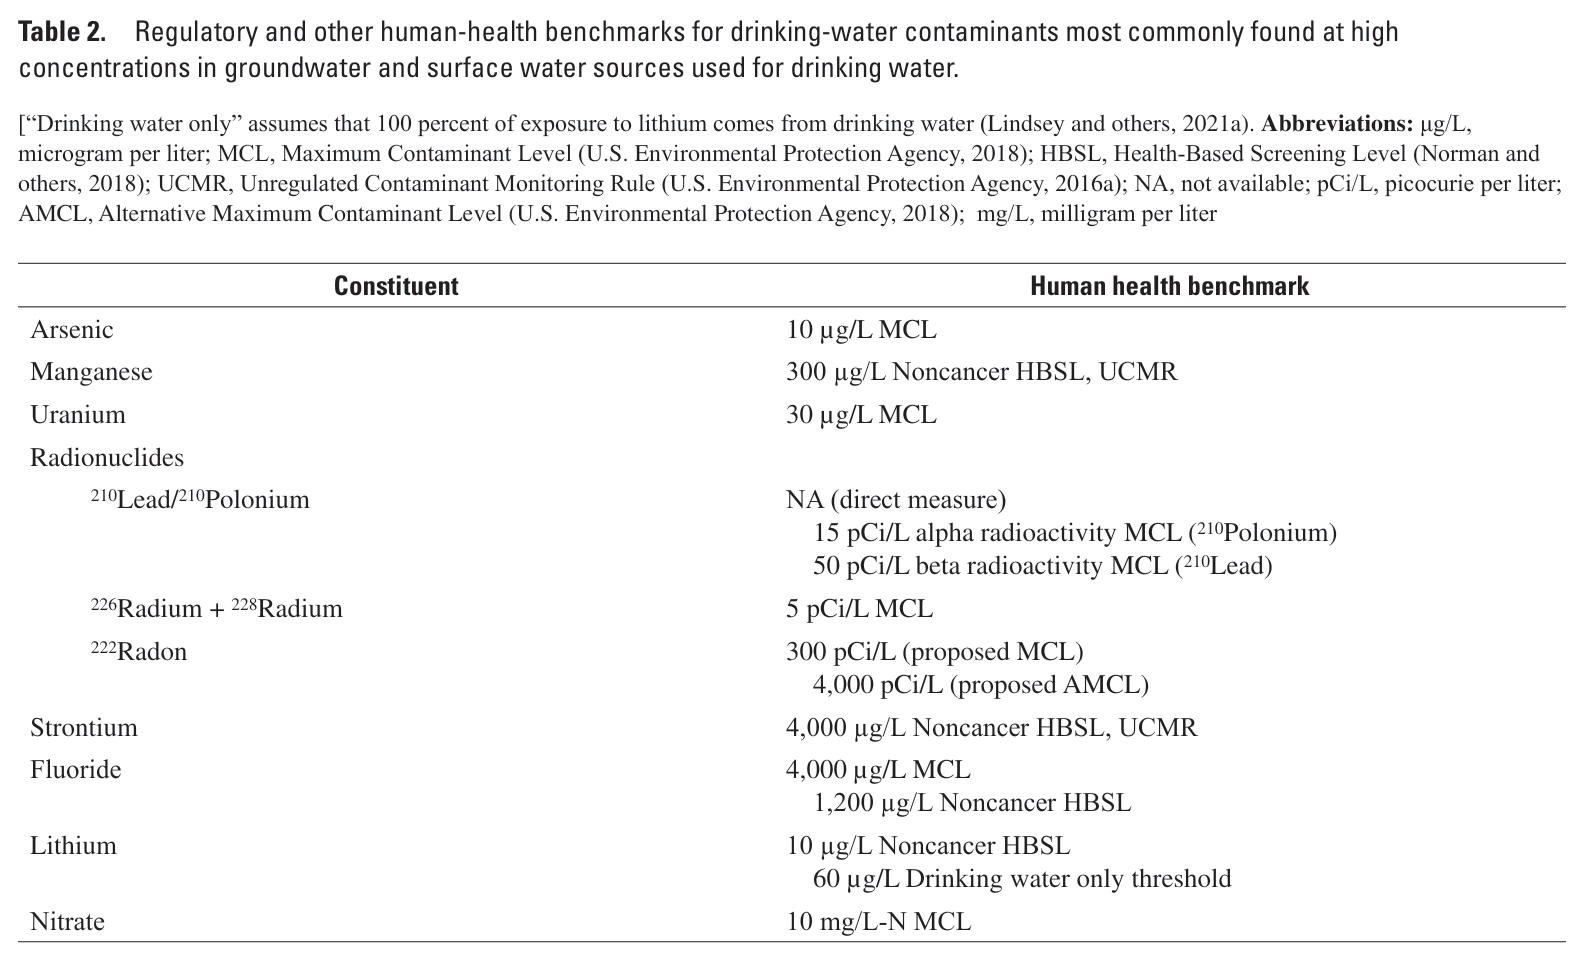
الصفحة المعروضة أدناه مأخوذة من تقرير هيئة المسح الجيولوجي الأمريكية (USGS) المعنون Status of Water-Quality Conditions in the United States, 2010–20. وتحتوي هذه الصفحة على عمودين من النصوص، وعنوان قسم، وجدول مرفق بتعليق توضيحي وملاحظات للاختصارات. هذا المستند حقيقي، وكل صورة معروضة هنا تم تصييرها مباشرة من ملف PDF المنشور. وقد قمنا برسم حدود المناطق يدوياً لتوضيح سير العمل المقترح.
إذا قرأت النص عبر كلا العمودين كما لو كانا فقرة واحدة، فستتجاور جمل لا علاقة لبعضها ببعض. وإذا فصلت الجدول عن ملاحظاته، فستفقد الاختصارات تعريفاتها. وإذا قمت بتسوية صفوفه المتداخلة والمزاحة أفقياً، فقد تضيع العلاقة بين الفئة ومدخلاتها. إن مجرد استخراج قائمة من الكلمات التي تم التعرف عليها بدقة لا يحفظ هذه الفروق البنيوية. يمكنك تحديد المناطق المظللة أدناه لفحص وحدات البكسل الأصلية.
تمثل هذه المسائل عقبات عملية حقيقية للتطبيقات القائمة على المستندات المستخرجة؛ فالبحث يتطلب فقرات ذات حدود متماسكة، وسير العمل المالي يحتاج إلى التمييز بين المجموع الكلي والمجموع الفرعي المجاور له، والمساعد الذكي الذي يجيب عن أسئلة حول ورقة بحثية يحتاج إلى التوضيحات المشروطة في التعليق التوضيحي تماماً كما يحتاج إلى القيم داخل المخطط البياني. بل إن النص المستخرج الذي يبدو متقناً في ظاهره قد يخفي خطأً بنيوياً فادحاً لا يكتشف إلا بعد الاعتماد عليه. وتزداد هذه التحديات تعقيداً في نصوص اللغة العربية، حيث تفرض الطبيعة المتصلة للخط، واتجاه الكتابة من اليمين إلى اليسار، وأشكال الحروف المتغيرة سياقياً، بالإضافة إلى التشكيل والروابط الحرفية (ligatures)، صعوبات جمة تجعل التعرف الضوئي واستخلاص بنية المستند أكثر تعقيداً.
وتتفاقم المشكلة ذاتها عبر المستندات الطويلة؛ إذ قد يبدأ التقرير كملف PDF رقمي، ثم يحتوي على عدة ملاحق ممسوحة ضوئياً، وينتهي بصور فوتوغرافية لنماذج موقعة. ومع أن معالجة كل صفحة بالطريقة نفسها أمر مريح وسهل، إلا أنه لا يتناسب بالضرورة مع طبيعة المحتوى المتنوع. ويهدف Stratify إلى الاحتفاظ بقدر كافٍ من المعلومات حول كل صفحة ومنطقة لإتاحة اتخاذ قرارات معالجة أكثر دقة وملاءمة.
كيف سيعالج Stratify المستندات
يبدأ سير العمل بالصفحة المصدر وينتهي بمستند يمكن تدقيقه وفحصه. ولكل مرحلة غرض محدد وملموس. وقد يغطي أحد المزودين بالفعل عدة مراحل منها في طلب واحد، لذا فهي ليست أربعة استدعاءات إلزامية للنماذج.
تحديد المناطق. فحص صفحات المستند واتجاهها وجودة الصورة والنص المضمن القابل للاستخدام. تحديد مواضع الفقرات والأعمدة والجداول والتعليقات التوضيحية والمناطق الأخرى، مع الحفاظ على مواقعها والعلاقات فيما بينها. يوفر ذلك لبقية مراحل سير العمل خريطة واضحة لما يجب قراءته.
اختيار أدوات القراءة. استخدام المحركات التي ضبطها العميل للمناطق المحددة. فقد يجمع العميل بين أداة كشف التخطيط (layout detector) ونموذج رؤية حاسوبية، أو يحتفظ باستخراج الفقرات من مزود حالي ويختار أداة قراءة مختلفة للجداول. ويجب أن تجعل خطة المعالجة هذه الخيارات وحدودها واضحة ومحددة.
استخراج المحتوى. إعداد مدخلات كل أداة قراءة مختارة بدقة وضوح مناسبة، مع تضمين السياق المجاور حينما يكون مهماً. تشغيل خطوة التعرف، والاحتفاظ بالمخرجات المفيدة المستخرجة مسبقاً، وتسجيل المنطقة المصدر والمحرك اللذين صدرت عنهما كل نتيجة.
إعادة تجميع المستند. استعادة ترتيب القراءة الصحيح، والتوفيق بين القصاصات المتداخلة، وإعادة ربط العناوين والتعليقات التوضيحية والملاحظات والجداول. تقديم نص صالح للاستخدام أو بيانات مهيكلة مع مراجع الإسناد لمصادرها، وتوضيح الفجوات المتبقية في حال كانت المعالجة غير مكتملة.
إذا كان أحد المزودين يرجع بالفعل جدولاً مفيداً متضمناً علاقات الخلايا وإحداثيات الصفحة، فينبغي لـ Stratify الاحتفاظ بتلك المخرجات؛ فتكرار استخراج ناجح يضيف تكلفة دون جدوى واضحة. وتشرح وثائق التطوير السلوك المقترح وحدود التكامل بمزيد من التفصيل.
القراءة المجزأة دون فقدان السياق الكلي
في صفحة USGS المرفقة بالشروحات، يشير الرمزان P1 وP2 إلى عمودي النص الرئيسيين. ويمثل H1 عنواناً، وP3 فقرته التابعة، وC1 التعليق التوضيحي للجدول، وN1 الملاحظات التفسيرية، وT1 الجدول نفسه. هذه المعرّفات وضعت لأغراض تحريرية في هذا المثال. أما في خط المعالجة الفعلي (pipeline)، فسيتولى كاشف التخطيط تزويد النظام بمواقع المناطق وأنواعها المحتملة، مما يمنح الخطوات اللاحقة وسيلة ثابتة للإشارة إلى كل جزء.
يتطلب إعداد المنطقة T1 اتخاذ قرار بشأن السياق؛ فمع أن رؤوس الأعمدة والخلايا تقع ضمن مستطيل واحد، إلا أن تعريفات الاختصارات مثل MCL وHBSL وغيرها تقع أعلاه في المنطقة N1، في حين يوضح التعليق في C1 محتوى الجدول. إن تضمين المناطق الثلاث يمنح القارئ سياقاً أوسع دون الحاجة لإرسال الصفحة بأكملها. يمكنك التبديل بين خيارات العرض في المثال أعلاه لمقارنة القصاصتين، مع بقاء بكسلات المستند الأصلية دون أي تغيير.
يحتاج النظام أيضاً إلى معرفة كيفية ارتباط القصاصة بالمستند الأصلي. فعملية التصيير قد تغير دقة العرض؛ وقد تكون الصفحات مستدارة؛ وقد يحدد المزودون المواقع باستخدام أنظمة إحداثيات متباينة. ولذا، فإن النتيجة المرتبطة فقط بصورة القصاصة النهائية لا تكفي لمستخدم يريد تظليل المنطقة المقابلة في ملف PDF الأصلي؛ بل يجب أن تظل عمليات التحويل تلك قابلة للتتبع بدقة.
وتتسبب القصاصات المتداخلة في مشكلة تجميع أخرى؛ إذ إن تضمين النص المحيط قد يساعد نموذج القراءة على تفسير الجدول، لكن لا ينبغي أن يتكرر هذا النص مرتين في المستند النهائي. فالسياق المرسل إلى النموذج والمحتوى المختار للإخراج النهائي هما قراران مترابطان ولكنهما متمايزان، ويجب على تمثيل المناطق الحفاظ على هذا التمايز.
هناك إخفاقات لا يمكن معالجتها بمجرد إعداد مدخلات مختلفة؛ فتكبير مسح ضوئي رديء لن يعيد رقماً مفقوداً، والصفحة المقتطعة عند حافة الصورة قد تظل غير مكتملة. وفي هذه الحالات، تتمثل النتيجة المفيدة في تقديم إشارة واضحة وصادقة لعدم اليقين وربطها بالمصدر، بدلاً من تخمين قيمة مكتملة بثقة زائفة.
الجمع بين أداة التقسيم ونموذج OCR أو نموذج رؤية حاسوبية
تجيب أداة التقسيم (segmenter) عن تساؤل يتعلق بالتخطيط: أين تقع الأجزاء، وما الأدوار التي تبدو أنها تؤديها؟ في حين يجيب محرك التعرف عن تساؤل حول محتواها. ويتولى بعض المزودين التعامل مع الأمرين معاً، بينما يوفر آخرون أداة مخصصة لكشف التخطيط أو نموذجاً ذا فائدة خاصة لنوع محدد من المدخلات.
سيدعم Stratify توليفات وتركيبات مخصصة وصريحة؛ إذ يمكن للعميل اختيار أداة كشف واحدة ونموذج تعرف واحد لجميع المناطق، أو الاحتفاظ بمخرجات استخراج الفقرات من أحد المزودين مع إرسال جداول أو شروحات محددة إلى قارئ آخر. ويوضح نموذج IRS الفارغ أدناه سبب أهمية طبيعة المدخلات: فحقوق العناوين، وخيارات مربعات الاختيار، وجدول المعالين، وصفوف الدخل المرقمة تمثل هياكل وبنى مختلفة على الصفحة ذاتها.
قد يحافظ قارئ الجداول على عناوين أعمدة المعالين وخلايا الإدخال معاً، في حين يتعين على قارئ النماذج الحفاظ على العلاقة بين مربع الاختيار وتسميته، بينما يمكن لقارئ النصوص معالجة التعليمات الهامشية بشكل منفصل. هذا النموذج فارغ، والنتيجة الدقيقة والأمينة تقتضي الحفاظ على الحقول فارغة بدلاً من اختلاق قيم وهمية. إن مطالبة نموذج لغوي كبير (LLM) بشرح نموذج ما هي عملية مختلفة تماماً عن نسخ محتواه وتفريغه، ويجب أن يوضح سير العمل هذا التمايز بجلاء.
التنسيق هو الجزء الذي نريد لـ OpenOCR تقديمه: إعداد المدخلات، وإرسال كل منها إلى المحرك المحدد، وتسجيل ما تم إنجازه، وإبقاء النتائج مرتبطة بمناطقها المصدرية. ولا ينبغي للعميل أن يضطر لبناء خدمة منفصلة للقص وإعادة البناء لمجرد اختبار أداة تقسيم مع قارئه المفضل.
لا يعني هذا افتراض أن التوليفات المتخصصة ستتفوق دائماً؛ فنموذج المستندات الذي يتلقى الصفحة كاملة قد يستوعب سياقاً تغفله القصاصة، كما قد يتمكن نموذج الرؤية العامة بالفعل من قراءة جدول معين بدقة. ويتعين علينا تقييم التركيبات الفعلية على مدخلات ممثلة للواقع، بما في ذلك الجهد المطلوب لإعدادها وتجميعها.
تقديم مستند قابل للتدقيق والفحص
يجب أن تعود النتائج في هيئة مستند متكامل، لا كمجموعة غير مرتبة من ردود النماذج. ففي مثال USGS، يسبق P1 الرمز P2، ويرتبط H1 بالفقرة P3، ويحتفظ الجدول بروابطه مع تعليقه التوضيحي وملاحظات الاختصارات. وتستمر هذه المعرّفات عبر المراحل لتمكين المستخدم من مقارنة أي جزء مستخرج بالصفحة الأصلية.
ويشكل هذا التمثيل أيضاً الأساس لإعادة المحاولة الانتقائية؛ فلو افترضنا أن الفقرات كانت مقبولة لكن إحدى خلايا الجدول خاطئة، يستطيع المستخدم تحديد T1 واختيار محرك آخر وطلب جولة معالجة جديدة. وسيتطلب استبدالها التوفيق مع المستند المعتمد مع الإبقاء على الفقرات والتعليق والملاحظات المقبولة في أماكنها دون مساس. فلا ينبغي لإعادة المحاولة أن تعيد كتابة محتوى لا علاقة له بشكل خفي.
كما أن الاحتفاظ بسجل تاريخي لهذه القرارات من شأنه المساعدة في تفسير النتيجة: أي المحركات أنتج النسخة الأولى؟ وما المدخلات التي تلقاها المحرك الثاني؟ وهل تضمن الاستبدال قصاصة مختلفة أو سياقاً أوسع؟ هذه أسئلة جوهرية ومفيدة عند المقارنة بين البدائل، أو التحقيق في خطأ ما، أو تقرير ما إذا كانت النتيجة الجديدة جديرة بالثقة الكافية للانتقال إلى الخطوة التالية.
كذلك يجب أن تظل المنطقة التي أخفقت معالجتها مرئية بوضوح؛ فإذا انتهت مهلة المزود أثناء قراءة T1، فقد تظل نتائج الفقرات لدى النظام قابلة للاستخدام. وإرجاع تلك الفقرات كمستند مكتمل من شأنه إخفاء الجزء الناقص. لذا تحتاج النتيجة المخطط لها إلى معلومات اكتمال خاصة بكل منطقة على حدة، حتى يتسنى للتطبيق التمييز بين الاستخراج الجزئي والاستخراج المكتمل، وتحديد ما إذا كان يجب إعادة المحاولة أو طلب المراجعة البشرية.
ما زال مخطط الاستجابة (response schema) الدقيق قيد التصميم. والمهم في هذه المرحلة هو الحفاظ على المعلومات اللازمة لهذه السلوكيات؛ فتسطيح كل شيء مبكراً وتحويله إلى سلسلة نصية واحدة من شأنه أن يجعل عمليات الاستبدال الانتقائي والفحص اللاحق أكثر صعوبة في التطبيق لاحقاً.
البناء على إمكانات مزودي الخدمة
تدعم OpenOCR بالفعل معالجة ملفات PDF الأصلية لدى المزود للمحركات المتوافقة، وتصيير الصفحات للمحركات التي تقبل الصور. كما يقدم بعض المزودين تحليلاً خاصاً بهم للتخطيط أو المستند. وسيعمل Stratify على توسيع هذه الأسس عبر توفير تمثيل مشترك للمناطق والعلاقات عبر مختلف المحركات.
وهناك قدرات متميزة يمكن البناء عليها؛ إذ توثق Mistral OCR مخرجات المستندات المهيكلة بما في ذلك معلومات التخطيط، وتقدم AWS Textract تحليلاً للجداول والنماذج والتخطيط، وتوفر PaddleOCR أداة كشف تخطيط مخصصة تعد مرشحاً مثالياً للاقتران بنموذج تعرف منفصل.
هذه الاستجابات ليست قابلة للتبادل دون تحويل ومعايرة؛ فقد تمثل "الكتلة" (block) لدى أحد المزودين سطراً أو فقرة أو جدولاً، وقد تكون الإحداثيات معيارية أو معبراً عنها بوحدة قياس أخرى. ويمكن أن يحمل الجدول مواضع الخلايا، والخلايا المدمجة، والعلاقات التي قد تختفي إذا اقتصرنا على الاحتفاظ بنصه فقط. ولذا يتعين على التنسيق الموحد الاحتفاظ بهذه الفروق الدقيقة.
لهذا السبب، تتمثل الخطوة الأولى المخطط لها في الحفاظ على البنية المفيدة التي يقدمها المزود. فقبل تقديم جولة تعرف إضافية، نحتاج إلى التأكد مما تحتويه النتيجة الحالية وما إذا كانت قادرة على دعم اختيار المناطق وتجميعها. ولا ينبغي أن يُفهم دعم أحد المزودين في OpenOCR اليوم على أن كل عملية متقدمة يقدمها ذلك المزود باتت متاحة بالفعل.
سيتعين التحقق من المحولات (adapters) ومطابقتها مع العملية المحددة وإصدار النموذج المعني؛ فقائمة المقاطع النصية ليست الشيء ذاته كمجموعة من المناطق المزودة بالإحداثيات. ويجب أن يحدد التكامل ما يمكن تتبعه وصولاً إلى الصفحة الأصلية، وما يمكن إعادة استخدامه، وما يتطلب أداة كشف أو جولة تعرف أخرى.
خطتنا للتقييم
إن وجود خط معالجة أطول يزيد من المواضع التي يمكن أن تحدث فيها الأخطاء؛ فقد تفوت أداة الكشف حاشية سفلية، أو قد يقتطع القص شرطاً توضيحياً، أو قد يكرر التجميع جملة ما. ولذا يتعين أن يراعي التقييم المستند الناتج عن سير العمل بأكمله، وليس مجرد دقة نموذج يعمل على مناطق معزولة.
نخطط لمقارنة توليفات Stratify المقترحة مع المزودين الفرديين على المدخلات نفسها. وتتطلب مجموعة الاختبار مستندات تبرز مشكلات مختلفة: أوراق بحثية متعددة الأعمدة، وجداول كثيفة البيانات، وتعليقات توضيحية بخط صغير، وصفحات تجمع بين النسخ الرقمية والمسح الضوئي، ومعادلات رياضية، وشروحات. كما يجب تمثيل رسالة بسيطة أيضاً، حيث تحتاج المعالجة الإضافية إلى إثبات جدواها في المستندات العادية تماماً كما في المستندات المعقدة.
دقة النص هي مجرد مقياس واحد؛ إذ إن ترتيب القراءة، والمحتوى المفقود، والمناطق المكررة، وعلاقات الجداول أمور بالغة الأهمية أيضاً. فبالنسبة لجدول USGS، فإن التعرف على قيمة مع ربطها بالمكون الخاطئ يظل نتيجة غير صحيحة. وبالنسبة للنموذج الفارغ، فإن تحويل مربع اختيار فارغ إلى إجابة محددة يعد نوعاً آخر من الفشل. وأي مقياس تقييم يغفل هذه العلاقات سيعطي صورة غير مكتملة حول ما إذا كان خط المعالجة قد قدم فائدة حقيقية.
ويندرج الوقت المستغرق والتكلفة الإجمالية ضمن التقييم نفسه؛ فالقصاصة قد تكون صغيرة ولكنها تنطوي على عمليات تصيير، وكشف، وطلب إضافي لمزود الخدمة، وإعادة بناء. ولا تكون إعادة المحاولة الانتقائية مفيدة إلا إذا أثمرت عن نتيجة مقبولة دون تكرار جهد لا داعي له. كما يجب أن تأخذ الخطة في الحسبان محاولات الإعادة التي تبوء بالفشل، بدلاً من الاقتصار على حساب تكلفة الاستدعاء النهائي الناجح فحسب.
لم ننشر بعد نتائج اختبارات الأداء المرجعية (benchmarks) لـ Stratify، أو أسعاره، أو ادعاءات بشأن تحسينات الأداء. كما أن معلومات مستويات الثقة (confidence scores) تحتاج إلى تقييم خاص؛ فالدرجات التي يقدمها مزودون مختلفون قد تصف أشياء متباينة ولا يمكن ببساطة حساب متوسط لها. وإلى أن يتم فهم هذه الإشارات جيداً، تظل المعالجة التي يحددها العميل وإظهار جوانب عدم اليقين نقطة بداية أكثر واقعية ومنطقية من التوجيه التلقائي المعتمد على درجة ثقة مفردة.
من واجهة برمجة التطبيقات (API) إلى منصة العمل (Workbench)
نتوقع أن يكون Stratify خياراً اختيارياً؛ إذ يتمثل نهج واجهة برمجة التطبيقات (API) المستهدف في توفير خيار معالجة إلى جانب المحركات التي يختارها العميل، مع تحكم صريح في التخطيط والتعرف. ولم يتم الانتهاء من صياغة العقد البرمجي بعد، لذا لا توجد اليوم معلمة (parameter) مدعومة لـ Stratify يمكن إضافتها إلى الطلب. كما لا ينبغي للطلبات الحالية أن تتحمل استدعاءات معالجة إضافية لمجرد طرح هذه الإمكانية.
وفي منصة العمل، ستكون أدوات التحكم المفيدة مرتبطة بالمستند ذاته: فحص منطقة تم كشفها، ومعرفة أي المحركات قام بقراءتها، ومقارنة النص المستخرج بالصفحة الأصلية، وطلب جولة معالجة أخرى عند الحاجة. كما أن إظهار الحدود المكتشفة يتيح للمستخدم التمييز بين مشكلة التقسيم ومشكلة التعرف؛ فالنسخ المثالي لقصاصة خاطئة يظل بحاجة إلى تصحيح القصاصة نفسها.
التدرج المخطط له هو الحفاظ على بنية المزود، ودعم التوليفات الصريحة بين المحركات، ثم تقديم أدوات فحص المناطق والتحكم في إعادة المحاولة. أما الاختيار التلقائي للمحرك فهو احتمال وارد في مرحلة لاحقة؛ إذ يتطلب أدلة واضحة حول المواضع التي تكون فيها التوليفة مفيدة، وما تكلفته، وكيف يمكن أن تخفق، قبل أن يتمكن النظام من اتخاذ ذلك القرار بمسؤولية نيابة عن العميل.
وتعد الشفافية بشأن المزودين وحدود التكلفة جزءاً أساسياً من التصميم المقترح؛ إذ ينبغي أن يكون العميل قادراً على معرفة الخدمات التي تستقبل المستند أو القصاصات، وتحديد الأعمال الإضافية المسموح بها. كما يجب أن يظل تغيير قارئ منطقة معينة قرار معالجة واضحاً ومفهوماً، وليس سلسلة غير مفسرة من إجراءات التراجع والحلول البديلة (fallbacks).
ما نريد تعلمه من المستندات المعقدة
تحتاج النسخة الأولى إلى مجموعة ملموسة ومحددة من المشكلات لحلها؛ فالتقرير الذي يفقد ترتيب أعمدته يختلف عن نموذج ممسوح ضوئياً بخط يد باهت، والجدول الممتد عبر ثلاث صفحات يطرح تساؤلات مختلفة عن إيصال من صفحة واحدة. وسيساعدنا الوصف الدقيق لحالات الإخفاق هذه في اختيار حالات التقييم وتحديد أدوات التحكم التي تستحق التطوير أولاً.
إذا كانت مستنداتك تفقد أعمدتها، أو تعليقاتها التوضيحية، أو علاقات جداولها، أو شروحاتها أثناء الاستخراج، فـ تواصل مع OpenOCR مع وصف للمشكلة التي تواجهها. نقطة البداية المفيدة هي السلوك الفعلي: ما توقعت الاحتفاظ به، وما فقده الاستخراج، وما اضطررت إلى إصلاحه بعد ذلك. ولا داعي لافتراض أن توليفة معينة من النماذج هي الحل مسبقاً.
سنحرص على إبقاء وثائق تطوير Stratify متوافقة مع سير العمل المقترح وحدود التكامل مع تبلور المشروع. ويظل Stratify قيد التصميم والتخطيط دون موعد إطلاق معلن؛ فالهدف هو توفير امتداد عملي لـ OpenOCR يمنح العملاء مزيداً من التحكم في المستندات الصعبة ورؤية أوضح لكيفية إنتاج نتائجهم.
*مصادر المستندات: الورقة المهنية لهيئة المسح الجيولوجي الأمريكية (USGS Professional Paper 1894–C)، الإصدار 1.1 (فبراير 2025)، الصفحة المطبوعة 6؛ وIRS 2024 Form 1040، الصفحة 1. الغلاف والقصاصات تعيد إنتاج المستندات المنشورة. وتعد حدود المناطق وعلاقاتها أمثلة موضحة يدوياً، ويستخدم مقتطف النص طبقة النص المضمنة في ملف الـ PDF. ولا يعد أي من هذه الأمثلة كشفاً ناتجاً عن Stratify أو نتيجة لـ OCR أو تقييماً مرجعياً.*