OpenOCR Stratify のご紹介
複雑なドキュメントを処理する際、OCRエンジンには単に文字を認識する以上の能力が求められます。2段組の段落を順序正しく追跡したり、表を再構成したり、手書きの修正箇所を読み取ったり、キャプションをそれが説明する図の横に正しく対応付けたりする必要があるかもしれません。こうした処理は同一ページ内に混在することがあり、ある要素を読み取るための最適なアプローチが、別の要素にも最適であるとは限りません。
私たちは、こうした処理を要素単位で柔軟に行えるよう OpenOCR Stratify を設計しています。Stratifyはドキュメント内の各領域(リージョン)を検出し、ユーザーが選択した適切なリーダー(読み取りエンジン)に送信した上で、元のソースへの参照関係を保ったまま結果を統合します。これにより、読み取りが難しい表に対して、ドキュメント全体を最初からやり直すことなく個別の再処理を実行できるようになります。
「Stratify(層別化・層状に分ける)」という名称はこのアプローチを反映しています。複雑なドキュメントを個別に処理可能な要素へと分割しつつ、それらがどのように結合されているかの追跡を維持します。このワークフローは、領域の検出(find the regions)、リーダーの選択(choose the readers)、コンテンツの抽出(extract the content)、ドキュメントの再構成(reassemble the document) という4つのステップで構成されます。
OpenOCRはすでに、共通APIを通じてユーザーが好みのOCRエンジンを選択できる仕組みを提供しています。Stratifyはこの選択肢を個別の領域単位にまで拡張するものです。なお、共通処理レイヤー、APIオプション、およびワークベンチ操作画面は現在設計・計画段階にあり、現時点では提供されていません。
なぜドキュメント構造が重要なのか
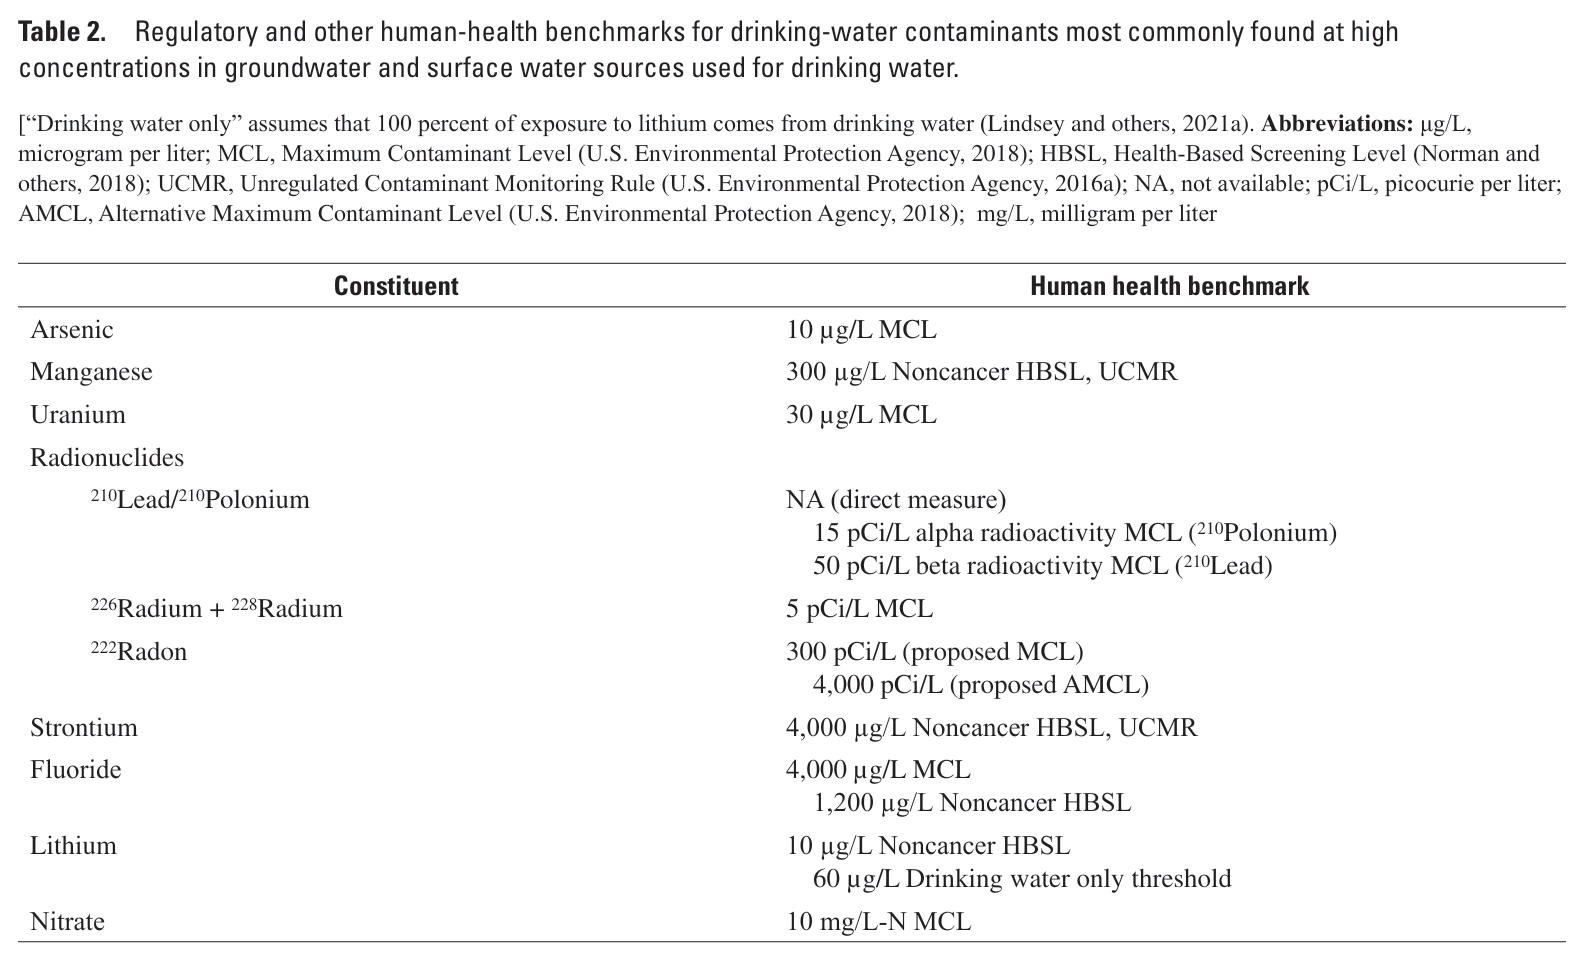
以下のページは、USGS(米国地質調査所)のレポート『Status of Water-Quality Conditions in the United States, 2010–20』からの抜粋です。2段組の本文、セクション見出し、キャプションや略語注記の付いた表が含まれています。これは実在のドキュメントであり、掲載している画像はいずれも公開されているPDFからレンダリングしたものです。提案するワークフローを説明するため、領域の境界線をあらかじめ手動で描画しています。
もし2つの段組を1つの段落であるかのように横断して読み取ってしまえば、無関係な文章同士が隣り合わせになってしまいます。表を注記から切り離せば略語の定義が失われ、インデントされた行を平坦化してしまえばカテゴリとその項目間の従属関係が消えてしまいます。単語をいくら正確に認識してリスト化したところで、こうした構造的な違いを保持することはできません。ハイライトされた領域を選択すると、元のピクセルを確認できます。
これらは、抽出されたドキュメントを基盤とするアプリケーションにとって実務上の切実な問題です。検索機能には意味的にまとまりのある適切な境界を持った文章が必要ですし、財務ワークフローでは合計とすぐ近くにある小計を正確に区別する必要があります。また、論文に関する質問に回答するAIアシスタントには、グラフ内の数値だけでなく、キャプションに記された条件や注釈も必要です。一見するときれいに文字起こしされているように見えても、実際に利用するまで構造的な欠陥が見落とされがちです。また、多くのモデルが英語前提で縦書きレイアウトや膨大な漢字・かな混在を考慮していない現状は、日本語のドキュメントにおいて読み順や構造の破綻という一層深刻な課題をもたらします。
この問題は、ページ数の多い長大なドキュメントになるほどさらに複雑化します。あるレポートは、デジタル生成されたPDFから始まり、スキャンされた複数の付録が含まれ、最後は署名されたフォームの写真で終わるかもしれません。すべてのページを一律に同じ方法で処理するのは手軽ですが、ドキュメントの性質に必ずしも適合するとは限りません。Stratifyは、各ページや領域に関する十分な情報を保持し、より適切な処理の選択を可能にすることを目的としています。
Stratify によるドキュメント処理の流れ
このワークフローは元のソースページから始まり、人間が検証可能なドキュメントの出力で終わります。各ステップには明確な目的があります。なお、1回のリクエストでこれら複数の処理に対応しているプロバイダーも存在するため、これらは必ずしも4回個別のモデル呼び出しを強制するものではありません。
領域の検出(Find the regions):ドキュメントのページ、向き、画質、および利用可能な埋め込みテキストを検査します。段落、段組、表、キャプションなどの各領域を特定し、その位置と関係性を保持します。これにより、後続のワークフローに対して「何を読み取るべきか」を示すマップが提供されます。
リーダーの選択(Choose the readers):特定された各領域に対し、ユーザーが設定したエンジンを適用します。例えば、レイアウト検出器とビジョンモデルを組み合わせたり、既存プロバイダーの段落抽出を利用しつつ表に対しては別のリーダーを選択したりできます。処理プランでは、これらの選択内容と制約事項を明確にしておく必要があります。
コンテンツの抽出(Extract the content):選択された各リーダーへの入力を適切な解像度で準備し、必要に応じて周辺の文脈情報も含めます。認識処理を実行し、すでに得られている有用な抽出結果は保持しつつ、各結果がどのソース領域およびどのエンジンに由来するものかを記録します。
ドキュメントの再構成(Reassemble the document):読み順を復元し、重複する切り出し(クロップ)領域を整合させ、見出し、キャプション、注記、表の結びつきを再構築します。処理が不完全な箇所は空白として明示しつつ、ソースへの参照関係を備えた利用可能なテキストや構造化データを出力します。
もしプロバイダーがセルの関係性やページ座標を含む有用な表をすでに返している場合、Stratifyはその結果を活用すべきです。成功している抽出処理を繰り返すことは、明確な目的もなくコストを増大させるだけです。開発ドキュメントには、提案されている動作や統合の境界についての詳細が記載されています。
全体の一貫性を失わずに部分ごとに読み取る
注釈を付けたUSGSのページにおいて、P1とP2は本文の段組を示しています。H1は見出し、P3はその段落、C1は表のキャプション、N1は説明用の注記、T1は表自体を表します。これらは本例のために便宜上付けた識別子です。実際のパイプラインでは、レイアウト検出器が領域の位置と推測される種別を提供し、後続のステップで各要素を一貫して参照できるようにします。
T1を準備する際には、コンテキスト(文脈)に関する判断が必要です。列ヘッダーとセルは1つの矩形内に収まりますが、MCLやHBSLなどの略語の定義はその上にあるN1に記載されています。また、C1のキャプションは表が何を説明しているかを示しています。これら3つの領域をすべて含めることで、ページ全体を送信することなく、リーダーに対してより多くのコンテキストを提供できます。上記のサンプルを切り替えて両方のクロップを比較してみてください。元となるドキュメントのピクセル自体は変わりません。
システムは、切り出された画像が元のドキュメントとどのように関連しているかを把握しておく必要もあります。レンダリングによって解像度が変わることもあれば、ページが回転していることもあり、プロバイダーごとに異なる座標系で位置を出力することもあります。切り出された最終画像にのみ紐付けられた結果では、元のPDF上の対応する領域をハイライトしたいユーザーにとっては不十分です。そのため、一連の幾何変換は追跡可能である必要があります。
重複したクロップは、再構成時に別の問題を引き起こします。周囲のテキストを含めることはリーダーによる表の解釈を助けますが、そのテキストが最終ドキュメント内に二重に出現してはなりません。モデルに送信する「コンテキスト」と、出力として選択する「コンテンツ」は密接に関連していますが、別個の判断です。領域のデータ表現において、この違いが明確に区別されていなければなりません。
入力の準備方法を工夫するだけでは解決できないエラーもあります。質の悪いスキャン画像を拡大しても欠落した数字は復元できませんし、撮影時に端が見切れてしまったページは不完全なままです。そうしたケースにおいて真に有用な出力とは、自信満々に補完された値ではなく、不確実性を率直に明示し、元のソースへのリンクを提供することです。
セグメンターとOCR/ビジョンモデルの組み合わせ
セグメンター(領域分割器)はレイアウトに関する問いに答えます。すなわち、「どの部分に要素があり、それらはどのような役割を持っているように見えるか」です。一方、認識エンジンはその内容に関する問いに答えます。プロバイダーによっては両方に対応している場合もあれば、専用のレイアウト検出器や、特定の入力に対して強みを持つモデルを提供している場合もあります。
Stratifyは、これらを明示的に組み合わせる構成をサポートします。ユーザーはすべての領域に対して1つの検出器と1つの認識モデルを選択することもできますし、あるプロバイダーによる段落抽出を利用しつつ、特定の表や注釈だけを別のリーダーに送信することも可能です。以下の未記入のIRS(内国歳入庁)フォームを見れば、入力の重要性がよく分かります。住所欄、チェックボックスの選択肢、扶養親族の表、番号付きの所得行など、同一ページ内に異なる構造が混在しています。
表リーダーであれば、扶養親族の列ヘッダーと入力セルを一体として保持できるでしょう。フォームリーダーであれば、チェックボックスとそのラベルとの関係性を維持する必要があります。テキストリーダーなら、余白の指示文を個別に処理できます。なお、このフォームは未記入です。忠実な結果とは、値を勝手に捏造することなく空のフィールドをそのまま保持することです。LLMにフォームの内容を「説明」させることと、その内容を忠実に「文字起こし」することは異なる処理であり、ワークフローにおいてこの違いを明確にしておく必要があります。
この統合調整こそが、OpenOCRが提供を目指す部分です。すなわち、入力の準備、設定された各エンジンへの振り分け、完了した処理の記録、そして抽出結果とソース領域との紐付けの維持です。ユーザーは、好みのリーダーでセグメンターをテストしたいというだけの目的で、切り出しや再構成のための独自サービスを別途構築する必要がなくなります。
もちろん、特殊な組み合わせが常に優れていると想定しているわけではありません。ページ全体を入力として受け取るドキュメントモデルは、個別の切り出しでは失われてしまう文脈を理解できる場合があります。また、汎用のビジョンモデルが特定の表をすでに高い精度で読み取れることもあります。そのため、入力の準備や結果の再構成に要する処理も含めて、代表的な入力サンプルを用いて実際の組み合わせを評価する必要があります。
検証可能なドキュメントの出力
処理結果は、順序のないモデルのレスポンスの寄せ集めではなく、1つのドキュメントとして返される必要があります。USGSの例では、P1はP2の前に位置し、H1はP3と対になり、表はキャプションや略語注記へのリンクを維持します。こうした識別子が引き継がれることで、ユーザーは抽出された任意の部分と元のページとを照らし合わせて確認できます。
このような表現形式は、選択的な再試行(リトライ)を行うための基盤でもあります。例えば、段落の読み取り結果には問題がないものの、表の1つのセルに誤りがあったとします。ユーザーはT1を選択し、別のエンジンを指定して再処理をリクエストできます。その際、確定済みの段落、キャプション、注記には手を加えず、差し替えられた新しい結果のみをドキュメントと整合させる必要があります。再試行によって無関係なコンテンツが勝手に書き換えられてはなりません。
そうした判断の履歴を保持することは、結果の説明性を高める上でも有用です。「最初のバージョンを出力したのはどのエンジンか?」「2番目のエンジンにはどのような入力が渡されたか?」「差し替えの際、異なるクロップ範囲やより広いコンテキストが含まれていたか?」といった情報は、代替案を比較したり、エラーを調査したり、新しい結果が次のステップに進めるほど信頼できるかを判断したりする際に不可欠な問いとなります。
処理に失敗した領域も可視化されたままである必要があります。もしプロバイダーがT1の読み取り中にタイムアウトした場合でも、システムには利用可能な段落の処理結果が残っている可能性があります。それらを完全なドキュメントとして返してしまうと、処理が抜け落ちている事実が隠蔽されてしまいます。計画されている仕様では領域ごとの完了情報が含まれるため、アプリケーションは部分的な抽出結果と完全な抽出結果を識別し、再試行を行うか人間のレビューを求めるかを判断できます。
レスポンススキーマの詳細は現在も設計中です。現段階で重要なのは、こうした動作を実現するために必要な情報を保持しておくことです。早い段階ですべてを単一のテキスト文字列へと平坦化してしまうと、後から選択的な差し替えや検証機能を導入することが極めて難しくなってしまいます。
プロバイダーの機能を活用する
OpenOCRはすでに、対応エンジン向けのプロバイダーネイティブなPDF処理や、画像を受け付けるエンジン向けのページレンダリングをサポートしています。また、一部のプロバイダーは独自のレイアウト解析やドキュメント分析結果を返します。Stratifyはこれらの基盤を拡張し、異なるエンジン間でも領域とその関係性を扱える共通のデータ表現を提供します。
活用できる既存の優れた機能は数多く存在します。Mistral OCR はレイアウト情報を含む構造化ドキュメント出力を提供しています。AWS Textract は表、フォーム、レイアウトの高度な分析機能を備えています。PaddleOCR は、独立した認識モデルとの組み合わせに適した専用のレイアウト検出器を提供しています。
ただし、これらのレスポンスは変換なしに相互互換性を持つわけではありません。あるプロバイダーの「ブロック」は1行を指すこともあれば、段落や表全体を指すこともあります。座標系も正規化されている場合や別の単位で表されている場合があります。表にはセルの位置、結合セル、各種関係性が含まれていますが、テキストのみを抽出した場合にはこれらはすべて失われてしまいます。共通フォーマットでは、こうした違いを損なわずに保持する必要があります。
だからこそ、最初の計画ステップとしてプロバイダーの有用な構造情報を維持することに注力しています。別の認識パスを導入する前に、既存の結果に何が含まれており、それらが領域の選択や再構成に対応できるかを確定させる必要があります。なお、現在OpenOCRでサポートされているプロバイダーであっても、そのプロバイダーのすべての高度な機能がすでに公開されているわけではない点にご留意ください。
アダプターについては、該当する操作やモデルのバージョンごとに検証を行う必要があります。テキストのチャンクのリストと、座標情報を伴う領域の集合は全くの別物です。今回の統合においては、ページ上のどこまでを追跡でき、何を再利用でき、何に対して別の検出器や認識パスが必要になるのかを明確にする必要があります。
今後の評価計画
パイプラインが長くなれば、それだけエラーが発生しうる箇所も増えます。検出器が脚注を見落とすかもしれませんし、クロップによって前提条件となる文脈が削られるかもしれません。また、再構成時に同一の文が重複してしまう可能性もあります。そのため評価にあたっては、孤立した領域における単一モデルの精度だけでなく、ワークフロー全体から出力される最終ドキュメントを評価対象とする必要があります。
私たちは、同一の入力を用いて、提案するStratifyの組み合わせと個別のプロバイダー単体とを比較検証する予定です。テストデータセットには、段組のある論文、密度の高い表、小さなキャプション、デジタル生成ページとスキャン画像が混在したドキュメント、数式、注釈など、多様な課題を含むドキュメントが必要です。また、追加の処理ステップが難解なドキュメントだけでなく一般的なドキュメントにおいても有効であるかを証明するため、単純な書状などもデータセットに含める必要があります。
テキスト認識の精度は指標の1つに過ぎません。読み順、コンテンツの欠落、領域の重複、表の関係性なども同様に極めて重要です。USGSの表を例にとると、数値を正しく認識できていても、それが誤った成分項目に紐付けられていれば誤りであることに変わりありません。また、未記入のフォームにおいて、空のチェックボックスを選択済みの回答として処理してしまうのも重大なエラーです。そうした関係性を見落としたスコアリングでは、パイプラインが真に有効であったかどうかを正しく評価することはできません。
処理時間と総コストも同じ評価軸で考慮すべき要素です。たとえ切り出された画像が小さくても、レンダリング、検出、別のプロバイダーへのリクエスト、そして再構成といった処理が発生します。選択的な再試行は、不必要な重複作業を避けつつ許容可能な結果が得られて初めて価値を持ちます。成功した最終リクエストのコストだけを報告するのではなく、失敗した再試行にかかるコストも考慮に入れた計画でなければなりません。
現在、Stratifyのベンチマーク結果、価格設定、パフォーマンス向上に関する公式な発表は行っていません。信頼度スコアについても個別の評価が必要です。プロバイダーごとに返されるスコアの定義や基準は異なっており、単純に平均化することはできないからです。そうしたシグナルの性質が十分に解明されるまでは、単一のスコアに基づく自動ルーティングよりも、ユーザー自身が処理を選択でき、不確実性が可視化されている状態を提供する方が、はるかに堅実な出発点であると考えています。
API からワークベンチへ
Stratifyはオプション機能として提供される予定です。想定しているAPIのアプローチは、ユーザーが選択したエンジンと並んで、レイアウト解析や文字認識を明示的に制御できる処理オプションとしての提供です。API仕様はまだ確定していないため、現時点でリクエストに追加可能なStratifyパラメータは存在しません。本機能が導入されたからといって、既存のリクエストに意図しない追加の処理呼び出しが発生することはありません。
ワークベンチ(GUI環境)においては、ドキュメントそのものに紐付いた操作体系が有用となります。検出された領域の確認、どのエンジンが読み取ったかの表示、抽出結果と元のページとの比較、そして必要に応じた再処理のリクエストなどです。検出された境界線を表示することで、ユーザーはそれがセグメンテーション(領域分割)の問題なのか、認識自体の問題なのかを判別できるようになります。誤った切り出し領域に対していくら完璧な文字起こしが行われたとしても、切り出し自体を修正しなければならないことに変わりはありません。
段階的な展開として、まずはプロバイダーの構造情報の保持、エンジンの明示的な組み合わせのサポートを進め、その後に領域の検証や再試行コントロールを導入していく予定です。エンジンの自動選択は将来的な可能性として検討しています。システムがユーザーに代わって責任を持って判断を下せるようになるには、どのような組み合わせが効果的か、コストはどの程度か、どのような失敗パターンがあるかについての十分な検証データが必要です。
プロバイダーの可視性とコスト上限の設定も、提案されている設計の一部です。ユーザーは、どのサービスにドキュメントや切り出し画像が送信され、どのような追加処理が許可されているかを明確に把握できる必要があります。特定の領域に対するリーダーの変更は、理由の分からないフォールバックの連鎖ではなく、納得のいく明確な処理判断であり続けるべきです。
複雑なドキュメントから私たちが学びたいこと
最初のバージョンには、解決すべき具体的な課題の選定が必要です。段組の順序が崩れてしまうレポートと、薄い手書き文字が含まれるスキャンフォームとでは課題が異なります。3ページにまたがる表と、1ページのレシートとでも直面する論点は異なります。そうした失敗事例を正確に記述していただくことが、評価ケースの選定や、優先して開発すべき操作機能の決定に役立ちます。
もしお使いのドキュメントで、抽出処理中に段組、キャプション、表の関係性、注釈などが失われてしまう場合は、具体的な問題の内容を添えて OpenOCR にお問い合わせ ください。重要な出発点は実際の挙動です。何を保持したかったのか、抽出時に何が失われたのか、事後にどのような手動修正が必要となったのかをお知らせください。特定のモデルの組み合わせがあらかじめ正解であると仮定する必要はありません。
開発の進展に伴い、Stratify 開発ドキュメント を更新し、提案されたワークフローや統合の境界を最新の状態に保ちます。Stratifyは現在も設計・計画段階にあり、リリース日は未定です。私たちの目標は、難解なドキュメントに対する制御性を高め、処理結果がどのように生成されたかをより明確に把握できるようにする、OpenOCRの実用的な拡張機能を提供することです。
ドキュメントの出典:USGS Professional Paper 1894–C, version 1.1(2025年2月発行)6ページ、および IRS 2024 Form 1040 1ページ。表紙および切り出し画像は公開されているドキュメントを再現したものです。領域の境界および関係性は手動で付与したサンプルの注釈です。テキストの抜粋にはPDFの埋め込みテキストレイヤーを使用しています。これらの例はいずれもStratifyによる検出、OCRの認識結果、またはベンチマークではありません。