Apresentando o OpenOCR Stratify
Um documento complexo exige de um mecanismo de OCR muito mais do que o mero reconhecimento de palavras. Pode ser necessário acompanhar duas colunas, reconstruir uma tabela, ler uma correção manuscrita e manter a legenda junto à figura que ela descreve. Essas demandas podem coexistir na mesma página, e o método ideal para ler uma parte pode ser bem diferente do mais indicado para a seguinte.
Estamos projetando o OpenOCR Stratify para lidar com esse trabalho em etapas. A proposta do Stratify é identificar as regiões de um documento, enviá-las aos leitores selecionados pelo cliente e reunir os resultados mantendo intactas as referências de origem. Dessa forma, uma tabela difícil pode passar por uma nova leitura sem que seja preciso reprocessar o documento inteiro.
O nome reflete essa abordagem: separar um documento complexo em partes tratadas individualmente, preservando o mapeamento de como elas se articulam no todo. O fluxo de trabalho é estruturado em quatro etapas: localizar as regiões, escolher os leitores, extrair o conteúdo e remontar o documento.
O OpenOCR já permite aos clientes selecionar um mecanismo de OCR por meio de uma API unificada. O Stratify estende essa flexibilidade para regiões individuais. A camada de processamento compartilhado, os parâmetros de API e os controles do workbench estão atualmente em fase de design e planejamento, não estando disponíveis no momento.
Por que a estrutura do documento importa
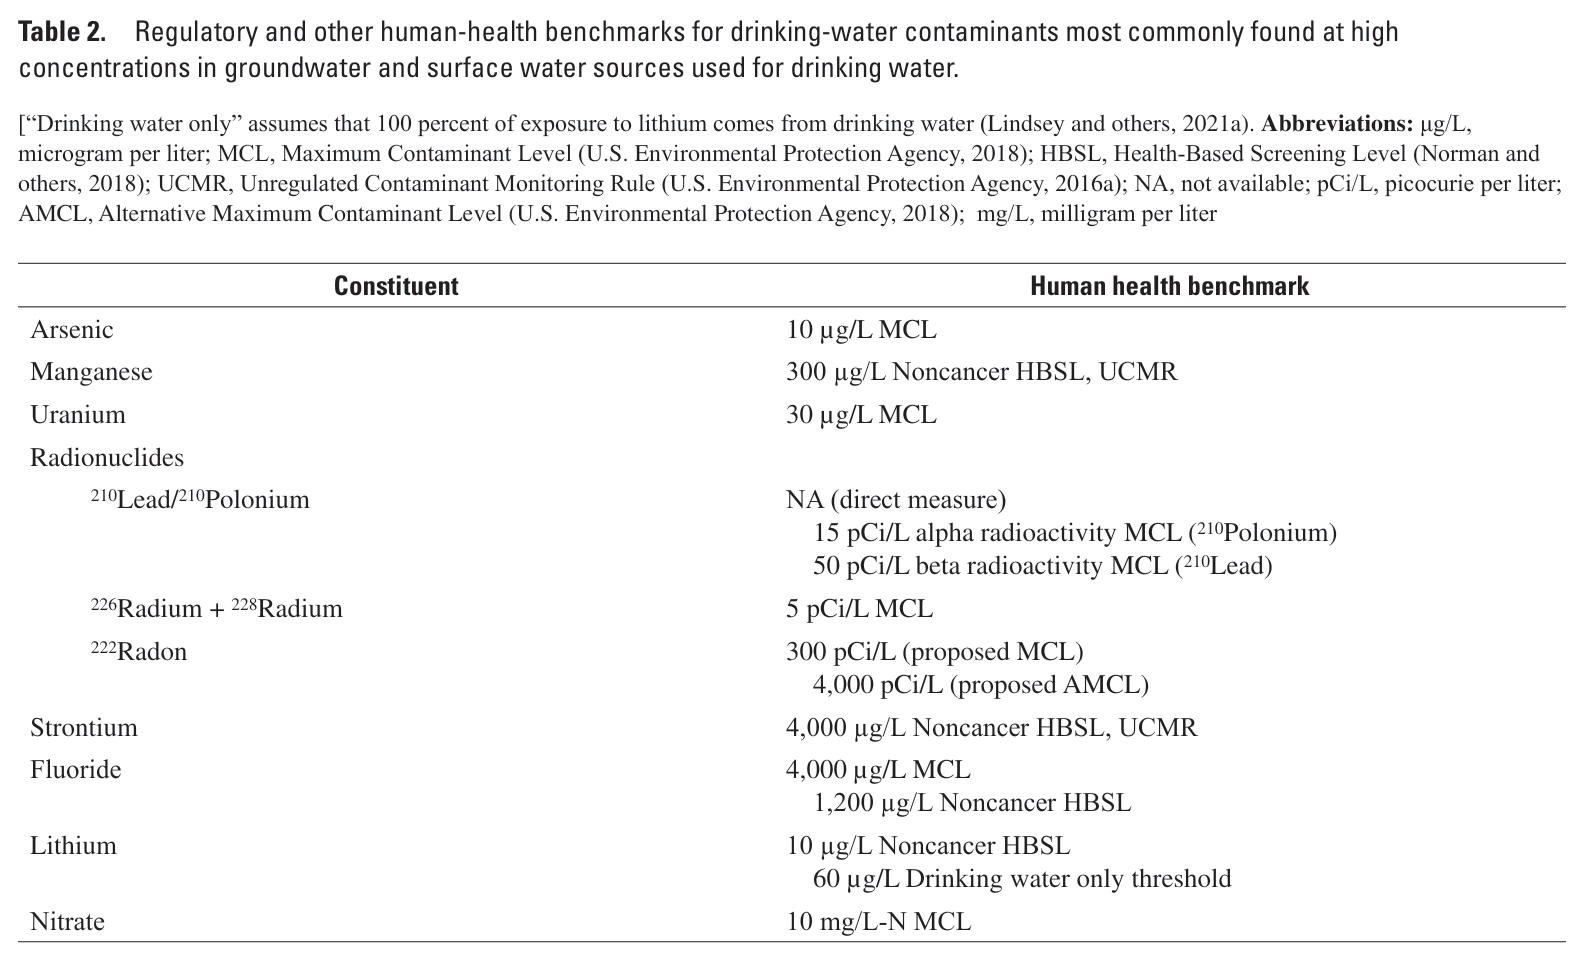
A página abaixo foi extraída do relatório do USGS Status of Water-Quality Conditions in the United States, 2010–20. Ela apresenta duas colunas de texto, um título de seção e uma tabela com legenda e notas de abreviação. O documento é real: cada imagem aqui foi renderizada a partir do PDF publicado. Desenhamos as caixas delimitadoras manualmente para ilustrar a proposta do fluxo de trabalho.
Se as duas colunas forem lidas horizontalmente como se fossem um único parágrafo, frases desconexas tornam-se vizinhas imediatas. Se a tabela for dissociada de suas notas, as abreviações perdem o significado. Se suas linhas recuadas forem achatadas, a hierarquia entre uma categoria e seus itens desaparece. Uma simples lista de palavras reconhecidas com precisão não preserva essas nuances. Selecione as regiões destacadas abaixo para inspecionar os pixels originais.
Esses são gargalos práticos para aplicações construídas com base na extração de documentos. Sistemas de busca dependem de passagens com limites semânticos coerentes. Um fluxo de trabalho financeiro precisa diferenciar um total geral de um subtotal próximo. Um assistente projetado para responder a dúvidas sobre um artigo científico precisa tanto das ressalvas contidas em uma legenda quanto dos dados numéricos de um gráfico. Uma transcrição de aparência limpa pode ocultar falhas estruturais graves até que alguém tome uma decisão baseada nela.
Esse desafio se amplia progressivamente em documentos extensos. Um relatório pode começar como um PDF digital, incluir apêndices digitalizados e terminar com fotografias de formulários assinados. Processar todas as páginas de maneira idêntica é prático, mas raramente se ajusta à diversidade do material. O Stratify foi concebido para reter dados suficientes sobre cada página e região, viabilizando decisões mais deliberadas e assertivas.
Como o Stratify processaria um documento
O fluxo tem início na página de origem e culmina em um documento plenamente inspecionável. Cada etapa cumpre um papel bem delineado. Como determinados provedores já abrangem várias dessas funções em uma única requisição, não se trata de quatro chamadas de modelo compulsórias.
Localizar as regiões. Inspeciona as páginas, a orientação, a qualidade de imagem e o texto embutido utilizável do documento. Identifica parágrafos, colunas, tabelas, legendas e demais regiões, preservando suas posições e relacionamentos espaciais. Isso oferece ao restante do pipeline um mapa estruturado do que precisa ser lido.
Escolher os leitores. Aplica os mecanismos configurados pelo cliente para as regiões identificadas. É possível combinar um detector de layout com um modelo multimodal de visão, ou manter a extração de parágrafos de um provedor já existente e destinar um leitor específico para as tabelas. O plano de processamento explicita essas definições e suas respectivas restrições.
Extrair o conteúdo. Prepara a entrada de cada leitor selecionado na resolução apropriada, incluindo o contexto circundante quando pertinente. Executa o reconhecimento, preserva extrações prévias satisfatórias e registra a região de origem e o mecanismo responsável por cada resultado.
Remontar o documento. Restabelece a ordem correta de leitura, concilia recortes sobrepostos e reconecta títulos, legendas, notas e tabelas. Entrega o texto formatado ou dados estruturados acompanhados de referências de origem, sinalizando com clareza lacunas em casos de processamento incompleto.
Se um provedor já entrega uma tabela íntegra, com relações celulares e coordenadas na página preservadas, o Stratify mantém esse resultado. Reprocessar uma extração já bem-sucedida apenas encarece o pipeline sem agregar valor. A documentação de desenvolvimento detalha as fronteiras de integração e o comportamento previsto.
Lendo em partes sem perder o todo
Na página anotada do USGS, P1 e P2 indicam as colunas principais de texto. H1 corresponde a um título, P3 ao seu parágrafo, C1 à legenda da tabela, N1 às notas explicativas e T1 à tabela propriamente dita. Trata-se de identificadores editoriais adotados para este exemplo. Em um pipeline funcional, o detector de layout forneceria as coordenadas e os prováveis tipos de região, servindo de base estável para as etapas subsequentes.
A preparação de T1 exige uma definição criteriosa de contexto. Seus cabeçalhos e células cabem em um retângulo único, mas as definições de siglas como MCL, HBSL e outras encontram-se logo acima, em N1. A legenda em C1 define o tema abordado pela tabela. Incluir essas três regiões fornece ao leitor um contexto muito mais rico sem obrigar o envio da página inteira. Alterne o exemplo acima para comparar os dois recortes; os pixels originais do documento permanecem inalterados.
O sistema precisa, da mesma forma, mapear a relação de cada recorte com o documento original. A renderização pode modificar a resolução, páginas podem sofrer rotação e diferentes provedores utilizam sistemas de coordenadas próprios. Um resultado atrelado unicamente à imagem recortada final é insuficiente para quem precisa destacar a área correspondente no PDF original. Essa cadeia de transformações precisa se manter rastreável.
Recortes com sobreposição trazem um desafio adicional na remontagem. Incluir texto adjacente pode auxiliar o leitor na interpretação de uma tabela, mas esse texto não pode ser duplicado no documento final. O contexto enviado a um modelo e o conteúdo destinado ao documento consolidado são decisões relacionadas, mas distintas. A modelagem das regiões deve preservar essa separação.
Há falhas que não se corrigem apenas refinando a entrada. Aumentar o tamanho de uma digitalização em baixa resolução não recupera um número ilegível. Uma página cortada na extremidade de uma foto pode permanecer irremediavelmente truncada. Nesses cenários, a saída mais transparente é apontar a incerteza e disponibilizar um link para a fonte, em vez de inferir valores com falsa precisão.
Combinando um segmentador com um modelo de OCR ou de visão
O segmentador atua sobre a estrutura e o layout: onde estão os componentes e qual papel desempenham? O mecanismo de reconhecimento, por sua vez, atua sobre o conteúdo. Determinados provedores realizam ambas as tarefas; outros fornecem detectores dedicados de layout ou modelos otimizados para padrões específicos de entrada.
O Stratify dará suporte a essas composições de forma explícita. O cliente poderá adotar um único detector e um mesmo modelo de reconhecimento para todas as áreas, ou manter a extração de parágrafos de um provedor enquanto direciona tabelas ou anotações para leitores especializados. O formulário em branco da IRS reproduzido abaixo exemplifica essa necessidade: campos de endereço, caixas de marcação, uma tabela de dependentes e linhas numeradas de rendimentos formam estruturas radicalmente distintas dentro de uma única página.
Um leitor de tabelas pode preservar os cabeçalhos de coluna e as células de dependentes de maneira integrada. Um leitor de formulários precisa vincular com precisão cada caixa de seleção ao seu respectivo rótulo. Um leitor textual pode tratar instruções de margem de modo independente. Como este formulário está em branco, um resultado fiel mantém os campos vazios em vez de criar dados fictícios. Solicitar a um LLM que interprete um formulário difere substancialmente de transcrever seu conteúdo — e o fluxo de trabalho deve deixar essa distinção evidente.
A coordenação desse fluxo é exatamente a lacuna que o OpenOCR pretende preencher: preparar entradas, despachá-las para os motores configurados, registrar etapas concluídas e manter os dados vinculados às suas coordenadas de origem. O cliente não deveria ter de implementar serviços próprios de recorte e remontagem apenas para avaliar um segmentador em conjunto com seu leitor de preferência.
Isso não implica que abordagens especializadas superem sempre as soluções integradas. Um modelo de documento que analisa a página por inteiro pode absorver um contexto que um recorte isolado descarta. Um modelo geral de visão computacional pode ser plenamente capaz de ler com exatidão uma tabela específica. É indispensável testar as combinações em entradas reais, mensurando também o custo de preparação e recomposição dos fragmentos.
Retornando um documento que você pode inspecionar
O retorno do pipeline precisa ser estruturado como um documento coerente, e não como uma coleção dispersa de saídas de modelos. No exemplo do USGS, P1 precede P2, H1 associa-se a P3 e a tabela mantém seus vínculos com a legenda e com as notas de rodapé. Os identificadores percorrem todo o fluxo para que o usuário consiga auditar qualquer trecho extraído diretamente contra a página original.
Essa estrutura viabiliza repetições seletivas (retries). Se os parágrafos estiverem corretos, mas uma célula da tabela contiver um erro, o usuário poderá selecionar T1, optar por outro mecanismo e executar uma nova extração. A substituição será então reconciliada com o documento consolidado, sem alterar os parágrafos, legendas e notas já validados. Uma repetição seletiva não deve sobrescrever conteúdos adjacentes de maneira silenciosa.
Armazenar o histórico dessa decisão torna o resultado auditável: qual mecanismo produziu a primeira versão? Que dados foram fornecidos ao segundo? A substituição envolveu um recorte alternativo ou uma área maior de contexto? Esses registros são fundamentais para comparar abordagens, diagnosticar falhas ou verificar se uma saída atende aos requisitos de confiabilidade das etapas seguintes.
Falhas pontuais em regiões específicas também devem permanecer visíveis. Se houver timeout em T1 durante o processamento por um provedor, o sistema ainda poderá aproveitar os parágrafos lidos com sucesso. Entregar esse material como se estivesse completo mascararia a ausência de parte dos dados. A resposta planejada fornecerá o status de conclusão por região, permitindo que a aplicação distinga uma extração parcial de uma finalizada e decida entre acionar uma repetição ou encaminhar o caso para revisão manual.
O schema final de resposta continua em definição. A prioridade nesta fase é assegurar a retenção dos metadados essenciais para viabilizar esses comportamentos. Concatenar precocemente o conteúdo em uma string linear inviabilizaria auditorias detalhadas e correções seletivas no futuro.
Aproveitando os recursos dos provedores
O OpenOCR já suporta o processamento nativo de PDFs para ferramentas compatíveis e renderização prévia em imagens para mecanismos que exigem esse formato. Alguns provedores fornecem nativamente análises de documento e de layout. O Stratify aproveitará essa base ao instituir um modelo comum de representação de regiões e dependências entre diferentes motores.
Há tecnologias consolidadas nesse ecossistema: o Mistral OCR oferece saídas estruturadas com mapeamento de layout; o AWS Textract destaca-se na análise de tabelas, formulários e diagramação; e o PaddleOCR disponibiliza um detector de layout dedicado com grande potencial para integração com modelos externos de reconhecimento.
Contudo, essas respostas não são intercambiáveis sem padronização. O conceito de "bloco" em um provedor pode significar uma linha, um parágrafo ou uma tabela completa. As coordenadas podem vir normalizadas ou em unidades absolutas. Tabelas frequentemente trazem coordenadas de células, junções e hierarquias que se perderiam caso apenas o texto plano fosse preservado. O modelo unificado precisa preservar essas particularidades.
Por isso, o marco inicial do projeto foca em reter a estrutura útil fornecida por cada motor. Antes de introduzir novas etapas de reconhecimento, é necessário mapear o que o resultado original entrega e se ele atende aos requisitos de segmentação e remontagem. O suporte a um provedor no OpenOCR hoje não pressupõe que todas as suas funções avançadas estejam automaticamente disponíveis.
Cada adaptador precisará ser validado conforme a operação e a versão do modelo empregado. Uma sequência linear de blocos de texto não equivale a um conjunto ordenado de regiões com coordenadas espaciais. A integração precisa estabelecer com clareza o que pode ser referenciado na página, o que pode ser reaproveitado e em quais pontos será necessário acionar um novo detector ou leitor.
Como planejamos avaliar isso
Pipelines mais extensos ampliam os pontos potenciais de falha. Um detector pode omitir uma nota, o recorte pode excluir termos essenciais e a etapa de montagem pode duplicar orações. A avaliação não pode se restringir à acurácia de modelos em regiões isoladas; ela deve analisar a qualidade do documento gerado ao término de todo o processo.
Prevemos comparar as composições do Stratify diretamente com provedores individuais executados sobre as mesmas entradas. A base de testes precisa contemplar desafios reais: artigos diagramados em colunas, tabelas compactas, legendas reduzidas, documentos híbridos digitais e digitalizados, fórmulas e anotações marginais. Uma carta simples também deve fazer parte da amostragem, garantindo que o custo computacional adicional compense tanto em casos triviais quanto em cenários complexos.
A acurácia do texto é apenas um dos critérios. Ordem de leitura, ausência de dados, duplicações de blocos e coerência relacional em tabelas são métricas igualmente determinantes. Na tabela do USGS, transcrever um valor corretamente, mas associá-lo ao parâmetro incorreto, constitui uma falha. No formulário em branco, interpretar uma caixa vazia como marcada representa outro erro crítico. Índices que desconsiderem esses vínculos estruturais transmitem uma percepção distorcida sobre o ganho real do pipeline.
Tempo de resposta e custo operacional entram na mesma equação. Um recorte diminuto pode demandar renderização, detecção, chamada externa de API e reconciliação estrutural. Repetições seletivas só se justificam se entregarem um resultado aceitável sem redundâncias desnecessárias. A metodologia deve considerar inclusive o impacto de retentativas malsucedidas, em vez de contabilizar somente o custo da chamada final aprovada.
Não divulgamos até o momento benchmarks, precificação ou estimativas fechadas de ganhos de desempenho para o Stratify. Métricas de confiança também exigem critérios cuidadosos: índices informados por provedores distintos medem aspectos diferentes e não devem ser combinados por simples média aritmética. Até que essas variáveis sejam totalmente dominadas, conceder controle ao cliente e sinalizar incertezas com transparência constituem uma abordagem muito mais sólida do que roteamentos automáticos baseados em pontuações isoladas.
Da API ao workbench
O Stratify foi idealizado como um recurso opcional. A interface de API pretendida funcionará como uma camada de configuração de processamento paralela à escolha dos motores pelo cliente, oferecendo gestão explícita sobre detecção de layout e reconhecimento. O contrato técnico ainda está em definição e nenhum parâmetro do Stratify está ativo para requisições em produção. Chamadas existentes não sofrerão cobranças ou etapas extras de processamento em decorrência do lançamento dessa capacidade.
No workbench, as ferramentas de controle estarão conectadas visualmente ao próprio documento: inspecionar uma região localizada, identificar o mecanismo que realizou a leitura, comparar a extração com a imagem da página e solicitar reprocessamento pontual onde preciso. A visualização das caixas delimitadoras permitirá ainda distinguir falhas de segmentação de falhas no OCR. Uma transcrição perfeita feita sobre um recorte equivocado continua demandando a retificação do recorte.
A sequência planejada prevê consolidar a estrutura dos provedores, habilitar combinações manuais de motores e, progressivamente, liberar os controles de inspeção e reprocessamento no workbench. O roteamento automatizado de mecanismos poderá ser considerado no futuro, mas sua adoção dependerá de dados concretos que demonstrem onde uma combinação agrega valor, qual é seu custo efetivo e quais são suas taxas de falha, viabilizando decisões autônomas seguras em nome do usuário.
Transparência no consumo e limites orçamentários rígidos integram a concepção do produto. O cliente deve ter plena visibilidade de quais serviços recebem seus documentos ou recortes e quais etapas adicionais estão autorizadas a rodar. Substituir o leitor de uma área específica deve ser uma escolha clara e compreensível, sem depender de sequências opacas de fallbacks.
O que queremos aprender com documentos difíceis
A primeira versão precisa focar em problemas concretos. Um relatório cuja ordem de colunas é corrompida demanda abordagens distintas de um formulário com anotações manuais fracas. Uma tabela que se desdobra por três páginas exige soluções diferentes de um comprovante fiscal de página única. O mapeamento detalhado desses gargalos direcionará os cenários de teste e a priorização dos recursos no roadmap.
Se os seus documentos costumam perder o fluxo de leitura, legendas, vínculos de tabelas ou anotações durante a extração, entre em contato com o OpenOCR detalhando o cenário. O ponto de partida ideal é o relato do comportamento observado: quais dados deveriam ser mantidos, o que foi corrompido e quais correções manuais foram necessárias. Não é preciso antecipar qual modelo ou arquitetura resolveria o problema.
Acompanharemos a evolução do fluxo e os limites de integração na documentação de desenvolvimento do Stratify. O Stratify segue em estágio de concepção e planejamento, sem data definida para lançamento público. Nossa meta é entregar uma extensão prática para o ecossistema OpenOCR que proporcione aos clientes maior controle sobre documentos desafiadores e ampla rastreabilidade sobre a geração de seus resultados.
Fontes dos documentos: USGS Professional Paper 1894–C, versão 1.1 (fevereiro de 2025), página impressa 6; e o IRS 2024 Form 1040, página 1. A capa e os recortes reproduzem fielmente os documentos originais. As caixas de delimitação e os relacionamentos entre áreas são anotações manuais para fins didáticos. O excerto de texto utiliza a camada textual original do PDF. Nenhum desses exemplos corresponde a detecções, resultados de OCR ou benchmarks oficiais do Stratify.