Presentamos OpenOCR Stratify
Un documento complejo exige a un motor de OCR mucho más que reconocer palabras. Puede requerir seguir dos columnas, reconstruir una tabla, leer una corrección manuscrita y mantener una leyenda junto a la figura que explica. Esas tareas pueden presentarse en la misma página, y la mejor forma de leer una parte puede diferir de la siguiente.
Estamos diseñando OpenOCR Stratify para abordar ese trabajo por partes. Stratify se encargaría de identificar las regiones en un documento, enviarlas a los lectores seleccionados por el cliente y volver a reunir los resultados manteniendo intactas las referencias a su origen. Una tabla compleja podría recibir otra pasada sin obligar a reiniciar el procesamiento de todo el documento.
El nombre refleja este enfoque: dividir un documento complejo en partes que puedan gestionarse individualmente, sin perder el rastro de cómo encajan entre sí. El flujo de trabajo consta de cuatro etapas: identificar las regiones, elegir los lectores, extraer el contenido y reensamblar el documento.
OpenOCR ya permite a los clientes elegir un motor de OCR mediante una API común. Stratify ampliaría esa capacidad de elección a regiones individuales. La capa compartida de procesamiento, la opción de API y los controles del workbench se encuentran en fase de diseño y planificación; actualmente no están disponibles.
Por qué importa la estructura del documento
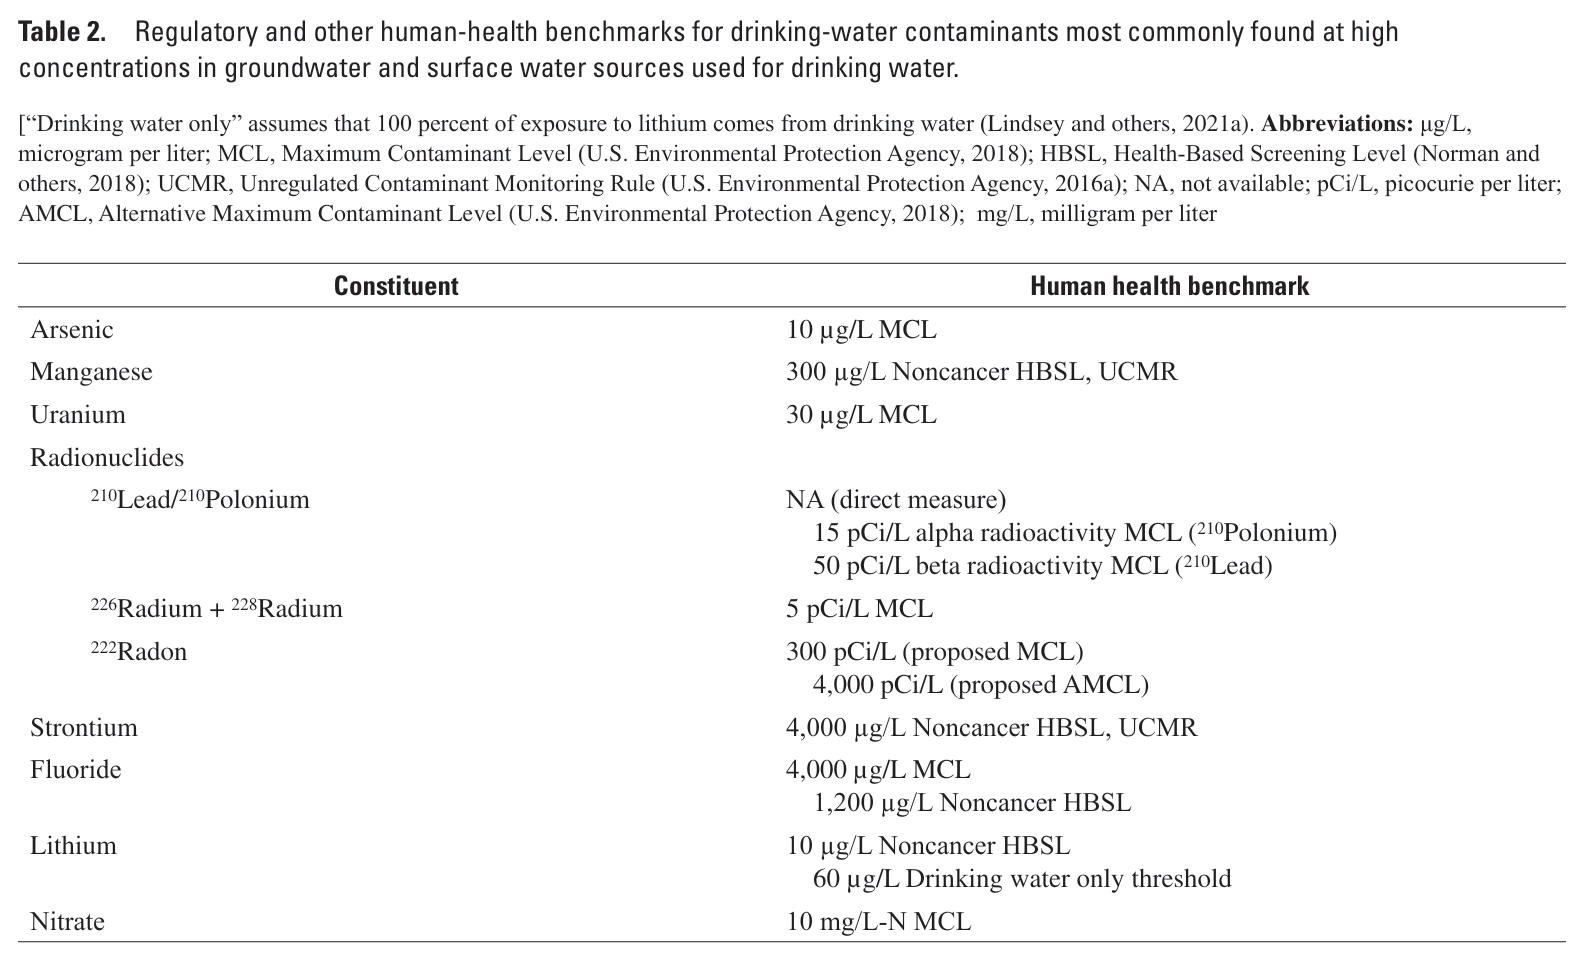
La página que figura a continuación procede del informe del USGS Status of Water-Quality Conditions in the United States, 2010–20. Consta de dos columnas de texto, un encabezado de sección y una tabla con leyenda y notas de abreviaturas. El documento es real: cada imagen mostrada aquí se renderizó a partir del PDF publicado. Hemos delimitado las regiones manualmente para explicar el flujo de trabajo propuesto.
Si se leen ambas columnas como si fueran un solo párrafo, oraciones sin relación alguna terminan juntas. Si se separa la tabla de sus notas, las abreviaturas pierden su definición. Si se aplanan sus filas con sangría, la relación entre una categoría y sus elementos puede desaparecer. Una lista de palabras reconocidas correctamente no preserva estas distinciones. Seleccione las regiones resaltadas a continuación para inspeccionar los píxeles originales.
Estos son problemas prácticos para las aplicaciones creadas a partir de documentos extraídos. La búsqueda requiere fragmentos con límites coherentes. Un flujo de trabajo financiero necesita distinguir un total de un subtotal cercano. Un asistente que responda preguntas sobre un artículo necesita tanto las aclaraciones de una leyenda como los valores de un gráfico. Una transcripción de aspecto impecable puede ocultar un error estructural hasta que alguien toma decisiones basándose en ella.
Este mismo problema se complica aún más en documentos extensos. Un informe puede comenzar como un PDF digital, contener varios apéndices escaneados y concluir con fotografías de formularios firmados. Procesar cada página de la misma manera es cómodo, pero no siempre se adapta al material. El propósito de Stratify es preservar suficiente información sobre cada página y región para hacer posible una elección más deliberada.
Cómo procesaría Stratify un documento
El flujo de trabajo comienza con la página de origen y termina con un documento que se puede inspeccionar. Cada parte tiene un propósito concreto. Dado que un proveedor puede cubrir varias de ellas en una sola solicitud, no se trata necesariamente de cuatro llamadas obligatorias a modelos.
Identificar las regiones. Inspeccionar las páginas del documento, su orientación, la calidad de la imagen y el texto incrustado aprovechable. Localizar párrafos, columnas, tablas, leyendas y demás regiones, conservando sus posiciones y relaciones. Esto proporciona al resto del flujo de trabajo un mapa de lo que se debe leer.
Elegir los lectores. Utilizar los motores configurados por el cliente para las regiones identificadas. Un cliente podría combinar un detector de maquetación con un modelo de visión, o bien conservar la extracción de párrafos de un proveedor existente y elegir un lector distinto para las tablas. El plan de procesamiento debe hacer explícitas esas elecciones y sus límites.
Extraer el contenido. Preparar la entrada de cada lector seleccionado a una resolución adecuada, incluyendo el contexto circundante donde resulte relevante. Ejecutar el paso de reconocimiento, conservar las extracciones útiles existentes y registrar de qué región de origen y de qué motor provino cada resultado.
Reensamblar el documento. Restaurar el orden de lectura, conciliar recortes superpuestos y reconectar encabezados, leyendas, notas y tablas. Entregar texto utilizable o datos estructurados con referencias a las fuentes y vacíos visibles donde el procesamiento haya quedado incompleto.
Si un proveedor ya devuelve una tabla útil con relaciones entre celdas y coordenadas de página, Stratify debería conservar ese trabajo. Repetir una extracción exitosa añade costo sin un propósito claro. La documentación de desarrollo describe con mayor detalle el comportamiento propuesto y los límites de integración.
Leer por partes sin perder el conjunto
En la página anotada del USGS, P1 y P2 identifican las columnas principales de texto. H1 es un encabezado, P3 su párrafo, C1 la leyenda de la tabla, N1 las notas explicativas y T1 la tabla en sí. Se trata de identificadores editoriales para este ejemplo. En un pipeline funcional, un detector de maquetación proporcionaría las ubicaciones de las regiones y sus tipos probables, brindando a los pasos posteriores una forma estable de referirse a cada parte.
Preparar T1 requiere tomar una decisión sobre el contexto. Sus encabezados de columna y celdas caben en un solo rectángulo, pero las definiciones de MCL, HBSL y otras abreviaturas se sitúan encima, en N1. La leyenda en C1 explica lo que describe la tabla. Incluir las tres regiones aporta más contexto a un lector sin enviar la página entera. Alterne el ejemplo superior para comparar ambos recortes; los píxeles del documento subyacente permanecen inalterados.
El sistema también necesita saber cómo se relaciona un recorte con el original. El renderizado puede cambiar la resolución; las páginas pueden rotarse; los proveedores pueden reportar posiciones utilizando diferentes sistemas de coordenadas. Un resultado asociado únicamente a la imagen final del recorte no basta para un usuario que desea resaltar el área correspondiente en el PDF original. Esa transformación debe permanecer trazable.
Los recortes superpuestos plantean otro problema de ensamblaje. Incluir texto circundante puede ayudar a un lector a interpretar una tabla, pero ese texto no debería aparecer dos veces en el documento final. El contexto enviado a un modelo y el contenido seleccionado para la salida son decisiones relacionadas pero distintas. La representación de las regiones debe preservar esa distinción.
Algunos fallos no se pueden corregir preparando una entrada diferente. Aumentar el tamaño de un escaneo deficiente no recupera un dígito faltante. Una página cortada en el borde de una fotografía puede quedar incompleta. En esos casos, el resultado útil es una indicación honesta de incertidumbre y un enlace a la fuente, en lugar de un valor completado con falsa seguridad.
Combinar un segmentador con un modelo de OCR o de visión
Un segmentador responde a una pregunta sobre la maquetación: ¿dónde están las partes y qué funciones parecen desempeñar? Un motor de reconocimiento responde a una pregunta sobre su contenido. Algunos proveedores cubren ambas cosas. Otros ofrecen un detector de maquetación dedicado o un modelo especialmente útil para cierto tipo de entrada.
Stratify admitiría combinaciones explícitas. Un cliente podría seleccionar un detector y un modelo de reconocimiento para todas las regiones, o bien mantener la extracción de párrafos de un proveedor y enviar ciertas tablas o anotaciones a otro lector. El formulario en blanco del IRS que aparece a continuación muestra por qué la entrada importa: los campos de dirección, las opciones con casillas de verificación, una tabla de dependientes y filas de ingresos numeradas constituyen estructuras diferentes en una misma página.
Un lector de tablas podría preservar juntos los encabezados de columna de los dependientes y las celdas de registro. Un lector de formularios necesitaría conservar la relación entre una casilla de verificación y su etiqueta. Un lector de texto podría encargarse de las instrucciones del margen por separado. Este formulario está en blanco; un resultado fiel conservaría los campos vacíos en lugar de inventar valores. Pedirle a un LLM que explique un formulario es una operación distinta a transcribir su contenido, y el flujo de trabajo debe hacer explícita esa distinción.
La coordinación es la parte que queremos que aporte OpenOCR: preparar las entradas, enviar cada una al motor configurado, registrar lo que se completó y mantener los resultados vinculados a sus regiones de origen. Un cliente no debería tener que construir un servicio independiente de recorte y reconstrucción solo para probar un segmentador con su lector preferido.
Esto no asume que las combinaciones especializadas vayan a ganar siempre. Un modelo de documentos que recibe la página completa puede comprender un contexto que un recorte deja fuera. Un modelo general de visión puede leer ya una tabla específica con precisión. Necesitamos evaluar la combinación real sobre entradas representativas, incluyendo el trabajo requerido para prepararlas y ensamblarlas.
Devolver un documento que se pueda inspeccionar
Los resultados deben volver en forma de documento, no como una colección desordenada de respuestas de modelos. En el ejemplo del USGS, P1 precede a P2, H1 pertenece a P3 y la tabla conserva los enlaces a su leyenda y notas de abreviaturas. Los identificadores se trasladan a lo largo del proceso para que el usuario pueda comparar cualquier parte de la extracción con la página original.
Esa representación es también la base para los reintentos selectivos. Supongamos que los párrafos son aceptables pero una celda de la tabla es incorrecta. El usuario podría seleccionar T1, elegir otro motor y solicitar otra pasada. Su reemplazo tendría que conciliarse con el documento aceptado, dejando intactos los párrafos, la leyenda y las notas ya aprobados. Un reintento no debería reescribir silenciosamente contenido no relacionado.
Mantener un historial de esa decisión ayudaría a explicar el resultado. ¿Qué motor generó la primera versión? ¿Qué entrada recibió el segundo motor? ¿Incluyó el reemplazo un recorte diferente o más contexto? Son preguntas útiles al comparar alternativas, investigar un error o decidir si un nuevo resultado es lo bastante confiable para el siguiente paso.
Una región con fallos también debe permanecer visible. Si un proveedor agota el tiempo de espera mientras lee T1, es posible que el sistema aún disponga de párrafos con resultados utilizables. Devolverlos como un documento completo ocultaría el trabajo faltante. El resultado planificado necesita información de finalización por región para que la aplicación pueda distinguir una extracción parcial de una terminada y decidir si reintentar o solicitar una revisión.
El esquema exacto de respuesta todavía se está diseñando. Lo fundamental en esta etapa es preservar la información requerida para estos comportamientos. Aplanar todo prematuramente en una sola cadena de texto haría mucho más difícil incorporar posteriormente la inspección y el reemplazo selectivo.
Aprovechar las capacidades de los proveedores
OpenOCR ya admite el procesamiento nativo de PDF del proveedor para motores compatibles y el renderizado de páginas para motores que aceptan imágenes. Algunos proveedores también devuelven su propio análisis de maquetación o del documento. Stratify ampliaría esas bases con una representación compartida para regiones y relaciones entre motores.
Hay capacidades muy útiles sobre las que construir. Mistral OCR documenta salidas estructuradas de documentos, incluida información sobre maquetación. AWS Textract ofrece análisis de tablas, formularios y maquetación. PaddleOCR proporciona un detector de maquetación dedicado que es candidato a combinarse con un modelo de reconocimiento independiente.
Estas respuestas no son intercambiables sin una traducción. El «bloque» de un proveedor puede representar una línea, un párrafo o una tabla. Las coordenadas pueden estar normalizadas o expresadas en otra unidad. Una tabla puede contener posiciones de celdas, celdas combinadas y relaciones que desaparecerían si nos quedáramos solo con su texto. El formato común necesita preservar esas distinciones.
Por eso el primer paso planificado es conservar la estructura útil del proveedor. Antes de introducir otra pasada de reconocimiento, debemos establecer qué contiene el resultado existente y si puede respaldar la selección de regiones y el ensamblaje. El hecho de que OpenOCR admita hoy a un proveedor no debe interpretarse como que todas las operaciones avanzadas de ese proveedor ya están disponibles.
Habrá que verificar los adaptadores frente a la operación correspondiente y la versión del modelo. Una lista de fragmentos de texto no es lo mismo que un conjunto de regiones con coordenadas. La integración debe determinar qué se puede rastrear hasta la página, qué se puede reutilizar y qué requeriría otro detector u otra pasada de reconocimiento.
Cómo planeamos evaluarlo
Una canalización más larga introduce más puntos en los que puede producirse un error. Un detector puede pasar por alto una nota al pie, un recorte puede eliminar una aclaración y el ensamblaje puede duplicar una oración. La evaluación debe considerar el documento resultante de todo el flujo de trabajo, no solo la precisión de un modelo en regiones aisladas.
Planeamos comparar las combinaciones propuestas de Stratify con proveedores individuales sobre las mismas entradas. El conjunto necesita documentos que expongan problemas diferentes: artículos de varias columnas, tablas densas, leyendas pequeñas, páginas que mezclan contenido digital y escaneado, ecuaciones y anotaciones. También debe incluirse una carta sencilla, ya que el procesamiento adicional debe justificarse tanto en documentos habituales como en los complejos.
La precisión del texto es solo una medida. El orden de lectura, el contenido omitido, las regiones duplicadas y las relaciones en las tablas también importan. En la tabla del USGS, reconocer un valor pero asociarlo al componente equivocado sigue siendo un resultado incorrecto. En el formulario en blanco, convertir una casilla vacía en una respuesta marcada sería otro tipo de fallo. Una puntuación que pase por alto esas relaciones ofrecería un panorama incompleto de si la canalización ayudó.
El tiempo transcurrido y el costo total pertenecen a la misma evaluación. Un recorte puede ser pequeño pero implicar aún así renderizado, detección, otra solicitud al proveedor y reconstrucción. Un reintento selectivo solo es útil si genera un resultado aceptable sin repetir trabajo innecesario. El plan también debe contemplar los reintentos que fallan, en lugar de reportar únicamente el costo de una llamada final exitosa.
No hemos publicado resultados de benchmarks de Stratify, precios ni afirmaciones de mejoras de rendimiento. La información sobre la confianza requiere su propia evaluación: las puntuaciones que devuelven diferentes proveedores pueden describir cosas distintas y no se pueden promediar sin más. Hasta que no se comprendan esas señales, el procesamiento seleccionado por el cliente y la incertidumbre visible son un punto de partida más defendible que el enrutamiento automático basado en una sola puntuación.
De la API al workbench
Esperamos que Stratify sea opcional. El enfoque previsto para la API es una opción de procesamiento junto a los motores seleccionados por el cliente, con control explícito sobre la maquetación y el reconocimiento. El contrato aún no se ha formalizado, por lo que hoy no existe un parámetro admitido de Stratify para añadir a una solicitud. Las solicitudes existentes no deberían adquirir llamadas adicionales de procesamiento solo porque se introduzca esta funcionalidad.
En el workbench, los controles útiles estarían vinculados al documento mismo: inspeccionar una región detectada, ver qué motor la leyó, comparar la extracción con la página y solicitar otra pasada donde sea necesario. Mostrar los límites detectados también permitiría al usuario distinguir un problema de segmentación de uno de reconocimiento. Una transcripción perfecta del recorte equivocado sigue requiriendo que se corrija el recorte.
La progresión prevista consiste en conservar la estructura del proveedor, admitir combinaciones explícitas de motores y, posteriormente, introducir controles de inspección y reintento de regiones. La selección automática de motores es una posibilidad posterior. Requiere evidencia sobre dónde ayuda una combinación, cuánto cuesta y cómo falla antes de que el sistema pueda tomar esa decisión de manera responsable en nombre del cliente.
La visibilidad de los proveedores y los límites de costo forman parte del diseño propuesto. El cliente debería poder saber qué servicios reciben el documento o los recortes y qué trabajo adicional está permitido. Cambiar el lector de una región debe seguir siendo una decisión de procesamiento comprensible, no una cadena inexplicable de fallbacks.
Qué queremos aprender de los documentos complejos
La primera versión necesita un conjunto concreto de problemas por resolver. Un informe que pierde el orden de las columnas es diferente de un formulario escaneado con letra manuscrita tenue. Una tabla que continúa a lo largo de tres páginas plantea interrogantes distintos a los de un recibo de una página. Describir esos fallos con precisión nos ayudará a elegir casos de evaluación y a decidir qué controles vale la pena construir primero.
Si sus documentos pierden columnas, leyendas, relaciones de tablas o anotaciones durante la extracción, contacte con OpenOCR describiendo qué falla. El punto de partida útil es el comportamiento: qué esperaba conservar, qué perdió la extracción y qué tuvo que corregir después. No hace falta asumir que una combinación particular de modelos sea la solución.
Mantendremos la documentación de desarrollo de Stratify alineada con el flujo de trabajo propuesto y los límites de integración a medida que el trabajo tome forma. Stratify sigue en fase de diseño y planificación, sin una fecha de lanzamiento anunciada. El objetivo es una extensión práctica de OpenOCR que ofrezca a los clientes un mayor control sobre documentos complejos y una explicación más clara de cómo se obtuvieron sus resultados.
Fuentes de los documentos: USGS Professional Paper 1894–C, versión 1.1 (febrero de 2025), página impresa 6; y el formulario 1040 del IRS de 2024, página 1. La portada y los recortes reproducen los documentos publicados. Los límites y relaciones entre regiones son ejemplos anotados manualmente. El extracto de texto utiliza la capa de texto incrustada del PDF. Ninguno de estos ejemplos constituye una detección de Stratify, un resultado de OCR o un benchmark.