OpenOCR Stratify का परिचय
एक जटिल दस्तावेज़ किसी OCR इंजन से केवल शब्दों की पहचान करने से कहीं अधिक की मांग करता है। इसमें दो कॉलमों का क्रम समझना, किसी टेबल को दोबारा निर्मित (reconstruct) करना, हाथ से लिखे सुधारों को पढ़ना और कैप्शन को उस चित्र के साथ जोड़े रखना पड़ सकता है जिसकी वह व्याख्या करता है। ये सभी कार्य एक ही पृष्ठ पर मौजूद हो सकते हैं, और दस्तावेज़ के एक हिस्से को पढ़ने का सबसे अच्छा तरीका दूसरे हिस्से से बिल्कुल अलग हो सकता है।
हम इस कार्य को अलग-अलग हिस्सों में संभालने के लिए OpenOCR Stratify को डिज़ाइन कर रहे हैं। Stratify किसी दस्तावेज़ में विभिन्न क्षेत्रों (regions) की पहचान करेगा, उन्हें ग्राहक द्वारा चुने गए रीडर्स के पास भेजेगा, और उनके मूल स्रोत संदर्भों (source references) को सुरक्षित रखते हुए परिणामों को वापस एक साथ संयोजित करेगा। इससे किसी जटिल टेबल को पूरे दस्तावेज़ को दोबारा प्रोसेस किए बिना एक और पास (second pass) में फिर से प्रोसेस किया जा सकेगा।
इसका नाम इसके दृष्टिकोण को दर्शाता है: किसी जटिल दस्तावेज़ को ऐसे हिस्सों में विभाजित करना जिन्हें व्यक्तिगत रूप से प्रोसेस किया जा सके, और साथ ही यह ट्रैक रखना कि वे आपस में कैसे जुड़ते हैं। इस वर्कफ़्लो के चार मुख्य भाग हैं: क्षेत्रों को खोजना (find the regions), रीडर्स चुनना (choose the readers), सामग्री निष्कर्षित करना (extract the content), और दस्तावेज़ को फिर से जोड़ना (reassemble the document)।
OpenOCR पहले से ही ग्राहकों को एक सामान्य API के माध्यम से अपनी पसंद का OCR इंजन चुनने की सुविधा देता है। Stratify इस विकल्प को दस्तावेज़ के अलग-अलग क्षेत्रों तक विस्तारित करेगा। यह शेयर्ड प्रोसेसिंग लेयर, API विकल्प और वर्कबेंच कंट्रोल्स अभी डिज़ाइन और योजना के चरण में हैं; वे आज उपलब्ध नहीं हैं।
दस्तावेज़ की संरचना क्यों महत्वपूर्ण है
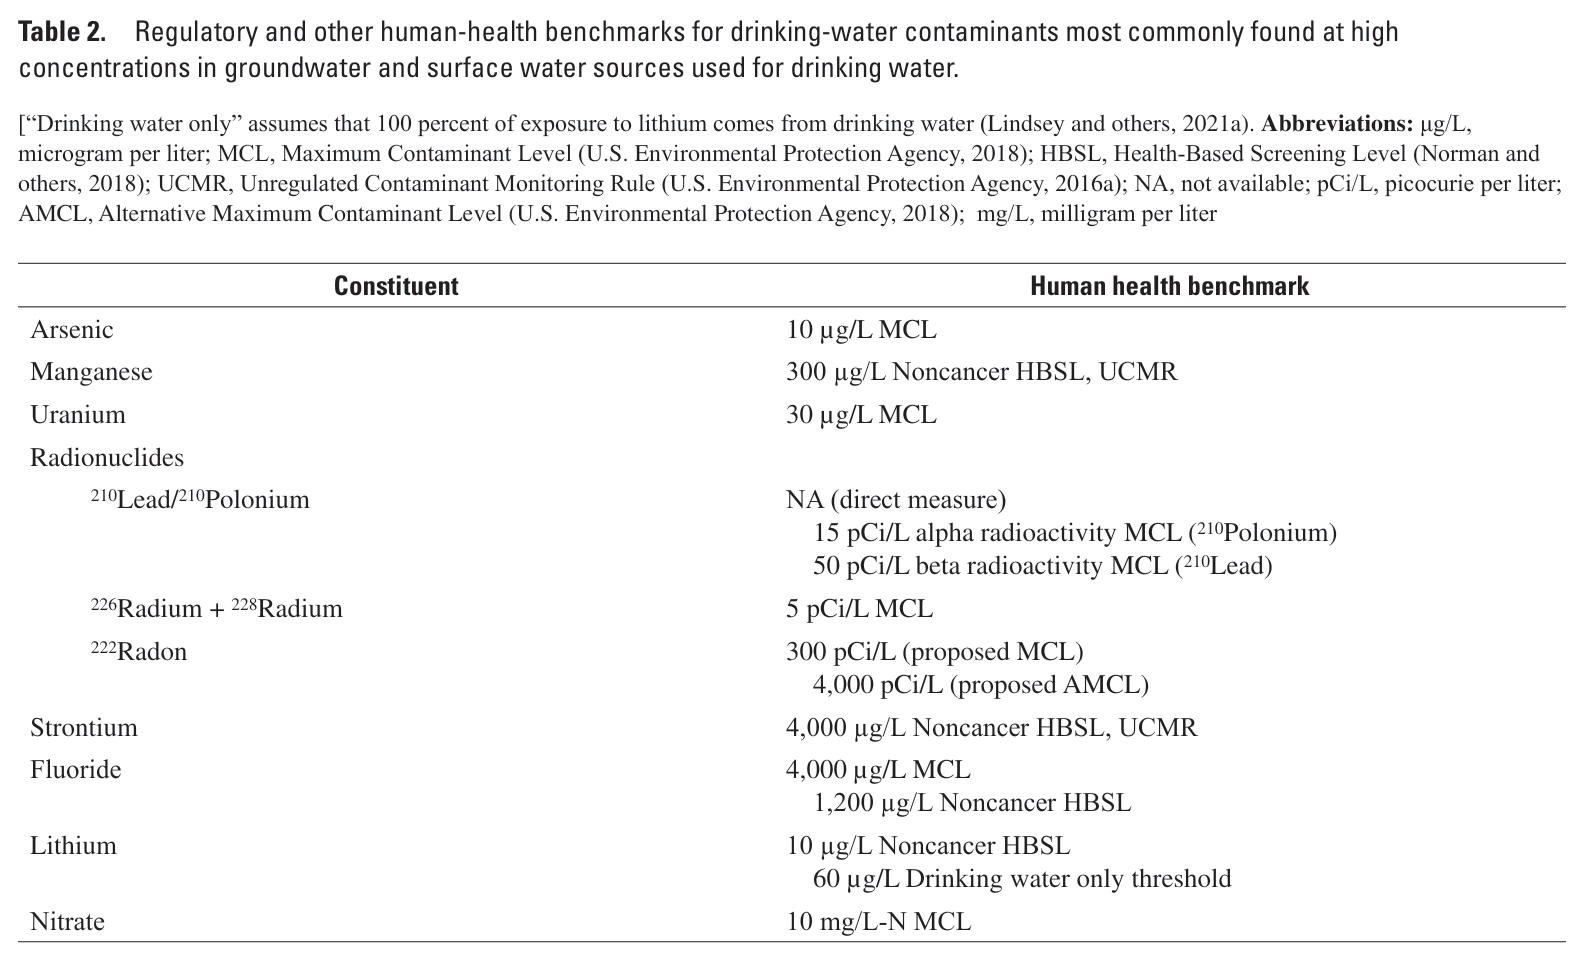
नीचे दिया गया पृष्ठ USGS रिपोर्ट Status of Water-Quality Conditions in the United States, 2010–20 से लिया गया है। इसमें दो टेक्स्ट कॉलम, एक सेक्शन हेडिंग, और कैप्शन व संक्षिप्ताक्षर नोट्स के साथ एक टेबल शामिल है। यह दस्तावेज़ वास्तविक है: यहाँ दी गई प्रत्येक इमेज प्रकाशित PDF से रेंडर की गई है। हमने प्रस्तावित वर्कफ़्लो को समझाने के लिए क्षेत्र की सीमाओं (region boundaries) को मैन्युअल रूप से चिह्नित किया है।
यदि दोनों कॉलमों को एक ही पैराग्राफ मानकर सीधे पढ़ लिया जाए, तो असंबंधित वाक्य आपस में जुड़ जाते हैं। टेबल को उसके नोट्स से अलग कर देने पर संक्षिप्ताक्षरों की परिभाषाएँ खो जाती हैं। इसकी इंडेंट की गई पंक्तियों को समतल (flatten) कर देने से किसी श्रेणी और उसकी प्रविष्टियों के बीच का संबंध गायब हो सकता है। सही ढंग से पहचाने गए शब्दों की महज़ एक सूची इन अंतरों को सुरक्षित नहीं रख पाती। मूल पिक्सल्स की जांच करने के लिए नीचे हाइलाइट किए गए क्षेत्रों को चुनें।
निष्कर्षित (extracted) दस्तावेज़ों पर आधारित एप्लिकेशन्स के लिए ये व्यावहारिक समस्याएँ हैं। सर्च को सुसंगत सीमाओं वाले अनुच्छेदों की आवश्यकता होती है। एक वित्तीय वर्कफ़्लो में कुल राशि (total) और पास के सब-टोटल के बीच अंतर करना ज़रूरी होता है। किसी रिसर्च पेपर पर प्रश्नों के उत्तर देने वाले असिस्टेंट को चार्ट के मानों के साथ-साथ कैप्शन में दी गई शर्तों की भी आवश्यकता होती है। एक साफ-सुथरा दिखने वाला ट्रांसक्रिप्शन तब तक किसी संरचनात्मक त्रुटि को छुपाए रख सकता है जब तक कोई उस पर पूरी तरह निर्भर न हो। इसी संदर्भ में यह ध्यान रखना भी प्रासंगिक है कि अंग्रेज़ी में मजबूत OCR होना देवनागरी के लिए अच्छे OCR की गारंटी नहीं देता, जहाँ शिरोरेखा, मात्राओं, नुक्ते और संयुक्त अक्षरों की जटिलताएँ इस संरचनात्मक चुनौती को और बढ़ा देती हैं।
किसी लंबे दस्तावेज़ में यह समस्या और भी गंभीर हो जाती है। एक रिपोर्ट डिजिटल PDF के रूप में शुरू हो सकती है, उसमें कई स्कैन किए गए परिशिष्ट (appendices) हो सकते हैं, और अंत में हस्ताक्षरित फॉर्मों की तस्वीरें हो सकती हैं। प्रत्येक पृष्ठ को एक ही तरीके से प्रोसेस करना सुविधाजनक तो है, लेकिन यह ज़रूरी नहीं कि वह सामग्री के अनुकूल भी हो। Stratify का उद्देश्य प्रत्येक पृष्ठ और क्षेत्र के बारे में पर्याप्त जानकारी को संरक्षित रखना है ताकि अधिक सोच-समझकर निर्णय लिया जा सके।
Stratify किसी दस्तावेज़ को कैसे प्रोसेस करेगा
यह वर्कफ़्लो मूल स्रोत पृष्ठ (source page) से शुरू होता है और एक ऐसे दस्तावेज़ पर समाप्त होता है जिसकी कोई भी व्यक्ति आसानी से समीक्षा (inspect) कर सके। इसके प्रत्येक भाग का एक ठोस उद्देश्य है। चूंकि कोई प्रोवाइडर एक ही रिक्वेस्ट में इनमें से कई कार्यों को पहले ही कवर कर सकता है, इसलिए ये चार अनिवार्य मॉडल कॉल्स नहीं हैं।
Find the regions. दस्तावेज़ के पृष्ठों, ओरिएंटेशन, इमेज क्वालिटी और उपयोग योग्य एम्बेडेड टेक्स्ट का विश्लेषण करें। पैराग्राफ, कॉलम, टेबल, कैप्शन और अन्य क्षेत्रों की पहचान करें और उनकी स्थिति व आपसी संबंधों को बनाए रखें। इससे शेष वर्कफ़्लो को एक स्पष्ट मैप मिल जाता है कि वास्तव में क्या पढ़ा जाना है।
Choose the readers. पहचाने गए क्षेत्रों के लिए ग्राहक द्वारा कॉन्फ़िगर किए गए इंजनों का उपयोग करें। कोई ग्राहक लेआउट डिटेक्टर को किसी विज़न मॉडल के साथ जोड़ सकता है, या किसी मौजूदा प्रोवाइडर के पैराग्राफ निष्कर्षण को बनाए रखते हुए टेबल्स के लिए एक अलग रीडर चुन सकता है। प्रोसेसिंग प्लान में इन चॉइसेस और उनकी सीमाओं को स्पष्ट रूप से परिभाषित किया जाना चाहिए।
Extract the content. प्रत्येक चयनित रीडर के इनपुट को उपयुक्त रिज़ॉल्यूशन पर तैयार करें, जिसमें जहाँ आवश्यक हो वहाँ आस-पास का संदर्भ (neighboring context) भी शामिल हो। पहचान (recognition) का चरण चलाएँ, उपयोगी मौजूदा निष्कर्षण को बनाए रखें, और यह रिकॉर्ड करें कि प्रत्येक परिणाम किस स्रोत क्षेत्र और इंजन से आया है।
Reassemble the document. पढ़ने के क्रम (reading order) को बहाल करें, ओवरलैपिंग क्रॉप्स का मिलान करें, और हेडिंग्स, कैप्शन्स, नोट्स और टेबल्स को फिर से आपस में जोड़ें। स्रोत संदर्भों और दिखाई देने वाले अंतराल (gaps) के साथ उपयोग योग्य टेक्स्ट या संरचित डेटा प्रदान करें जहाँ प्रोसेसिंग अधूरी रह गई हो।
यदि कोई प्रोवाइडर सेल संबंधों और पृष्ठ निर्देशांकों (page coordinates) के साथ पहले से ही एक उपयोगी टेबल लौटाता है, तो Stratify को उस काम को बनाए रखना चाहिए। किसी सफल निष्कर्षण को दोहराना बिना किसी स्पष्ट उद्देश्य के केवल लागत बढ़ाता है। इसका डेवलपमेंट डॉक्यूमेंटेशन प्रस्तावित व्यवहार और इंटीग्रेशन सीमाओं का अधिक विस्तार से वर्णन करता है।
समग्रता को खोए बिना टुकड़ों में पढ़ना
एनोटेट किए गए USGS पृष्ठ में, P1 और P2 मुख्य टेक्स्ट कॉलमों की पहचान करते हैं। H1 एक हेडिंग है, P3 उसका पैराग्राफ, C1 टेबल का कैप्शन, N1 व्याख्यात्मक नोट्स, और T1 स्वयं टेबल है। इस उदाहरण के लिए ये संपादकीय पहचानकर्ता (editorial identifiers) हैं। एक चालू पाइपलाइन में, एक लेआउट डिटेक्टर क्षेत्रों के स्थानों और उनके संभावित प्रकारों की जानकारी प्रदान करेगा, जिससे बाद के चरणों को प्रत्येक भाग को संदर्भित करने का एक स्थिर तरीका मिल सकेगा।
T1 को तैयार करने के लिए संदर्भ (context) के बारे में निर्णय लेने की आवश्यकता होती है। इसके कॉलम हेडर और सेल्स एक आयत (rectangle) के भीतर समा जाते हैं, लेकिन MCL, HBSL और अन्य संक्षिप्ताक्षरों की परिभाषाएँ इसके ऊपर N1 में स्थित हैं। C1 में दिया गया कैप्शन बताता है कि टेबल किस बारे में है। इन तीनों क्षेत्रों को शामिल करने से पूरे पृष्ठ को भेजे बिना ही रीडर को अधिक संदर्भ मिल जाता है। दोनों क्रॉप्स की तुलना करने के लिए ऊपर दिए गए उदाहरण को टॉगल करें; मूल दस्तावेज़ के पिक्सल अपरिवर्तित रहते हैं।
सिस्टम को यह भी जानने की आवश्यकता होती है कि कोई क्रॉप मूल दस्तावेज़ से कैसे संबंधित है। रेंडरिंग से रिज़ॉल्यूशन बदल सकता है; पृष्ठ घूमे (rotate) हो सकते हैं; और अलग-अलग प्रोवाइडर्स विभिन्न निर्देशांक प्रणालियों (coordinate systems) का उपयोग करके स्थितियों की रिपोर्ट कर सकते हैं। केवल अंतिम क्रॉप की गई छवि से जुड़ा परिणाम उस उपयोगकर्ता के लिए पर्याप्त नहीं है जो मूल PDF के संबंधित क्षेत्र को हाइलाइट करना चाहता है। उस रूपांतरण (transformation) का ट्रेस करने योग्य (traceable) बने रहना आवश्यक है।
ओवरलैपिंग क्रॉप्स एक अन्य असेंबली समस्या उत्पन्न करते हैं। आस-पास के टेक्स्ट को शामिल करने से रीडर को किसी टेबल की व्याख्या करने में मदद मिल सकती है, लेकिन वह टेक्स्ट अंतिम दस्तावेज़ में दो बार नहीं दिखना चाहिए। मॉडल को भेजा गया संदर्भ (context) और आउटपुट के लिए चुनी गई सामग्री (content) दो अलग-अलग, हालांकि परस्पर संबंधित निर्णय हैं। क्षेत्र के निरूपण (region representation) में उस अंतर को बनाए रखने की आवश्यकता है।
कुछ त्रुटियों को केवल एक अलग इनपुट तैयार करके ठीक नहीं किया जा सकता। किसी खराब स्कैन को बड़ा करने से गायब अंक वापस नहीं आ जाते। तस्वीर के किनारे से कटा हुआ पृष्ठ अधूरा ही रह सकता है। ऐसे मामलों में, पूरे आत्मविश्वास के साथ गढ़ा गया कोई गलत मान देने के बजाय अनिश्चितता का स्पष्ट संकेत और मूल स्रोत का लिंक देना ही अधिक उपयोगी परिणाम होता है।
सेगमेंटर को OCR या विज़न मॉडल के साथ जोड़ना
एक सेगमेंटर लेआउट से जुड़े प्रश्नों का उत्तर देता है: विभिन्न हिस्से कहाँ हैं, और उनकी क्या भूमिका प्रतीत होती है? एक पहचान इंजन (recognition engine) उनकी सामग्री से जुड़े प्रश्नों का उत्तर देता है। कुछ प्रोवाइडर्स इन दोनों को संभालते हैं। अन्य एक समर्पित लेआउट डिटेक्टर या ऐसा मॉडल पेश करते हैं जो किसी विशेष प्रकार के इनपुट के लिए विशेष रूप से उपयोगी होता है।
Stratify स्पष्ट संयोजनों (explicit combinations) का समर्थन करेगा। एक ग्राहक सभी क्षेत्रों के लिए एक डिटेक्टर और एक पहचान मॉडल चुन सकता है, या किसी प्रोवाइडर के पैराग्राफ निष्कर्षण को बनाए रखते हुए चुनिंदा टेबल्स या एनोटेशन को किसी अन्य रीडर के पास भेज सकता है। नीचे दिया गया खाली IRS फॉर्म दिखाता है कि इनपुट क्यों मायने रखता है: पते के फ़ील्ड, चेकबॉक्स विकल्प, आश्रितों (dependents) की टेबल, और क्रमांकित आय पंक्तियाँ एक ही पृष्ठ पर अलग-अलग संरचनाएँ हैं।
एक टेबल रीडर आश्रितों के कॉलम हेडिंग्स और प्रविष्टि सेल्स को एक साथ सुरक्षित रख सकता है। एक फॉर्म रीडर को चेकबॉक्स और उसके लेबल के बीच के संबंध को बनाए रखने की आवश्यकता होगी। एक टेक्स्ट रीडर हाशिए (margin) के निर्देशों को अलग से प्रोसेस कर सकता है। यह फॉर्म खाली है; एक सटीक परिणाम मनगढ़ंत मान गढ़ने के बजाय खाली फ़ील्ड्स को खाली ही रखेगा। किसी LLM से फॉर्म की व्याख्या करने के लिए कहना उसकी सामग्री को ट्रांसक्राइब करने से पूरी तरह अलग कार्य है, और वर्कफ़्लो को इस अंतर को स्पष्ट रूप से बनाए रखना चाहिए।
समन्वय (coordination) वह हिस्सा है जिसे हम OpenOCR के माध्यम से प्रदान करना चाहते हैं: इनपुट तैयार करना, प्रत्येक को कॉन्फ़िगर किए गए इंजन में भेजना, क्या पूरा हुआ उसे रिकॉर्ड करना, और परिणामों को उनके मूल स्रोत क्षेत्रों से जोड़े रखना। किसी ग्राहक को अपने पसंदीदा रीडर के साथ सेगमेंटर का परीक्षण करने मात्र के लिए अलग से क्रॉपिंग और पुनर्निर्माण सेवा (reconstruction service) तैयार करने की आवश्यकता नहीं होनी चाहिए।
इसका अर्थ यह कतई नहीं है कि विशेष संयोजन (specialized combinations) हमेशा ही बेहतर साबित होंगे। पूरे पृष्ठ को प्रोसेस करने वाला एक संपूर्ण डॉक्यूमेंट मॉडल उस संदर्भ को समझ सकता है जो क्रॉप करने से छूट जाता है। एक सामान्य विज़न मॉडल किसी विशिष्ट टेबल को पहले से ही सटीकता से पढ़ सकता है। हमें वास्तविक संयोजनों का प्रतिनिधि इनपुट्स पर मूल्यांकन करने की आवश्यकता है, जिसमें उन्हें तैयार करने और संयोजित करने के लिए आवश्यक प्रयास भी शामिल हैं।
एक ऐसा दस्तावेज़ प्राप्त करना जिसकी आप जांच कर सकें
परिणामों को एक संपूर्ण दस्तावेज़ के रूप में वापस आना चाहिए, न कि मॉडल प्रतिक्रियाओं के एक अव्यवस्थित संग्रह के रूप में। USGS उदाहरण में, P1 का क्रम P2 से पहले है, H1 का संबंध P3 के साथ है, और टेबल अपने कैप्शन व संक्षिप्ताक्षर नोट्स के लिंक को बनाए रखती है। ये पहचानकर्ता (identifiers) लगातार जुड़े रहते हैं ताकि उपयोगकर्ता निष्कर्षण के किसी भी हिस्से की मूल पृष्ठ से तुलना कर सके।
यह निरूपण चयनात्मक पुनः प्रयासों (selective retries) का आधार भी है। मान लीजिए कि पैराग्राफ स्वीकार्य हैं लेकिन टेबल का कोई सेल गलत है। एक उपयोगकर्ता T1 का चयन कर सकता है, दूसरा इंजन चुन सकता है, और एक और पास के लिए अनुरोध कर सकता है। पहले से स्वीकृत पैराग्राफ, कैप्शन और नोट्स को यथावत रखते हुए इसके प्रतिस्थापन (replacement) को स्वीकृत दस्तावेज़ के साथ समन्वित करने की आवश्यकता होगी। पुनः प्रयास द्वारा असंबंधित सामग्री को बिना बताए चुपचाप दोबारा नहीं लिखा जाना चाहिए।
उस निर्णय का इतिहास सुरक्षित रखने से परिणाम को समझाने में मदद मिलेगी। पहला संस्करण किस इंजन ने तैयार किया था? दूसरे इंजन को क्या इनपुट मिला? क्या प्रतिस्थापन में एक अलग क्रॉप या अधिक संदर्भ शामिल था? विकल्पों की तुलना करते समय, किसी त्रुटि की जांच करते समय, या यह तय करते समय कि क्या कोई नया परिणाम अगले कदम के लिए पर्याप्त विश्वसनीय है, ये सभी उपयोगी प्रश्न हैं।
असफल रहा क्षेत्र भी स्पष्ट रूप से दिखाई देना चाहिए। यदि T1 को पढ़ते समय किसी प्रोवाइडर का टाइमआउट हो जाता है, तो भी सिस्टम के पास उपयोग योग्य पैराग्राफ परिणाम हो सकते हैं। उन्हें एक संपूर्ण दस्तावेज़ के रूप में प्रस्तुत करना छूटे हुए कार्य को छुपा देगा। नियोजित परिणाम में प्रति-क्षेत्र पूर्णता की जानकारी (per-region completion information) की आवश्यकता होती है ताकि एप्लिकेशन आंशिक निष्कर्षण और पूर्ण निष्कर्षण के बीच अंतर कर सके और यह निर्णय ले सके कि पुनः प्रयास करना है या समीक्षा का अनुरोध करना है।
सटीक रिस्पॉन्स स्कीमा (response schema) अभी भी डिज़ाइन किया जा रहा है। इस चरण में जो बात सबसे महत्वपूर्ण है, वह है इन क्षमताओं के लिए आवश्यक जानकारी को सुरक्षित रखना। सब कुछ बहुत पहले ही एक एकल टेक्स्ट स्ट्रिंग में समेट (flatten) देने से बाद में चयनात्मक प्रतिस्थापन और निरीक्षण की सुविधा जोड़ना कहीं अधिक कठिन हो जाएगा।
प्रोवाइडर की मौजूदा क्षमताओं का लाभ उठाना
OpenOCR संगत इंजनों के लिए प्रोवाइडर-नेटिव PDF प्रोसेसिंग और इमेज स्वीकार करने वाले इंजनों के लिए पेज रेंडरिंग का पहले से ही समर्थन करता है। कुछ प्रोवाइडर्स अपना स्वयं का लेआउट या दस्तावेज़ विश्लेषण भी लौटाते हैं। Stratify विभिन्न इंजनों में क्षेत्रों और उनके संबंधों के लिए एक साझा निरूपण (shared representation) के साथ उन आधारों का विस्तार करेगा।
आगे बढ़ने के लिए कई उपयोगी क्षमताएं उपलब्ध हैं। Mistral OCR संरचित दस्तावेज़ आउटपुट का दस्तावेजीकरण करता है, जिसमें लेआउट की जानकारी शामिल है। AWS Textract टेबल्स, फॉर्म्स और लेआउट का विश्लेषण प्रदान करता है। PaddleOCR एक समर्पित लेआउट डिटेक्टर प्रदान करता है जिसे एक अलग पहचान मॉडल के साथ जोड़ने के लिए इस्तेमाल किया जा सकता है।
ये प्रतिक्रियाएं बिना अनुवाद (translation/रूपांतरण) के एक-दूसरे के स्थान पर उपयोग नहीं की जा सकतीं। किसी प्रोवाइडर का "ब्लॉक" एक पंक्ति, एक पैराग्राफ या एक टेबल का प्रतिनिधित्व कर सकता है। निर्देशांक (coordinates) सामान्यीकृत (normalized) हो सकते हैं या किसी अन्य इकाई में व्यक्त किए जा सकते हैं। एक टेबल में सेल की स्थितियाँ, मर्ज किए गए सेल्स और ऐसे संबंध हो सकते हैं जो केवल टेक्स्ट रखने पर गायब हो जाएंगे। सामान्य प्रारूप में उन अंतरों को बनाए रखने की आवश्यकता है।
यही कारण है कि पहला नियोजित कदम उपयोगी प्रोवाइडर संरचना को सुरक्षित रखना है। एक और पहचान पास (recognition pass) शुरू करने से पहले, हमें यह स्थापित करने की आवश्यकता है कि मौजूदा परिणाम में क्या शामिल है और क्या यह क्षेत्र चयन और असेंबली का समर्थन कर सकता है। आज OpenOCR में किसी प्रोवाइडर का समर्थन करने का मतलब यह नहीं निकाला जाना चाहिए कि उस प्रोवाइडर का प्रत्येक उन्नत ऑपरेशन पहले से ही उपलब्ध करा दिया गया है।
प्रासंगिक ऑपरेशन और मॉडल संस्करण के संदर्भ में एडेप्टर्स की जांच करनी होगी। टेक्स्ट चंक्स की एक सूची निर्देशांकों वाले क्षेत्रों के सेट के समान नहीं होती है। एकीकरण (integration) को यह स्थापित करना होगा कि पृष्ठ पर किस हिस्से को ट्रेस किया जा सकता है, किसका पुन: उपयोग किया जा सकता है, और किसके लिए किसी अन्य डिटेक्टर या पहचान पास की आवश्यकता होगी।
हम इसका मूल्यांकन कैसे करने की योजना बना रहे हैं
एक लंबी पाइपलाइन त्रुटियों के उत्पन्न होने की अधिक गुंजाइश बनाती है। एक डिटेक्टर किसी फ़ुटनोट को छोड़ सकता है, एक क्रॉप किसी महत्वपूर्ण शर्त या स्पष्टीकरण को हटा सकता है, और असेंबली किसी वाक्य को दोहरा सकती है। मूल्यांकन में केवल अलग-थलग क्षेत्रों पर किसी मॉडल की सटीकता को ही नहीं, बल्कि संपूर्ण वर्कफ़्लो से निकलने वाले दस्तावेज़ पर भी विचार किया जाना चाहिए।
हम समान इनपुट्स पर व्यक्तिगत प्रोवाइडर्स के साथ प्रस्तावित Stratify संयोजनों की तुलना करने की योजना बना रहे हैं। इस परीक्षण सेट में ऐसे दस्तावेज़ों की आवश्यकता है जो विभिन्न समस्याओं को सामने लाते हों: मल्टी-कॉलम पेपर्स, सघन टेबल्स, छोटे कैप्शन्स, डिजिटल और स्कैन किए गए मिश्रित पृष्ठ, समीकरण और एनोटेशन। इसमें एक साधारण पत्र को भी शामिल किया जाना चाहिए, क्योंकि अतिरिक्त प्रोसेसिंग को कठिन दस्तावेज़ों के साथ-साथ सामान्य दस्तावेज़ों पर भी खुद को सही साबित करना होगा।
टेक्स्ट की सटीकता केवल एक पैमाना है। पढ़ने का क्रम (reading order), छूटी हुई सामग्री, डुप्लिकेट क्षेत्र और टेबल के संबंध भी मायने रखते हैं। USGS टेबल के मामले में, किसी मान को सही पहचानना लेकिन उसे गलत घटक (constituent) से जोड़ना अभी भी एक गलत परिणाम ही है। खाली फॉर्म के लिए, किसी खाली चेकबॉक्स को चुने गए उत्तर में बदल देना एक अन्य प्रकार की विफलता होगी। इन संबंधों की अनदेखी करने वाला स्कोर इस बात की अधूरी तस्वीर पेश करेगा कि क्या पाइपलाइन वास्तव में मददगार रही।
बीता हुआ समय (elapsed time) और कुल लागत भी इसी मूल्यांकन का हिस्सा हैं। एक क्रॉप छोटा हो सकता है लेकिन फिर भी उसमें रेंडरिंग, डिटेक्शन, एक अन्य प्रोवाइडर रिक्वेस्ट और रीकंस्ट्रक्शन शामिल हो सकता है। चयनात्मक पुनः प्रयास (selective retry) तभी उपयोगी है जब वह अनावश्यक काम को दोहराए बिना एक स्वीकार्य परिणाम देता हो। योजना में उन पुनः प्रयासों को भी शामिल किया जाना चाहिए जो विफल हो जाते हैं, न कि केवल अंतिम सफल कॉल की लागत की रिपोर्ट की जाए।
हमने Stratify बेंचमार्क परिणाम, मूल्य निर्धारण या प्रदर्शन लाभ के दावों को प्रकाशित नहीं किया है। कॉन्फिडेंस जानकारी को अपने स्वयं के मूल्यांकन की आवश्यकता होती है: विभिन्न प्रोवाइडर्स द्वारा लौटाए गए स्कोर अलग-अलग चीजों का वर्णन कर सकते हैं और उनका केवल औसत नहीं निकाला जा सकता। जब तक उन सिग्नलों को ठीक से समझा नहीं जाता, तब तक किसी एक स्कोर के आधार पर स्वचालित रूटिंग की तुलना में ग्राहक-चयनित प्रोसेसिंग और दिखाई देने वाली अनिश्चितता अधिक व्यावहारिक और तर्कसंगत शुरुआती बिंदु हैं।
API से वर्कबेंच तक
हम उम्मीद करते हैं कि Stratify वैकल्पिक होगा। इसका इच्छित API दृष्टिकोण लेआउट और पहचान पर स्पष्ट नियंत्रण के साथ, ग्राहक द्वारा चुने गए इंजनों के साथ-साथ एक प्रोसेसिंग विकल्प के रूप में काम करना है। कॉन्ट्रैक्ट को अभी अंतिम रूप नहीं दिया गया है, इसलिए आज किसी अनुरोध में जोड़ने के लिए कोई समर्थित Stratify पैरामीटर नहीं है। केवल इस क्षमता के पेश होने के कारण मौजूदा अनुरोधों में अतिरिक्त प्रोसेसिंग कॉल्स नहीं जुड़नी चाहिए।
वर्कबेंच में, उपयोगी कंट्रोल्स स्वयं दस्तावेज़ से जुड़े होंगे: पहचाने गए क्षेत्र की जांच करना, देखना कि किस इंजन ने इसे पढ़ा, निष्कर्षण की पृष्ठ से तुलना करना, और जहाँ आवश्यक हो वहाँ एक और पास का अनुरोध करना। पहचानी गई सीमाओं को प्रदर्शित करने से उपयोगकर्ता को सेगमेंटेशन की समस्या और पहचान की समस्या के बीच अंतर करने में भी मदद मिलेगी। गलत क्रॉप का एकदम सटीक ट्रांसक्रिप्शन होने पर भी क्रॉप को ठीक करने की आवश्यकता बनी रहती है।
इच्छित प्रगति प्रोवाइडर संरचना को संरक्षित करना, स्पष्ट इंजन संयोजनों का समर्थन करना, और फिर क्षेत्र निरीक्षण व पुनः प्रयास नियंत्रण पेश करना है। स्वचालित इंजन चयन बाद की संभावना है। सिस्टम द्वारा ग्राहक की ओर से जिम्मेदारीपूर्वक यह चुनाव करने से पहले इस बात के पुख्ता सबूत की आवश्यकता है कि कोई संयोजन कहाँ मदद करता है, उसकी लागत क्या है, और वह कहाँ विफल होता है।
प्रोवाइडर की दृश्यता (visibility) और लागत सीमाएं प्रस्तावित डिज़ाइन का हिस्सा हैं। एक ग्राहक को यह समझने में सक्षम होना चाहिए कि किन सेवाओं को दस्तावेज़ या क्रॉप्स प्राप्त होते हैं और किस अतिरिक्त कार्य की अनुमति है। किसी एक क्षेत्र के लिए रीडर बदलना एक समझ में आने वाला प्रोसेसिंग निर्णय होना चाहिए, न कि फ़ॉलबैक्स की कोई अस्पष्ट श्रृंखला।
हम कठिन दस्तावेज़ों से क्या सीखना चाहते हैं
पहले संस्करण को हल करने के लिए समस्याओं के एक ठोस सेट की आवश्यकता है। एक रिपोर्ट जो अपने कॉलम का क्रम खो देती है, वह धुंधली लिखावट वाले स्कैन किए गए फॉर्म से अलग होती है। तीन पृष्ठों तक चलने वाली टेबल एक-पृष्ठ की रसीद की तुलना में अलग प्रश्न प्रस्तुत करती है। उन विफलताओं का सटीक वर्णन करने से हमें मूल्यांकन मामलों को चुनने और यह तय करने में मदद मिलेगी कि कौन से नियंत्रण पहले बनाए जाने योग्य हैं।
यदि निष्कर्षण के दौरान आपके दस्तावेज़ अपने कॉलम, कैप्शन, टेबल संबंध, या एनोटेशन खो देते हैं, तो क्या गलत होता है इसके विवरण के साथ OpenOCR से संपर्क करें। उपयोगी शुरुआती बिंदु इसका व्यवहार है: आप क्या सुरक्षित रखने की अपेक्षा कर रहे थे, निष्कर्षण में क्या खो गया, और आपको बाद में क्या ठीक करना पड़ा। यह मान लेने की कोई आवश्यकता नहीं है कि कोई विशेष मॉडल संयोजन ही इसका समाधान है।
जैसे-जैसे काम आगे बढ़ेगा, हम Stratify डेवलपमेंट डॉक्यूमेंटेशन को प्रस्तावित वर्कफ़्लो और इंटीग्रेशन सीमाओं के अनुरूप बनाए रखेंगे। Stratify अभी भी डिज़ाइन और योजना के चरण में है, जिसकी रिलीज की कोई तारीख घोषित नहीं की गई है। इसका उद्देश्य OpenOCR का एक व्यावहारिक विस्तार है जो ग्राहकों को जटिल दस्तावेज़ों पर अधिक नियंत्रण प्रदान करता है और इस बात का स्पष्ट विवरण देता है कि उनके परिणाम कैसे तैयार किए गए थे।
दस्तावेज़ स्रोत: USGS Professional Paper 1894–C, version 1.1 (February 2025), printed page 6; और IRS 2024 Form 1040, page 1। कवर और क्रॉप्स प्रकाशित दस्तावेज़ों को पुनरुत्पादित करते हैं। क्षेत्र की सीमाएँ और संबंध मैन्युअल रूप से एनोटेट किए गए उदाहरण हैं। टेक्स्ट अंश PDF की एम्बेडेड टेक्स्ट लेयर का उपयोग करता है। इनमें से कोई भी उदाहरण Stratify डिटेक्शन, OCR परिणाम या बेंचमार्क नहीं है।