تغذية مصحح الذكاء الاصطناعي بتخمين OCR رديء: متى يفيد ومتى يُفسد الصفحة
استنادًا إلى: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
تخيّل مشروع رقمنة في إحدى مكتبات شمال إفريقيا: يمسح أحدهم ضوئياً بضعة آلاف من صفحات مخطوطات تعود لقرون مضت، ثم يُمررها عبر مسار المعالجة المعتاد؛ التعرف الضوئي على الحروف (OCR)، يليه نموذج ذكاء اصطناعي لتنقيح الأخطاء. في بعض الصفحات، ينجح الذكاء الاصطناعي في تدارك ما تعثّر فيه الـ OCR بدقة، مقدماً نصاً نقياً وسهل القراءة. ولكن في صفحات أخرى، يتناول الذكاء الاصطناعي تخمين الـ OCR المشوش، ويعامله كدليل إرشادي لمحتوى الصفحة، ليُنتج بثقة تفريغاً نصياً أسوأ بكثير مما لو لم يرَ مخرجات الـ OCR على الإطلاق.
هذه النتيجة الثانية تمثل المفارقة غير المتوقعة التي كشفت عنها ورقة بحثية جديدة صادرة من قطر بعنوان When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study. حيث اختبر الباحثون تقنيات OCR التقليدية، ونماذج الرؤية واللغة متعددة الوسائط (VLMs) للأغراض العامة، ونسخاً متخصصة في اللغة العربية من هذه النماذج، إضافة إلى نهج هجين «يُصحح» فيه الذكاء الاصطناعي مسودة الـ OCR، عبر ثمانية أنواع مختلفة من الوثائق العربية. لم يحقق أي نهج تفوقاً مطلقاً في جميع الحالات؛ إلا أن الورقة تقدم ما هو أجدى من مجرد إعلان فائز: فهي تفسر أسباب مساهمة نهج التصحيح في تحسين النتائج في بعض الوثائق وإفسادها تماماً في وثائق أخرى، وتضع اسماً محدداً لهذا النمط.
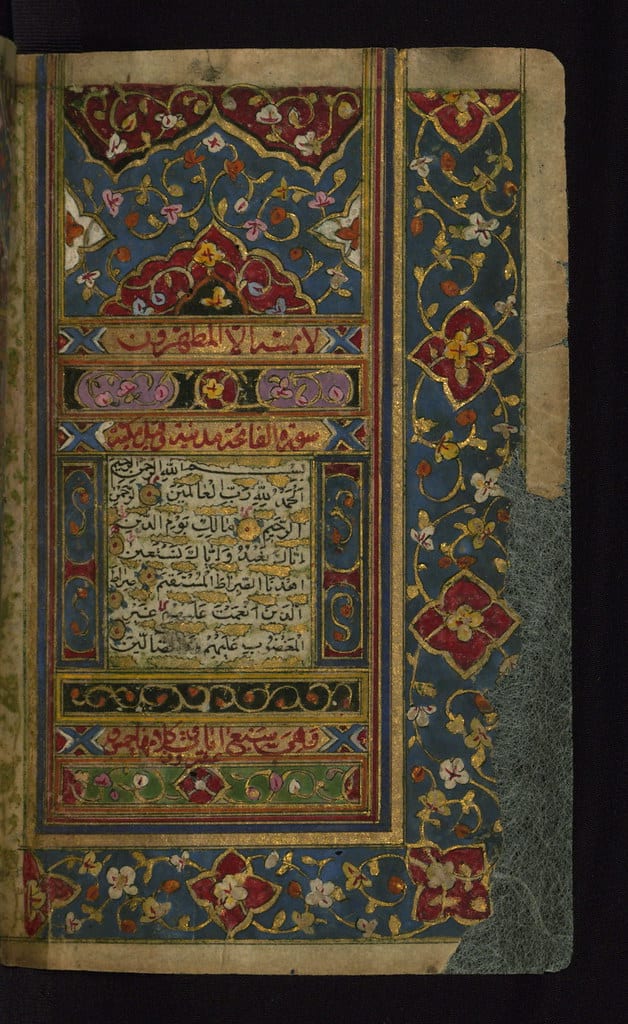
مصحف مخطوط مذهب، الجانب الأيمن من تنميق لصفحتين متقابلتين، متحف والترز للفنون MS. W.575، ورقة 2b — عبر Walters Art Museum Illuminated Manuscripts من خلال flickr، ترخيص CC0 1.0.
لماذا تمثل المخطوطات العربية معضلة حقيقية في التعرف الضوئي على الحروف (OCR)
ينطوي التعرف الضوئي على الحروف في النصوص العربية على قائمة من التحديات تفوق بكثير نظيرتها في النصوص اللاتينية، وتأتي المخطوطات لتزيد هذه الصعوبات تعقيداً.
فالعربية تُكتب بخط متصل تتغير فيه أشكال الحروف تبعاً لموقعها في الكلمة. فضلاً عن ذلك، لا يوجد «خط عربي» وحيد؛ فالطباعة الحديثة تعتمد غالباً على خط النسخ لكونه نمطاً واضحاً ومستديراً، بينما نُسِخَت المخطوطات التاريخية بأنماط إقليمية ذات أشكال حروف متباينة للغاية. وتركز هذه الورقة بوضوح على التباين بين خط النسخ والخط المغربي، وهو عائلة خطية استُخدمت عبر شمال إفريقيا والأندلس وتتميز بأشكال حروف وتباعدات وقواعد إعجام ونقط فريدة. وبالتالي، فإن نظام التعرف المدرب أساساً على خط النسخ يواجه صعوبة حقيقية في قراءة الخط المغربي، تماماً كشخص يجيد قراءة نمط أبجدي معين لكنه يتعثر أمام خط يدوي إقليمي غير مألوف.
ثم هناك الحركات التشكيلية: وهي علامات دقيقة توضع أعلى الحروف وأسفلها للدلالة على الحركات القصيرة وتفاصيل النطق. غالباً ما يُهمل التشكيل في الكتابة الاعتيادية، لكن وجوده في المخطوطات يجعل من ضبطه أو الخطأ فيه عاملاً يغير معنى الكلمة جذرياً. وقد وجدت الدراسة أن نماذج الذكاء الاصطناعي حساسة بصورة ملحوظة لمدى وضوح هذه العلامات أو تشوشها.
أضف إلى ذلك المشكلات المعتادة للأوراق القديمة: الحبر الباهت، وتلف الرطوبة والماء، وتفاوت المسافات بين السطور، وتدرج خطوط اليد من كتابة ورّاق متمرس شديدة العناية إلى ملاحظات طالب دُوِّنت على عجل. وتغطي مجموعات البيانات الثماني في هذه الدراسة هذا النطاق بدقة؛ بدءاً من المخطوطات التاريخية والكتب المطبوعة القديمة، وصولاً إلى المطبوعات الحديثة النقية، والوثائق مختلطة المجالات، وعينات الكتابة اليدوية.
المقاربات الأربع التي خضعت للاختبار الفعلي
لا تقترح الورقة طريقة جديدة واحدة، بل تقدم مقارنة بين أربع استراتيجيات قائمة، جرى اختبارها على نفس مجموعة الوثائق لضمان دقة المقارنة بين النتائج.
التعرف الضوئي التقليدي على الحروف (Traditional OCR): والمقصود به هنا محرك Tesseract المفتوح المصدر، الذي يتعرف على الحروف عبر مطابقة الأنماط المدربة على أشكال الخطوط والمحارف. وهو محرك لا يفهم دلالة النص الذي يقرؤه، بل يطابق الأشكال بالحروف المقابلة لها.
نماذج الرؤية واللغة العامة (General-purpose VLMs): وهي نماذج ذكاء اصطناعي تستقبل صورة وموجهاً نصياً معاً لإنتاج مخرجات نصية، وهي نفس العائلة التقنية الكامنة وراء أدوات مثل GPT-4 with vision أو Gemini؛ حيث تُعرض صفحة المخطوطة على النموذج ويُطلب منه تفريغ محتواها نصياً. وخلافاً لـ Tesseract، يمتلك نموذج VLM فهماً لغوياً يمكنه من استغلال السياق لتخمين كلمة طمسها الحبر بناءً على الكلمات المحيطة بها.
نماذج VLMs المتخصصة في العربية (Arabic-specialized VLMs): وهي إصدارات من التقنية ذاتها جرى ضبطها بدقة (fine-tuned) خصيصاً على النصوص والخطوط العربية، انطلاقاً من فرضية أن النماذج العامة المدربة غالباً على وثائق بالإنجليزية والخطوط اللاتينية قد لا تكون اطلعت على محتوى كافٍ من المخطوطات العربية لأداء المهمة بكفاءة.
التصحيح المشروط بمخرجات التعرف الضوئي (OCR-conditioned correction): وهو النهج الهجين؛ حيث يُشغَّل Tesseract أولاً، ثم تُمرَّر مخرجاته إلى نموذج VLM مصحوبة بالصورة الأصلية لتصحيح أخطاء الـ OCR. وتفترض هذه النظرية منح نموذج الـ VLM أسبقية تمكنه من تحرير مسودة أولية بدلاً من بدء التفريغ من الصفر أمام صفحة بيضاء.
ما الذي تفوق فعلياً، وأين؟
جاءت النتيجة الأساسية متسمة بالموضوعية والصراحة: لا توجد مقاربة واحدة تهيمن على الصدارة، بل يتبدل نمط الأداء بوضوح تبعاً لنوع الوثيقة قيد المعالجة.
فعلى مستوى أسطر المخطوطات التاريخية المنفردة (line-level) — حيث تُعرض الصور سطراً واحداً في كل مرة بدلاً من صفحة كاملة — كان أداء نماذج VLMs متكافئاً تقريباً مع أداء Tesseract، دون تفوق ملحوظ لأحدهما. أما عند الانتقال إلى صور المخطوطات على مستوى الصفحة الكاملة (page-level)، حيث يتطلب الأمر معالجة تخطيط الصفحة وسياقها العام دفعة واحدة، فقد تفوقت نماذج VLMs بوضوح على أنظمة OCR التقليدية. وهذا الفارق مفهوم ومنطقي؛ إذ يستطيع نموذج الـ VLM استثمار الكلمات المحيطة وبنية الصفحة لفك لبس حرف ملتبس، بينما يحلل Tesseract المحارف شكلاً تلو الآخر بمعزل عن السياق.
أما المصحح المشروط بالـ OCR فهو المحور الذي اتخذت فيه النتائج منحى مثيراً للاهتمام؛ ففي عدة بيئات، تفوق هذا النهج على كل من الـ OCR المستقل ونماذج VLMs المنفردة. إن تزويد نموذج الـ VLM بمسودة أولية لتنقيحها — بدلاً من إلزامه بالتفريغ المباشر دون معطيات سابقة — حقق أفضل النتائج بين المقاربات الثلاث، ولكن في سياقات معينة فقط. أما في سياقات أخرى، فقد أسفرت الحيلة ذاتها عن مخرجات أضعف من نتائج أيٍّ من المكونين بمفرده، وهذا التباين هو القضية الجوهرية التي تعالجها الورقة.
الفكرة الجوهرية: ضرورة قابلية التخمين المسبق للـ OCR للاسترجاع والتصحيح
يُطلق الباحثون على هذه الظاهرة مبدأ «قابلية التخمين المسبق للـ OCR للاسترجاع» (OCR-prior recoverability principle)، وهي الفكرة الأكثر نفعاً في الورقة لكل من يصمم مسار معالجة عملياً.
يمكنك تشبيه مسودة الـ OCR برسم تخطيطي أولي يُسلَّم لفنان قبل أن يرسم لوحته استناداً إلى صورة فوتوغرافية مرجعية؛ فإذا قارب التخطيط الأشكال الحقيقية رغم بعض الأخطاء في التفاصيل، فإنه يمنح الفنان نقاط ارتكاز مفيدة ينطلق منها. أما إذا كان التخطيط مغلوطاً بثقة تامة — كأن يرسم منزلاً حيث تُظهر الصورة قارباً — فإنه لن يساعد الفنان إطلاقاً، بل سيشتته ويضلله بمحاولة التوفيق بين نقطة انطلاق زائفة وما يراه عياناً.
هذا ما يحدث تماماً في التصحيح المشروط بالـ OCR؛ فعندما تكون أخطاء الـ OCR قابلة للاسترجاع والتصحيح بصرياً ونصياً — بأن تكون الحروف الخاطئة شبيهة بالحروف المستهدفة، أو الكلمات الخاطئة قريبة من السياق — يستطيع نموذج الـ VLM اعتماد تلك المسودة كهيكل داعم ومقارنتها بالصورة الحقيقية لتصويبها. وقد أثبتت الورقة تحقق ذلك في الكتب المطبوعة القديمة، والمطبوعات الحديثة النقية، والوثائق العربية مختلطة المجالات، وبعض مخطوطات خط النسخ؛ فجميعها حالات جاءت فيها أخطاء الـ OCR، رغم وقوعها، مرتبطة ارتباطاً وثيقاً بالمحتوى الفعلي على الصفحة.
وينهار هذا المبدأ في الحالة المعاكسة: حين تكون مسودة الـ OCR خاطئة بطريقة لا صلة لها بالنص الأصلي، فيصبح التصحيح وبالاً على النص بدلاً من أن يفيده. وتوضح حالتان ذلك بجلاء: ففي المخطوطات المكتوبة بالخط المغربي، يُنتج نظام الـ OCR — المضبوط أساساً لخط النسخ — نصاً مشوشاً لعدم تطابق الخطوط لا يمت بصلة لما في الصفحة، فيرتهن الـ VLM لمدخلات عشوائية بلا معنى. وفي عينات خطوط الطلاب اليدوية الواقعية، تبيّن أن مسودة الـ OCR مضللة بصورة منهجية وليست مجرد غير دقيقة فحسب؛ إذ بدت ظاهرياً كأنها جديرة بالثقة، لكنها اشتملت على أخطاء عجز نموذج الـ VLM عن تمييزها وتصويبها. وفي كلتا الحالتين، كان من الأفضل للنموذج تجاهل مخرجات الـ OCR كلياً والاعتماد على قراءة الصورة مباشرة.
أنماط فشل فرعية تستحق الانتباه
إلى جانب الاستنتاج الرئيسي، تلفت الورقة الانتباه إلى عثرات عملية في سلوك نماذج VLM-OCR العربية، وهي مشكلات تبدو للوهلة الأولى كهبوط غامض في الدقة ما لم يكن المرء على دراية بوجوب فحصها.
الحساسية لعلامات التشكيل تأتي في مقدمة ذلك: فنظراً لأن علامات الحركات القصيرة تحمل قيمة دلالية فارقة، فإن تعامل الصورة معها — سواء كانت واضحة، أو باهتة، أو استُبعدت خلال المعالجة المسبقة — يُحدث تفاوتاً ملموساً في جودة المخرجات. كما أن خيارات المعالجة المسبقة بوجه عام (كتعديل التباين، والقص، والتحويل الثنائي للألوان binarization) تؤثر في النتائج بدرجة تتجاوز المتوقع لمهمة يُفترض أنها تقتصر على مجرد «قراءة النص».
وهناك عائقا توليد نصيين يرتبطان بآلية عمل نماذج VLMs ذاتها؛ أولهما «ميزانية التوليد» (Generation budget)، والمقصود بها الحد الأقصى للرموز (tokens) المسموح للنموذج بإنتاجها؛ فإذا ضُبطت عند حد منخفض للغاية، فإنها تبتر تفريغ صفحة المخطوطة في منتصف الجملة. والآخر هو «حلقات التكرار» (Repetition loops)، وهو نمط تعثر مألوف في النماذج اللغوية حيث يعلق النموذج في تكرار الكلمة أو الحرف أو العبارة نفسها دون تجاوزها؛ وهو نمط يظهر تحديداً في أنظمة VLM-OCR العربية ويُفسد تفريغ النص بصمت ما لم يخضع طول المخرجات للرقابة.
أهمية هذه النتائج عند بناء أو اختيار مسار معالجة للتعرف الضوئي على الحروف
يتجاوز الدرس المستفاد هنا حدود المخطوطات العربية؛ فإلحاق مرحلة تصحيح بنموذج VLM بعد الـ OCR ليس ترقية مضمونة ومجانية، بل هو رهان على أن أخطاء الـ OCR من النوع القابل للاسترجاع والإصلاح — أي أنها أخطاء تدور في الفلك الصحيح — وليست أخطاء مضللة بصورة منهجية. ويعتمد نجاح هذا الرهان على نوع الخط، وحالة الوثيقة، وطبيعة إخفاقات محرك الـ OCR المستخدم مع المادة المعنية. وتتفاقم هذه الصعوبة في الكتابة العربية لأنها خط متصل يُكتب من اليمين إلى اليسار وتعتمد أشكال حروفه ومحارفه المركبة وتشكيلاته الاختيارية كلياً على السياق والموضع، مما يجعل التعرف الضوئي عليها أصعب بطبيعته ويزيد من حساسية هذا الرهان.
الحل الذي يقترحه الباحثون هو مسار عمل تكيفي (adaptive workflow): توجيه كل صفحة نحو استراتيجية تناسبها وفق إشارات تشخيصية؛ مثل نوع الخط المدون، وقابلية مخرجات الـ OCR للاسترجاع، ومقارنة طول مخرجات الـ VLM بالطول المتوقع، ومؤشرات أنماط الإخفاق المعروفة مثل حلقات التكرار. وبمعنى أبسط: لا تختر طريقة واحدة وتعممها على كل شيء، بل افحص نوع الوثيقة وسلوك الـ OCR معها أولاً، ثم وجّه المعالجة على هذا الأساس.
هذا هو ذاته المنطق الداعي لتقييم محركات الـ OCR عبر أنواع متباينة من الوثائق بدلاً من اعتماد محرك واحد «مثالي» وتعميمه؛ فالموديل المتفوق في النماذج المطبوعة النقية قد يكون أسوأ خيار للملاحظات المكتوبة باليد أو الصفحات الباهتة، وهذا الخلل قد يظل مستتراً ما لم تقارن المخرجات بالحقيقة الأرضية (ground truth) للوثيقة المحددة التي تسعى لمعالجتها فعلياً.
ما لم تحسمه هذه الدراسة بعد
ثمة تحفظات صريحة وموضوعية تجب مراعاتها؛ فهذا البحث يركز على اللغة العربية، ومع أن مبدأ قابلية الاسترجاع يبدو بديهياً بما يكفي لافتراض إمكانية تعميمه على خطوط أخرى، فإن الورقة لم تختبر ذلك عملياً. كما أن استخدام ثماني مجموعات بيانات يمثل تغطية جيدة، إلا أن تقاليد المخطوطات العربية تمتد عبر خطوط وقرون تفوق قدرة ثماني مجموعات على تمثيلها بالكامل؛ لذا يجب اعتبار نتائج المقارنة بين الخطين المغربي والنسخ دلالة قوية ومعياراً استرشادياً، لا قاعدة مطلقة.
وهناك أيضاً فجوة بين استعراض «المؤشرات التشخيصية التي تتنبأ بفشل التصحيح» وبناء «نظام آلي يرصد ذلك بدقة ولحظياً قبل إهدار وقت التصحيح وتكلفته». لقد حددت الورقة المؤشرات الجوهرية — كعدم تطابق الخطوط، وقابلية التخمين المسبق للاسترجاع، وطول المخرجات، وأنماط التكرار — لكن بناء موجِّه تكيفي (adaptive router) يلتقط هذه العوامل تلقائياً وبتكلفة منخفضة في بيئات الإنتاج الفعلية هو تحدٍّ هندسي لاحق أشارت إليه الورقة دون أن تحسمه.
ومع ذلك، تظل الخلاصة العامة ثابتة: خطوة التصحيح بالذكاء الاصطناعي ترث أنماط الإخفاق الكامنة في أي مدخلات تتلقاها؛ وقبل أن تغذي نموذج VLM بمخرجات الـ OCR كتلميح يُسترشد به، يجدر بك التحقق أولاً مما إذا كانت أخطاء الـ OCR تستحق الاستماع إليها والاعتماد عليها أصلاً.