Alimentar un corrector de IA con una mala estimación de OCR: cuándo ayuda y cuándo arruina la página
Basado en: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
Imaginemos un proyecto de digitalización en una biblioteca del norte de África. Alguien escanea unos cuantos miles de páginas de manuscritos centenarios y las procesa mediante el flujo habitual: OCR y, a continuación, un modelo de IA para corregir los errores. En algunas páginas, la IA detecta con exactitud lo que el OCR interpretó mal y devuelve un texto limpio y legible. En otras, la IA toma la estimación ininteligible del OCR, la interpreta como una pista de lo que dice la página y genera, con total seguridad, una transcripción peor que si jamás hubiera visto la salida del OCR.
Ese segundo resultado es el giro inesperado que revela un nuevo artículo procedente de Catar, When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study. Los investigadores evaluaron OCR tradicional, modelos de visión y lenguaje de propósito general, versiones especializadas en árabe de dichos modelos y un enfoque híbrido donde la IA «corrige» un borrador de OCR, a lo largo de ocho tipos distintos de documentos en árabe. Ninguno resulta ganador en todos los casos. Sin embargo, el artículo aporta algo mucho más útil que proclamar un vencedor: explica por qué el enfoque de corrección ayuda en ciertos documentos y perjudica directamente en otros, y además da un nombre a este patrón.
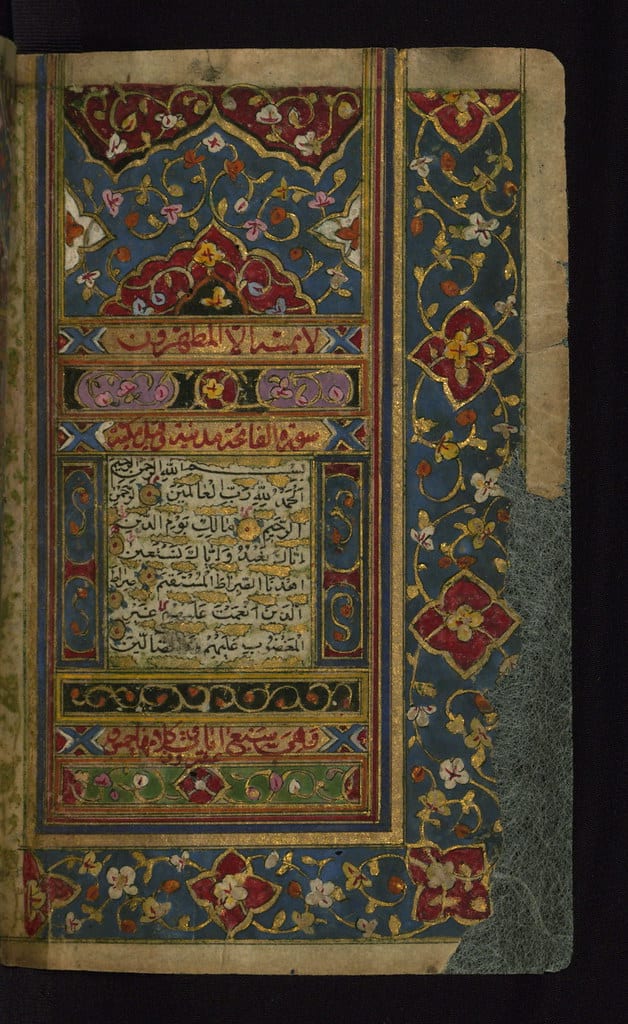
Illuminated Manuscript Koran, The right side of a double-page illumination, Walters Art Museum MS. W.575, fol. 2b — por Walters Art Museum Illuminated Manuscripts vía flickr, CC0 1.0.
Por qué los manuscritos en árabe son un problema de OCR realmente difícil
El OCR para árabe conlleva una lista de complicaciones más extensa que el OCR para escritura latina, y los manuscritos añaden aún más dificultades.
El árabe se escribe en una caligrafía cursiva y ligada, por lo que las letras cambian de forma según su posición dentro de la palabra. Tampoco existe una única «escritura árabe». El árabe impreso moderno utiliza principalmente Naskh, un estilo claro y redondeado. Sin embargo, los manuscritos históricos solían copiarse en estilos regionales con trazos muy diferentes, y este artículo profundiza en el contraste entre el Naskh y el Maghribi, una familia de escrituras empleada en el norte de África y Al-Ándalus con formas de letras, espaciados y convenciones de puntuación diacrítica muy particulares. Un sistema de reconocimiento entrenado principalmente en Naskh puede tener verdaderas dificultades para leer Maghribi, del mismo modo que alguien fluido en una variante de alfabeto puede desorientarse ante una caligrafía regional desconocida.
A esto se suman los signos diacríticos: pequeñas marcas por encima y por debajo de las letras que indican vocales cortas y otros detalles de pronunciación. Suelen omitirse en la escritura cotidiana, pero cuando aparecen en un manuscrito, acertar o fallar con ellos altera por completo el significado de una palabra; además, el estudio descubrió que los modelos de IA son notablemente sensibles a si estas marcas están presentes o distorsionadas.
Añádanse los problemas habituales del papel antiguo: tinta desvanecida, daños por humedad, interlineado irregular y caligrafías que van desde el trazo minucioso de un escriba profesional hasta los apuntes apresurados de un estudiante. Los ocho conjuntos de datos de este estudio abarcan precisamente todo ese espectro: desde manuscritos históricos y libros impresos antiguos hasta impresiones modernas limpias, documentos de dominio mixto y muestras manuscritas.
Los cuatro enfoques evaluados en el estudio
El artículo no propone un método nuevo por sí mismo. Se trata de una comparativa de cuatro estrategias existentes, evaluadas sobre el mismo conjunto de documentos para que los resultados sean realmente comparables.
OCR tradicional se refiere aquí a Tesseract, el motor de OCR de código abierto que reconoce caracteres mediante coincidencia de patrones entrenada con formas tipográficas y caligráficas. No comprende el texto que lee; simplemente empareja formas con caracteres.
Los modelos de lenguaje y visión (VLM) de propósito general son modelos de IA que reciben una imagen junto con un prompt de texto y generan una salida textual, la misma familia tecnológica detrás de herramientas como GPT-4 con visión o Gemini. Se le presenta la página del manuscrito y se le pide transcribir lo que ve. A diferencia de Tesseract, un VLM posee cierta comprensión del lenguaje, lo que le permite apoyarse en el contexto para deducir una palabra borrosa a partir de las palabras contiguas.
Los VLM especializados en árabe son variantes de esa misma tecnología sometidas a fine-tuning específicamente con texto y caligrafía en árabe, bajo la premisa de que los modelos generales entrenados mayoritariamente con documentos en inglés y caracteres latinos tal vez no hayan visto suficiente material de manuscritos árabes para obtener buenos resultados.
La corrección condicionada por OCR es el enfoque híbrido: primero se ejecuta Tesseract y luego se entrega su salida a un VLM junto con la imagen original para pedirle que corrija los errores del OCR. La teoría es que el VLM parte con ventaja: cuenta con un borrador preliminar para editar en lugar de una página en blanco que deba transcribir desde cero.
Qué enfoque ganó realmente, y en qué casos
La conclusión principal resulta reconfortantemente honesta: ningún enfoque domina de forma absoluta. Sin embargo, el patrón varía de manera concreta según el tipo de documento analizado.
En manuscritos históricos a nivel de línea —es decir, donde las imágenes muestran solo una línea de texto a la vez en lugar de una página completa—, los VLM rinden a un nivel similar al de Tesseract. Ninguno saca una ventaja clara. Pero al pasar a imágenes de manuscritos a nivel de página, donde el modelo debe procesar el diseño y el contexto de una página entera simultáneamente, los VLM superan al OCR tradicional. Esa diferencia tiene sentido: un VLM puede apoyarse en las palabras circundantes y en la estructura general de la página para desambiguar un carácter difícil, mientras que Tesseract trabaja trazo a trazo sin ese contexto.
En el corrector condicionado por OCR es donde la cuestión se vuelve interesante. En varios escenarios, supera tanto al OCR aislado como a los VLM independientes. Proporcionar al VLM un borrador preliminar para editar, en lugar de pedirle una transcripción en frío, ofrece los mejores resultados entre los tres enfoques, pero solo en determinadas condiciones. En otras, este mismo recurso empeora los resultados en comparación con cualquiera de los dos componentes por separado. Dicha inconsistencia constituye el verdadero núcleo del artículo.
La idea central: el prior del OCR debe ser recuperable
Los investigadores denominan a esto el «principio de recuperabilidad del prior del OCR» (OCR-prior recoverability principle), y es la idea más valiosa del artículo para cualquiera que diseñe un pipeline en producción.
Pensemos en el borrador preliminar del OCR como en un boceto que se entrega a un pintor antes de que pinte a partir de una foto de referencia. Si el boceto plasma a grandes rasgos las formas correctas, aunque falle en algunos detalles, le proporciona al artista puntos de anclaje útiles sobre los que trabajar. Pero si el boceto está rotundamente equivocado —mostrando una casa donde en la foto hay un barco—, no ayuda en nada al artista. Al contrario, lo induce activamente a error, porque ahora intenta conciliar un punto de partida erróneo con lo que realmente está viendo.
Eso es exactamente lo que ocurre con la corrección condicionada por OCR. Cuando los fallos del OCR son recuperables a nivel visual y textual —es decir, cuando los caracteres erróneos que predijo aún guardan parecido con los correctos, o las palabras incorrectas están en un rango plausible—, el VLM puede utilizar ese borrador como andamiaje y corregirlo cotejándolo con la imagen real. El artículo demostró que esto se cumple en libros impresos antiguos, textos impresos limpios, documentos en árabe de dominio mixto y ciertos manuscritos en Naskh. En todos estos casos, el OCR, aun cuando comete errores, se equivoca de una forma correlacionada con el contenido real de la página.
El principio se quiebra en el caso opuesto: cuando el borrador del OCR falla de tal modo que no guarda relación alguna con el texto real, la corrección empeora en lugar de mejorar. Dos ejemplos lo ilustran con claridad. En los manuscritos en Maghribi, el sistema de OCR, ajustado principalmente para caligrafía estilo Naskh, genera un galimatías incompatible con el estilo que no se parece en nada a lo que hay en la página, con lo cual el VLM queda anclado a puro ruido. Y en muestras realistas de caligrafía de estudiantes, el borrador del OCR resulta ser sistemáticamente engañoso y no meramente impreciso: tiene una apariencia lo bastante verosímil como para parecer fiable, pero contiene errores que el VLM no puede detectar ni contrastar adecuadamente. En ambos escenarios, el modelo habría obtenido probablemente mejores resultados ignorando por completo el OCR y leyendo directamente la imagen.
Modos de fallo secundarios que conviene conocer
Más allá del hallazgo principal, el artículo señala una serie de anomalías prácticas en el comportamiento de los VLM aplicados al OCR en árabe; el típico problema que se manifiesta como una misteriosa caída en la precisión hasta que se sabe exactamente qué buscar.
La sensibilidad a los signos diacríticos es uno de ellos: dado que esas pequeñas marcas vocálicas aportan significado semántico real, la forma en que se presentan en la imagen —visibles, descoloridas o eliminadas durante el preprocesamiento— altera de forma cuantificable la calidad de la salida. Las decisiones de preprocesamiento en general (ajuste de contraste, recorte, binarización) también influyen en los resultados mucho más de lo que cabría esperar en una tarea que supuestamente consiste solo en «leer el texto».
Otros dos problemas se deben a la propia naturaleza de cómo generan texto los VLM. El límite de generación (generation budget) se refiere al número máximo de tokens que el modelo puede producir antes de truncarse; si se configura demasiado bajo, el modelo corta la página del manuscrito a mitad de una frase. Y los bucles de repetición (repetition loops) son un modo de fallo conocido en modelos de lenguaje en el que el modelo se queda bloqueado generando la misma palabra, carácter o frase una y otra vez en lugar de avanzar; un fenómeno que se manifiesta específicamente en el OCR con VLM para árabe y que arruina silenciosamente la transcripción si no se monitoriza la longitud de la salida.
Por qué esto importa si estás diseñando o seleccionando un pipeline de OCR
La lección práctica va más allá de los manuscritos en árabe. Incorporar una etapa de corrección con VLM tras la salida del OCR no es una mejora gratuita. Es una apuesta a que los errores del OCR pertenezcan a la categoría de los recuperables —equivocados, pero bien orientados—, en lugar de ser sistemáticamente engañosos. Que esa apuesta dé frutos depende del tipo de escritura, del estado del documento y de cómo tienda a fallar ese motor de OCR concreto con dicho material.
La solución que proponen los investigadores consiste en un flujo adaptativo: enrutar cada página hacia una estrategia distinta según indicadores como el tipo de escritura utilizada, si la salida del OCR parece recuperable, cómo se compara la longitud de salida del VLM con la esperada y señales de modos de fallo conocidos como los bucles de repetición. En términos sencillos: no elijas un único método para aplicarlo a todo. Analiza qué tipo de documento tienes delante y cómo se comporta tu OCR ante él, y enruta en consecuencia.
Ese es el mismo principio que justifica evaluar motores de OCR a través de múltiples tipos de documentos en lugar de coronar a uno solo como «el mejor» y dar el trabajo por terminado. Un modelo excelente con formularios impresos nítidos puede ser la peor elección para notas manuscritas o escaneos degradados, y ese fallo no siempre resulta evidente a menos que se contrasten las salidas con el ground truth en la tipología específica de documentos que realmente se necesita procesar.
Lo que este estudio deja sin resolver
Conviene hacer algunas salvedades sinceras. Se trata de un trabajo centrado en el árabe y, aunque el principio de recuperabilidad resulta lo bastante intuitivo como para generalizarse probablemente a otras escrituras, el artículo no lo comprueba empíricamente. Ocho conjuntos de datos constituyen una muestra sólida, pero la tradición manuscrita árabe abarca más familias de escrituras y siglos de los que ocho colecciones pueden representar por completo; por tanto, conviene considerar el hallazgo específico sobre Maghribi frente a Naskh como un dato contundente y no como una ley universal.
Existe también una brecha entre «estas son las señales de diagnóstico que predicen cuándo falla la corrección» y «este es un sistema capaz de detectarlas con fiabilidad en tiempo real antes de desperdiciar una pasada de corrección». El estudio identifica las señales pertinentes —discrepancia tipográfica (script mismatch), recuperabilidad del prior, longitud de salida, patrones de repetición—, pero construir un enrutador adaptativo que capture todo esto de forma automática y económica a escala de producción es un desafío de ingeniería posterior que el artículo plantea, pero no resuelve.
La conclusión de fondo sigue siendo válida en cualquier caso: una etapa de corrección mediante IA hereda los modos de fallo de lo que recibe como entrada. Antes de conectar la salida de un OCR a un VLM a modo de «pista útil», vale la pena comprobar si el OCR se equivoca de una forma que realmente merezca la pena escuchar.