将糟糕的 OCR 猜测喂给 AI 校正器:何时能成助力,何时毁掉整页
参考论文: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
想象一下北非某图书馆里的一项数字化工程:工作人员扫描了数千页拥有数百年历史的古老手稿,并按照常规流程进行处理——先跑一遍 OCR,再用 AI 模型来清理识别错误。在某些页面上,AI 精准捕捉到了 OCR 遗漏或辨识不清的地方,返回了干净、可读的文本;但在另一些页面上,AI 却把 OCR 识别出的乱码猜测当成了理解页面的关键提示,自信地生成了一份甚至比完全不参考 OCR 输出时更糟糕的转写结果。
这后一种情况,正是来自卡塔尔的一篇新论文 When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study 揭示的意料之外的转折。研究人员在 8 类不同的阿拉伯语文档上,对比测试了传统 OCR、通用视觉语言模型(VLM)、针对阿拉伯语专门微调的模型,以及由 AI “修正” OCR 初稿的混合方案。结果显示,没有任何一种方法能在所有场景下通吃。但这篇论文做了一件比评选“赢家”更有价值的事:它解释了为什么校正方案在某些文档上能带来提升,而在另一些文档上反而起到负面作用,并为这一规律确立了概念框架。
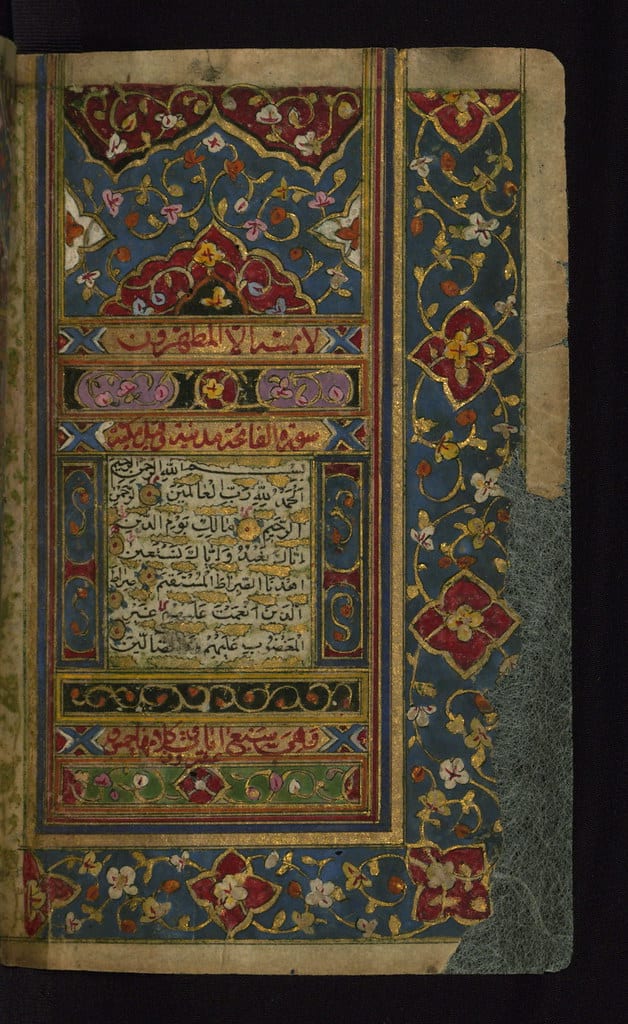
泥金装饰手抄本《古兰经》,双页泥金装饰右页,沃尔特斯艺术博物馆 MS. W.575, fol. 2b —— 来源:沃尔特斯艺术博物馆泥金手稿,通过 flickr,CC0 1.0。
为什么阿拉伯语手稿是极具挑战的 OCR 难题
相比拉丁字母文字的 OCR,阿拉伯语 OCR 本就面临更多棘手问题,而历史手稿更是让难度成倍叠加。
阿拉伯语采用连笔书写系统,字母的形状会随着其在词中所处的位置而发生变化。此外,并不存在单一标准的“阿拉伯文字”。现代阿拉伯语印刷体多采用纳斯赫体(Naskh),这是一种清晰、圆润的书写风格。然而历史手稿往往由不同地域风格抄写,字形差异极大。该论文重点对比了纳斯赫体与马格里布体(Maghribi)之间的差异——后者曾广泛流传于北非和伊斯兰时期的西班牙,在字母形态、间距和加点规则上均有鲜明特征。主要基于纳斯赫体训练的识别系统,在面对马格里布体时往往十分吃力,正如一个熟悉某种字母变体的人在面对陌生的地域手写风格时也会难以辨认一样。
此外还有变音符号(Diacritics):位于字母上方或下方的微小标记,用来标示短元音及其他发音细节。虽然日常书写中常被省略,但手稿中一旦出现,标对与否往往会直接改变词义。论文发现,AI 模型对这些符号是否存在或是否出现乱码格外敏感。
再加上古籍纸张的常见退化问题:墨迹褪色、水渍破损、行距不均,以及从训练有素的抄写员工整字迹到学生潦草笔记参差不齐的书写水平。本研究所用的 8 个数据集恰好覆盖了这一全谱系,涵盖历史手稿、老旧印刷书籍、清晰的现代印刷品、混合领域文档以及手写样本。
他们实际测试的四种方法
该论文并未提出单一的新方法,而是针对同一批文档横向评测了四种现有策略,从而确保结果具备真正的可比性。
传统 OCR:这里指的是 Tesseract,这是一款基于字体和字符形状训练的模式匹配开源 OCR 引擎。它并不理解所阅读的文本内容,只是单纯将形状映射到字符。
通用视觉语言模型(VLM):指同时接收图像和文本提示(Prompt)并生成文本输出的 AI 模型,也就是 GPT-4 with vision 或 Gemini 等工具背后的同类技术。你向模型出示手稿页面,并要求它转写所看到的内容。与 Tesseract 不同,VLM 具备一定的语言理解能力,因此能够借助上下文语境,根据周围词汇推断出模糊不清的单词。
阿拉伯语专用 VLM:指基于阿拉伯语文本和字形进行了专门微调的 VLM。其设计初衷在于,主要针对英语和拉丁语系文档训练的通用模型,可能没有见过足够多的阿拉伯语手稿数据,因此难以表现出色。
以 OCR 为条件的校正(OCR-conditioned correction):这是一种混合方案——先运行 Tesseract,然后将其输出与原始图像一同交由 VLM,要求其修复 OCR 的错误。理论假设在于,VLM 能借此获得先发优势,得到一份待修改的“初稿”,而不是从零开始面对一张白纸进行转写。
究竟谁赢了?在哪些场景胜出?
论文的核心结论非常坦率:没有任何单一方法能够全面占优。但不同方案的表现会随文档类型的变化呈现出极具规律性的转变。
在行级别(line-level)历史手稿上(即图像每次仅展示单行文本而非整个页面),VLM 的表现与 Tesseract 基本持平,双方均未拉开明显差距。然而,一旦换到页面级(page-level)手稿图像——模型必须同时处理整页的版面布局和全局上下文——VLM 便明显超越了传统 OCR。这种差距完全合乎逻辑:VLM 可以利用周围词汇与整页结构来消除疑难字符的歧义,而 Tesseract 只是脱离上下文逐字进行形状匹配。
真正引人注目的则是“以 OCR 为条件的校正器”。在数个评测场景中,它的表现同时击败了独立的 OCR 和独立的 VLM。向 VLM 提供一份待编辑的初稿,而非让其冷启动直接转写,在三类方法中取得了最优结果——但这仅发生在部分场景下。在另一些场景中,同样的手法反而使结果比单独使用任一组件还要糟糕。这种不一致性,正是这篇论文重点探究的课题。
核心观点:OCR 先验必须具备“可恢复性”
研究人员将此称为“OCR 先验可恢复性原则”(OCR-prior recoverability principle),对于任何构建实际工程管线的人来说,这也是论文中最具实用价值的见解。
不妨把 OCR 给出的初稿想象成递给画师的一幅草图,画师接下来需要参照实际照片作画。如果草图大致勾勒出了正确的轮廓,哪怕部分细节有误,也能为画师提供有用的定位参考。但如果草图错得非常离谱且“自信”——比如照片上明明是一艘船,草图上却画了一栋房子——这不仅帮不上画师,反而会产生严重的误导,因为画师此时必须费力去调和错误的起点与眼睛看到的真实画面。
以 OCR 为条件的校正正是如此。当 OCR 的错误在视觉和文本层面是“可恢复的”——意味着它猜错的字符在形态上仍与正确字符相似,或者猜错的词语依然在合理的语义范围内——VLM 就能将该初稿作为支架,对照真实图像进行校正。论文发现,老旧印刷书籍、清晰印刷品、混合领域阿拉伯语文档以及部分纳斯赫体手稿均符合这一规律。在这些情况下,OCR 即使犯错,其错误也与页面上的真实内容紧密相关。
但在相反的情况下,该原则便不复成立:当 OCR 初稿的错误与真实文本毫无关联时,校正只会让结果变得更糟。论文列举了两个具体的典型案例:在马格里布体手稿上,主要针对纳斯赫体调优的 OCR 系统产生了字体不匹配的乱码,与页面真实内容毫无实质相似性,导致 VLM 最终锚定在了噪声上;而在真实的学生手写样本上,OCR 初稿则呈现出系统性的误导而非单纯的精度不足——表面上看起来足够逼真、看似可信,但其错误方式却是 VLM 无法察觉和对照校正的。在这两种情况下,模型如果完全忽略 OCR 输出而直接去读图像,表现反而很可能更好。
值得留意的其他次要失效模式
除了主要发现之外,论文还指出了阿拉伯语 VLM-OCR 运行中的若干实用“坑点”。如果不知道去排查它们,往往会表现为准确率发生令人费解的骤降。
其一是变音符号敏感性:由于这些微小的元音标记承载着明确含义,图像中对它们的不同处理状态(清晰保留、墨迹褪色、或在预处理中被滤除)都会显著影响输出质量。通常而言,图像预处理方案(对比度调整、裁剪、二值化)对结果的影响,远比人们对“单纯读取文本”任务的预期要大得多。
另外两个问题则源自 VLM 生成文本本身的机制。其一是“生成预算”(Generation budget),即模型被截断前允许输出的最大 Token 数量;如果设置过低,模型就会在句子中途直接截断对手稿页面的转写。其二是“循环重复”(Repetition loops),这是语言模型中常见的失效模式,模型会卡在原地不断重复输出同一个词、字符或短语而无法继续;这一现象在阿拉伯语 VLM-OCR 中尤为突出,如果在流程中不检查输出长度,转写质量很容易在悄无声息中被彻底破坏。
为什么这对构建或选型 OCR 管线至关重要
这里的工程启示不仅限于阿拉伯语手稿。在 OCR 输出之后直接叠加一层 VLM 校正步骤,绝非稳赚不赔的免费升级。它本质上是一场赌注:赌你的 OCR 错误属于“可恢复”类型——虽有偏差但在合理范围内,而非系统性的误导。这场赌局能否获益,取决于具体的文字体系、文档品相,以及特定 OCR 引擎在该材料上的典型失效模式;对于字符集多达数千字、版面布局密集的汉字等表意文字而言,若初筛 OCR 已产生字形或语义上的系统性偏差,盲目引入 VLM 校正同样极易弄巧成拙。
研究人员提出的解决方案是自适应工作流:基于多种信号将每个页面路由至不同的处理策略,这些信号包括页面采用何种书写字体、OCR 输出是否看似可恢复、VLM 的输出长度与预期相比是否异常,以及是否存在循环重复等已知失效模式指标。简而言之:不要只挑一种方法就套用到所有文档上。应当先弄清当前处理的是哪类文档、你的 OCR 引擎在处理它时容易出现何种倾向,然后据此进行动态路由。
这也是为什么我们需要跨文档类型对 OCR 引擎进行基准测试,而不是随意选一个“综合最佳”便草草了事。一个在清晰打印表格上表现优异的模型,在面对手写笔记或严重老化的扫描件时可能完全是错误的选型;而且,除非你真正针对自己需要处理的特定文档类型拿实际输出与真值(Ground Truth)进行比对,否则这种失效往往不易被察觉。
这项研究尚未解决的问题
这里也有几点需要客观指出的局限性。这项工作专门针对阿拉伯语展开,尽管“可恢复性原则”在直觉上足够合理、很可能也适用于其他文字体系,但论文并未对其进行泛化测试。8 个数据集虽是不小的规模,但阿拉伯语手稿传统跨越的书写流派和世纪浩如烟海,绝非 8 个集合所能完全代表,因此对于马格里布体与纳斯赫体的具体对比结论,应将其视为一个有力的参考数据点,而非普遍适用的铁律。
此外,“明确哪些诊断信号能预测校正失效”与“构建一个在浪费校正开销前就能实时、可靠捕获这些信号的系统”之间,依然存在工程鸿沟。论文识别出了相关的信号(如书写字体不匹配、先验可恢复性、输出长度、重复模式),但在生产环境中以低成本、全自动的方式构建出捕获这些信号的自适应路由器,则是论文指明方向但尚未解决的后续工程难题。
无论如何,更广泛的启示依然成立:AI 校正环节会继承你输入给它的一切失效模式。在把 OCR 输出作为“有益参考”接入 VLM 之前,务必先验证一下:你的 OCR 所犯的错误,到底还值不值得被倾听。