不正確なOCR結果をAI補正にかける:有効に機能するケースと、かえってページ全体を破綻させるケース
元論文: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
北アフリカの図書館におけるデジタル化プロジェクトを思い浮かべてみてほしい。数千ページに及ぶ数世紀前の古文書がスキャンされ、標準的なパイプライン(まずOCRを実行し、次にAIモデルで誤りを修正する)にかけられる。一部のページでは、AIがOCRの見落としを的確に補正し、整った読みやすいテキストを生成してくれる。しかし別のページでは、AIがOCRの支離滅裂な推測結果を「本文の内容を示すヒント」と受け取り、OCR結果をまったく参照しなかった場合よりも確信を持って改悪されたテキストを出力してしまう。
後者のような予想外の結末こそが、カタールの研究チームによる最新論文 When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study が浮き彫りにしたポイントだ。研究者らは8種類のアラビア語文書を対象に、従来型OCR、汎用AIビジョンモデル、アラビア語特化型モデル、そしてAIがOCRの下書きを「補正」するハイブリッド手法の4つを検証した。あらゆる条件で全勝した手法は存在しなかった。しかし本論文は、単に勝者を決めること以上に有益な知見を提供している。なぜ補正アプローチが一部の文書では有効に働き、別の文書ではかえって悪影響を及ぼすのかを解明し、そのパターンに明確な概念を与えているのだ。
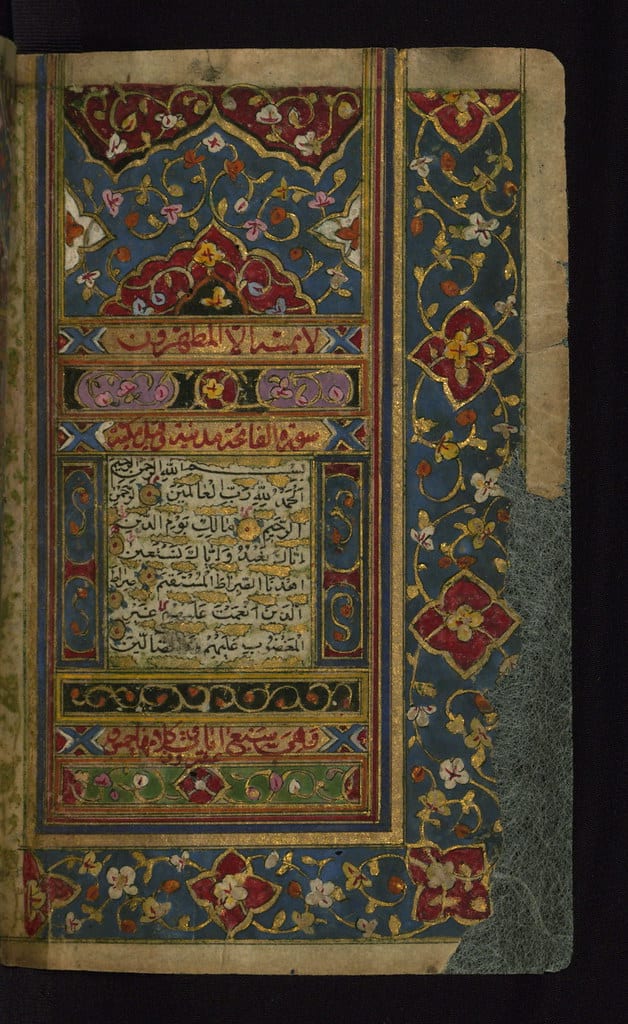
装飾写本コーラン、見開き装飾ページの右側、ウォルターズ美術館所蔵 MS. W.575, fol. 2b — Walters Art Museum Illuminated Manuscripts 提供(flickr 経由、CC0 1.0)
アラビア語古文書のOCRが極めて困難である理由
ラテン文字のOCRと比べても、アラビア語のOCRには厄介な課題が山積みであり、古文書となれば難易度はさらに跳ね上がる。
アラビア語は続け字(筆記体)で記述されるため、単語内での位置によって文字の形状が変化する。さらに「アラビア書体」と一口に言っても1種類ではない。現代の印刷物では主に、すっきりと丸みを帯びた書体であるナスフ体(Naskh)が用いられる。しかし歴史的な古文書は、字体が大きく異なる地域特有の書体で書かれていることが多い。本論文では、ナスフ体とマグレブ体(Maghribi)の対比に深く焦点を当てている。マグレブ体は北アフリカやイスラム統治下のスペインで広く用いられた書体群で、独自の字形、文字間隔、点の打ち方の慣習を持つ。主にナスフ体で訓練された認識システムは、ある文字体系に精通した人が不慣れな地域の筆跡に戸惑うのと同じように、マグレブ体の読解に著しく苦戦する。
さらに、ダイアクリティカルマーク(シャクル/母音記号)の存在もある。これは文字の上下に付される小さな記号で、短母音などの発音の詳細を示す。日常的な記述では省略されることも多いが、古文書においては、これらの記号を正しく認識できるかどうかで単語の意味そのものが変わってしまう。本論文の検証でも、AIモデルはこれらの記号の有無や誤読に対して極めて敏感であることが示された。
これに加えて、経年劣化した紙特有の一般的な問題——インクの薄れ、水濡れによる損傷、不均一な行間、さらには熟練した書記官の丁寧な筆跡から学生の走り書きに至るまでの多様な筆跡——が重なる。本研究で用いられた8つのデータセットは、歴史的写本や経年劣化した古書から、鮮明な現代の印刷物、異分野混在文書、手書き文書のサンプルに至るまで、まさにこうした幅広いバリエーションを網羅している。
実際に検証された4つのアプローチ
本論文は単一の新規手法を提案するものではない。結果を厳密に比較できるよう、同一の文書群に対して4つの既存手法を適用し、検証を行っている。
従来型OCR:ここではオープンソースのOCRエンジンであるTesseractを指す。フォントや書体の形状に基づいて学習されたパターンマッチングにより文字を認識する。読み取っているテキストの意味を理解しているわけではなく、字形を文字にマッピングしているにすぎない。
汎用視覚言語モデル(VLM):画像とテキストプロンプトを同時に入力し、テキストを出力するAIモデル群であり、GPT-4 with visionやGeminiの基盤となっているものと同じ系統の技術だ。古文書のページを提示し、見えている内容を書き起こす(transcribe)よう指示する。Tesseractとは異なり、VLMはある程度の言語理解力を備えているため、文脈を手がかりにして、かすれた単語を前後の言葉から推測することができる。
アラビア語特化型VLM:同じ技術をアラビア語のテキストおよび書体に特化してファインチューニングしたモデルだ。主に英語やラテン文字の文書で学習された汎用モデルでは、アラビア語古文書の学習データが不足しており十分な性能を発揮できないのではないか、という問題意識に基づいている。
OCR条件付け補正(OCR-conditioned correction):両者を組み合わせたハイブリッド手法。まずTesseractを実行し、その出力結果を原画像とともにVLMに渡して、OCRの誤りを修正させる。白紙の状態からゼロベースで書き起こすのではなく、推敲用の下書きを与えることでVLMに「有利なスタート地点」を与えるという理論に基づいている。
実際に何が、どこで優位に立ったのか
主たる結論は極めて率直なものだ。単一の支配的な手法は存在しなかった。しかし、対象とする文書の種類によって、明確なパターンの変化が見られた。
行単位(line-level)の歴史的古文書(ページ全体ではなく1行ごとの画像)では、VLMの性能はTesseractとおおむね同等であり、どちらかが大きく引き離すことはなかった。しかし、モデルがページ全体のレイアウトと文脈を同時に処理しなければならないページ単位(page-level)の古文書画像になると、VLMが従来型OCRを明確に上回る。この差には妥当な理由がある。Tesseractが文脈を持たずに文字の形状単位で処理を進めるのに対し、VLMは前後の単語やページ全体の構造を活用して、判読困難な文字の曖昧さを解消できるためだ。
興味深い結果が出たのはOCR条件付け補正だ。複数の設定において、この手法は単体のOCRや単体のVLMの両方を上回った。ゼロから文字起こしをさせるのではなく、編集用の下書きをVLMに渡すことで、3つのアプローチの中で最良の結果が得られたのだ。ただし、それはあくまで一部の設定に限られる。別の設定では、この同じ手法を用いたことで、どちらか単体で実行した場合よりも結果が悪化してしまった。この一貫性のなさの解明こそが、本論文の真のテーマである。
コアとなる概念:OCRの事前情報は「復元可能」でなければならない
研究者らはこれを「OCR事前情報の復元可能性原則(OCR-prior recoverability principle)」と呼んでおり、実用的なパイプラインを構築する者にとって本論文で最も有用な洞察である。
OCRによる下書きは、画家が見本写真をもとに絵を描く前に手渡す下絵(スケッチ)のようなものだと考えてほしい。スケッチが多少の細部は間違っていても大まかな形状を捉えていれば、画家にとって有用な足がかりとなる。しかし、写真には船が写っているのにスケッチには自信満々に家が描かれているような致命的な間違いの場合、それは画家を助けるどころか、かえって誤導することになる。画家は見えている実際の写真と、誤った出発点との矛盾を無理に調和させようとしてしまうからだ。
これとまったく同じ現象がOCR条件付け補正でも起きている。OCRの誤りが視覚的・テキスト的に「復元可能(recoverable)」である場合——つまり誤認識された文字が正解の文字と形状的に類似しているか、誤った単語が大筋で正解に近い範囲に収まっている場合——、VLMはその下書きを足場(スキャフォールディング)として活用し、実際の画像と照らし合わせながら修正することができる。論文では、経年劣化した印刷本、鮮明な現代印刷物、異分野混在文書、および一部のナスフ体古文書において、この原則が成立することが確認された。これらはすべて、OCRが誤っていたとしても、その誤り方が「実際にページに書かれている内容」と何らかの関連性を保っているケースである。
この原則が破綻するのはその逆のケースだ。OCRの下書きが実際のテキストと何の関係もない見当違いな誤りである場合、補正によって精度は向上するどころか悪化する。論文では2つの具体例が挙げられている。まずマグレブ体の古文書では、主にナスフ体向けに調整されたOCRシステムが書体の不一致による文字化けのような出力を生成し、実際のページ内容と有意な類似性を持たないため、VLMは無意味なノイズにアンカリングされてしまう。もう一つは実際の学生による手書き文書サンプルで、OCRの下書きは単に不正確というだけでなく体系的に誤導するもの(一見それらしく信頼できそうに見えるが、VLMでは検出・修正できない形で間違っている)となってしまう。いずれのケースにおいても、モデルはOCRを完全に無視して画像のみを読み取った方が、はるかに良好な結果を出せていたはずだ。
押さえておくべき細かな失敗モード
主たる発見にとどまらず、本論文はアラビア語のVLM-OCRにおける実用上の細かな「落とし穴(グレムリン)」をいくつか指摘している。これらは事前に知らなければ、原因不明の精度低下として頭を抱えることになる類のものだ。
その一つが「ダイアクリティカルマークへの感度」だ。小さな母音記号が本質的な意味を担うため、画像内でそれらが鮮明に残っているか、かすれているか、あるいは前処理で除去されてしまっているかによって、出力品質が如実に変化する。また、コントラスト調整、クロッピング、二値化といった前処理の選択全般も、「単にテキストを読み取るだけ」のタスクだと考えられがちな割に、予想以上に結果を左右する。
ほかの2つの問題は、VLMのテキスト生成メカニズムそのものに起因する。「生成バジェット(Generation budget)」は、強制終了されるまでにモデルが出力できる最大トークン数を指すが、これを小さく設定しすぎると、古文書のページが文の途中で打ち切られてしまう。そして「反復ループ(Repetition loops)」は、言語モデルが次の文脈に進めず、同じ単語、文字、フレーズを延々と繰り返し出力し続ける既知の失敗モードだ。これはアラビア語VLM-OCRにおいて顕著に発生し、出力テキストの長さをチェックしていなければ、転記結果を人知れず崩壊させる原因となる。
OCRパイプラインを構築・選定する上でなぜ重要なのか
ここでの実践的な教訓は、アラビア語古文書の領域にとどまらない。OCR出力にVLMによる補正ステップを組み込むことは、無条件のアップグレードではないのだ。それは、OCRの誤りが「体系的に誤導するもの」ではなく、「見当違いではない復元可能なもの」であるという前提に賭ける行為にほかならない。その賭けが報われるかどうかは、書体や文書の状態、そして使用するOCRエンジンがその素材に対してどのような誤り方をする傾向にあるかにかかっている。日本の読者にとっては、多くのOCR・VLMにとって最大の難関となる縦書きレイアウトや膨大な漢字が本研究の検証対象外である点に留意が必要だが、文字体系や配置の特性次第で補正の成否が左右されるという構図はそのまま当てはまる。
研究者らが提案する解決策は、適応型ワークフロー(adaptive workflow)だ。記述されている書体、OCR出力が復元可能に見えるか、VLMの出力長が想定と一致しているか、反復ループのような既知の失敗パターンの兆候があるか、といったシグナルに基づいて、ページごとに異なる戦略へとルーティングする。平たく言えば、「単一の手法を選んで全ページに一律適用してはならない」ということだ。対象文書の特性と、手元のOCRがそれに対してどのような挙動を示すかを確認し、それに応じて適切に処理を振り分ける必要がある。
単一の「最良」を選んで済ませるのではなく、文書タイプ横断でOCRエンジンをベンチマークすべき理由もここにある。鮮明な活字帳票で優れたモデルが、手書きのメモや劣化したスキャン画像では不適切となる場合があり、実際に処理すべき特定の文書タイプにおいてグラウンドトゥルース(正解データ)と突き合わせて検証しない限り、その破綻には気づきにくい。
本研究が未解決のまま残している点
いくつかの率直な留意点もある。本研究はアラビア語に特化したものであり、「復元可能性の原則」自体は直感的に他の文字体系にも一般化できそうではあるものの、論文内では他言語での検証は行われていない。また8つのデータセットは手堅い範囲をカバーしているが、アラビア語古文書の伝統は何世紀にもわたり、8つのコレクションだけでは表現しきれないほど多様な書体群が存在する。したがって、マグレブ体とナスフ体の比較結果についても、普遍的な法則というよりは有力なデータポイントの一つとして捉えるべきだ。
また、「補正が失敗する兆候を予測する診断シグナルが特定されたこと」と、「無駄な補正処理を走らせる前に、それらのシグナルをリアルタイムかつ高精度に自動検出するシステムが存在すること」の間には依然として隔たりがある。論文では書体の不一致、事前情報の復元可能性、出力長、反復パターンといった関連シグナルを特定しているが、これらを本番稼働スケールで安価かつ自動的に捕捉するアダプティブルーティング機構の構築は、論文が提起する今後のエンジニアリング課題であり、本稿で解決されているわけではない。
それでも、より大局的な教訓は揺るぎない。AIによる補正ステップは、入力として与えられたものの失敗モードをそのまま受け継ぐということだ。「有益なヒント」としてOCRの出力をVLMに接続する前に、そのOCRの誤りがそもそも耳を傾ける価値のある類のものなのかどうか、確認しておく必要がある。