Alimentar um Corretor de IA com Palpites Ruins de OCR: Quando Ajuda e Quando Arruína a Página
Baseado em: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
Imagine um projeto de digitalização em uma biblioteca no norte da África. Alguém escaneia alguns milhares de páginas de manuscritos com séculos de idade e os processa no pipeline habitual: OCR, seguido por um modelo de IA para corrigir os erros. Em algumas páginas, a IA detecta exatamente onde o OCR tropeçou e entrega um texto limpo e legível. Em outras, a IA pega o palpite confuso do OCR, trata-o como uma pista sobre o conteúdo da página e produz, com toda a confiança, uma transcrição pior do que se nunca tivesse visto a saída do OCR.
Esse segundo desfecho é a reviravolta central de um novo artigo vindo do Catar, When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study. Os pesquisadores testaram OCR tradicional, modelos de visão e linguagem (VLMs) de uso geral, versões desses modelos especializadas em árabe e uma abordagem híbrida na qual a IA "corrige" um rascunho de OCR, em oito tipos diferentes de documentos em árabe. Nenhuma abordagem se sobressai em todos os cenários. Mas o artigo faz algo mais útil do que coroar um vencedor: ele explica por que a abordagem de correção ajuda em alguns documentos e prejudica ativamente em outros, além de dar um nome a esse padrão.
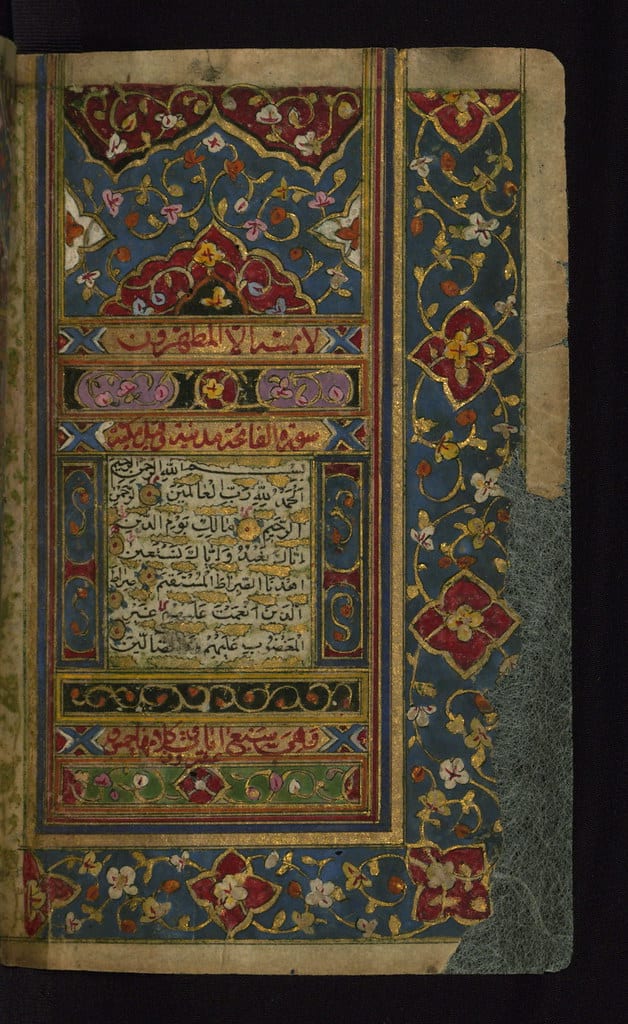
Illuminated Manuscript Koran, The right side of a double-page illumination, Walters Art Museum MS. W.575, fol. 2b — por Walters Art Museum Illuminated Manuscripts via flickr, CC0 1.0.
Por que manuscritos em árabe são um problema de OCR genuinamente difícil
O OCR para árabe carrega uma lista de dores de cabeça muito maior do que o OCR para o alfabeto latino, e os manuscritos acumulam ainda mais complicações.
O árabe é escrito em uma caligrafia cursiva e conectada, de modo que as letras mudam de forma dependendo da posição que ocupam na palavra. Também não existe apenas uma "escrita árabe". O árabe impresso moderno usa predominantemente o Naskh, um estilo limpo e arredondado. No entanto, os manuscritos históricos eram frequentemente copiados em estilos regionais com traçados de letras bastante diferentes, e este artigo explora a fundo o contraste entre o Naskh e o Maghribi — uma família de caligrafias usada no norte da África e na Espanha islâmica com convenções próprias de desenho, espaçamento e pontuação. Um sistema de reconhecimento treinado majoritariamente em Naskh pode ter sérias dificuldades para ler Maghribi, da mesma forma que alguém fluente em uma variante de alfabeto ainda pode se perder diante de uma caligrafia regional desconhecida.
Além disso, há os diacríticos: pequenos sinais acima e abaixo das letras que indicam vogais curtas e outros detalhes de pronúncia. Eles costumam ser omitidos na escrita cotidiana, mas, quando aparecem em um manuscrito, acertá-los ou errá-los altera o significado da palavra. O estudo constatou que os modelos de IA são notavelmente sensíveis ao fato de essas marcas estarem presentes ou corrompidas.
Some a isso os problemas usuais do papel antigo: tinta desbotada, danos causados por água, espaçamento irregular entre linhas e caligrafias que variam do traço meticuloso de um escriba experiente às anotações apressadas de um estudante. Os oito datasets deste estudo abrangem exatamente essa variedade, indo de manuscritos históricos e livros impressos antigos até impressões modernas nítidas, documentos de domínio misto e amostras de escrita manual.
As quatro abordagens efetivamente testadas
O artigo não propõe um método novo em si. Trata-se de uma comparação entre quatro estratégias existentes, avaliadas sobre o mesmo conjunto de documentos para que os resultados sejam de fato comparáveis.
OCR tradicional aqui se refere ao Tesseract, o motor de OCR de código aberto que reconhece caracteres por meio de correspondência de padrões treinados em formas de fontes e tipos de escrita. Ele não compreende o texto que lê; apenas associa formas visuais a caracteres.
Modelos de visão e linguagem (VLMs) de uso geral são modelos de IA que recebem uma imagem e um prompt de texto simultaneamente e produzem texto como resposta — a mesma família tecnológica por trás de ferramentas como GPT-4 with vision ou Gemini. Você apresenta a página do manuscrito e pede para ele transcrever o que vê. Ao contrário do Tesseract, um VLM possui certa compreensão de linguagem, podendo usar o contexto para deduzir uma palavra borrada com base nas palavras ao redor.
VLMs especializados em árabe são versões dessa mesma tecnologia ajustadas (fine-tuned) especificamente em textos e caligrafias árabes, partindo da premissa de que modelos gerais treinados predominantemente em documentos em inglês e no alfabeto latino podem não ter sido expostos a material suficiente de manuscritos em árabe para se saírem bem.
Correção condicionada por OCR é a abordagem híbrida: executa-se primeiro o Tesseract e, em seguida, entrega-se sua saída a um VLM junto com a imagem original, instruindo-o a corrigir as falhas do OCR. A teoria é que o VLM larga na frente, recebendo um rascunho para editar em vez de uma página em branco para transcrever do zero.
O que realmente venceu, e onde
O resultado principal é revigorantemente honesto: nenhuma abordagem isolada domina. No entanto, o padrão varia de forma específica dependendo do tipo de documento analisado.
Em manuscritos históricos no nível de linha — isto é, quando as imagens contêm apenas uma linha de texto por vez, em vez de uma página inteira —, os VLMs apresentam desempenho equivalente ao do Tesseract. Nenhum dos dois abre vantagem expressiva. Contudo, ao passar para imagens de manuscritos no nível de página, onde o modelo precisa lidar com o layout e o contexto de uma página inteira de uma só vez, os VLMs superam o OCR tradicional. Essa diferença faz todo o sentido: um VLM consegue utilizar as palavras adjacentes e a estrutura global da página para desambiguar um caractere difícil, enquanto o Tesseract analisa forma por forma, desprovido desse contexto.
É no corretor condicionado por OCR que o cenário fica interessante. Em diversas configurações, ele supera tanto o OCR isolado quanto os VLMs puros. Entregar ao VLM um rascunho para edição, em vez de exigir uma transcrição a frio, gera os melhores resultados entre as três abordagens — mas somente em alguns contextos. Em outros, esse mesmo artifício resulta em transcrições piores do que as de qualquer um dos componentes sozinho. Essa oscilação é o verdadeiro tema do artigo.
A ideia central: o prior do OCR precisa ser recuperável
Os pesquisadores batizam isso de princípio da recuperabilidade do prior de OCR (OCR-prior recoverability principle), sendo esta a ideia mais valiosa do estudo para quem projeta pipelines no mundo real.
Pense no rascunho do OCR como um esboço entregue a um pintor antes de ele pintar a partir de uma foto de referência. Se o esboço capturar razoavelmente as formas corretas, mesmo com falhas em alguns detalhes, ele fornece ao artista pontos de ancoragem úteis para o trabalho. Mas se o esboço estiver categoricamente errado — ilustrando uma casa onde a foto mostra um barco —, ele não ajuda em nada. Na verdade, induz ao erro, pois agora o pintor tentará reconciliar um ponto de partida incorreto com o que seus próprios olhos veem.
É exatamente isso o que se passa na correção condicionada por OCR. Quando as falhas do OCR são visual e textualmente recuperáveis — ou seja, os caracteres incorretos identificados ainda guardam semelhança com os corretos, ou as palavras erradas ainda estão dentro do esperado —, o VLM pode usar esse rascunho como andaime e corrigi-lo confrontando-o com a imagem real. O artigo comprovou que isso se sustenta em livros impressos antigos, impressões nítidas, documentos em árabe de domínio misto e alguns manuscritos em Naskh. Todos esses são casos nos quais o OCR, mesmo quando erra, comete erros que guardam relação direta com o que está na página.
O princípio se desfaz no caso inverso: quando o rascunho do OCR está errado de forma desconexa com o texto real, a correção degrada a transcrição em vez de refiná-la. Dois exemplos tornam isso palpável. Em manuscritos em Maghribi, o sistema de OCR, ajustado majoritariamente para o estilo Naskh, produz um amontoado de caracteres incompatível que não guarda semelhança real com o que está escrito; o VLM, portanto, acaba ancorado em puro ruído. Já em amostras realistas de manuscritos de estudantes, o rascunho do OCR se revela sistematicamente enganoso, e não apenas impreciso — com aparência próxima o suficiente para parecer confiável, mas errando de modos que o VLM não consegue detectar nem corrigir. Em ambos os cenários, o modelo provavelmente teria produzido um resultado melhor ignorando o OCR por completo e limitando-se a ler a imagem.
Modos de falha menores que vale a pena conhecer
Além do achado principal, o estudo destaca alguns problemas práticos recorrentes no comportamento do VLM-OCR para árabe — aquele tipo de detalhe que se parece com uma misteriosa queda de precisão até que se saiba onde procurar.
A sensibilidade a diacríticos é um deles: como esses pequenos sinais vocálicos trazem significado real, a forma como a imagem os preserva — íntegros, desbotados ou eliminados durante o pré-processamento — altera a qualidade da saída de maneira mensurável. As escolhas de pré-processamento em geral (ajuste de contraste, corte, binarização) também impactam os resultados mais do que se poderia supor para uma tarefa supostamente restrita a "ler o texto".
Outras duas questões são intrínsecas ao modo como os VLMs geram texto. O limite de geração (generation budget) diz respeito à quantidade máxima de tokens que o modelo pode produzir antes de ser interrompido; se configurado baixo demais, o modelo truncará a página do manuscrito no meio de uma frase. Já os loops de repetição (repetition loops) são um modo de falha conhecido em modelos de linguagem, no qual o modelo trava gerando a mesma palavra, caractere ou frase repetidamente sem avançar — um comportamento que desponta especificamente no VLM-OCR para árabe e destrói silenciosamente a transcrição se ninguém estiver monitorando o comprimento da saída.
Por que isso importa se você está construindo ou escolhendo um pipeline de OCR
A lição prática aqui vai muito além dos manuscritos em árabe. Acoplar uma etapa de correção com VLM à saída do seu OCR não é um upgrade garantido nem gratuito. É uma aposta de que os erros do seu OCR pertençam à categoria dos recuperáveis — imprecisos, mas contextualizados —, em vez da categoria dos sistematicamente enganosos. Se essa aposta se pagará ou não, depende da caligrafia, do estado do documento e de como o seu motor de OCR específico tende a falhar diante daquele material.
A intervenção recomendada pelos pesquisadores é um fluxo adaptativo: direcionar cada página para uma estratégia distinta com base em sinais como o estilo de escrita, a aparente recuperabilidade da saída do OCR, a extensão do texto gerado pelo VLM frente ao esperado e indicadores de modos de falha conhecidos, como loops de repetição. Em termos simples: não adote um método único para rodar sobre tudo. Avalie a natureza do documento, entenda como o seu OCR reage a ele e faça o roteamento em conformidade.
Esse é o exato raciocínio por trás de testar motores de OCR em múltiplos tipos de documento em vez de eleger um único "campeão" genérico. Um modelo formidável em formulários impressos perfeitamente nítidos pode ser a pior escolha para anotações manuscritas ou escaneamentos degradados, e a falha nem sempre salta aos olhos a menos que a saída seja confrontada com o ground truth no formato específico de documento que você de fato precisa processar.
O que este estudo não resolve
Algumas ressalvas fundamentais. Trata-se de uma pesquisa voltada especificamente para o árabe e, embora o princípio de recuperabilidade seja intuitivo o bastante para provavelmente se aplicar a outras escritas, o artigo não realiza essa validação. Oito datasets formam uma amostragem expressiva, mas as tradições de manuscritos árabes cobrem mais famílias caligráficas e séculos do que oito coleções conseguem contemplar; assim, trate a disparidade entre Maghribi e Naskh como um dado empírico consistente, e não como uma regra infalível.
Existe também um abismo entre "aqui estão os sinais diagnósticos que antecipam quando a correção vai falhar" e "aqui está um sistema capaz de detectar isso com segurança em tempo real antes de desperdiçar um ciclo de correção". O artigo mapeia os sinais pertinentes — inconsistência de escrita, recuperabilidade do prior, extensão de saída, padrões de repetição —, mas projetar um roteador adaptativo que capture tudo isso de forma automatizada, barata e em escala de produção é um desafio de engenharia posterior que o estudo apenas aponta, sem solucionar.
A conclusão maior, contudo, permanece intacta: uma etapa de correção por IA herda os vícios e modos de falha de qualquer dado com o qual seja alimentada. Antes de repassar a saída do OCR para um VLM como uma "dica útil", convém certificar-se de que os erros do seu OCR realmente merecem ser ouvidos.