AI Corrector को OCR का गलत अनुमान देना: कब यह मददगार होता है और कब पूरे पेज को बिगाड़ देता है
आधारित शोध-पत्र: When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study — Moshiur Farazi, Firoj Alam, Abderrahmane Maaradji, Zakaria Maamar, Hamdy Mubarak, Wajdi Zaghouani
उत्तरी अफ्रीका की किसी लाइब्रेरी में डिजिटलीकरण (digitization) प्रोजेक्ट की कल्पना कीजिए। कोई सदियों पुरानी पांडुलिपियों के कुछ हज़ार पन्नों को स्कैन करता है और उन्हें सामान्य पाइपलाइन से गुज़ारता है: पहले OCR, और फिर गलतियों को सुधारने के लिए एक AI मॉडल। कुछ पेजों पर, AI ठीक वही पकड़ लेता है जहां OCR से चूक हुई थी, और बिल्कुल साफ़, पढ़ने लायक टेक्स्ट वापस देता है। लेकिन बाकी पेजों पर, AI उस OCR के गड़बड़ (garbled) अनुमान को इस बात का संकेत मान लेता है कि पेज पर क्या लिखा है, और पूरे आत्मविश्वास के साथ ऐसा ट्रांसक्रिप्शन तैयार कर देता है जो उससे भी बदतर होता, अगर उसने OCR का आउटपुट देखा ही न होता।
यही दूसरा नतीजा कतर से आए एक नए रिसर्च पेपर, When Do VLMs Help Arabic Manuscript OCR? A Cross-Dataset Study का मुख्य ट्विस्ट है। शोधकर्ताओं ने आठ अलग-अलग प्रकार के अरबी दस्तावेज़ों पर पारंपरिक OCR, सामान्य प्रयोजन वाले AI विज़न मॉडल, उन मॉडलों के अरबी-विशिष्ट (Arabic-specialized) वर्ज़न, और एक हाइब्रिड दृष्टिकोण का परीक्षण किया, जिसमें AI किसी OCR ड्राफ्ट को "सुधारता" (corrects) है। कोई भी एक तरीका हर जगह खरा नहीं उतरता। लेकिन यह पेपर किसी एक को विजेता घोषित करने से कहीं अधिक उपयोगी काम करता है: यह समझाता है कि सुधार (correction) वाला दृष्टिकोण कुछ दस्तावेज़ों पर क्यों काम करता है और दूसरों पर नुकसान क्यों पहुंचाता है, और यह इस पैटर्न को एक नाम भी देता है।
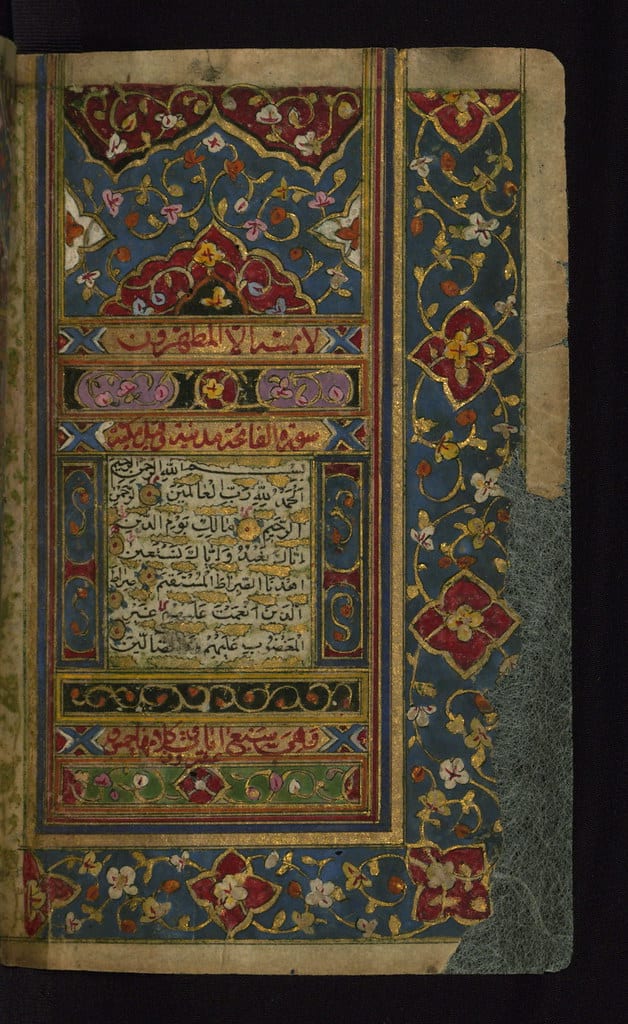
Illuminated Manuscript Koran, The right side of a double-page illumination, Walters Art Museum MS. W.575, fol. 2b — Walters Art Museum Illuminated Manuscripts द्वारा flickr के माध्यम से, CC0 1.0.
अरबी पांडुलिपियां OCR के लिए वास्तव में एक कठिन समस्या क्यों हैं
लैटिन-लिपि (Latin-script) OCR की तुलना में अरबी OCR में कई अतिरिक्त मुश्किलें आती हैं, और पांडुलिपियां इन समस्याओं को और बढ़ा देती हैं।
अरबी एक घसीट (cursive) और आपस में जुड़ी हुई लिपि में लिखी जाती है, इसलिए किसी शब्द में अपनी स्थिति के आधार पर अक्षरों का आकार बदल जाता है। इसके अलावा, कोई एक अकेली "अरबी लिपि" भी नहीं है। आधुनिक मुद्रित अरबी में ज़्यादातर Naskh का उपयोग होता है, जो एक साफ-सुथरी और गोल शैली है। लेकिन ऐतिहासिक पांडुलिपियां अक्सर अलग-अलग क्षेत्रीय शैलियों में तैयार की जाती थीं, जिनके अक्षरों के रूप (letterforms) काफी भिन्न होते थे। यह पेपर Naskh और Maghribi के बीच के अंतर पर विशेष ज़ोर देता है—Maghribi उत्तरी अफ्रीका और इस्लामिक स्पेन में इस्तेमाल होने वाला एक लिपि परिवार है, जिसमें अक्षरों के अलग आकार, स्पेसिंग और नुक्ते (dotting) लगाने के अपने नियम हैं। मुख्य रूप से Naskh पर प्रशिक्षित कोई रिकग्निशन सिस्टम Maghribi को पढ़ने में गंभीर रूप से लड़खड़ा सकता है, ठीक वैसे ही जैसे किसी वर्णमाला के एक रूप में दक्ष व्यक्ति किसी अपरिचित क्षेत्रीय हस्तलेखन शैली को देखकर उलझ सकता है।
इसके बाद डायक्रिटिक्स (diacritics) आते हैं: अक्षरों के ऊपर और नीचे लगने वाले छोटे निशान जो ह्रस्व स्वरों (short vowels) और उच्चारण के अन्य विवरणों को दर्शाते हैं। आम बोलचाल या सामान्य लेखन में अक्सर इन्हें छोड़ दिया जाता है, लेकिन जब ये किसी पांडुलिपि में मौजूद होते हैं, तो उन्हें सही या गलत पहचानना पूरे शब्द का अर्थ बदल देता है। पेपर में पाया गया कि AI मॉडल इस बात के प्रति काफी संवेदनशील होते हैं कि ये निशान मौजूद हैं या विकृत (garbled) हो गए हैं।
इसके अलावा पुराने कागज़ की आम समस्याएं भी हैं: फीकी पड़ चुकी स्याही, पानी से हुआ नुकसान, लाइनों के बीच असमान दूरी, और प्रशिक्षित मुंशी (scribe) की सुव्यवस्थित लिखावट से लेकर छात्र के जल्दबाज़ी में लिखे गए नोट्स तक फैला हस्तलेखन। इस अध्ययन के आठ डेटासेट ठीक इसी दायरे को कवर करते हैं—ऐतिहासिक पांडुलिपियों और पुरानी छपी किताबों से लेकर साफ़ आधुनिक प्रिंट, मिक्स्ड-डोमेन दस्तावेज़ों और हस्तलेखन के नमूनों तक।
वे चार दृष्टिकोण जिनका उन्होंने वास्तव में परीक्षण किया
यह पेपर कोई एक नया तरीका प्रस्तावित नहीं करता। यह चार मौजूदा रणनीतियों की तुलना है, जिन्हें दस्तावेज़ों के एक ही सेट पर परखा गया है ताकि परिणाम वास्तव में तुलनीय हों।
यहाँ Traditional OCR का अर्थ Tesseract से है—यह एक ओपन-सोर्स OCR इंजन है जो फ़ॉन्ट और लिपि के आकारों पर प्रशिक्षित पैटर्न मैचिंग का उपयोग करके वर्णों (characters) को पहचानता है। यह जो टेक्स्ट पढ़ रहा होता है उसे समझता नहीं है; यह केवल आकृतियों का वर्णों से मिलान करता है।
General-purpose vision-language models (VLMs) ऐसे AI मॉडल हैं जो एक इमेज और टेक्स्ट प्रॉम्प्ट को एक साथ लेते हैं और टेक्स्ट आउटपुट देते हैं—यह उसी तकनीक का परिवार है जो GPT-4 with vision या Gemini जैसे टूल्स के पीछे काम करती है। आप इसे पांडुलिपि का पन्ना दिखाते हैं और जो दिख रहा है उसे ट्रांसक्राइब करने को कहते हैं। Tesseract के विपरीत, एक VLM में भाषा की कुछ समझ होती है, इसलिए वह आसपास के शब्दों के संदर्भ (context) का उपयोग करके किसी धुंधले शब्द का अंदाज़ा लगा सकता है।
Arabic-specialized VLMs इसी तकनीक के वे संस्करण हैं जिन्हें विशेष रूप से अरबी टेक्स्ट और लिपि पर फ़ाइन-ट्यून किया गया है। इसके पीछे सोच यह है कि मुख्य रूप से अंग्रेज़ी और लैटिन-लिपि के दस्तावेज़ों पर प्रशिक्षित सामान्य मॉडलों ने शायद इतना अरबी पांडुलिपि डेटा नहीं देखा होगा कि वे बेहतर प्रदर्शन कर सकें।
OCR-conditioned correction एक हाइब्रिड तरीका है: पहले Tesseract चलाएं, फिर उसके आउटपुट को मूल इमेज के साथ VLM को सौंपें और उससे OCR की गलतियों को ठीक करने को कहें। इसके पीछे का सिद्धांत यह है कि VLM को शुरुआत से ही एक रफ़ ड्राफ्ट मिल जाता है जिसे वह एडिट कर सकता है, बजाय इसके कि वह कोरे पन्ने से स्क्रैच से ट्रांसक्रिप्शन शुरू करे।
वास्तव में किसकी जीत हुई, और कहाँ
मुख्य परिणाम पूरी तरह से ईमानदार है: कोई भी एक दृष्टिकोण पूरी तरह हावी नहीं है। लेकिन आप किस प्रकार के दस्तावेज़ को देख रहे हैं, उसके आधार पर पैटर्न एक खास तरीके से बदलता है।
लाइन-लेवल (line-level) ऐतिहासिक पांडुलिपियों पर—यानी जहां इमेज में पूरे पेज के बजाय एक बार में सिर्फ टेक्स्ट की एक लाइन दिखाई देती है—VLMs का प्रदर्शन लगभग Tesseract के बराबर रहता है। कोई भी एक-दूसरे से बहुत आगे नहीं निकलता। लेकिन जब पेज-लेवल (page-level) पांडुलिपि छवियों की बात आती है, जहां मॉडल को एक साथ पूरे पेज के लेआउट और संदर्भ को संभालना होता है, तो VLMs पारंपरिक OCR से आगे निकल जाते हैं। यह अंतर समझ में आता है: एक VLM किसी कठिन वर्ण की अस्पष्टता दूर करने के लिए आसपास के शब्दों और पेज की समग्र संरचना का उपयोग कर सकता है, जबकि Tesseract बिना उस संदर्भ के केवल आकार-दर-आकार काम कर रहा होता है।
OCR-कंडीशन्ड करेक्टर (OCR-conditioned corrector) वह जगह है जहाँ चीजें दिलचस्प हो जाती हैं। कई सेटिंग्स में, यह स्टैंडअलोन OCR और स्टैंडअलोन VLMs दोनों को पछाड़ देता है। VLM से बिल्कुल नए सिरे से ट्रांसक्राइब कराने के बजाय उसे एडिट करने के लिए एक रफ़ ड्राफ्ट देना तीनों दृष्टिकोणों में सबसे अच्छे परिणाम देता है, लेकिन केवल कुछ ही सेटिंग्स में। अन्य सेटिंग्स में, यही तरकीब परिणामों को दोनों घटकों के अकेले प्रदर्शन से भी बदतर बना देती है। यह असंगति ही इस पेपर का वास्तविक विषय है।
मूल विचार: OCR प्रायर रिकवरेबल होना चाहिए
शोधकर्ता इसे OCR-प्रायर रिकवरेबिलिटी सिद्धांत (OCR-prior recoverability principle) कहते हैं, और वास्तविक पाइपलाइन बनाने वाले किसी भी व्यक्ति के लिए यह पेपर का सबसे उपयोगी विचार है।
OCR के रफ़ ड्राफ्ट को एक ऐसे स्केच की तरह समझें जो आप किसी कलाकार को संदर्भ तस्वीर (reference photo) से पेंटिंग बनाने से पहले थमा देते हैं। यदि स्केच मोटे तौर पर सही आकृतियों को पकड़ लेता है, भले ही कुछ विवरण गलत हों, तो यह कलाकार को काम करने के लिए उपयोगी आधार (anchors) प्रदान करता है। लेकिन यदि स्केच पूरी तरह गलत है—जहां फोटो में नाव है वहां वह घर दिखा रहा है—तो यह कलाकार की मदद नहीं करता। यह वास्तव में उसे गुमराह करता है, क्योंकि अब वह एक गलत शुरुआती बिंदु और जो वह वास्तव में देख रहा है, उसके बीच तालमेल बिठाने की कोशिश कर रहा होता है।
OCR-कंडीशन्ड करेक्शन के साथ ठीक यही हो रहा है। जब OCR की गलतियां विज़ुअली और टेक्स्चुअली रिकवरेबल (recoverable) होती हैं—यानी उसके द्वारा अनुमानित गलत वर्ण अभी भी सही वर्णों से मिलते-जुलते हैं, या गलत शब्द अभी भी सही दायरे में हैं—तो VLM उस ड्राफ्ट को एक मचान (scaffolding) की तरह इस्तेमाल कर सकता है और वास्तविक इमेज के आधार पर उसे सुधार सकता है। पेपर में पाया गया कि यह बात पुरानी छपी किताबों, साफ़ प्रिंट, मिक्स्ड-डोमेन अरबी दस्तावेज़ों और कुछ Naskh पांडुलिपियों के लिए सही साबित हुई। ये सभी ऐसे मामले हैं जहां OCR, गलत होने पर भी, इस तरह से गलत होता है जिसका पन्ने पर वास्तव में मौजूद सामग्री से कोई संबंध होता है।
यह सिद्धांत इसके विपरीत मामले में टूट जाता है: जब OCR ड्राफ्ट इस हद तक गलत होता है कि उसका वास्तविक टेक्स्ट से कोई लेना-देना ही नहीं होता, तब सुधार बेहतर होने के बजाय और खराब हो जाता है। दो उदाहरण इसे स्पष्ट करते हैं। Maghribi पांडुलिपियों पर, Naskh-शैली की लिपि के लिए ट्यून किया गया OCR सिस्टम लिपि-असंगत (script-mismatched) ऐसा कचरा आउटपुट देता है जो पन्ने पर मौजूद सामग्री से बिल्कुल मेल नहीं खाता, जिससे VLM केवल शोर (noise) से बंधकर रह जाता है। और छात्रों के वास्तविक हस्तलेखन के नमूनों पर, OCR ड्राफ्ट केवल सटीक न होने के बजाय व्यवस्थित रूप से भ्रामक (systematically misleading) साबित होता है—दिखने में इतना करीब कि भरोसेमंद लगे, लेकिन ऐसे तरीकों से गलत जिन्हें VLM पहचानकर ठीक नहीं कर पाता। दोनों ही मामलों में, मॉडल के लिए बेहतर होता कि वह OCR को पूरी तरह नज़रअंदाज़ कर देता और सीधे इमेज को पढ़ता।
विफलता के कुछ छोटे मोड्स जिनके बारे में जानना ज़रूरी है
मुख्य निष्कर्ष के अलावा, पेपर अरबी VLM-OCR के व्यवहार में कुछ व्यावहारिक दिक्कतों (practical gremlins) को रेखांकित करता है—ऐसी समस्याएं जो सटीकता में एक रहस्यमयी गिरावट की तरह दिखती हैं, जब तक कि आपको यह न पता हो कि इनकी जांच कैसे करनी है।
डायक्रिटिक संवेदनशीलता (Diacritic sensitivity) इनमें से एक है: चूंकि वे छोटे स्वर-चिह्न वास्तविक अर्थ रखते हैं, इसलिए इमेज उनके साथ कैसा व्यवहार करती है—वे मौजूद हैं, फीके हैं, या प्रीप्रोसेसिंग के दौरान हटा दिए गए हैं—इससे आउटपुट की गुणवत्ता में मापने योग्य अंतर आता है। सामान्य तौर पर प्रीप्रोसेसिंग के विकल्प (कंट्रास्ट एडजस्टमेंट, क्रॉपिंग, बाइनराइजेशन) भी परिणामों को उम्मीद से कहीं अधिक प्रभावित करते हैं, विशेष रूप से उस कार्य के लिए जिसे केवल "टेक्स्ट पढ़ना" माना जाता है।
दो अन्य समस्याएं इस बात से जुड़ी हैं कि VLMs टेक्स्ट कैसे जनरेट करते हैं। जनरेशन बजट (Generation budget) का तात्पर्य टोकन की उस अधिकतम संख्या से है जिसे मॉडल कट-ऑफ होने से पहले आउटपुट कर सकता है; यदि इसे बहुत कम सेट किया जाए, तो मॉडल पांडुलिपि के पन्ने को वाक्य के बीच में ही काट (truncate) देता है। और रेपिटिशन लूप्स (repetition loops) भाषा मॉडलों में विफलता का एक जाना-माना मोड हैं, जहाँ मॉडल आगे बढ़ने के बजाय बार-बार एक ही शब्द, वर्ण या वाक्यांश जनरेट करने में अटक जाता है—यह चीज़ विशेष रूप से अरबी VLM-OCR में सामने आती है और यदि कोई आउटपुट की लंबाई की जांच नहीं कर रहा है, तो यह चुपचाप पूरे ट्रांसक्रिप्शन को बर्बाद कर देती है।
यदि आप OCR पाइपलाइन बना रहे हैं या चुन रहे हैं तो यह क्यों मायने रखता है
यहाँ मिला व्यावहारिक सबक सिर्फ अरबी पांडुलिपियों तक सीमित नहीं है। अपने OCR आउटपुट में VLM करेक्शन स्टेप जोड़ना कोई मुफ़्त अपग्रेड नहीं है। यह इस बात पर लगाया गया दांव है कि आपके OCR की गलतियां रिकवरेबल किस्म की हैं—गलत तो हैं लेकिन सही दायरे के आसपास—न कि व्यवस्थित रूप से भ्रामक। यह दांव सफल होगा या नहीं, यह लिपि, दस्तावेज़ की स्थिति और इस बात पर निर्भर करता है कि आपका विशेष OCR इंजन उस सामग्री पर किस तरह विफल होता है। यही बात देवनागरी जैसी लिपियों पर भी लागू होती है, जहाँ अंग्रेज़ी में मजबूत OCR प्रदर्शन का यह अर्थ बिल्कुल नहीं है कि वह संयुक्ताक्षरों, मात्राओं और शिरोरेखा वाली लिपि पर भी उतना ही अच्छा काम करेगा।
शोधकर्ताओं का प्रस्तावित समाधान एक एडेप्टिव वर्कफ़्लो (adaptive workflow) है: प्रत्येक पेज को विभिन्न संकेतों के आधार पर एक अलग रणनीति पर रूट करें—जैसे कि वह किस लिपि में लिखा गया है, क्या OCR आउटपुट रिकवरेबल लगता है, VLM के आउटपुट की लंबाई अपेक्षित लंबाई से कैसी तुलना करती है, और रेपिटिशन लूप्स जैसे जाने-माने विफलता संकेतक। सीधे शब्दों में कहें तो: किसी एक तरीके को चुनकर उसे हर चीज़ पर लागू न करें। यह जांचें कि आप किस प्रकार का दस्तावेज़ देख रहे हैं और आपका OCR उस पर कैसा व्यवहार करता है, और उसी के अनुसार रूटिंग करें।
यही तर्क केवल एक "सर्वश्रेष्ठ" मॉडल चुनकर काम खत्म मान लेने के बजाय अलग-अलग प्रकार के दस्तावेज़ों पर OCR इंजनों को बेंचमार्क करने के पीछे भी है। एक मॉडल जो साफ़ मुद्रित फ़ॉर्म पर उत्कृष्ट है, वह हस्तलिखित नोट्स या खराब स्कैन के लिए गलत विकल्प साबित हो सकता है, और यह विफलता तब तक हमेशा दिखाई नहीं देती जब तक कि आप उस विशिष्ट प्रकार के दस्तावेज़ के ग्राउंड ट्रुथ (ground truth) से आउटपुट का मिलान न कर रहे हों जिसे आपको वास्तव में प्रोसेस करना है।
यह अध्ययन क्या तय नहीं करता
कुछ ईमानदार चेतावनियां (caveats)। यह शोध विशेष रूप से अरबी पर केंद्रित है, और यद्यपि रिकवरेबिलिटी सिद्धांत इतना सहज है कि यह संभवतः अन्य लिपियों पर भी लागू होता है, लेकिन पेपर में इसका परीक्षण नहीं किया गया है। आठ डेटासेट एक अच्छा विस्तार हैं, लेकिन अरबी पांडुलिपि परंपराएं किसी भी आठ संग्रहों की तुलना में कहीं अधिक लिपि परिवारों और सदियों में फैली हुई हैं, इसलिए Maghribi बनाम Naskh के विशिष्ट निष्कर्ष को एक सार्वभौमिक नियम के बजाय एक मजबूत डेटा पॉइंट के रूप में देखें।
इसके अलावा "ये वे डायग्नोस्टिक संकेत हैं जो बताते हैं कि सुधार कब विफल होगा" और "यहाँ एक ऐसा सिस्टम है जो करेक्शन पास बर्बाद करने से पहले रियल-टाइम में इसका विश्वसनीय रूप से पता लगाता है" के बीच एक अंतर है। पेपर प्रासंगिक संकेतों की पहचान करता है—लिपि बेमेल (script mismatch), प्रायर रिकवरेबिलिटी, आउटपुट की लंबाई, रेपिटिशन पैटर्न—लेकिन प्रोडक्शन स्केल पर इन्हें स्वचालित और कम लागत में पकड़ने वाला एक एडेप्टिव राउटर बनाना एक बाद की इंजीनियरिंग समस्या है जिसकी ओर पेपर केवल इशारा करता है, उसका समाधान नहीं करता।
फिर भी, इसका व्यापक निष्कर्ष जस का तस रहता है: AI सुधार चरण उन सभी विफलता मोड्स को अपना लेता है जो आप उसे इनपुट के रूप में देते हैं। इससे पहले कि आप VLM में OCR आउटपुट को एक "मददगार संकेत" के रूप में जोड़ें, यह जांच लेना समझदारी है कि क्या आपका OCR इस तरह से गलत है जिसे वास्तव में सुनना फायदेमंद हो।