مسار OCR تقليدي يتفوق للتو على Gemini وGPT وClaude في قراءة السنسكريتية
استنادًا إلى: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
تخيل مخطوطة سنسكريتية يعود تاريخها إلى 400 عام؛ حيث حشر الناسخ التعليقات والشروح في الهوامش، وكتب بعض الفقرات بأسلوب حلزوني يلتف حول رسم ديني تعبدي، وحشد 44 سطراً في الصفحة الواحدة في أكثر الأقسام كثافة. حتى الشخص المتمرس في قراءة هذا الخط قد يقضي دقيقة كاملة لمجرد معرفة أي ضربة قلم تنتمي إلى أي سطر قبل أن يبدأ بنسخ كلمة واحدة. والمفارقة المثيرة للدهشة هنا هي أن مساراً تقليدياً تماماً للتعرف الضوئي على الحروف (OCR) يتألف من ثلاث مراحل — وهو النوع الذي قد يصفه معظم العاملين في مجال الرؤية الحاسوبية بأنه قديم وتجاوزه الزمن — ينجح في التفوق على Gemini وGPT وClaude في قراءة هذه الصفحات، بمجرد أن يقوم إنسان بتصحيح ثلاث صفحات منها يدوياً لا أكثر.
هذه هي النتيجة التي توصلت إليها ورقة بحثية جديدة بعنوان "Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts" من إعداد Kartik Chincholikar وKaushik Gopalan وMihir Hasabnis. وتمثل هذه النتيجة وقفة تذكيرية مفيدة مع الواقع لكل من يفترض أن حل أي معضلة مستعصية في معالجة المستندات يكمن دائماً في توجيه نموذج متعدد الوسائط (multimodal model) أكبر نحوها.
لماذا تكسر هذه الصفحات قواعد التعرف الضوئي المعتادة
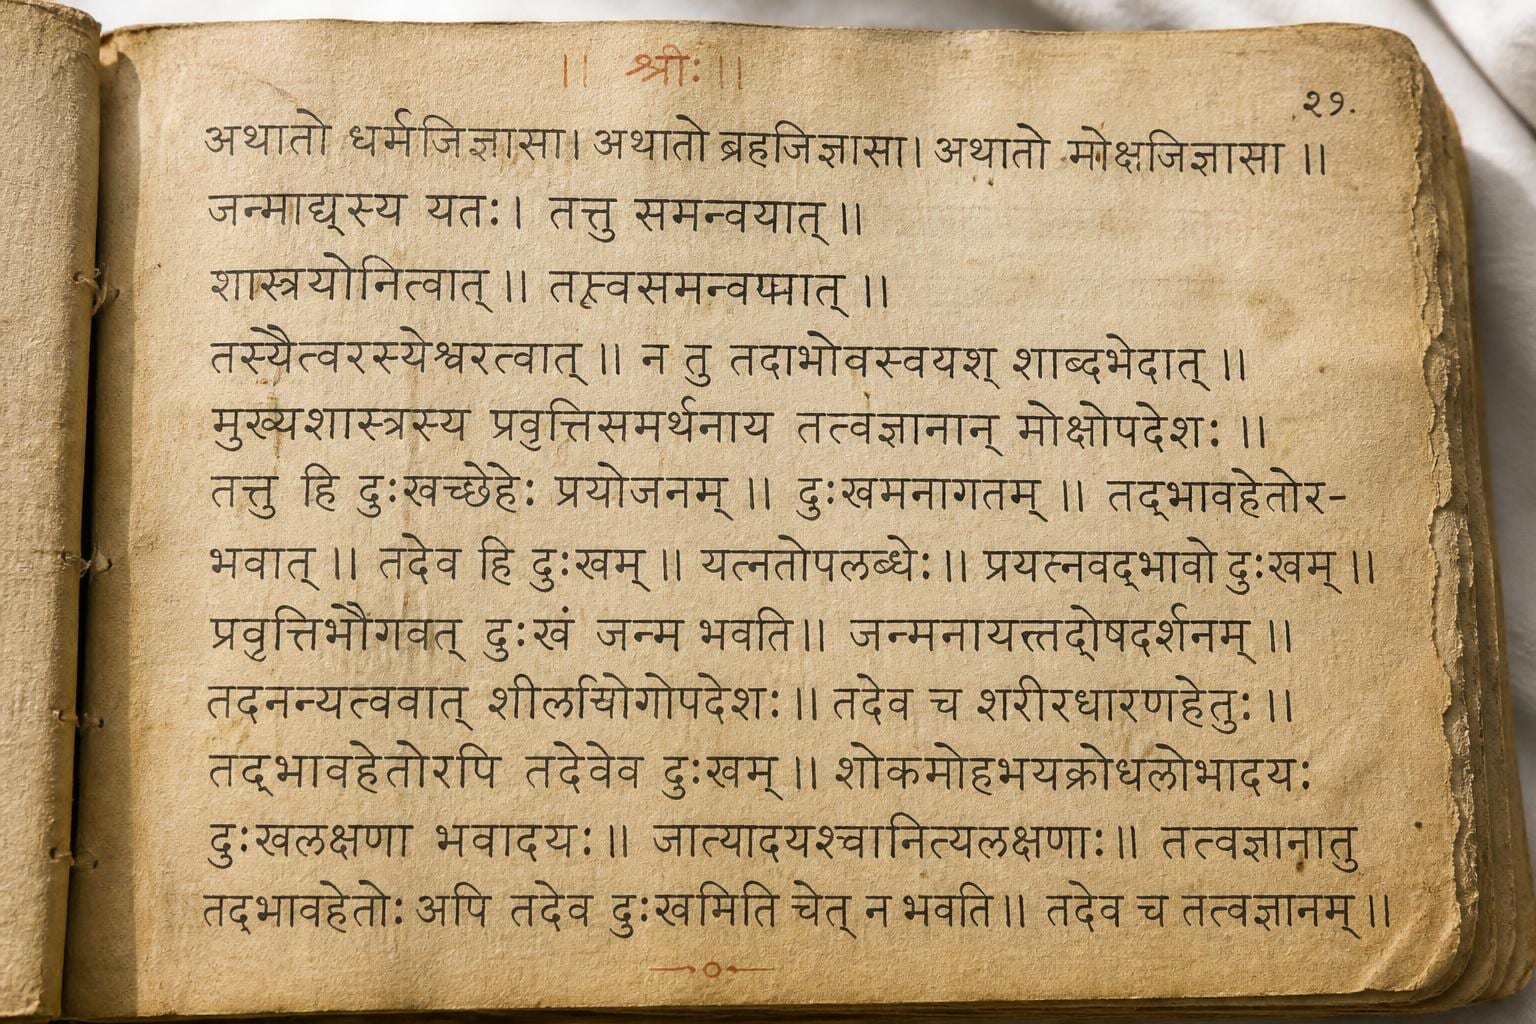
تفترض معظم أنظمة التعرف الضوئي على الحروف (OCR) أن النص يسير في أسطر أفقية منتظمة تتتابع من أعلى الصفحة إلى أسفلها، تماماً كما هو الحال في الكتب المطبوعة أو الإيصالات. غير أن المخطوطات السنسكريتية التاريخية تكسر هذا الافتراض في عدة اتجاهات في وقت واحد. وقد قسّم الباحثون عينات المخطوطات الثلاث بحسب صعوبة التخطيط والتنسيق (layout): تخطيط متوسط الصعوبة يحتوي على حواشٍ جانبية وهوامش بين الأسطر (interlinear glosses)، وتخطيط كثيف يبلغ متوسط عدد أسطره 44.43 سطراً في الصفحة، وتخطيط دائري يلتف فيه النص حول الرسوم التوضيحية بدلاً من السير في خطوط مستقيمة.
وعلاوة على هذه المعضلة الهندسية، تبرز معضلة المظهر البصري؛ فلكل ناسخ أسلوبه الخاص وخط يده المتأثر بالحقبة الزمنية والمنطقة الجغرافية. كما تحمل الصفحات بقعاً وتمزقات وإضاءة غير متساوية ناتجة عن تصويرها بالكاميرات داخل الأرشيف بدلاً من مسحها بماسح ضوئي مسطح. ويتطلب تصحيح أي من ذلك وجود خبير متمرس قادر بالفعل على قراءة اللغة السنسكريتية التاريخية، وهي مهارة نادرة ومكلفة للغاية. وهذه الندرة تحديداً هي القيد الحقيقي الذي بُنيت الورقة البحثية لمعالجته: تقليص حجم المراجعة والتصحيح الذي يتعين على خبير المجال إجراؤه، بدلاً من الاكتفاء برفع الدقة الخام فقط.
ثلاثة نماذج مترابطة معاً، لا شبكة عملاقة واحدة
يتألف مسار المعالجة الذي صممه المؤلفون من ثلاث مراحل منفصلة بدلاً من الاعتماد على شبكة واحدة شاملة من البداية إلى النهاية (end-to-end).
أولاً، يقوم كاشف محارف مدرَّب مسبقاً ومجمّد (frozen) يُدعى CRAFT بمسح الصفحة وتوليد خريطة حرارية (heatmap) للمواضع المحتملة للمحارف الفردية، تماماً كصورة حرارية توضح أي بقع من الصفحة تحتوي على حبر يتخذ شكل حرف. ثانياً، تأخذ شبكة عصبية بيانية (graph neural network) مبنية على بنية تُدعى SplineCNN تلك المحارف المكتشفة وتقرر، زوجاً تلو الآخر، ما إذا كان المحرفان ينتميان إلى السطر نفسه أم لا. يمكنك تخيل الأمر كلعبة «التوصيل بين النقاط»: فكل محرف يمثل نقطة، ومهمة الشبكة هي استنتاج أي النقاط تترابط معاً لتشكّل سطراً نصياً، وبأي ترتيب. ثالثاً، تتولى شبكة من نوع CNN-BiLSTM-CTC قراءة كل سطر مجمّع وتحويله إلى نص بترميز يونيكود (Unicode). وتعتمد هذه القطعة الأخيرة على تقنية تدريب تُعرف بـ CTC (التصنيف الزمني الارتباطي - connectionist temporal classification)، والتي تسمح للنموذج بتوليد النص المكتوب دون الحاجة إلى معرفة مسبقة بموضع بداية كل حرف ونهايته بدقة داخل الصورة، وهو أمر مفيد للغاية عندما يتعذر تقسيم خط اليد وتجزئته بوضوح.
وفي حالة المخطوطات ذات التخطيط الدائري، يضيف مسار المعالجة حيلة هندسية ذكية: إذ يستنتج نظام إحداثيات محلياً يتبع انحناء النص ويبسطه عملياً إلى شريط مستقيم قبل تمريره إلى نموذج القراءة. ولولا هذه الخطوة، لما كانت هناك أي فرصة لنموذج تعرّف مدرّب على الأسطر المستقيمة للتعامل مع نص ينحني ويلتف حول رسم توضيحي.
مقبضان للضبط يُعدّلان على نحو منفصل
تتمثل الفكرة المحورية للورقة البحثية في إجراء الضبط الدقيق (fine-tuning) لمسار المعالجة هذا عبر مقبضين يدوران بشكل مستقل تماماً.
فالضبط الدقيق على مستوى التخطيط (Layout-level fine-tuning) يعيد تدريب الشبكة البيانية على صفحة صحّح فيها إنسان تجميعات الأسطر، بالاعتماد على تعزيز البيانات (data augmentation) — مثل التشويه البصري، والإمالة، والإسقاط العشوائي للعقد — لتوسيع نطاق صفحة واحدة مصححة وتحويلها إلى إشارة تدريبية أكبر بكثير، ثم تدريبها عبر عشر حقب تدريبية (epochs) باستخدام دالة خسارة (loss function) مضبوطة للتركيز على الأمثلة الأكثر صعوبة. أما الضبط الدقيق على مستوى المظهر (Appearance-level fine-tuning) فيعيد تدريب نموذج التعرّف على صفحة صحّح فيها إنسان النص المنقول الفعلي، مما يجعله يتكيف مع خط يد ذلك الناسخ بعينه وتفاصيل التلف والاهتراء في تلك الصفحة المحددة عبر 60 تكراراً (iterations).
ونظراً لكون هذين المقبضين منفصلين، فإن تصحيح أحدهما لا يجبرك على إعادة تدريب الآخر؛ إذ يمكنك تلقين النظام أن «هذا الناسخ يكتب الملاحظات الهامشية في عمود على الجانب الأيسر» دون المساس بما يعرفه عن أشكال حروف هذا الناسخ، والعكس بالعكس.
حلقة العمل بحد ذاتها واضحة ومباشرة: تصحيح صفحة، ثم إجراء الضبط الدقيق لكلا النموذجين استناداً إلى هذا التصحيح، ثم تشغيل مسار المعالجة المحسّن على الصفحة التالية. وبما أن النموذج بات يمتلك فهماً عملياً لعادات التخطيط وخط اليد لدى هذا الناسخ، فإن الصفحة التالية ستتطلب قدراً أقل من التصحيح. كرر هذه العملية بضع مرات وسيتراجع عبء التصحيح بسرعة كبيرة، وهو المقصد الجوهري هنا؛ فالورقة البحثية لا تلهث وراء رقم يتصدر لوحات المتصدرين (leaderboards)، بل تسعى إلى استعادة وقت المؤرخ الثمين وإنقاذه من الضياع.
ثلاث صفحات، ثلاث مخطوطات، وأرقام حقيقية
بنى الفريق مجموعة التقييم الخاصة بهم من ثلاث مخطوطات سنسكريتية: مخطوطة ذات تخطيط متوسط (15 صفحة، بمتوسط 21.07 سطراً في الصفحة)، وأخرى ذات تخطيط كثيف (7 صفحات، بمتوسط 44.43 سطراً في الصفحة)، وثالثة ذات تخطيط دائري (9 صفحات، بمتوسط 28.33 سطراً في الصفحة)، أي بإجمالي 31 صفحة. وتتضمن كل صفحة توصيفات تفصيلية دقيقة للتخطيط، بالإضافة إلى نسخ كامل بنظام Unicode ومرمز بصيغة PAGE-XML، وهو النسق المعتمد بالفعل في دور الأرشيف والمكتبات لمثل هذه البيانات المرجعية الحقيقية (ground truth). وتعد هذه الخطوة بحد ذاتها مساهمة قيّمة؛ فمجموعات البيانات المشروحة للمخطوطات التاريخية بهذا المستوى من التفصيل نادرة الوجود، واللغة السنسكريتية تعاني من نقص شديد في الدعم حتى عند مقارنتها بالمعايير المتدنية التي يكتفي بها عادةً بحث التعرف الضوئي على الحروف للنصوص غير اللاتينية.
وفيما يتعلق بالدقة، وبعد الضبط الدقيق على ثلاث صفحات فقط والتشغيل بأسلوب آلي بالكامل (أي استخدام تنبؤات النموذج نفسه كتصحيحات زائفة بدلاً من التصحيحات البشرية)، شهدت المخطوطة ذات التخطيط المتوسط انخفاضاً في مقياس TextEdit بنسبة 34.1%، وتراجعاً في معدل الخطأ في المحارف على مستوى الصفحة (Page-CER) بنسبة 37.5%. وفي التخطيط الكثيف، تحسن الأداء بنسبة 22.9% في كلا المقياسين. أما التخطيط الدائري، وهو الحالة الأكثر تعقيداً، فقد شهد تحسناً بنسبة 15.5% في مقياس TextEdit و8.1% في مقياس Page-CER.
يمثل TextEdit تقريباً نسبة المحارف التي يتعين عليك إدراجها أو حذفها أو استبدالها لتحويل مخرجات النموذج إلى النص الصحيح. أما Page-CER فيقيس النوع نفسه من الأخطاء ولكن على امتداد الصفحة بأكملها بدلاً من قياسها سطراً بسطر، وهو أمر بالغ الأهمية هنا تحديداً؛ لأن النموذج الذي يخطئ في تسلسل ترتيب القراءة قد يحقق نتيجة جيدة في المقاييس الفردية لكل سطر، في حين أنه يُنتج في النهاية صفحة مشوشة ومبعثرة.
وعندما يتدخل خبير بشري لتصحيح التخطيط كجزء من حلقة العمل، بدلاً من تركها تعمل بشكل آلي تماماً، تصبح المكاسب أكبر بكثير: فقد انخفضت نسبة خطأ TextEdit في المخطوطة ذات التخطيط المتوسط بمقدار 51.3%، وتحسن التخطيط الكثيف بنسبة 36.2% في TextEdit و36.9% في Page-CER.
وما يجعل تشغيل هذه الحلقة مجدياً حقاً هو جانب التكلفة؛ فقد استغرق التصحيح اليدوي لصفحة واحدة 38.0 ثانية للتخطيط المتوسط، و165.5 ثانية للتخطيط الكثيف، و109.0 ثوانٍ للتخطيط الدائري، وهي مدد تقع جميعها بكل أريحية دون حاجز الثلاث دقائق حتى في أسوأ الحالات. أما عملية الضبط الدقيق للنموذجين بين الصفحات، فاستغرقت 41.10 ثانية للشبكة البيانية و27.51 ثانية لنموذج التعرّف، أي أقل من 70 ثانية معاً. وهذه التكلفة الحسابية أقل بكثير من وقت التصحيح الذي توفره في الصفحة التالية مباشرة، مما يعني أن الحلقة تؤتي ثمارها وتسترد تكلفتها على الفور تقريباً دون أن تتطلب استثماراً أولياً ضخماً قبل أن تصبح مجدية.
لماذا يهمك هذا إذا كنت تبني نظام تعرّف ضوئي أو تختاره
الدرس المستفاد هنا ليس «اذهب وطبّق CRAFT وSplineCNN»، بل إن مسار معالجة متخصصاً يمكنك ضبطه دقيقاً بتكلفة زهيدة على حفنة من وثائقك الخاصة قادر على التفوق على نموذج عام لم يرَ نمط وثائقك من قبل، ولا يتطلب الأمر سوى القليل من الضبط الدقيق لتحقيق ذلك. وينطبق هذا بشكل خاص عندما تشترك وثائقك في نمط داخلي قوي: خط يد ناسخ بعينه، أو إعدادات كاميرا لأرشيف معين، أو قالب فاتورة لمورد محدد، أو صيغة ملفات لمحكمة بذاتها. ويكتسب هذا المنطق أهمية مضاعفة عند التعامل مع نصوص الخط العربي، حيث تفرض طبيعته المتصلة واتجاهه من اليمين إلى اليسار وتغير أشكال حروفه حسب موضعها، إلى جانب تعقيدات التراكيب الخطية والتشكيل الاختياري، تحديات شاقة تجعل التعرف الضوئي عليها أصعب بكثير أمام النماذج العامة غير المضبوطة خصيصاً لها.
إذا كنت تعالج دفعة كبيرة من المستندات المتشابهة بصرياً، فإن الحسابات الاقتصادية ترجح كفة قضاء ساعتين في تصحيح بضع صفحات كعينة والضبط الدقيق عليها، بدلاً من الدفع مقابل كل صفحة لإرسال كل مستند إلى نموذج رائد يخمن التخطيط دون أي أمثلة مسبقة عن نسقك الخاص. وتنقلب هذه المعادلة في الاتجاه المعاكس عندما تكون مستنداتك متباينة وغير متجانسة حقاً ولا يوجد نمط مشترك يمكن لنموذج صغير تعلمه. لذا، حدد بدقة الموقف الذي تواجهه قبل اختيار استراتيجيتك؛ فالقرار الخاطئ في الحالتين مكلف: إذ إن الإفراط في بناء حلقة ضبط دقيق لدفعة وثائق لمرة واحدة يهدر وقت الهندسة والتطوير، في حين أن التقصير في بنائها لنوع وثائق متكرر وبأحجام ضخمة يستنزف الدقة ويزيد تكاليف واجهات البرمجة (APIs) بهدوء واستمرار.
أين تعثرت النماذج «الذكية» في واقع الأمر
أجرت الورقة البحثية أيضاً تقييماً مقارناً لأربعة نماذج لغوية كبيرة متعددة الوسائط مباشرة دون أي تعديل: Gemini 3.5 Flash، وGPT-5.6 Terra، وClaude Sonnet 5، وSarvam Vision، وهو نموذج طُوِّر خصيصاً للنصوص والخطوط الهندية.
في المخطوطة ذات التخطيط المتوسط، تصدر Gemini 3.5 Flash هذه المجموعة محققاً 0.26 في TextEdit و0.35 في Page-CER، في حين سجل Claude Sonnet 5 نحو 0.60 و0.64، وسجل GPT-5.6 Terra نحو 0.71 و0.74، وهو ما يعني الخطأ في سبعة محارف تقريباً من بين كل عشرة. وفي التخطيط الكثيف، حقق Gemini نتيجة 0.30 و0.44، بينما حقق Sarvam Vision نحو 0.43 و0.64. وفي التخطيط الدائري، قاد Gemini المجموعة مجدداً مسجلاً 0.51 في كلا المقياسين، في حين دخل Sarvam Vision، وفقاً لما ذكره المؤلفون، في حالة أسموها «التوليد الجامح» (runaway generation): حيث واصل توليد النصوص وتجاوز بكثير نقطة انتهاء الفقرة الفعلية، مخترعاً محتوى للمخطوطة لا وجود له على الإطلاق في الصفحة.
ثم تأتي النتيجة الحاسمة؛ فبعد الضبط الدقيق على ثلاث صفحات فقط، تفوق المسار التقليدي على Gemini 3.5 Flash — أفضل النماذج الأربعة متعددة الوسائط — عبر المخطوطات الثلاث جميعها وفي كلا المقياسين. فالنماذج العامة للرؤية واللغة، رغم تدريبها على كميات هائلة من النصوص والصور، لا تزال تعاني عند «القراءة المباشرة من الصفر» لخط تاريخي محدد لم تصادفه كثيراً على الأرجح أثناء تدريبها؛ وقد نجحت حفنة من الأمثلة المصححة في سد فجوة عجز الحجم الهائل وحده عن تجاوزها.
ما لم تجب عنه الورقة البحثية بعد
إن 31 صفحة موزعة على ثلاث مخطوطات تعد مجموعة تقييم صغيرة، وإن كان من المهم تذكر السبب وراء ذلك؛ فتوصيف كل صفحة وشرحها يتطلب تدريباً حقيقياً في علم الخطوط القديمة (paleography)، وبالتالي فهذه ليست مجموعة بيانات يمكنك توسيعها بالاعتماد على عمال التعهيد الجماعي (crowdworkers). كما أن كاشف المحارف في مقدمة مسار المعالجة، CRAFT، ظل مجمداً دون تغيير طوال التجارب؛ إذ خضعت الشبكة البيانية ونموذج التعرّف فقط للضبط الدقيق، مما يعني أن النظام بأكمله يظل مقيداً بمدى كفاءة تلك المرحلة الأولى التي لم تُمَس في تحديد مواضع المحارف على الصفحات ذات الإضاءة غير المعتادة أو التلطخات الشديدة.
وهناك أيضاً تكلفة إعداد وتجهيز حقيقية؛ فبناء كاشف للمحارف وشبكة بيانية ونموذج تعرّف من نوع CNN-BiLSTM-CTC وضبطها دقيقاً مهمة تتطلب جهداً أكبر بكثير من مجرد توجيه سكربت برمجي نحو واجهة برمجة تطبيقات (API) لنموذج رؤية ولغة. ولا يؤتي هذا الجهد ثماره إلا عندما يتوفر لديك حجم عمل كافٍ لاستهلاك تكاليف هذا الإعداد وتبريرها. أما إذا كان لديك بضع صفحات فقط يُراد نسخها لمرة واحدة ولن تتكرر، فمن المرجح أن تصحيحها يدوياً أو إرسالها إلى أفضل نموذج لغوي كبير متعدد الوسائط (MLLM) متاح يظل هو الخيار الأسرع.
الكود ومجموعة البيانات متاحان للعموم على GitHub تحت اسم flame-cai/gnn-synthetic-layout-historical، متضمنين توصيفات PAGE-XML. ونشر هذه الموارد يعد عملاً مفيداً وقَيّماً بحق؛ فمجموعات بيانات المخطوطات التاريخية الرقمية التي تتمتع بهذا المستوى من التوصيف المرجعي الدقيق للتخطيط نادرة جداً، وأياً كان ما سيُبنى فوق هذا المسار لاحقاً، فمن المرجح أن تظل مجموعة البيانات هذه باقية ونافعة لوقت أطول بكثير.