Um pipeline de OCR tradicional acabou de superar Gemini, GPT e Claude na leitura de sânscrito
Baseado em: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
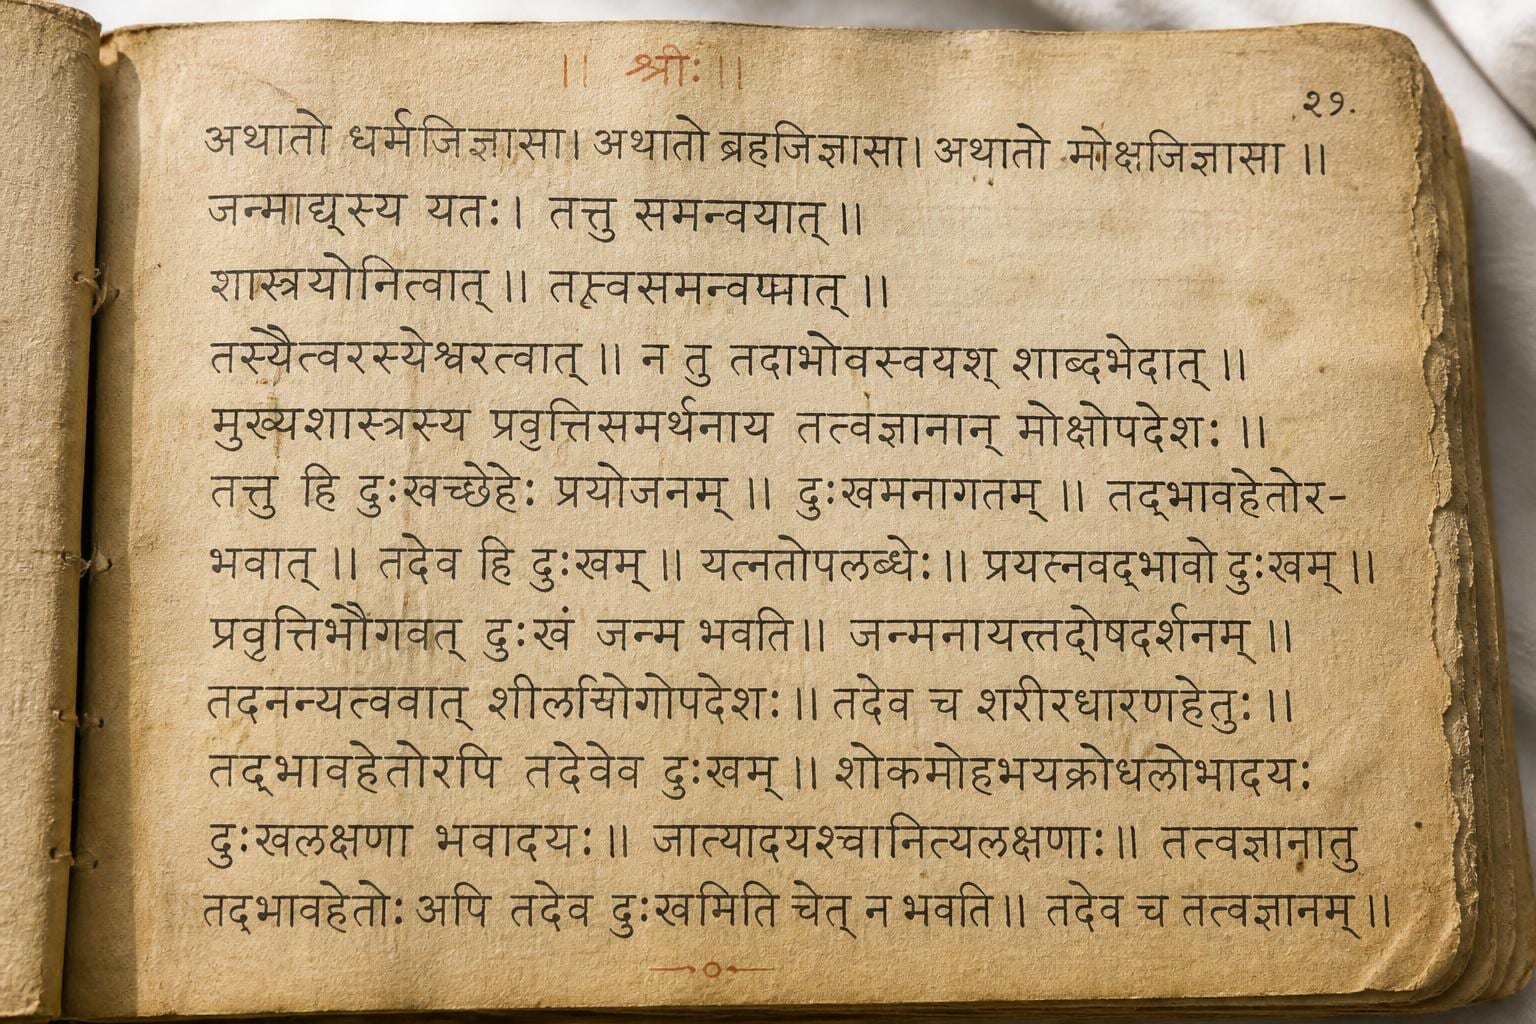
Imagine um manuscrito em sânscrito de 400 anos. O escriba amontoou comentários nas margens, escreveu algumas passagens em espiral ao redor de uma ilustração devocional e espremeu 44 linhas em uma única página nas seções mais densas. Alguém treinado para ler essa escrita poderia levar um minuto inteiro apenas tentando discernir qual traço pertence a qual linha antes mesmo de transcrever uma única palavra. Aqui está o ponto surpreendente: um pipeline de OCR de três estágios razoavelmente convencional — do tipo que a maioria dos especialistas em visão computacional consideraria ultrapassado — acaba superando Gemini, GPT e Claude na leitura dessas páginas, depois que um humano corrige manualmente exatamente três delas.
Essa é a conclusão de um novo artigo, "Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts", de autoria de Kartik Chincholikar, Kaushik Gopalan e Mihir Hasabnis. Trata-se de um choque de realidade oportuno para quem assume que a solução para um problema complexo em documentos é sempre apontar um modelo multimodal ainda maior para ele.
Por que essas páginas quebram a cartilha tradicional do OCR
A maioria dos sistemas de OCR presume que o texto flui em linhas horizontais bem organizadas ao longo da página, como ocorre em um livro impresso ou em um recibo. Os manuscritos históricos em sânscrito quebram essa premissa em várias frentes simultaneamente. Os pesquisadores agruparam seus três manuscritos de amostra por nível de dificuldade de layout: um layout moderado com notas marginais e glosas interlineares, um layout denso com média de 44.43 linhas de texto por página e um layout circular, no qual a escrita contorna ilustrações em vez de seguir em linha reta.
Além desse problema geométrico, há uma questão visual. Cada escriba possui sua própria caligrafia, moldada pela época e pela região. As páginas apresentam manchas, rasgos e iluminação irregular por terem sido fotografadas em um arquivo em vez de digitalizadas em um scanner de mesa. E corrigir qualquer um desses problemas exige alguém que realmente saiba ler sânscrito histórico — uma habilidade escassa e cara de contratar. Essa escassez é a verdadeira restrição em torno da qual o artigo foi estruturado: reduzir a quantidade de correções que um especialista no domínio precisa fazer, e não apenas melhorar a precisão bruta.
Três modelos integrados, e não uma rede gigante única
O pipeline construído pelos autores conta com três etapas distintas, em vez de uma única rede ponta a ponta (end-to-end).
Primeiro, um detector de caracteres pré-treinado e congelado (frozen) chamado CRAFT varre a página e gera um mapa de calor indicando a provável localização dos caracteres individuais, similar a uma imagem térmica mostrando quais trechos da página contêm tinta com formato de letra. Em segundo lugar, uma rede neural em grafo (GNN) baseada em uma arquitetura chamada SplineCNN recebe os caracteres detectados e decide, par a par, se dois caracteres pertencem à mesma linha. Pense nisso como um jogo de ligar os pontos: cada caractere é um ponto, e a função da rede é determinar quais pontos se conectam para formar uma linha de texto, e em qual ordem. Em terceiro lugar, uma rede CNN-BiLSTM-CTC lê cada linha montada e a converte em texto Unicode. Essa última parte utiliza uma técnica de treinamento chamada CTC (connectionist temporal classification), que permite ao modelo produzir uma transcrição sem precisar saber com antecedência o ponto exato de início e término de cada letra na imagem — algo muito útil quando a caligrafia não possui uma segmentação limpa.
Para os manuscritos circulares, o pipeline inclui um truque geométrico: ele localiza um sistema de coordenadas locais que acompanha a curvatura do texto e praticamente o "desenrola" em uma faixa reta antes de entregá-lo ao leitor. Sem essa etapa, um reconhecedor treinado em linhas retas não teria a menor chance diante de um texto que se curva ao redor de uma ilustração.
Dois botões, ajustados separadamente
A ideia central do artigo é aplicar o fine-tuning a esse pipeline por meio de dois eixos que operam de maneira independente.
O fine-tuning no nível do layout retreina a rede em grafo em uma página cujos agrupamentos de linhas foram corrigidos por um humano. Ele utiliza técnicas de aumento de dados (data augmentation, como distorção, inclinação e descarte aleatório de nós) para transformar uma única página corrigida em um sinal de treinamento muito maior, executando então dez épocas com uma função de perda ajustada para priorizar os exemplos mais difíceis. Já o fine-tuning no nível da aparência retreina o reconhecedor em uma página cujo texto transcrito foi corrigido por um humano, adaptando o modelo à caligrafia daquele escriba específico e ao desgaste característico daquela página ao longo de 60 iterações.
Como esses dois ajustes são desacoplados, corrigir um não obriga você a retreinar o outro. É possível ensinar ao sistema que "este escriba faz anotações marginais em uma coluna à esquerda" sem alterar nada do que ele já sabe sobre o traçado das letras daquele escriba, e vice-versa.
O ciclo em si é direto: corrige-se uma página, faz-se o fine-tuning de ambos os modelos com base nessa correção e, em seguida, executa-se o pipeline aprimorado na página seguinte. Como o modelo agora possui uma representação funcional dos hábitos de layout e da caligrafia daquele escriba, a próxima página demandará menos intervenção. Repita esse processo algumas vezes e o volume de correções cai rapidamente — e esse é o verdadeiro objetivo: o artigo não está perseguindo uma pontuação de leaderboard, mas tentando devolver a um historiador uma tarde inteira de trabalho.
Três páginas, três manuscritos, números reais
A equipe construiu seu conjunto de avaliação a partir de três manuscritos em sânscrito: um de layout moderado (15 páginas, média de 21.07 linhas por página), um de layout denso (7 páginas, média de 44.43 linhas por página) e um de layout circular (9 páginas, média de 28.33 linhas por página), totalizando 31 páginas. Cada página contém anotações granulares de layout e uma transcrição Unicode completa, estruturadas em PAGE-XML — formato que arquivos e bibliotecas já utilizam para esse tipo de ground truth. Isso, por si só, é uma contribuição valiosa: conjuntos de dados de manuscritos históricos anotados com esse nível de detalhe são raros, e o sânscrito é negligenciado até mesmo para os padrões modestos que as pesquisas de OCR costumam adotar para alfabetos não latinos.
Em termos de precisão, após o fine-tuning em apenas três páginas e operando de forma totalmente automática (ou seja, quando o ciclo utiliza as próprias previsões do modelo como pseudocorreções, em vez de correções humanas), o manuscrito de layout moderado viu sua pontuação de TextEdit cair 34.1% e sua taxa de erro de caracteres por página (Page-CER) diminuir 37.5%. O layout denso melhorou 22.9% em ambas as métricas. O layout circular, o caso mais difícil, obteve uma melhora de 15.5% no TextEdit e de 8.1% no Page-CER.
O TextEdit corresponde, a grosso modo, à proporção de caracteres que você precisaria inserir, excluir ou substituir para transformar a saída do modelo na transcrição correta. O Page-CER mede o mesmo tipo de erro, mas em toda a página, em vez de avaliar linha por linha — o que é especialmente relevante neste caso, já que um modelo que erra a ordem de leitura ainda pode obter uma boa pontuação em uma métrica por linha, mesmo entregando uma página totalmente desordenada.
Quando um humano intervém e corrige o layout como parte do ciclo, em vez de deixá-lo rodar de forma totalmente automática, os ganhos são ainda maiores: a pontuação de TextEdit do manuscrito de layout moderado caiu 51.3%, e o layout denso melhorou 36.2% no TextEdit e 36.9% no Page-CER.
O que torna o ciclo vantajoso é o aspecto do custo. A correção manual de uma página levou 38.0 segundos no layout moderado, 165.5 segundos no layout denso e 109.0 segundos no layout circular — todos confortavelmente abaixo de três minutos, mesmo no pior cenário. O fine-tuning dos dois modelos entre as páginas custou 41.10 segundos para a rede em grafo e 27.51 segundos para o reconhecedor, somando menos de 70 segundos no total. Esse custo computacional é inferior ao tempo de correção poupado logo na página seguinte; assim, o ciclo se paga quase que instantaneamente, sem exigir um investimento inicial elevado para se tornar viável.
Por que isso importa se você está desenvolvendo ou escolhendo um OCR
A lição aqui não é "vá correndo implementar CRAFT e SplineCNN". É que um pipeline especializado que você possa ajustar com fine-tuning de baixo custo, usando apenas um punhado de documentos próprios, pode superar um modelo de uso geral que nunca viu o seu tipo de documento antes — e não é preciso muito treinamento para chegar lá. Isso se aplica especialmente quando os seus documentos compartilham um padrão interno consistente: a caligrafia de um determinado escriba, o arranjo de câmera de um arquivo específico, o modelo de fatura de um fornecedor ou a formatação de processos de um tribunal.
Se você está processando um grande volume de documentos visualmente semelhantes, a lógica econômica favorece gastar algumas horas corrigindo algumas páginas de amostra e aplicando fine-tuning sobre elas, em vez de pagar por página para enviar cada documento a um modelo de fronteira que estará tentando adivinhar tudo sem nenhum exemplo prévio do seu layout específico. Esse cálculo se inverte quando seus documentos são genuinamente heterogêneos e não há um padrão comum que um modelo menor possa aprender. Saiba exatamente em qual situação você se encontra antes de definir uma estratégia, pois uma decisão errada em qualquer uma das direções custa caro: estruturar um ciclo complexo de fine-tuning para um lote pontual desperdiça tempo de engenharia, enquanto deixar de construí-lo para um tipo de documento recorrente e de alto volume drena silenciosamente a precisão e inflaciona os custos com API para sempre.
Onde os modelos "inteligentes" realmente tiveram dificuldades
O artigo também avalia quatro grandes modelos de linguagem multimodais (MLLMs) prontos para uso (out-of-the-box): Gemini 3.5 Flash, GPT-5.6 Terra, Claude Sonnet 5 e Sarvam Vision, um modelo desenvolvido especificamente para escritas índicas.
No manuscrito de layout moderado, o Gemini 3.5 Flash liderou o grupo com 0.26 de TextEdit e 0.35 de Page-CER, enquanto o Claude Sonnet 5 marcou 0.60 e 0.64, e o GPT-5.6 Terra ficou com 0.71 e 0.74 — o que significa errar aproximadamente sete a cada dez caracteres. No layout denso, o Gemini obteve 0.30 e 0.44, enquanto o Sarvam Vision registrou 0.43 e 0.64. No layout circular, o Gemini liderou novamente com 0.51 em ambas as métricas, ao passo que o Sarvam Vision entrou no que os autores denominaram "geração descontrolada" (runaway generation): ele continuou gerando texto muito além do término do trecho real, praticamente inventando conteúdo que não existia na página.
E então vem o desfecho: após o fine-tuning em apenas três páginas, o pipeline tradicional superou o Gemini 3.5 Flash — o melhor dos quatro modelos multimodais — em todos os três manuscritos, em ambas as métricas. Modelos de visão e linguagem de uso geral, mesmo treinados em volumes massivos de texto e imagens, ainda não são eficientes na leitura a frio de uma escrita histórica específica com a qual provavelmente tiveram pouco contato durante o treinamento. Um punhado de exemplos corrigidos eliminou uma discrepância que a escala bruta não havia conseguido resolver.
O que o artigo ainda não responde
Trinta e uma páginas distribuídas em três manuscritos compõem um conjunto de avaliação pequeno, embora seja importante lembrar o motivo: anotar cada página exige conhecimento especializado em paleografia, de modo que este não é um dataset que você expande contratando mão de obra em plataformas de crowdsourcing. O detector de caracteres na entrada do pipeline, o CRAFT, permaneceu congelado o tempo todo. Apenas a rede em grafo e o reconhecedor passaram por fine-tuning; portanto, todo o sistema ainda enfrenta o gargalo da capacidade dessa primeira etapa intacta de localizar caracteres em páginas com iluminação irregular ou manchas acentuadas.
Há também um custo de configuração considerável. Desenvolver e ajustar um detector de caracteres, uma rede em grafo e um reconhecedor CNN-BiLSTM-CTC é uma tarefa bem mais complexa do que simplesmente apontar um script para a API de um modelo de visão e linguagem. Isso só compensa quando há volume suficiente para amortizar essa configuração inicial. Para um punhado de páginas transcritas apenas uma vez e nunca mais, provavelmente ainda é mais rápido corrigir à mão ou enviar para o melhor MLLM disponível.
O código e o conjunto de dados estão disponíveis publicamente no GitHub em flame-cai/gnn-synthetic-layout-historical, incluindo as anotações em PAGE-XML. Essa é uma contribuição verdadeiramente valiosa. Datasets de manuscritos históricos digitalizados com esse nível de ground truth de layout são difíceis de encontrar e, independentemente do que venha a ser construído sobre esse pipeline no futuro, é provável que o dataset continue sendo relevante por muito mais tempo.