संस्कृत पांडुलिपियों को पढ़ने में एक पारंपरिक OCR पाइपलाइन ने Gemini, GPT और Claude को पीछे छोड़ा
आधारित शोध-पत्र: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
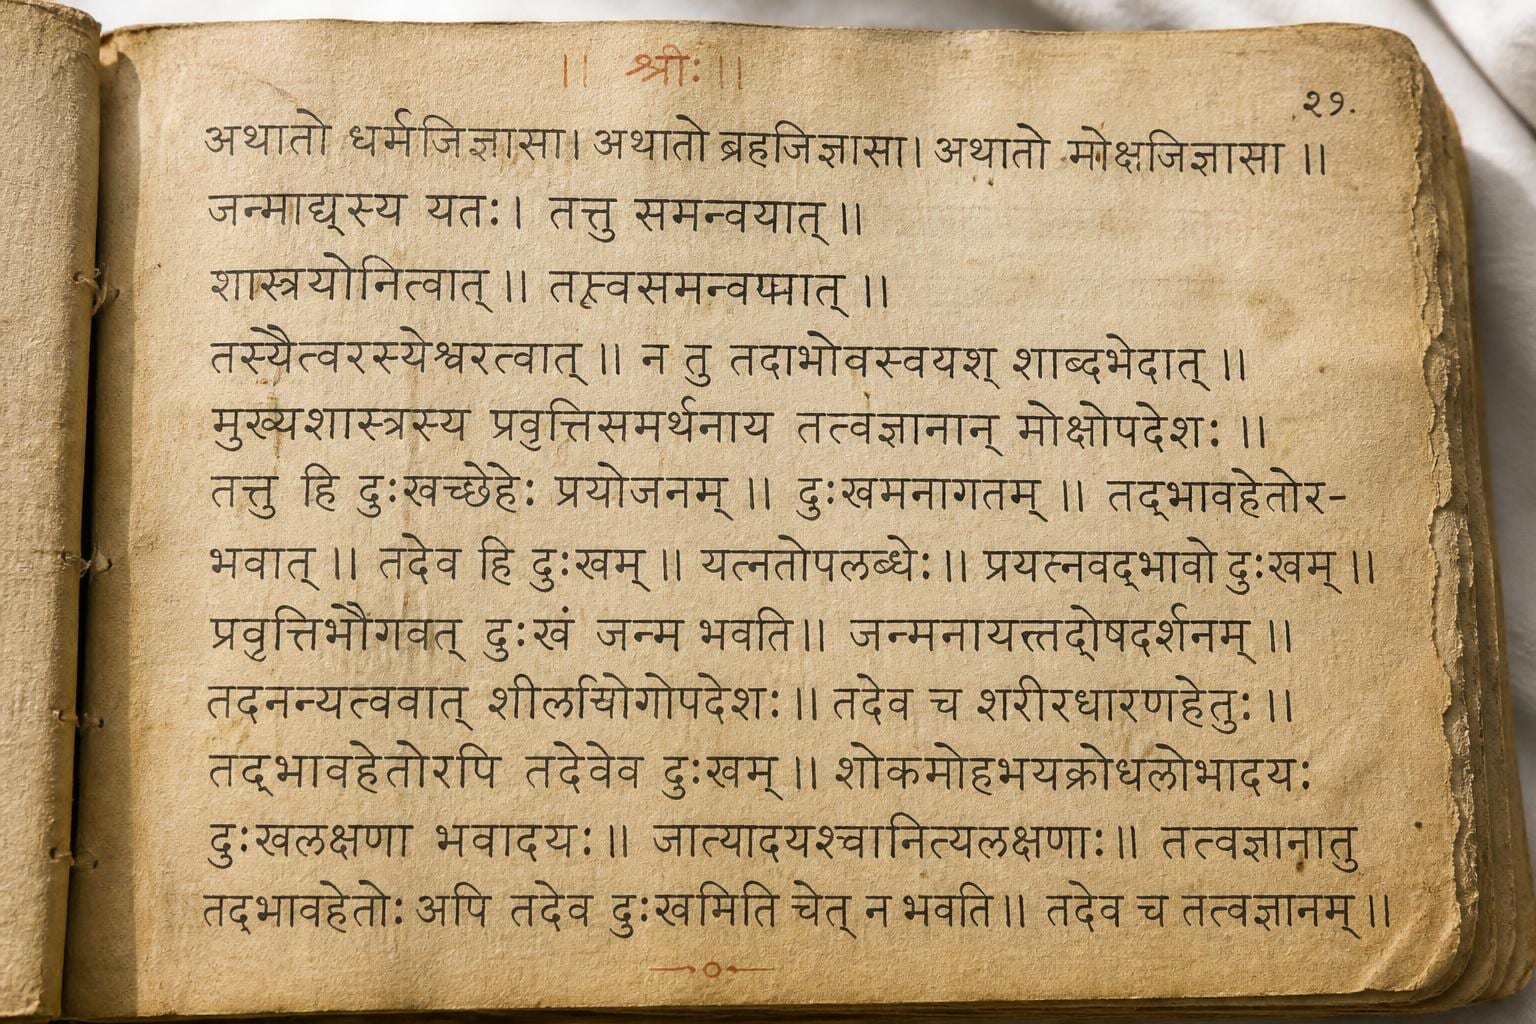
कल्पना कीजिए 400 साल पुरानी किसी संस्कृत पांडुलिपि की। लेखक (scribe) ने मार्जिन में टीकाएं ठूंस रखी हैं, किसी भक्तिपूर्ण चित्र के चारों ओर घुमावदार (spiral) आकार में पंक्तियां लिखी हैं, और सबसे घने हिस्सों में एक ही पन्ने पर 44 पंक्तियां भर दी हैं। इस लिपि को पढ़ने का प्रशिक्षण प्राप्त व्यक्ति भी एक शब्द का लिप्यंतरण (transcribe) करने से पहले पूरा एक मिनट यह समझने में लगा सकता है कि कौन सा स्ट्रोक किस पंक्ति का हिस्सा है। लेकिन दिलचस्प बात यह है: एक पारंपरिक थ्री-स्टेज OCR पाइपलाइन—जिसे कंप्यूटर विज़न के अधिकतर लोग शायद पुराना मानेंगे—इन पन्नों को पढ़ने में Gemini, GPT और Claude को मात दे देती है, वह भी तब जब किसी इंसान ने हाथ से सिर्फ तीन पन्नों को ठीक किया हो।
यह निष्कर्ष Kartik Chincholikar, Kaushik Gopalan और Mihir Hasabnis के एक नए शोधपत्र, "Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts" से सामने आया है। यह उन सभी लोगों के लिए एक सटीक रियलिटी चेक है जो यह मानते हैं कि दस्तावेज़ों से जुड़ी किसी भी जटिल समस्या का हल हमेशा किसी बड़े मल्टीमॉडल मॉडल को लगा देना ही होता है।
पारंपरिक OCR के तरीके इन पन्नों के सामने क्यों नाकाम हो जाते हैं
अधिकांश OCR प्रणालियाँ यह मानकर चलती हैं कि टेक्स्ट पन्ने पर ऊपर से नीचे सीधी क्षैतिज (horizontal) पंक्तियों में चलता है, जैसे किसी छपी हुई किताब या रसीद में होता है। ऐतिहासिक संस्कृत पांडुलिपियाँ इस धारणा को एक साथ कई दिशाओं में तोड़ती हैं। शोधकर्ताओं ने अपनी तीन नमूना पांडुलिपियों को लेआउट की जटिलता के आधार पर वर्गीकृत किया है: एक मध्यम (moderate) लेआउट जिसमें हाशिए के नोट्स (marginal notes) और पंक्तियों के बीच की टिप्पणियाँ (interlinear glosses) शामिल हैं; एक घना (dense) लेआउट जिसमें प्रति पृष्ठ औसतन 44.43 टेक्स्ट पंक्तियाँ हैं; और एक वृत्ताकार (circular) लेआउट जहाँ लिपि सीधी चलने के बजाय चित्रों के चारों ओर घूमती है।
इस ज्यामितीय (geometry) समस्या के अलावा, एक रूप-रंग (appearance) की समस्या भी है। हर लेखक (scribe) की अपनी लिखावट होती है, जो कालखंड और क्षेत्र से प्रभावित होती है। पन्नों पर दाग-धब्बे, फटे हुए हिस्से और असमान रोशनी (uneven lighting) होती है, क्योंकि उन्हें किसी फ्लैटबेड स्कैनर से स्कैन करने के बजाय किसी अभिलेखागार (archive) में कैमरे से फोटो खींचा गया होता है। और इनमें से किसी भी चीज़ को सुधारने के लिए ऐसे व्यक्ति की आवश्यकता होती है जो वास्तव में ऐतिहासिक संस्कृत पढ़ सके—एक ऐसा हुनर जो दुर्लभ है और जिसे काम पर रखना काफी महंगा है। यह कमी ही वह वास्तविक बाधा (constraint) है जिसके समाधान के लिए यह शोधपत्र तैयार किया गया है: इसका उद्देश्य केवल शुद्ध सटीकता (raw accuracy) बढ़ाना नहीं, बल्कि किसी विषय विशेषज्ञ (domain expert) द्वारा किए जाने वाले सुधार कार्य को कम करना भी है।
एक विशाल नेटवर्क के बजाय, एक साथ जोड़े गए तीन अलग मॉडल
लेखकों द्वारा तैयार की गई पाइपलाइन में किसी एक एंड-टू-एंड नेटवर्क के बजाय तीन अलग-अलग चरण हैं।
पहला, एक फ्रोज़न, प्रीट्रेन्ड कैरेक्टर डिटेक्टर, जिसे CRAFT कहा जाता है, पन्ने को स्कैन करता है और इस बात का हीटमैप (heatmap) तैयार करता है कि अलग-अलग अक्षर संभावित रूप से कहाँ स्थित हैं—बिल्कुल एक थर्मल इमेज की तरह जो यह दिखाती है कि पन्ने के किन हिस्सों में अक्षर के आकार की स्याही मौजूद है। दूसरा, SplineCNN आर्किटेक्चर पर आधारित एक ग्राफ न्यूरल नेटवर्क (GNN) इन पहचाने गए अक्षरों को लेता है और एक बार में एक जोड़ी पर यह तय करता है कि क्या दो अक्षर एक ही पंक्ति का हिस्सा हैं। इसे 'बिंदुओं को जोड़ने' (connect-the-dots) जैसा समझें: प्रत्येक अक्षर एक बिंदु है, और नेटवर्क का काम यह पता लगाना है कि कौन से बिंदु आपस में जुड़कर एक टेक्स्ट पंक्ति बनाते हैं और उनका क्रम क्या है। तीसरा, एक CNN-BiLSTM-CTC नेटवर्क हर जोड़ी गई पंक्ति को पढ़ता है और उसे यूनिकोड (Unicode) टेक्स्ट में बदलता है। यह अंतिम हिस्सा CTC (connectionist temporal classification) नामक एक ट्रेनिंग तकनीक का उपयोग करता है, जो मॉडल को इमेज पर यह पहले से जाने बिना लिप्यंतरण आउटपुट करने की अनुमति देता है कि प्रत्येक अक्षर ठीक कहाँ शुरू और खत्म होता है—यह तब बेहद उपयोगी होता है जब लिखावट को स्पष्ट रूप से अलग-अलग (segment) नहीं किया जा सकता।
वृत्ताकार (circular) पांडुलिपियों के लिए, पाइपलाइन एक ज्यामितीय तरकीब जोड़ती है: यह एक ऐसा स्थानीय निर्देशांक तंत्र (local coordinate system) खोजती है जो टेक्स्ट के घुमाव का अनुसरण करता है और इसे पहचानकर्ता (recognizer) को सौंपने से पहले एक सीधी पट्टी के रूप में खोल (unroll) देता है। इस चरण के बिना, सीधी पंक्तियों पर प्रशिक्षित पहचानकर्ता के पास किसी चित्र के चारों ओर मुड़े हुए टेक्स्ट को पढ़ने का कोई मौका नहीं होता।
दो अलग-अलग डायल, जिन्हें अलग-अलग ट्यून किया जाता है
इस शोधपत्र का मुख्य विचार इस पाइपलाइन को दो ऐसे डायल पर फाइन-ट्यून करना है जो स्वतंत्र रूप से काम करते हैं।
लेआउट-स्तरीय (Layout-level) फाइन-ट्यूनिंग ग्राफ नेटवर्क को उस पन्ने पर दोबारा प्रशिक्षित करती है जहाँ किसी इंसान ने पंक्तियों के समूहीकरण (line groupings) को सुधारा हो। इसमें डेटा ऑग्मेंटेशन (warping, skewing और नोड्स को रैंडमली ड्रॉप करना) का उपयोग करके एक सुधारे गए पन्ने को बहुत बड़े ट्रेनिंग सिग्नल में बदला जाता है, और फिर सबसे कठिन उदाहरणों पर ध्यान केंद्रित करने के लिए ट्यून किए गए लॉस फंक्शन (loss function) के साथ दस इपॉक्स (epochs) चलाए जाते हैं। अपीयरेंस-स्तरीय (Appearance-level) फाइन-ट्यूनिंग उस पन्ने पर पहचानकर्ता (recognizer) को पुनः प्रशिक्षित करती है जहाँ किसी इंसान ने वास्तविक लिप्यंतरित टेक्स्ट को सुधारा हो, जिससे 60 इटरेशन्स (iterations) में यह उस विशिष्ट लेखक की लिखावट और पन्ने की टूट-फूट के अनुसार खुद को ढाल लेता है।
चूँकि ये दोनों डायल अलग-अलग हैं, इसलिए एक को सुधारने पर आपको दूसरे को फिर से प्रशिक्षित करने की आवश्यकता नहीं होती। आप सिस्टम को यह सिखा सकते हैं कि "यह लेखक बाईं ओर के कॉलम में मार्जिन नोट्स लिखता है", बिना इस बात को छेड़े कि वह लेखक के अक्षरों की बनावट के बारे में क्या जानता है, और इसका उल्टा भी उतना ही सच है।
यह लूप बेहद सीधा है: एक पन्ना सुधारें, उस सुधार पर दोनों मॉडलों को फाइन-ट्यून करें, और फिर बेहतर हुई पाइपलाइन को अगले पन्ने पर चलाएं। चूँकि मॉडल के पास अब इस लेखक के लेआउट की आदतों और लिखावट का एक व्यावहारिक मॉडल मौजूद है, इसलिए अगले पन्ने पर कम मानवीय सुधार की आवश्यकता होती है। इसे कुछ बार दोहराएं और सुधार का बोझ तेज़ी से घट जाता है, जो कि इसका वास्तविक उद्देश्य है: यह पेपर किसी लीडरबोर्ड नंबर के पीछे नहीं भाग रहा, बल्कि किसी इतिहासकार का कीमती समय बचाने की कोशिश कर रहा है।
तीन पन्ने, तीन पांडुलिपियाँ, वास्तविक आँकड़े
टीम ने अपना मूल्यांकन सेट (evaluation set) तीन संस्कृत पांडुलिपियों से तैयार किया: एक मध्यम-लेआउट वाली (15 पन्ने, औसतन 21.07 पंक्तियाँ प्रति पृष्ठ), एक घने-लेआउट वाली (7 पन्ने, औसतन 44.43 पंक्तियाँ प्रति पृष्ठ), और एक वृत्ताकार-लेआउट वाली (9 पन्ने, औसतन 28.33 पंक्तियाँ प्रति पृष्ठ), कुल मिलाकर 31 पन्ने। प्रत्येक पृष्ठ में बारीक लेआउट एनोटेशन के साथ-साथ एक पूर्ण यूनिकोड लिप्यंतरण है, जिसे PAGE-XML में एनकोड किया गया है—यह एक ऐसा प्रारूप है जिसे अभिलेखागार और पुस्तकालय इस प्रकार के ग्राउंड ट्रुथ (ground truth) के लिए पहले से उपयोग करते हैं। केवल यही अपने आप में एक उपयोगी योगदान है: इस स्तर के विवरण वाले एनोटेट किए गए ऐतिहासिक-पांडुलिपि डेटासेट दुर्लभ हैं, और गैर-लैटिन लिपियों के लिए OCR अनुसंधान में आम तौर पर तय किए जाने वाले निम्न मानकों के हिसाब से भी संस्कृत पर बहुत कम काम हुआ है।
सटीकता के संदर्भ में, केवल तीन पन्नों पर फाइन-ट्यूनिंग के बाद, पूरी तरह से स्वचालित रूप से चलाने पर (जिसका अर्थ है कि लूप मानवीय सुधार के बजाय मॉडल की अपनी भविष्यवाणियों को छद्म-सुधार यानी pseudo-corrections के रूप में उपयोग करता है), मध्यम-लेआउट वाली पांडुलिपि के TextEdit स्कोर में 34.1% और इसके पृष्ठ-स्तरीय कैरेक्टर एरर रेट (Page-CER) में 37.5% की गिरावट देखी गई। घने लेआउट में दोनों मेट्रिक्स पर 22.9% का सुधार हुआ। वृत्ताकार लेआउट, जो सबसे कठिन मामला था, ने TextEdit पर 15.5% और Page-CER पर 8.1% का सुधार दर्ज किया।
TextEdit मोटे तौर पर उन वर्णों (characters) का अनुपात है जिन्हें मॉडल के आउटपुट को सही लिप्यंतरण में बदलने के लिए सम्मिलित (insert), हटाना (delete) या बदलना (swap) पड़ता है। Page-CER इसी प्रकार की त्रुटि को पंक्ति-दर-पंक्ति मापने के बजाय पूरे पृष्ठ पर मापता है, जो यहाँ विशेष रूप से मायने रखता है क्योंकि पढ़ने के क्रम (reading order) को गलत समझने वाला मॉडल भी प्रति-पंक्ति मीट्रिक पर अच्छा स्कोर कर सकता है, जबकि वह एक बिखरा हुआ (scrambled) पृष्ठ तैयार कर रहा होता है।
जब कोई इंसान इस लूप के हिस्से के रूप में लेआउट को पूरी तरह स्वचालित चलने देने के बजाय वास्तव में ठीक करता है, तो लाभ और बढ़ जाते हैं: मध्यम-लेआउट पांडुलिपि का TextEdit स्कोर 51.3% गिर गया, और घने लेआउट में TextEdit पर 36.2% और Page-CER पर 36.9% का सुधार हुआ।
इस लूप को चलाने लायक जो चीज़ बनाती है, वह है इसकी लागत का पहलू। एक पन्ने को मैन्युअल रूप से ठीक करने में मध्यम लेआउट के लिए 38.0 सेकंड, घने लेआउट के लिए 165.5 सेकंड और वृत्ताकार लेआउट के लिए 109.0 सेकंड का समय लगा—सबसे जटिल स्थिति में भी यह समय तीन मिनट से काफी कम रहा। पन्नों के बीच दोनों मॉडलों को फाइन-ट्यून करने में ग्राफ नेटवर्क के लिए 41.10 सेकंड और पहचानकर्ता के लिए 27.51 सेकंड लगे, यानी दोनों मिलाकर 70 सेकंड से भी कम। यह कंप्यूट लागत उस सुधार समय से कम है जो यह ठीक अगले पन्ने पर बचाती है, इसलिए यह लूप व्यावहारिक बनने से पहले किसी बड़े अग्रिम निवेश (upfront investment) की मांग करने के बजाय लगभग तुरंत ही अपनी भरपाई कर लेता है।
यदि आप OCR बना रहे हैं या चुन रहे हैं तो यह क्यों मायने रखता है
यहाँ सबक यह नहीं है कि "जाकर CRAFT और SplineCNN लागू करें।" सबक यह है कि एक संकीर्ण (narrow) पाइपलाइन, जिसे आप अपने ही कुछ दस्तावेज़ों पर कम लागत में फाइन-ट्यून कर सकते हैं, ऐसे सामान्य-उद्देश्यीय मॉडल से बेहतर प्रदर्शन कर सकती है जिसने आपके दस्तावेज़ का प्रकार पहले कभी नहीं देखा है—और वहाँ तक पहुँचने के लिए बहुत अधिक फाइन-ट्यूनिंग की आवश्यकता नहीं होती। यह विशेष रूप से तब लागू होता है जब आपके दस्तावेज़ों का एक मज़बूत आंतरिक पैटर्न हो: किसी एक लेखक की लिखावट, किसी एक अभिलेखागार का कैमरा सेटअप, किसी एक वेंडर का इनवॉइस टेम्प्लेट, या किसी एक अदालत का फाइलिंग फ़ॉर्मेट। यह बात देवनागरी जैसी लिपियों के मामले में और भी प्रासंगिक हो जाती है, जहाँ शिरोरेखा, संयुक्त अक्षरों और मात्राओं की जटिलता के कारण अंग्रेज़ी में बेहतरीन प्रदर्शन करने वाला OCR भी अक्सर नाकाम साबित होता है।
यदि आप देखने में समान दस्तावेज़ों के एक बड़े बैच को प्रोसेस कर रहे हैं, तो आर्थिक दृष्टि से कुछ नमूना पन्नों को सुधारने में दो घंटे बिताना और उन पर फाइन-ट्यून करना अधिक फायदेमंद है, बजाय इसके कि आप हर दस्तावेज़ को किसी फ्रंटियर मॉडल पर भेजने के लिए प्रति-पृष्ठ भुगतान करें जो आपके विशिष्ट लेआउट के शून्य उदाहरणों के आधार पर केवल अंदाज़ा लगा रहा हो। लेकिन जब आपके दस्तावेज़ वास्तव में विषम (heterogeneous) हों और किसी छोटे मॉडल के सीखने के लिए कोई साझा पैटर्न न हो, तो यह समीकरण उलट जाता है। कोई रणनीति चुनने से पहले यह अच्छी तरह जान लें कि आपकी वास्तविक स्थिति क्या है, क्योंकि दोनों ही मामलों में गलत निर्णय महंगा पड़ता है: किसी एक बार के बैच के लिए बहुत बड़ा फाइन-ट्यूनिंग लूप तैयार करना इंजीनियरिंग समय की बर्बादी है, और बार-बार आने वाले, उच्च-मात्रा वाले दस्तावेज़ प्रकार के लिए इसे पर्याप्त रूप से न बनाना सटीकता को प्रभावित करता है और हमेशा के लिए आपकी API लागत को बढ़ाता रहता है।
"स्मार्ट" मॉडल असल में कहाँ लड़खड़ाए
शोधपत्र चार मल्टीमॉडल लार्ज लैंग्वेज मॉडल्स का सीधे (out of the box) बेंचमार्क भी प्रस्तुत करता है: Gemini 3.5 Flash, GPT-5.6 Terra, Claude Sonnet 5, और Sarvam Vision, जो विशेष रूप से भारतीय लिपियों (Indic scripts) के लिए बनाया गया एक मॉडल है।
मध्यम-लेआउट वाली पांडुलिपि पर, 0.26 TextEdit और 0.35 Page-CER के साथ Gemini 3.5 Flash इस समूह में शीर्ष पर रहा; Claude Sonnet 5 ने 0.60 और 0.64, तथा GPT-5.6 Terra ने 0.71 और 0.74 स्कोर किया, जिसका अर्थ है कि लगभग हर दस में से सात अक्षर गलत थे। घने लेआउट पर, Gemini ने 0.30 और 0.44 स्कोर किया, जबकि Sarvam Vision 0.43 और 0.64 पर रहा। वृत्ताकार लेआउट पर, Gemini दोनों मेट्रिक्स पर 0.51 के साथ एक बार फिर सबसे आगे रहा, जबकि Sarvam Vision के बारे में बताया गया कि वह उस स्थिति में चला गया जिसे लेखक 'रनवे जेनरेशन' (runaway generation) कहते हैं: जहाँ वास्तविक गद्यांश समाप्त हुआ, यह उसके काफी आगे तक टेक्स्ट उत्पन्न करता रहा, यानी पांडुलिपि की ऐसी सामग्री गढ़ता रहा जो पन्ने पर थी ही नहीं।
फिर आता है असली चौंकाने वाला मोड़। सिर्फ तीन पन्नों पर फाइन-ट्यूनिंग के बाद, इस पारंपरिक पाइपलाइन ने चारों मल्टीमॉडल मॉडलों में सर्वश्रेष्ठ रहे Gemini 3.5 Flash को तीनों पांडुलिपियों पर, दोनों ही मेट्रिक्स में पीछे छोड़ दिया। टेक्स्ट और इमेज के विशाल डेटा पर प्रशिक्षित सामान्य-उद्देश्यीय विज़न-लैंग्वेज मॉडल अभी भी किसी विशिष्ट ऐतिहासिक लिपि को सीधे पढ़ने (cold-reading) में उतने सक्षम नहीं हैं, जिसे उन्होंने शायद ट्रेनिंग के दौरान बहुत कम देखा हो। मुट्ठी भर सुधारे गए उदाहरणों ने उस अंतर को पाट दिया जिसे मॉडल का विशाल पैमाना (scale) भी नहीं भर सका था।
शोधपत्र के वे पहलू जिनका उत्तर मिलना अभी बाकी है
तीन पांडुलिपियों के कुल 31 पन्ने एक छोटा मूल्यांकन सेट हैं, हालांकि इसका कारण याद रखना ज़रूरी है: प्रत्येक पृष्ठ को एनोटेट करने के लिए वास्तविक पुरालेखशास्त्र (paleography) के प्रशिक्षण की आवश्यकता होती है, इसलिए यह ऐसा डेटासेट नहीं है जिसे आप क्राउडवर्कर्स (crowdworkers) को भुगतान करके बड़ा कर सकें। पाइपलाइन के शुरुआती हिस्से में मौजूद कैरेक्टर डिटेक्टर, CRAFT, पूरी प्रक्रिया के दौरान फ्रोज़न (अपरिवर्तित) रहा। केवल ग्राफ नेटवर्क और पहचानकर्ता (recognizer) को ही फाइन-ट्यून किया गया था, इसलिए पूरी प्रणाली अभी भी इस बात पर निर्भर करती है कि वह अछूता पहला चरण असामान्य रोशनी या अत्यधिक दाग-धब्बों वाले पन्नों पर अक्षरों को कितनी अच्छी तरह पहचान पाता है।
इसके अलावा इसका एक वास्तविक सेटअप खर्च भी है। एक कैरेक्टर डिटेक्टर, एक ग्राफ नेटवर्क और एक CNN-BiLSTM-CTC पहचानकर्ता का निर्माण और फाइन-ट्यूनिंग करना किसी विज़न-लैंग्वेज मॉडल के API की ओर एक स्क्रिप्ट निर्देशित करने की तुलना में कहीं अधिक भारी काम है। इसका फायदा तभी मिलता है जब आपके पास उस सेटअप की लागत की भरपाई (amortize) करने के लिए पर्याप्त मात्रा में दस्तावेज़ हों। कुछ पन्नों के लिए, जिन्हें केवल एक बार लिप्यंतरित किया जाना हो और दोबारा कभी नहीं, उन्हें हाथ से सुधारना या उपलब्ध सर्वश्रेष्ठ MLLM पर भेजना शायद अभी भी अधिक तेज़ तरीका है।
इसका कोड और डेटासेट PAGE-XML एनोटेशन के साथ GitHub पर flame-cai/gnn-synthetic-layout-historical के तहत सार्वजनिक रूप से उपलब्ध हैं। यह वास्तव में जारी की गई एक बेहद उपयोगी सामग्री है। लेआउट ग्राउंड ट्रुथ के इस स्तर के साथ डिजिटाइज़ किए गए ऐतिहासिक-पांडुलिपि डेटासेट मिलना बहुत कठिन है, और आगे इस पाइपलाइन के ऊपर जो कुछ भी बनेगा, यह डेटासेट संभवतः उससे भी अधिक समय तक उपयोगी बना रहेगा।