Un pipeline de OCR tradicional acaba de superar a Gemini, GPT y Claude al leer sánscrito
Basado en: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
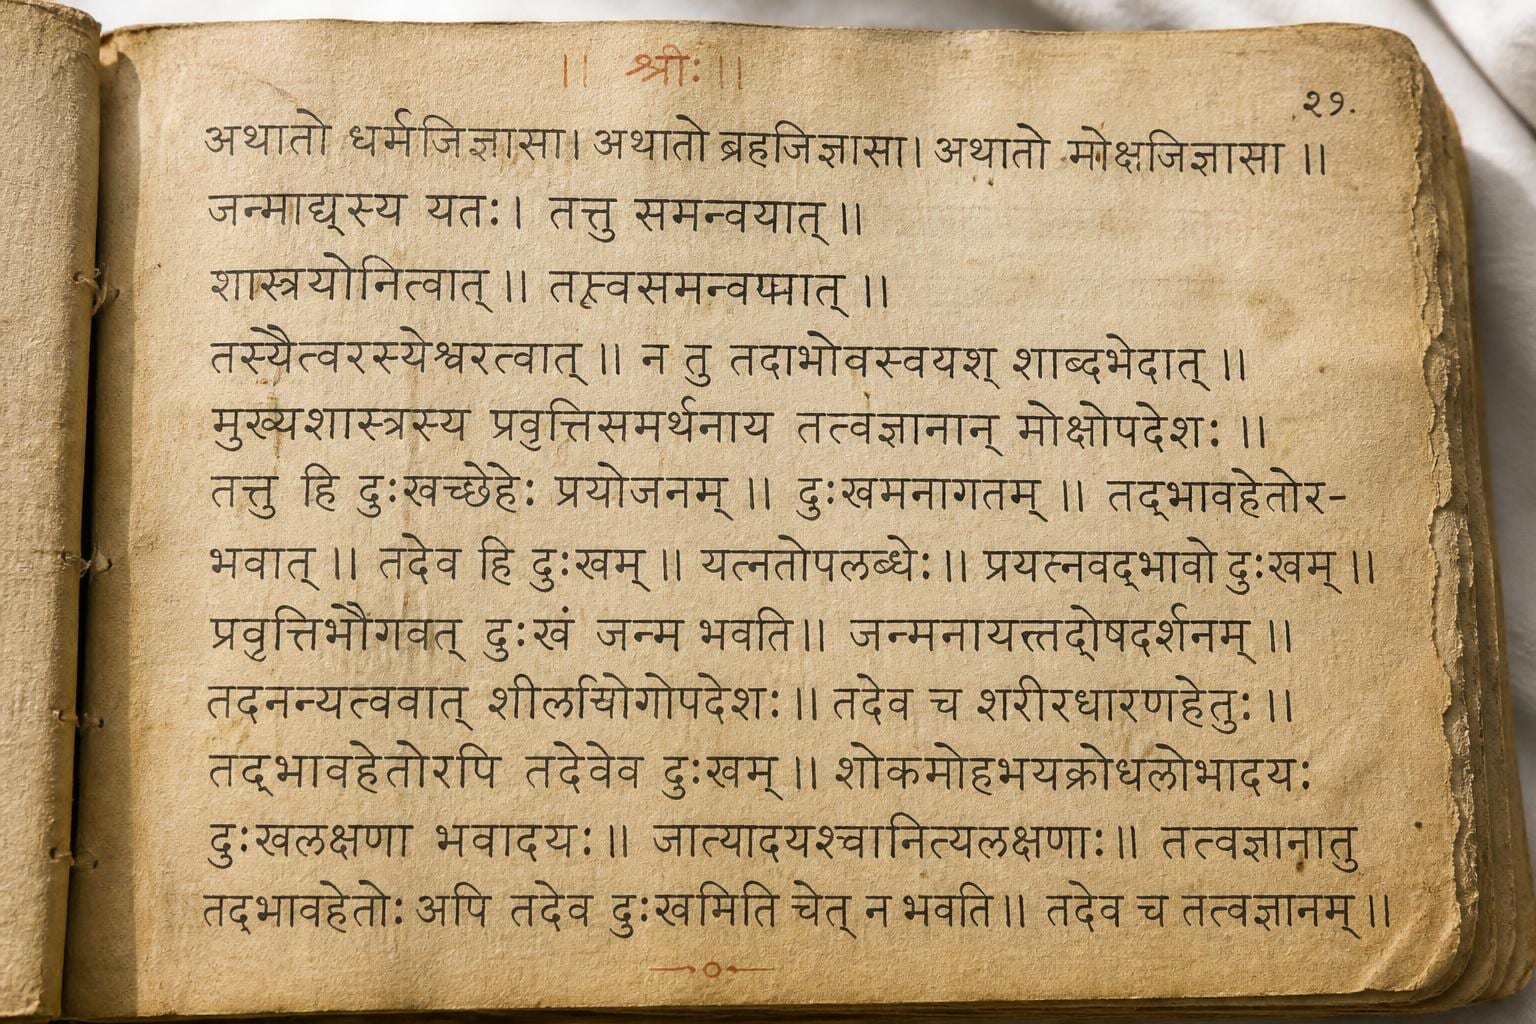
Imagina un manuscrito en sánscrito de hace 400 años. El escriba comprimió comentarios en los márgenes, redactó algunos pasajes en espiral alrededor de una ilustración devocional y condensó 44 líneas en una sola página en las secciones más densas. Alguien entrenado para leer esta escritura podría tardar un minuto entero solo en descifrar a qué línea pertenece cada trazo antes de transcribir una sola palabra. Aquí viene lo curioso: un pipeline de OCR de tres etapas bastante convencional —del tipo que la mayoría de los especialistas en visión por computador consideraría anticuado— termina superando a Gemini, GPT y Claude al leer estas páginas, una vez que un humano ha corregido a mano exactamente tres de ellas.
Ese es el hallazgo de un nuevo artículo, "Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts", de Kartik Chincholikar, Kaushik Gopalan y Mihir Hasabnis. Es una oportuna dosis de realidad para cualquiera que asuma que la solución a un problema documental complejo siempre consiste en apuntarle con un modelo multimodal más grande.
Por qué estas páginas rompen el guion habitual del OCR
La mayoría de los sistemas de OCR asumen que el texto fluye en ordenadas filas horizontales a lo largo de la página, como en un libro impreso o en un recibo. Los manuscritos históricos en sánscrito rompen esa suposición en múltiples direcciones al mismo tiempo. Los investigadores agrupan sus tres manuscritos de muestra según la dificultad del layout: una maquetación moderada con notas marginales y glosas interlineales, una maquetación densa con un promedio de 44.43 líneas de texto por página, y una maquetación circular donde la escritura envuelve ilustraciones en lugar de seguir una línea recta.
Además de ese problema geométrico, existe un problema de apariencia. Cada escriba tiene su propia caligrafía, moldeada por la época y la región. Las páginas presentan manchas, rasgaduras e iluminación irregular al haber sido fotografiadas en un archivo en lugar de digitalizarse con un escáner plano. Y corregir cualquiera de estos detalles requiere a alguien capaz de leer sánscrito histórico, una habilidad escasa y costosa de contratar. Esa escasez es la verdadera limitación en torno a la cual está diseñado el artículo: reducir el volumen de correcciones que debe realizar un experto en la materia, no solo mejorar la precisión bruta.
Tres modelos ensamblados, no una red gigante
El pipeline que construyen los autores consta de tres etapas independientes en lugar de una única red end-to-end.
En primer lugar, un detector de caracteres congelado y preentrenado llamado CRAFT escanea la página y genera un mapa de calor con la ubicación probable de cada carácter individual, similar a una imagen térmica que muestra qué zonas de la página contienen tinta con forma de letra. En segundo lugar, una red neuronal de grafos construida sobre una arquitectura llamada SplineCNN toma los caracteres detectados y decide, par por par, si dos caracteres pertenecen a la misma línea. Piénsalo como el juego de unir los puntos: cada carácter es un punto y la tarea de la red es averiguar qué puntos se encadenan para formar una línea de texto y en qué orden. En tercer lugar, una red CNN-BiLSTM-CTC lee cada línea ensamblada y la convierte en texto Unicode. Esta última pieza utiliza una técnica de entrenamiento llamada CTC (connectionist temporal classification), que permite al modelo generar una transcripción sin necesidad de conocer de antemano el inicio y fin exactos de cada letra en la imagen, algo muy útil cuando la escritura manual no se segmenta de forma limpia.
Para los manuscritos circulares, el pipeline añade un truco geométrico: encuentra un sistema de coordenadas locales que sigue la curvatura del texto y lo «desenrolla» de forma efectiva en una tira recta antes de pasárselo al reconocedor. Sin ese paso, un reconocedor entrenado en líneas rectas no tendría ninguna oportunidad frente a un texto que se curva alrededor de una ilustración.
Dos diales, ajustados por separado
La idea central del artículo es aplicar fine-tuning a este pipeline mediante dos diales que se ajustan de manera independiente.
El fine-tuning a nivel de layout reentrena la red de grafos sobre una página donde un humano ha corregido las agrupaciones de líneas, utilizando data augmentation (deformación, inclinación y eliminación aleatoria de nodos) para transformar una sola página corregida en una señal de entrenamiento mucho mayor, y ejecutando después diez épocas con una función de pérdida configurada para centrarse en los ejemplos más difíciles. El fine-tuning a nivel de apariencia reentrena el reconocedor sobre una página en la que un humano ha corregido el texto transcrito real, adaptándolo a la caligrafía específica de ese escriba y al desgaste concreto de esa página a lo largo de 60 iteraciones.
Dado que estos dos diales son independientes, corregir uno no te obliga a reentrenar el otro. Puedes enseñarle al sistema que «este escriba añade notas marginales en una columna a la izquierda» sin tocar lo que ya sabe sobre las formas de las letras de ese escriba, y viceversa.
El bucle en sí es directo: se corrige una página, se aplica fine-tuning a ambos modelos con esa corrección y luego se ejecuta el pipeline mejorado en la página siguiente. Dado que el sistema dispone ahora de un modelo funcional de los hábitos de layout y de la caligrafía de ese escriba, la siguiente página requiere menos corrección. Se repite esto unas pocas veces y la carga de trabajo de corrección se reduce con rapidez, que es el objetivo real: el artículo no persigue un récord en una tabla clasificatoria, sino devolverle la tarde a un historiador.
Tres páginas, tres manuscritos, cifras reales
El equipo construyó su conjunto de evaluación a partir de tres manuscritos en sánscrito: uno con layout moderado (15 páginas, con un promedio de 21.07 líneas por página), uno con layout denso (7 páginas, con un promedio de 44.43 líneas por página) y uno con layout circular (9 páginas, con un promedio de 28.33 líneas por página), sumando 31 páginas en total. Cada página cuenta con anotaciones granulares de layout y una transcripción completa en Unicode, codificada en PAGE-XML, un formato que los archivos y bibliotecas ya emplean para este tipo de ground truth. Eso en sí mismo ya es una contribución valiosa: los conjuntos de datos de manuscritos históricos anotados con este nivel de detalle son escasos, y el sánscrito está desatendido incluso para el bajo estándar que la investigación en OCR suele exigir a las escrituras no latinas.
En cuanto a precisión, tras realizar fine-tuning con tan solo tres páginas y ejecutándolo de forma totalmente automática (es decir, el bucle utiliza las propias predicciones del modelo como pseudocorrecciones en lugar de las de un humano), el manuscrito de layout moderado vio reducirse su puntuación de TextEdit en un 34.1% y su tasa de error de caracteres a nivel de página (Page-CER) en un 37.5%. El layout denso mejoró un 22.9% en ambas métricas. El layout circular, el caso más complejo, mejoró un 15.5% en TextEdit y un 8.1% en Page-CER.
TextEdit representa aproximadamente la proporción de caracteres que habría que insertar, eliminar o sustituir para transformar la salida del modelo en la transcripción correcta. Page-CER mide el mismo tipo de error, pero en toda la página en lugar de línea por línea, lo cual resulta crítico aquí porque un modelo que altere el orden de lectura puede obtener una buena puntuación en una métrica por línea y, al mismo tiempo, generar una página completamente desordenada.
Cuando un humano interviene corrigiendo el layout en el bucle, en vez de dejarlo correr de forma totalmente automática, las mejoras son aún mayores: la puntuación de TextEdit del manuscrito de layout moderado cayó un 51.3%, y el layout denso mejoró un 36.2% en TextEdit y un 36.9% en Page-CER.
Lo que hace que valga la pena implementar este bucle es la relación de coste. La corrección manual de una página tomó 38.0 segundos para el layout moderado, 165.5 segundos para el layout denso y 109.0 segundos para el layout circular, situándose todas holgadamente por debajo de los tres minutos incluso en el caso más desfavorable. El fine-tuning de ambos modelos entre página y página requirió 41.10 segundos para la red de grafos y 27.51 segundos para el reconocedor: menos de 70 segundos combinados. Ese coste de computación es inferior al tiempo de corrección que ahorra en la página inmediatamente posterior, por lo que el bucle se amortiza casi al instante sin exigir una gran inversión inicial previa para ser rentable.
Por qué esto importa si estás desarrollando o eligiendo soluciones de OCR
La lección aquí no es «ve a implementar CRAFT y SplineCNN». Es que un pipeline especializado al que puedas aplicar fine-tuning de bajo coste con un puñado de tus propios documentos puede superar a un modelo de propósito general que jamás ha visto tu tipo de documento, y no se requiere mucho ajuste para lograrlo. Esto se cumple especialmente cuando los documentos comparten un patrón interno consistente: la letra de un mismo escriba, la configuración de cámara de un archivo específico, la plantilla de factura de un proveedor o el formato de presentación de un juzgado.
Si procesas un gran lote de documentos visualmente similares, la ecuación económica favorece dedicar un par de horas a corregir unas pocas páginas de muestra y hacer fine-tuning sobre ellas, en lugar de pagar por página para enviar cada documento a un modelo frontera que intenta adivinar con cero ejemplos de tu layout específico. Ese cálculo se invierte cuando los documentos son genuinamente heterogéneos y no existe un patrón compartido que un modelo pequeño pueda aprender. Ten claro en qué situación te encuentras antes de elegir una estrategia, ya que equivocarse en cualquiera de los dos sentidos resulta costoso: sobrediseñar un bucle de fine-tuning para un lote puntual desperdicia tiempo de ingeniería, y no construirlo para un tipo de documento recurrente y de gran volumen drena silenciosamente precisión y costes de API de forma indefinida.
Dónde tuvieron verdaderas dificultades los modelos «inteligentes»
El artículo también evalúa cuatro modelos de lenguaje multimodales de gran tamaño listos para usar: Gemini 3.5 Flash, GPT-5.6 Terra, Claude Sonnet 5 y Sarvam Vision, un modelo desarrollado específicamente para escrituras índicas.
En el manuscrito de layout moderado, Gemini 3.5 Flash lideró el grupo con 0.26 en TextEdit y 0.35 en Page-CER, frente a 0.60 y 0.64 de Claude Sonnet 5, y 0.71 y 0.74 de GPT-5.6 Terra, lo que equivale aproximadamente a siete de cada diez caracteres erróneos. En el layout denso, Gemini obtuvo 0.30 y 0.44, mientras que Sarvam Vision se situó en 0.43 y 0.64. En el layout circular, Gemini volvió a encabezar el grupo con 0.51 en ambas métricas, mientras que Sarvam Vision cayó en lo que los autores describen como generación descontrolada (runaway generation): continuó produciendo texto mucho más allá del final del pasaje real, inventando contenido que no existe en la página.
Y aquí llega el punto culminante: tras un fine-tuning con tan solo tres páginas, el pipeline tradicional superó a Gemini 3.5 Flash —el mejor de los cuatro modelos multimodales— en los tres manuscritos y en ambas métricas. Los modelos de visión y lenguaje de propósito general entrenados con enormes volúmenes de texto e imágenes aún no son eficaces leyendo en frío una escritura histórica concreta con la que probablemente apenas tuvieron contacto durante su entrenamiento. Un puñado de ejemplos corregidos cerró una brecha que la escala bruta no había logrado solventar.
Lo que el artículo todavía no resuelve
Treinta y una páginas distribuidas en tres manuscritos representan un conjunto de evaluación reducido, aunque conviene recordar el motivo: anotar cada página exige auténtica formación en paleografía, por lo que no es un conjunto de datos que se pueda ampliar contratando trabajadores en plataformas de crowdsourcing. El detector de caracteres al inicio del pipeline, CRAFT, se mantuvo congelado en todo momento. Solo se aplicó fine-tuning a la red de grafos y al reconocedor, por lo que todo el sistema sigue teniendo como cuello de botella la capacidad de esa primera etapa intacta para localizar caracteres en páginas con iluminación anómala o manchas severas.
Existe además un coste de configuración real. Desarrollar y ajustar un detector de caracteres, una red de grafos y un reconocedor CNN-BiLSTM-CTC supone un esfuerzo técnico bastante mayor que apuntar un script hacia la API de un modelo de visión y lenguaje. Solo compensa cuando se dispone del volumen suficiente para amortizar esa infraestructura inicial. Si se trata de un puñado de páginas que se transcribirán una única vez, probablemente siga siendo más rápido corregirlas a mano o enviarlas al mejor MLLM disponible.
El código y el conjunto de datos son públicos en GitHub en flame-cai/gnn-synthetic-layout-historical, con las anotaciones en PAGE-XML incluidas. Publicar esto es una aportación genuinamente útil. Los datasets de manuscritos históricos digitalizados con este nivel de ground truth para el layout son muy difíciles de encontrar y, sea lo que sea que se construya sobre este pipeline en el futuro, es muy probable que el dataset perdure mucho más allá.