一套传统 OCR 流水线刚刚在梵文识别上击败了 Gemini、GPT 和 Claude
参考论文: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
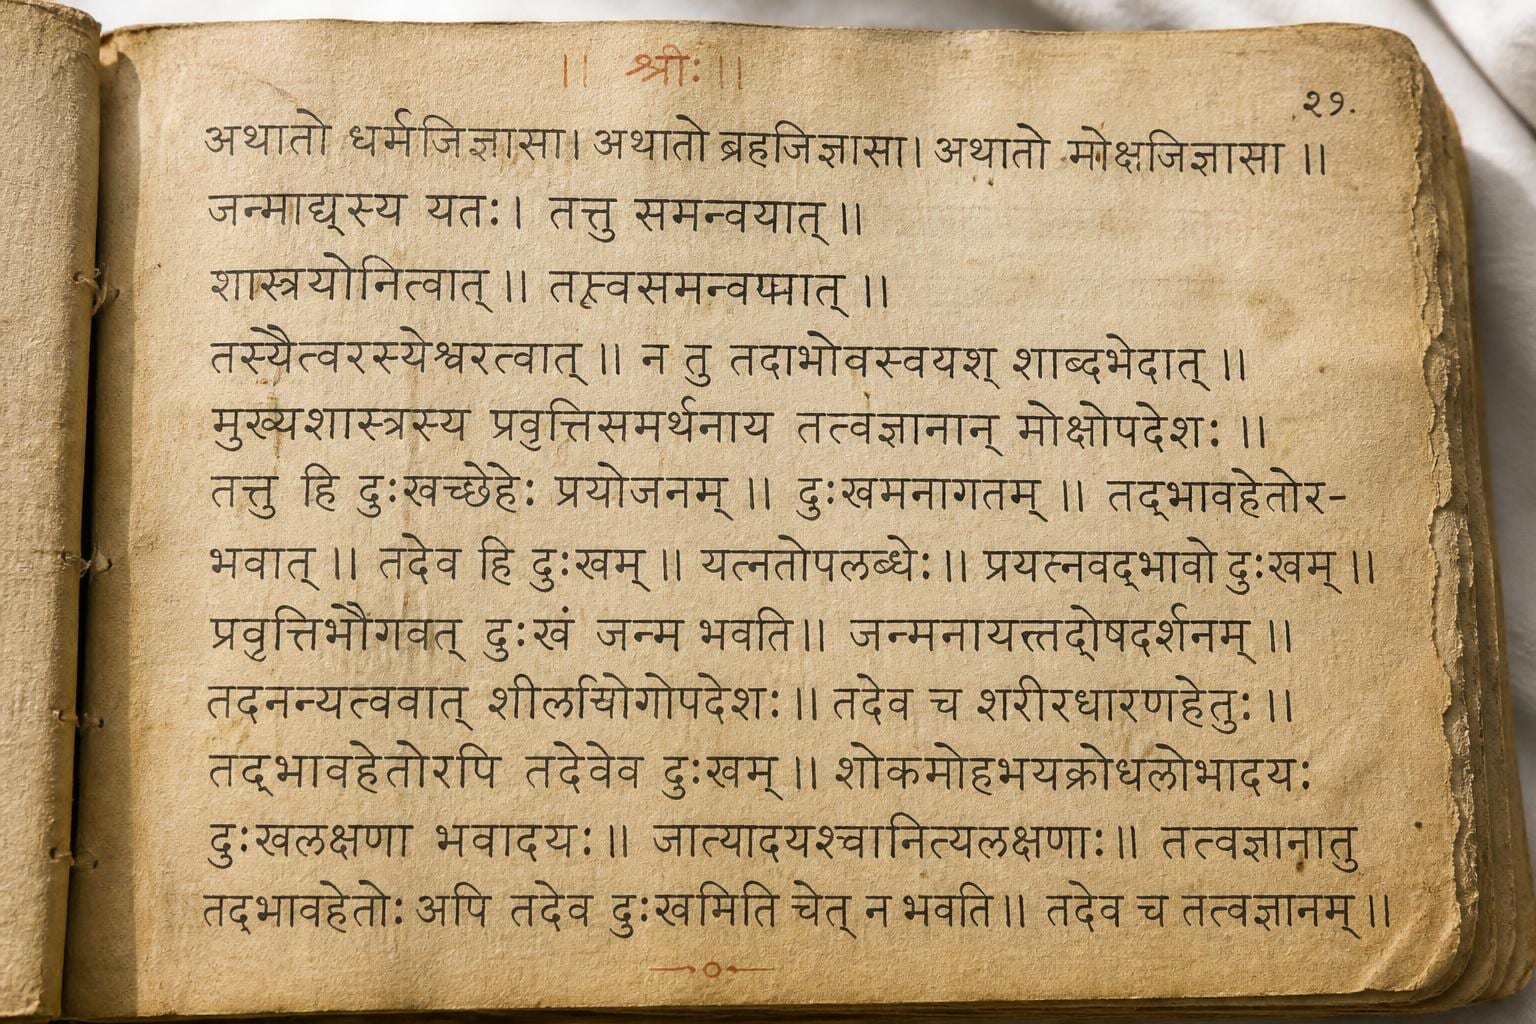
想象一下这样一幅画面:一份拥有 400 年历史的梵文手稿。抄写员将注释密密麻麻地挤在页边,在围绕供奉插图的螺旋走势中写下某些段落,在最密集的地方甚至一页挤下了 44 行文字。哪怕是受过专业文献阅读训练的人,在转录哪怕一个词之前,可能都得花上一整分钟才能厘清哪一笔属于哪一行。然而不可思议的是:一旦有人手动校正了其中恰好三页,一套相当传统的三阶段 OCR 流水线——大多数计算机视觉研究人员眼中的过时产物——在读取这些页面时的表现,竟然击败了 Gemini、GPT 和 Claude。
这就是 Kartik Chincholikar、Kaushik Gopalan 和 Mihir Hasabnis 在新论文《Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts》中得出的结论。对于那些认为解决复杂文档难题的唯一途径就是直接甩出一个更大规模的多模态模型的人来说,这无疑是一记及时的清醒剂。
为什么这些文献会打破常规 OCR 的既定套路
绝大多数 OCR 系统都默认文本在页面上沿着水平方向整齐排列,就像印刷书籍或购物收据那样。然而,历史梵文手稿却在多个维度上彻底打破了这一假设。研究人员根据版面复杂度将三份样本手稿进行了分类:中等复杂度版面(包含边注与行间夹注)、密集版面(平均每页包含 44.43 行文本),以及环形版面(文字并非沿直线排布,而是围绕插图螺旋环绕)。
除几何排版上的难题外,还有视觉外观上的挑战。受时代和地域影响,每位抄写员都有独特的个人笔迹。手稿页面往往带有污渍、撕裂,且由于是在档案馆内现场拍摄而非通过平板扫描仪扫描,光照通常极不均匀。更棘手的是,要对这些数据进行任何校正,都必须依赖真正通晓古代梵文的专业人员——这种专业人才是稀缺且昂贵的。这种稀缺性正是该论文的核心立足点:它旨在最大限度减少领域专家所需承担的校正工作量,而不仅仅是单纯刷高识别准确率。
三个模型拼装组合,而非单个庞大网络
作者构建的流水线包含三个独立阶段,而非单一的端到端网络。
首先,一个冻结参数的预训练字符检测器 CRAFT 会扫描页面并生成热力图,标出单个字符可能所在的位置,类似于通过热成像图显示页面哪些区域含有字母形状的墨迹。其次,一个基于 SplineCNN 架构构建的图神经网络接收这些检测到的字符,并逐对判定两个字符是否属于同一文本行。你可以把它想象成连点成线游戏:每个字符都是一个点,而网络的工作就是厘清哪些点应该串联成一行文本,以及它们的排列顺序如何。第三,一个 CNN-BiLSTM-CTC 网络读取每一条拼装好的文本行,并将其转换为 Unicode 文本。最后这一环节采用了一种名为 CTC(联结主义时间分类,connectionist temporal classification)的训练技术,使模型在无需预先知道每个字符在图像中精确起止位置的情况下即可输出转录文本;当手写字迹无法清晰分割时,这种特性极为实用。
针对环形手稿,该流水线引入了一个几何技巧:它通过建立一个沿着文本曲线延伸的局部坐标系,在将文本交给识别器之前,将其“展平”为平直条带。如果不做这一步,针对水平直行文本训练出的识别模型在面对围绕插图弯曲的文本时将毫无胜算。
两个旋钮,分别微调
论文的核心思想在于:通过两个独立旋转的“旋钮”对这套流水线进行微调。
版面级微调(Layout-level fine-tuning):在人工校正过文本行分组的页面上重新训练图网络。该阶段利用数据增强技术(扭曲、倾斜和随机丢弃节点),将单个校正页面的信息扩展为更丰富的训练信号,随后在专注于难例的损失函数引导下训练 10 个 epoch。外观级微调(Appearance-level fine-tuning):在人工校正过转录文本的页面上重新训练识别器,经过 60 次迭代,使其适应特定抄写员的书写风格以及特定页面的磨损与污损。
正因为这两个旋钮相互独立,校正其中一个并不会强迫你重新训练另一个。你完全可以教会系统“这位抄写员习惯在左侧栏中书写边注”,而无需改动它对该抄写员字符字形的认知;反之亦然。
这一迭代闭环本身十分清晰直接:校正一页,基于该校正对两个模型进行微调,然后将改进后的流水线应用于下一页。由于模型此时已经掌握了该抄写员的排版习惯与笔迹特征,下一页需要人工校正的地方就会大幅减少。重复几次后,校正负担便会迅速下降——这正是该研究的核心意义所在:论文并非为了盲目刷榜,而是为了帮历史学者把耗费在枯燥校正上的大好时光赢回来。
三页样本、三份手稿,真实数据表现
研究团队基于三份梵文手稿构建了评估数据集:中等版面手稿(15 页,平均每页 21.07 行)、密集版面手稿(7 页,平均每页 44.43 行)以及环形版面手稿(9 页,平均每页 28.33 行),共计 31 页。每一页都包含细粒度的版面标注以及完整的 Unicode 转录文本,并以档案机构和图书馆广泛使用的 PAGE-XML 格式进行编码。单是这一点就是一项极具价值的贡献:在非拉丁文字的 OCR 研究领域,原本的标注标准就已经很低,而具备如此精细标注的历史文献数据集不仅少之又少,梵文更是长期处于被严重忽视的境地。
在准确率方面,仅用三页进行微调并以全自动模式运行(即循环中使用模型自身的预测作为伪校正标签,而非人工校正),中等版面手稿的 TextEdit 得分下降了 34.1%,页面级字符错误率(Page-CER)下降了 37.5%。密集版面手稿在这两项指标上均取得了 22.9% 的改善。而在难度最高的环形版面上,TextEdit 改善了 15.5%,Page-CER 改善了 8.1%。
TextEdit 大致对应将模型输出转化为正确转录文本所需的插入、删除或替换字符的比例。Page-CER 衡量的也是同类错误,但它是在整页尺度而非逐行尺度上计算的;这在此类任务中尤为关键,因为一个搞错阅读顺序的模型可能在单行指标上表现尚可,但整页文本却可能已经完全错乱。
如果由人工在闭环中实际校正版面,而非完全依赖自动化运行,收益还会进一步扩大:中等版面手稿的 TextEdit 得分降低了 51.3%,密集版面手稿的 TextEdit 改善了 36.2%,Page-CER 改善了 36.9%。
真正让这一闭环具备实用价值的是成本端。人工校正一页所需的时间,在中等版面上为 38.0 秒,密集版面上为 165.5 秒,环形版面上为 109.0 秒,即便是最复杂的极端情况,也都在 3 分钟以内。而在两页之间微调两个模型的时间开销,图网络需要 41.10 秒,识别器需要 27.51 秒,合计不足 70 秒。这种计算成本远低于它在紧接着的下一页上所节省的人工校正时间,因此该闭环几乎能够立即收回成本,而无需大量前期投入才能见效。
为什么这对于构建或选型 OCR 方案至关重要
这里的启示并不是“赶紧去实现 CRAFT 和 SplineCNN”。它的核心在于:一个针对自身文档以低成本进行快速微调的专用流水线,完全可以胜过从未接触过该文档类型的通用模型,而且只需极少量的微调即可达成。当你的文档具有很强的内部共性时尤为如此——无论是同一位抄写员的手迹、同一个档案馆的翻拍设置、同一家供应商的发票模板,还是同一家法院的卷宗格式。尽管该研究主要针对历史梵文手稿,但对于包含数千个表意字符且排版更密集的汉字识别而言,虽然其庞大字符集对识别网络提出了更高要求,但这种针对特定版式与风格进行小样本闭环微调的工程思路同样极具参考价值。
如果你需要处理大批量视觉风格相近的文档,从经济效益角度来看,花上几个小时校正几页样本并在其上进行微调,要比按页付费将所有文档统统发送给在你的特定版面上“零样本瞎猜”的前沿模型划算得多。反过来,如果你的文档高度异构,不存在任何可供小型模型学习的共有规律,这套算盘就得另打了。在选定技术路线之前,一定要认清自己究竟身处哪种场景,因为选错任何一种方案代价都极其高昂:为一次性处理的零散文档过度搭建复杂的微调闭环纯属浪费工程精力;而面对长期存在的高频业务文档,若缺少针对性的微调闭环,则会在准确率下滑与巨额 API 账单中持续流血。
这些“聪明”的大模型到底卡在哪儿了
该论文还对四款开箱即用的多模态大语言模型进行了基准测试:Gemini 3.5 Flash、GPT-5.6 Terra、Claude Sonnet 5,以及专为印度语系文字打造的 Sarvam Vision。
在中等版面手稿上,Gemini 3.5 Flash 以 0.26 的 TextEdit 和 0.35 的 Page-CER 成为这组模型中表现最好的;Claude Sonnet 5 的得分分别为 0.60 和 0.64;而 GPT-5.6 Terra 则分别为 0.71 和 0.74,这意味着每 10 个字符中大约有 7 个是错的。在密集版面上,Gemini 取得了 0.30 和 0.44 的得分,而 Sarvam Vision 为 0.43 和 0.64。在环形版面上,Gemini 再次以两项指标均为 0.51 领跑,而据作者报告,Sarvam Vision 出现了所谓的“失控生成”(runaway generation):在实际段落早已结束之后它仍在源源不断地生成文本,凭空捏造出页面上根本不存在的手稿内容。
接着戏剧性的一幕出现了:仅在三页上手工校正并微调之后,这套传统流水线在全部三份手稿、全部两项指标上,全面击败了四款多模态模型中表现最好的 Gemini 3.5 Flash。即便是在海量文本和图像上训练出来的通用视觉语言模型,在冷启动阅读训练阶段极少接触的特定历史文字时,依然力不从心。寥寥几个经过校正的样本,就弥合了单纯依赖模型规模无法跨越的鸿沟。
论文尚未解决的问题
涵盖三份手稿共 31 页的评估集规模确实偏小,但必须理解其背后的原因:标注每一页都需要深厚的古文字学功底,这绝不是花钱请众包标注员就能扩充的数据集。此外,流水线最前端的字符检测器 CRAFT 在全程都保持冻结状态,只有图网络和识别器进行了微调,因此整套系统的性能瓶颈,依然受制于未受微调的第一阶段在面对光照异常或严重污损页面时定位字符的准确能力。
同时,构建与部署成本也不容忽视。搭建并微调字符检测器、图神经网络以及 CNN-BiLSTM-CTC 识别器,其工程负担远重于写个脚本调用视觉语言模型的 API。只有当你有足够的业务体量来分摊这些前期搭建成本时,这套方案才算划算。如果只是寥寥数页、只转录一次便不再使用的手稿,直接人工校正或调用所能找到的最佳多模态大模型,可能依然是更省时的选择。
相关代码和数据集已在 GitHub 上开源(仓库地址:flame-cai/gnn-synthetic-layout-historical),并附带完整的 PAGE-XML 标注文件。开源这些资源着实功不可没。具备如此细致版面真实标签(ground truth)的数字化历史手稿数据集实属凤毛麟角;无论未来在此流水线基础上诞生什么样的新方法,这份数据集的生命力大概率都会比模型本身更为长久。