従来型のOCRパイプラインが、サンスクリット語の解読においてGemini、GPT、Claudeを凌駕
元論文: Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts — Kartik Chincholikar, Kaushik Gopalan, Mihir Hasabnis
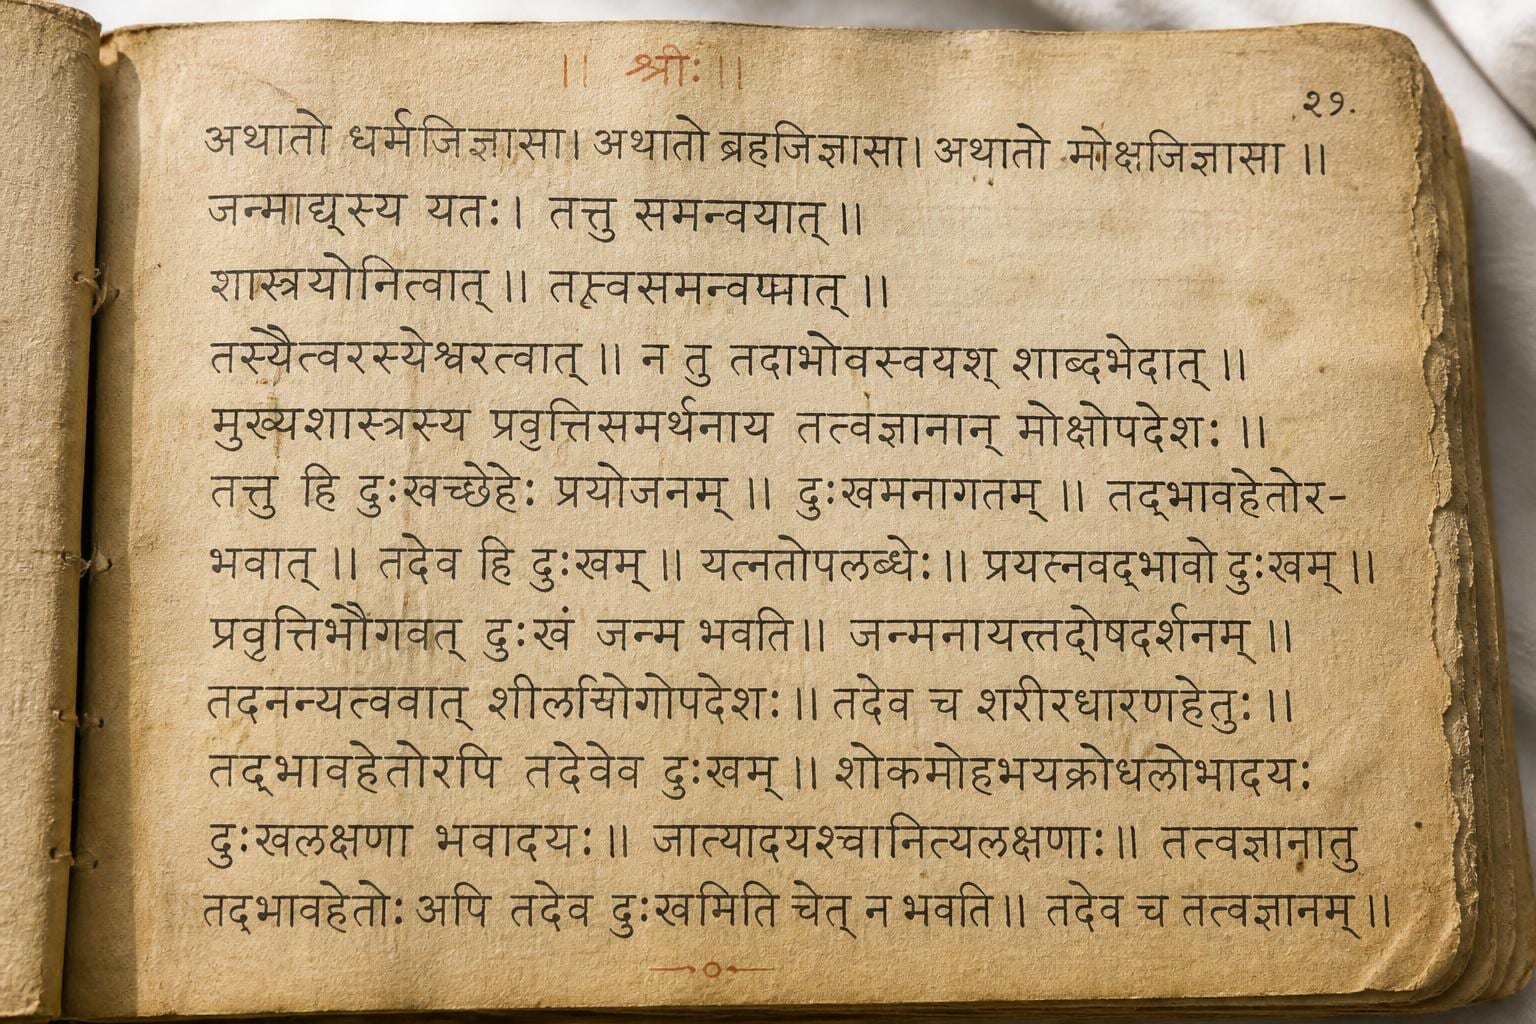
400年前のサンスクリット語の写本を思い浮かべてみてほしい。筆記者は余白に注釈をびっしりと書き込み、ある箇所では祈祷画の周りに渦巻き状に文章を綴り、最も過密な部分では1ページに44行ものテキストを詰め込んでいる。この文字の読み取り訓練を受けた専門家であっても、1文字書き起こす前に、どの筆画がどの行に属しているかを把握するだけで1分丸々費やすかもしれない。だが奇妙なことに、多くのコンピュータビジョン研究者なら「時代遅れ」と呼ぶであろう、ごくオーソドックスな3段階のOCRパイプラインが、人間が正確に3ページだけ手作業で修正しただけで、これら写本の解読においてGemini、GPT、Claudeを打ち負かしてしまうのだ。
これは、Kartik Chincholikar氏、Kaushik Gopalan氏、Mihir Hasabnis氏による新しい論文「Impact of Iterative Fine-Tuning on Transcription Accuracy in Complex Historical Sanskrit Manuscripts」で示された知見だ。難解な文書処理の問題に対する答えは、常により大規模なマルチモーダルモデルを投入することだと考えているすべての人にとって、有益な警鐘(リアリティチェック)となる。
なぜこれらの写本は通常のOCRの定石を打ち破るのか
大半のOCRシステムは、印刷された書籍やレシートのように、テキストがページ上を整然と水平方向に並んでいることを前提としている。歴史的なサンスクリット語写本は、その前提をいくつもの方向から一度に打ち砕く。研究チームは、サンプルとした3種類の写本をレイアウトの難易度別に分類している。すなわち、欄外注や行間注が含まれる「中程度(moderate)のレイアウト」、1ページあたり平均44.43行に達する「過密(dense)なレイアウト」、そしてテキストが直線的に進むのではなく挿絵を囲むように巻いている「円形(circular)のレイアウト」である。
この幾何学的な問題に加え、外観上の問題もある。筆記者ごとに時代や地域に起因する特有の筆跡があり、ページには汚れや破れ、さらにはフラットベッドスキャナではなく公文書館での撮影による不均一な照明のムラが存在する。しかも、これらを修正するには歴史的なサンスクリット語を実際に読める人材が必要となるが、そうしたスキルを持つ専門家は極めて希少であり、雇用コストも高い。その希少性こそが、この論文が前提としている真の制約条件だ。単に生の認識精度を向上させるだけでなく、専門家による修正作業の負担をどれだけ削減できるかが設計の中心にある。
1つの巨大なネットワークではなく、3つのモデルを結合
著者らが構築したパイプラインは、単一のエンドツーエンドのネットワークではなく、3つの独立したステージで構成されている。
第1に、事前学習済みで重みが固定(frozen)されたCRAFTと呼ばれる文字検出器がページを走査し、個々の文字が存在しそうな位置のヒートマップを生成する。これは、ページのどの部分に文字の形をしたインクがあるかを示すサーモグラフィのようなものだ。第2に、SplineCNNと呼ばれるアーキテクチャ上に構築されたグラフニューラルネットワーク(GNN)が、検出された文字を受け取り、2つの文字が同じ行に属するかどうかをペアごとに判定する。これは「点つなぎ」のようなものと考えてほしい。各文字が「点」であり、ネットワークの役割は、どの点と点をどのような順序でつなげば1行のテキストになるかを突き止めることだ。第3に、CNN-BiLSTM-CTCネットワークが組み立てられた各行を読み取り、Unicodeテキストへと変換する。この最後のコンポーネントにはCTC(connectionist temporal classification)と呼ばれる学習手法が用いられており、画像上で各文字がどこから始まりどこで終わるかを事前に正確に把握していなくても書き起こしを出力できる。これは、手書き文字をきれいに切り分けられない場合に非常に有効だ。
円形レイアウトの写本に対しては、パイプラインに幾何学的な工夫が追加されている。テキストの曲線に沿った局所座標系を見つけ出し、文字認識モデルに渡す前にテキストを事実上まっすぐな帯状に「展開(アンロール)」するのだ。このステップがなければ、直線的なテキストで訓練された認識器が、挿絵の周囲を曲がりくねって配置されたテキストに対処できる見込みはない。
独立して調整される2つのダイヤル
本論文の中核となるアイデアは、このパイプラインを独立して回せる2つのダイヤルによってファインチューニングすることだ。
レイアウトレベルのファインチューニングでは、人間が行のグループ分けを修正したページを使ってグラフネットワークを再学習させる。データ拡張(歪み付与、スキュー、ノードのランダムドロップなど)を用いて、修正されたわずか1ページのデータをはるかに大きな訓練シグナルへと拡張し、最も困難なサンプルに焦点を当てるよう調整された損失関数を用いて10エポック学習を行う。一方、外観レベルのファインチューニングでは、人間が実際の書き起こしテキストを修正したページを使って認識器を再学習させ、60イテレーションをかけて特定の筆記者の筆跡やページの摩耗に適応させる。
これら2つのダイヤルが分離されているため、一方を修正しても他方を再学習させる必要がない。筆記者の字体に関する学習内容には一切手を触れずに、「この筆記者は余白の注記を左側のカラムに書く」という知識だけをシステムに教え込むことができ、その逆も可能である。
ループ自体の仕組みは極めてシンプルだ。1ページを修正し、その修正内容に基づいて両モデルをファインチューニングし、改良されたパイプラインを次のページに適用する。この時点でモデルはその筆記者のレイアウトの癖や筆跡の動作モデルを把握しているため、次のページで必要となる修正量は少なくなる。これを数回繰り返すだけで修正の負担は急速に減少する。これこそが真の狙いだ。本論文の目的はリーダーボードのスコアを競うことではなく、歴史家の貴重な午後を取り戻すことにあるのだ。
3ページ、3つの写本、具体的な数値
研究チームは、3種類のサンスクリット語写本から評価セットを構築した。「中程度レイアウト」の写本(15ページ、1ページあたり平均21.07行)、「過密レイアウト」の写本(7ページ、1ページあたり平均44.43行)、「円形レイアウト」の写本(9ページ、1ページあたり平均28.33行)の合計31ページである。各ページには粒度の細かいレイアウトアノテーションと完全なUnicode書き起こしが付与されており、公文書館や図書館などで正解データの記録にすでに使われているPAGE-XML形式でエンコードされている。これだけでも有益な貢献と言える。このレベルで詳細にアノテーションされた歴史的写本のデータセットは極めて希少であり、OCR研究が非ラテン文字に対して設定しがちな低い基準に照らしても、サンスクリット語のリソースは著しく不足していたからだ。
精度面について見ると、わずか3ページでファインチューニングを行い、完全自動(ループ内で人間の修正ではなくモデル自身の予測を擬似修正データとして利用する手法)で実行した場合でも、「中程度レイアウト」の写本ではTextEditスコアが34.1%、ページレベルの文字誤り率(Page-CER)が37.5%低下(改善)した。「過密レイアウト」では両方の指標で22.9%の改善が見られた。最も難易度の高い「円形レイアウト」でも、TextEditで15.5%、Page-CERで8.1%の改善を記録した。
ここでTextEditとは、モデルの出力を正しい書き起こしにするために挿入・削除・置換する必要がある文字の割合をおおむね表す指標だ。一方のPage-CERは、行ごとではなくページ全体を通して同様の誤り率を測定する。これは今回のケースで特に重要となる。なぜなら、読み取り順序を誤ったモデルであっても、行単位の評価指標では良好なスコアを出すことがある一方で、ページ全体としては支離滅裂な結果になってしまうことがあるからだ。
完全自動ではなく、人間がループの一部として実際にレイアウトを修正した場合、その効果はさらに大きくなる。「中程度レイアウト」の写本のTextEditスコアは51.3%減少し、「過密レイアウト」ではTextEditが36.2%、Page-CERが36.9%改善した。
このループを実行する価値を高めているのが、コスト面(所要時間)の低さだ。1ページの手作業による修正時間は、「中程度レイアウト」で38.0秒、「過密レイアウト」で165.5秒、「円形レイアウト」で109.0秒であり、最悪のケースでも3分を余裕で下回っている。ページ間で行われる2つのモデルのファインチューニングにかかる時間も、グラフネットワークで41.10秒、認識器で27.51秒と、合計しても70秒未満だ。この計算コストは、まさにその次のページで削減できる修正時間よりも小さいため、元を取るために多額の初期投資を必要とせず、ほぼ即座に投資回収ができる計算になる。
OCRの構築や選定においてこれが重要な理由
ここでの教訓は、「今すぐCRAFTとSplineCNNを実装せよ」ということではない。少数の自前ドキュメントで安価にファインチューニングできる特化型パイプラインは、その文書タイプを一度も見たことがない汎用モデルを凌駕し得るということ、そしてそこに到達するのに多くの微調整は必要ないということだ。これは、特定の筆記者の筆跡、特定の公文書館の撮影環境、特定ベンダーの請求書テンプレート、特定裁判所の提出書類フォーマットなど、処理対象の文書が強い内部パターンを共有している場合に特に当てはまる。なお、日本の読者にとっては、多くのOCRやVLMにとって最大の難所である縦書きレイアウトや膨大な漢字体系が本研究の検証対象外である点に留意が必要だが、固有の規則性に適応させるという設計思想そのものは大いに参考になるはずだ。
視覚的に類似した大量の文書を処理する場合、特定のレイアウトの事例を一切見ずに推測している最先端モデルに1ページごとのAPI費用を払うよりも、数時間かけてサンプルの数ページを手作業で修正し、それを基にファインチューニングを行う方が経済的に有利となる。逆に、扱う文書が真に雑多で、小規模なモデルが学習できる共通パターンが存在しない場合は、その計算は逆転する。戦略を選択する前に、自らがどちらの状況にあるのかを的確に見極める必要がある。どちらの方向であれ判断を誤れば高くつくからだ。一度きりのバッチ処理のために過剰なファインチューニングループを構築するのはエンジニアリング工数の浪費であり、継続的かつ大量に発生する文書タイプに対して十分な仕組みを構築しなければ、精度低下とAPIコストの流出が永遠に続くことになる。
「スマートな」最新モデルが実際に苦戦した箇所
本論文では、追加調整なしの素の状態(out of the box)の4つのマルチモーダル大規模言語モデル、すなわちGemini 3.5 Flash、GPT-5.6 Terra、Claude Sonnet 5、そしてインド系文字に特化して構築されたモデルであるSarvam Visionもベンチマークしている。
「中程度レイアウト」の写本では、Gemini 3.5 FlashがTextEditで0.26、Page-CERで0.35を記録してこのグループのトップとなり、Claude Sonnet 5は0.60と0.64、GPT-5.6 Terraは0.71と0.74(つまり10文字中およそ7文字が誤り)という結果に終わった。「過密レイアウト」では、Geminiが0.30と0.44を記録したのに対し、Sarvam Visionは0.43と0.64だった。「円形レイアウト」でもGeminiが両指標とも0.51で首位を維持したが、Sarvam Visionは著者らが「暴走生成(runaway generation)」と呼ぶ状態に陥ったと報告されている。実際の文末を大幅に超えてテキストを生成し続け、ページ上に存在しない写本の内容を事実上捏造してしまったのだ。
そして決定的な結論が訪れる。わずか3ページでファインチューニングを行った後、この従来型パイプラインは4つのマルチモーダルモデルの中で最高だったGemini 3.5 Flashを、3つの写本すべて、かつ両方の評価指標において打ち負かしたのである。膨大な量のテキストと画像で学習された汎用ビジョン言語モデルであっても、学習中にほとんど目にしたことがない特定の歴史的文字を初見で読み解くのは依然として苦手なのだ。わずか一握りの修正済みサンプルが、モデルの生のスケールでは埋められなかった溝を埋めたのである。
本論文がまだ解明していないこと
3つの写本にまたがる計31ページというのは小さな評価セットだが、その理由を考慮しておく価値はある。各ページのアノテーションには本格的な古文字学の専門知識が必要であり、クラウドワーカーにお金を払って集められるようなデータセットではないからだ。また、パイプラインの先頭にある文字検出器CRAFTは一貫して重みが固定されたままであった。ファインチューニングされたのはグラフネットワークと認識器のみであるため、システム全体としては、手つかずの第1ステージが異常な照明やひどい汚れのあるページ上でどれだけ正確に文字を検出できるかという点に依然としてボトルネックを抱えている。
さらに、相応の導入コストも存在する。文字検出器、グラフネットワーク、そしてCNN-BiLSTM-CTC認識器を構築してファインチューニングすることは、ビジョン言語モデルのAPIにスクリプトを投げるよりもはるかに骨の折れる作業だ。このセットアップコストを償却できるだけの十分な処理量があって初めて採算が合う。一度きりの書き起こしで二度と使わない数ページの文書であれば、手作業で修正するか、利用可能な最高のMLLMに送る方がおそらく今でも手っ取り早い。
コードとデータセットは、PAGE-XMLアノテーションを含めてGitHub上のflame-cai/gnn-synthetic-layout-historicalで公開されている。これらが公開されたこと自体、純粋に有益な成果だ。このレベルのレイアウト正解データを持つデジタル化された歴史的写本のデータセットは極めて入手困難であり、このパイプラインの上に今後どのような技術が構築されようとも、このデータセットはそれ以上に長く活用され続ける可能性が高い。