El persa tiene 110 millones de hablantes y casi ningún dato de OCR. Este artículo falsifica 343.000 páginas para solucionarlo
Basado en: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
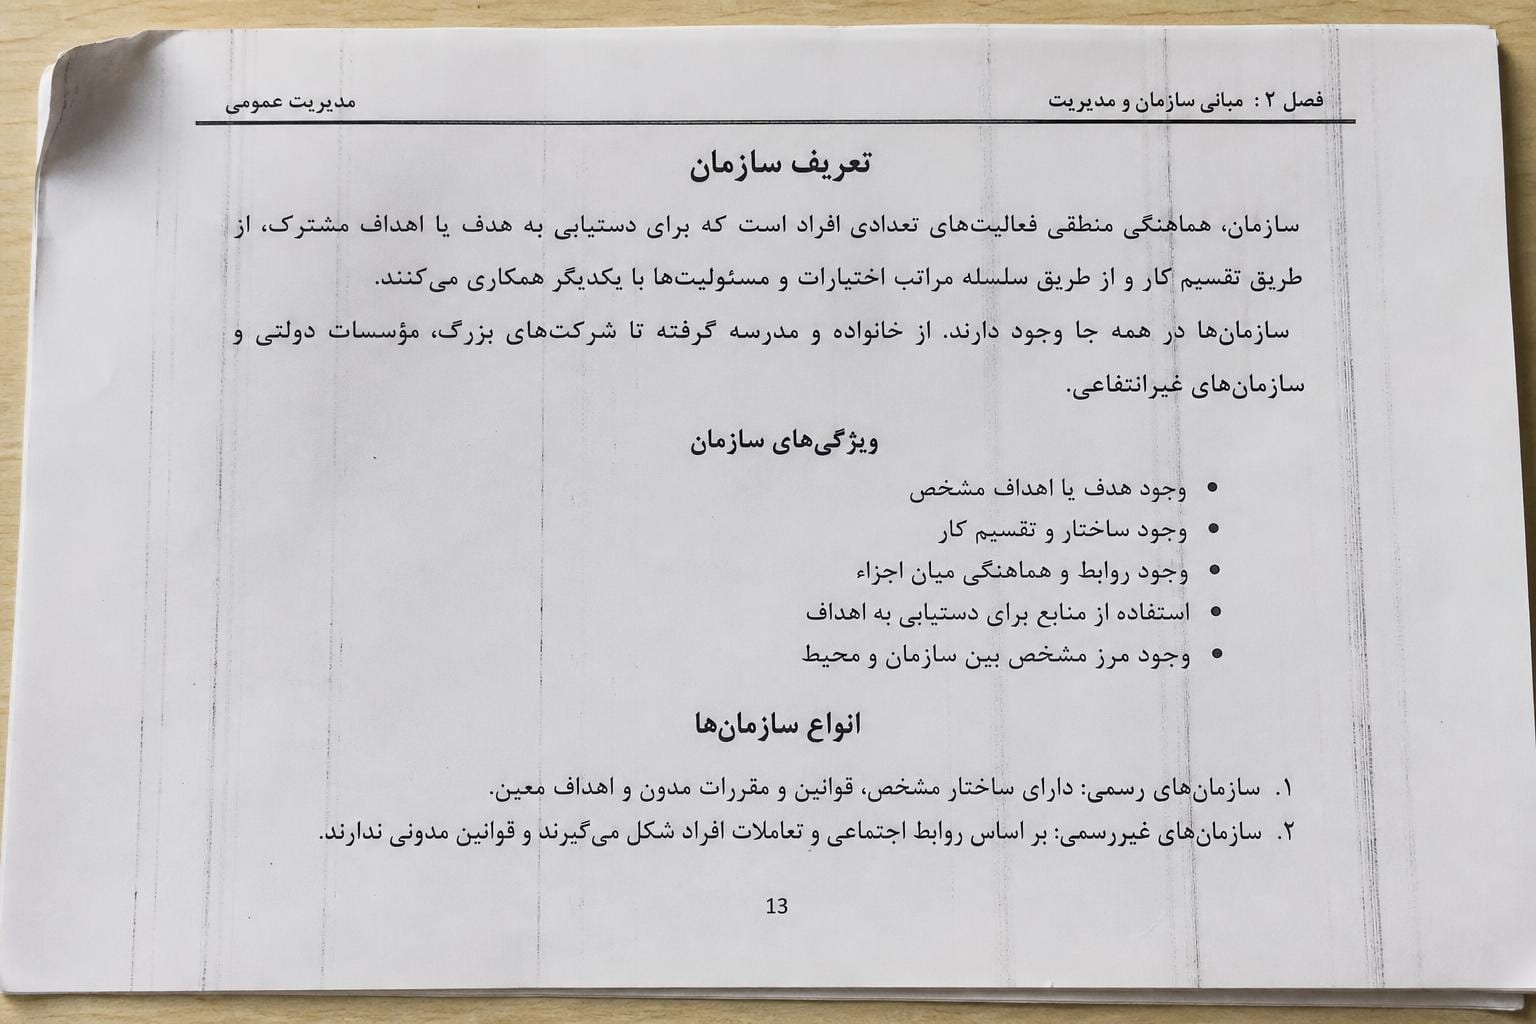
Prueba esto: toma la letra persa ب (el equivalente a la "b") e imagínala apareciendo de cuatro formas diferentes dependiendo de si inicia una palabra, está en el medio, termina una palabra o aparece aislada. Ahora haz eso con la mayor parte del alfabeto. Ahora añade marcas diacríticas opcionales que cambian la pronunciación pero no son obligatorias en la escritura normal, por lo que un modelo tiene que adivinar si su ausencia significa "no es necesario" o "el escáner lo omitió". Ahora renderiza todo esto en Nastaliq, un estilo caligráfico donde las letras se curvan diagonalmente y se apilan unas sobre otras, y buena suerte intentando dibujar una caja delimitadora limpia alrededor de cualquier cosa.
Esa es la OCR persa en un párrafo, y es por eso que un idioma hablado por más de 110 millones de personas sigue rezagándose significativamente frente a los idiomas de script latino en calidad de reconocimiento de texto. Un nuevo artículo, "Persian Pixel", no propone una nueva arquitectura de modelo para solucionar esto. Hace algo más aburrido y, argumentaría, más útil: fabrica 343.000 imágenes falsas de documentos para que las arquitecturas existentes tengan algo decente de lo cual aprender.
El problema nunca fueron los modelos, fue el dato
Los sistemas modernos de OCR, los basados en transformadores como TrOCR y Donut que menciona el artículo, son voraces. Necesitan enormes volúmenes de datos emparejados: una imagen de texto por un lado, y la transcripción correcta por el otro. El inglés tiene esto en abundancia, raspado de décadas de libros escaneados, formularios y sitios web, y luego corregido a mano por ejércitos de anotadores. El persa no.
Parte de esa brecha es simplemente económica. Anotar datos de OCR significa que alguien (o alguna canalización) debe mirar una imagen y teclear exactamente lo que dice, carácter por carácter, incluyendo dónde cayeron los diacríticos. Eso es lento, es caro, y no escala de la manera que lo hace un corpus de inglés raspado. Pero parte de la brecha es la propia escritura. El persa, como el árabe y el urdu, se escribe en cursiva por regla, no por elección de estilo, y cada letra se remodela sutilmente según lo que tenga al lado. Un conjunto de datos construido a partir de un puñado de fuentes modernas y limpias no preparará a un modelo para los ligamentos y variantes de glifos que encontrará en la naturaleza, y mucho menos para las dos tradiciones de escritura dominantes, Naskh (más erguido, similar a la impresión) y Nastaliq (la forma caligráfica fluida común en la literatura y la señalización persa), que parecen escrituras casi no relacionadas si eres un modelo que solo ha visto una de ellas.
Así que terminas atascado: los datos anotados reales son demasiado costosos de producir a escala, y los conjuntos de datos pequeños no cubren suficiente variación de la escritura para entrenar un modelo robusto. La respuesta de Persian Pixel es dejar de esperar datos reales y generar datos sintéticos en su lugar, y luego trabajar duro para que los datos sintéticos se comporten como datos reales una vez que un modelo los ve.
Cómo construyeron 343.000 documentos falsos que (en su mayoría) se comportan como reales
El flujo de trabajo comienza con un corpus de texto en persa de siete millones de palabras, curado en lugar de extraído masivamente, que se convierte en la materia prima para todo lo que sigue. Un marco de renderizado que los autores llaman SynthOCR-Gen convierte luego ese texto en imágenes, y es aquí donde ocurre realmente la ingeniería específica del guion. El sistema debe manejar correctamente la unión contextual de caracteres (qué forma de una letra dibujar según sus vecinos), colocar correctamente las variantes posicionales de glifos, gestionar la colocación de diacríticos y hacer todo esto a través de múltiples tipografías persas representativas que abarcan tanto los estilos Naskh como Nastaliq.
La salida no son solo fragmentos a nivel de palabra. El conjunto de datos abarca tres escalas de diseño: oraciones, párrafos y documentos de página completa. Ese rango importa más de lo que parece. Un modelo entrenado solo con palabras aisladas no tiene idea de cómo manejar los saltos de línea, la justificación de párrafos o el ruido de diseño de una página escaneada real, donde el texto no se encuentra en una sola línea ordenada esperando ser leído.
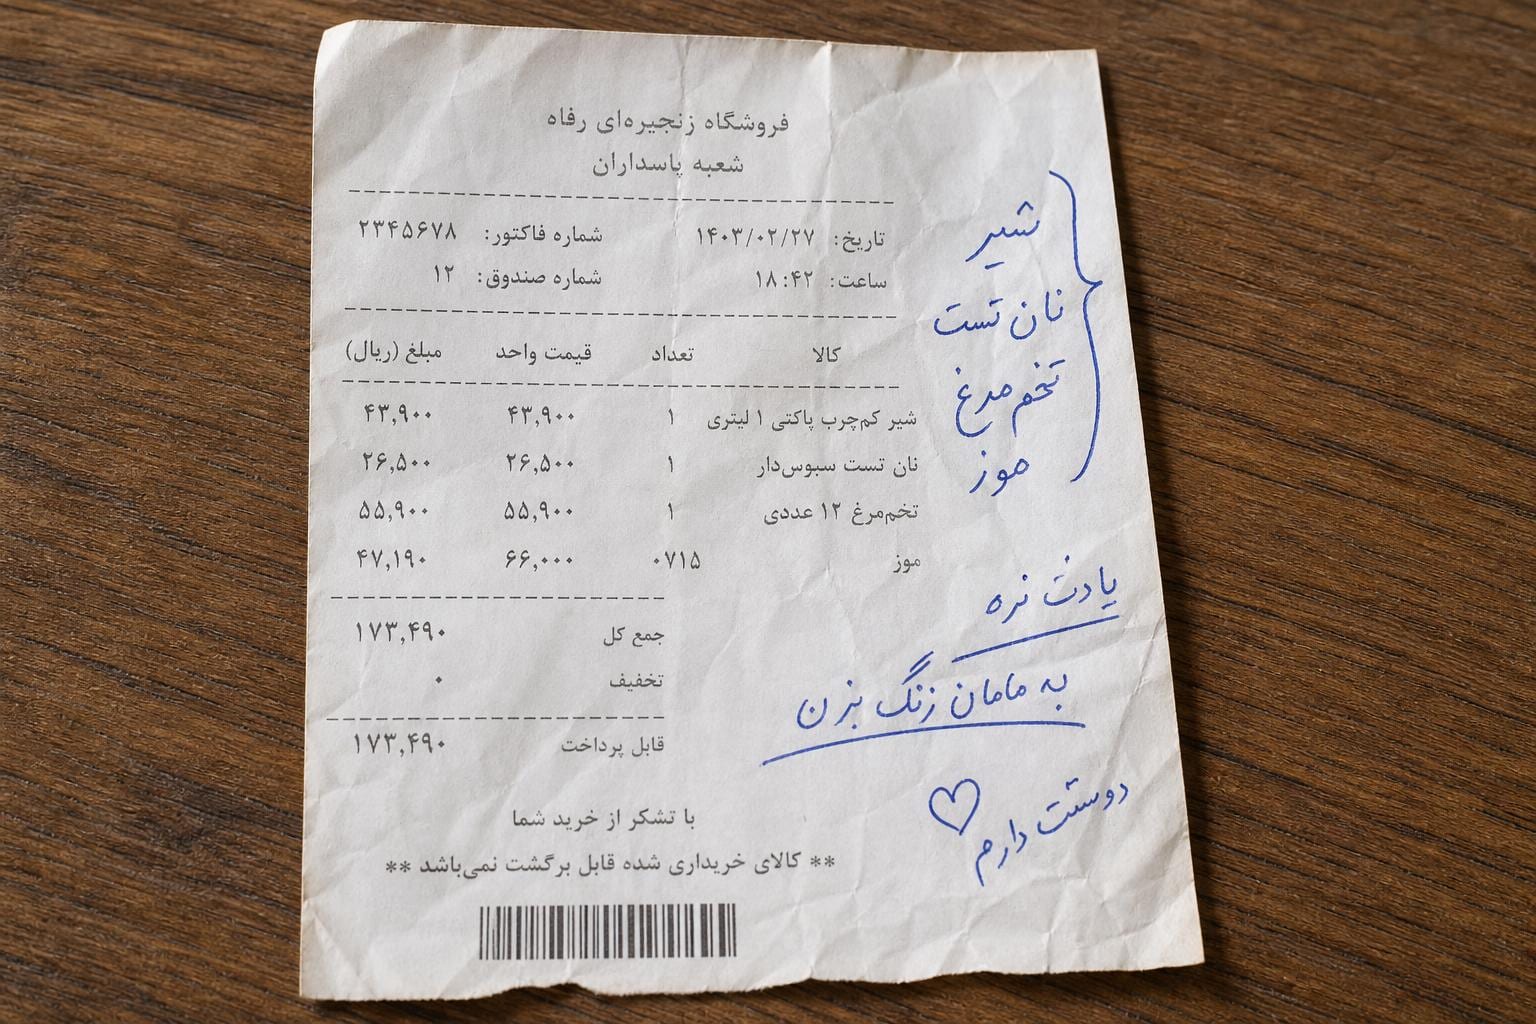
Renderizar texto limpio es la parte fácil. El problema más difícil, y el que realmente determina si algo de esto es útil, es la brecha de dominio entre lo sintético y lo real: un modelo entrenado con texto renderizado por computadora impecable tiende a desmoronarse en el momento en que se enfrenta a un documento escaneado o fotografiado real, porque los documentos reales están llenos de imperfecciones físicas que un renderizador no produce por defecto. Persian Pixel ataca esto con más de veinticinco modelos de degradación estocástica superpuestos a las imágenes renderizadas: sangrado de tinta, envejecimiento del papel, desenfoque, iluminación desigual, artefactos del escáner, ruido de compresión y varios otros procesos de ruido, aplicados probabilísticamente para que ninguna dos imágenes se degraden de manera idéntica. Es el equivalente en OCR a entrenar un sistema de conducción autónoma en un simulador, y luego aleatorizar el clima simulado, la iluminación y la suciedad de la carretera hasta que el modelo deje de poder distinguir la simulación de la realidad.
Qué hay realmente en la caja
Si quitamos la descripción de la tubería de procesamiento, el conjunto de datos en sí es fácil de describir: más de 343.000 pares de imagen-texto, generados a partir de un corpus de siete millones de palabras, distribuido en diseños a nivel de oración, párrafo y página, renderizado en múltiples tipografías persas que cubren ambos estilos principales de escritura, y degradado con más de 25 modelos de artefactos para simular condiciones de captura del mundo real. Está diseñado para ser un recurso de entrenamiento o ajuste fino para arquitecturas de OCR basadas en transformadores como TrOCR y Donut específicamente, en lugar de un punto de referencia de propósito general.
Lo que el resumen del artículo no incluye es la parte que más quería ver: números reales sobre cómo se desempeña un modelo entrenado con Persian Pixel frente a documentos persas reales, no sintéticos. No hay tasa de error de caracteres, no hay tasa de error de palabras, no hay comparación con los puntos de referencia de OCR en persa que ya existen. Eso no es una crítica a la utilidad del conjunto de datos tanto como una señal sobre cómo leer la afirmación. "Construimos un conjunto de datos sintético grande y cuidadosamente diseñado" y "demostramos que este conjunto de datos cierra la brecha de precisión en el mundo real" son dos afirmaciones diferentes, y solo la primera está completamente respaldada por lo que se describe aquí.
Por qué importa para quien construye o elige OCR
Si estás eligiendo un motor de OCR y el persa aparece en tu mezcla de documentos, recibos, formularios gubernamentales, manuscritos históricos, lo que sea, la conclusión práctica no es "usa Persian Pixel directamente". Es que el campo ahora cuenta con un recurso de entrenamiento creíble y diseñado específicamente para un sistema de escritura que estaba muy desatendido, y cualquier proveedor o modelo abierto que afirme tener un soporte decente para el persa en el próximo año o dos probablemente se haya entrenado con datos como estos, ya que los datos persas anotados manualmente a esta escala básicamente no existen en otro lugar.
La lección más amplia se generaliza más allá del persa. Una gran parte de los sistemas de escritura del mundo, árabe, urdu, tailandés, amhárico y docenas más, enfrentan exactamente el mismo cuello de botella: scripts complejos, datos anotados escasos y una calidad de OCR que se queda atrás respecto a los scripts latinos como consecuencia. Persian Pixel es un ejemplo funcional de la solución aplicada a gran escala: en lugar de esperar a que la anotación manual se ponga al día, modela las reglas de renderizado del script con suficiente precisión para que los datos sintéticos puedan suplir, y luego dedica esfuerzo de ingeniería real para cerrar la brecha entre "parece texto" y "parece un documento que ha pasado por un escáner, una década y una fotocopiadora defectuosa".
Si estás evaluando las afirmaciones de un proveedor de OCR sobre el persa (o el árabe, o el tailandés), la pregunta honesta que debes hacer es si su precisión reportada proviene de un benchmark como este sintético, o de documentos reales extraídos del tipo de flujo de trabajo que realmente ejecutarás. Los modelos entrenados con datos sintéticos pueden ser genuinamente fuertes, pero "entrenado en 343.000 páginas sintéticas" y "evaluado en 343.000 páginas sintéticas" es una afirmación mucho más débil que "evaluado en facturas reales que nadie diseñó el renderizador para anticipar". Pide el número del mundo real, no solo el tamaño del conjunto de datos.
Qué falta aún
Hay algunas lagunas que vale la pena nombrar con claridad. Primero, y lo más obvio: no hay resultados de evaluación en los materiales disponibles para este artículo. No conocemos las tasas de error reales que alcanza un modelo TrOCR o Donut después de ajustar finamente sobre Persian Pixel, ni en datos sintéticos retenidos ni, más importante aún, en documentos persas escaneados reales. Ese es el número que te diría si este conjunto de datos realmente mueve la aguja o simplemente parece impresionante en el papel.
En segundo lugar, la degradación sintética, por sofisticada que sea, sigue siendo una simulación del desgaste del mundo real, no la cosa en sí. Veinticinco modelos de degradación estocástica representan mucho esfuerzo de ingeniería y probablemente son suficientes para reducir significativamente la brecha de dominio, pero "reducir" no es "cerrar". Los manuscritos históricos en particular, uno de los casos de uso que el artículo nombra explícitamente, implican patrones de degradación (siglos de desvanecimiento de tinta, daños físicos, tipografías históricas no estándar y escritura a mano) que un pipeline de renderizado moderno calibrado sobre fuentes Naskh y Nastaliq contemporáneas probablemente no captura por completo.
En tercer lugar, la escritura a mano no se menciona en absoluto. Todo lo descrito aquí es texto renderizado y compuesto. El reconocimiento de escritura a mano en persa, que probablemente es un problema aún más difícil dada la línea base cursiva del alfabeto que se vuelve más extrema en forma manuscrita, no está abordado por este conjunto de datos.
Nada de eso borra la contribución. La digitalización de documentos persas ha estado estancada detrás de una barrera de datos durante mucho tiempo, y un conjunto de datos sintético cuidadosamente diseñado que modela las reglas tipográficas reales del alfabeto, en lugar de tratar el persa como "texto latino pero de derecha a izquierda", es un paso real. Simplemente trata el número destacado, 343.000 pares imagen-texto, como una medida de escala y esfuerzo de ingeniería, no como un sustituto de qué tan bien leerán los modelos resultantes tus documentos reales. Esa segunda pregunta aún necesita una respuesta, y es la que vale la pena hacer antes de construir sobre esto.