फारसी की 11 करोड़ बोलने वाले हैं और लगभग कोई OCR डेटा नहीं। यह पेपर इसे ठीक करने के लिए 343,000 पृष्ठों को फेक करता है
आधारित शोध-पत्र: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
इसे आज़माएं: फ़ारसी अक्षर ب ("b" के समकक्ष) को लें और इसे कल्पना करें कि यह शब्द की शुरुआत में, बीच में, अंत में या अकेले होने के आधार पर चार अलग-अलग तरीकों से प्रकट होता है। अब वर्णमाला के अधिकांश अक्षरों के लिए ऐसा ही करें। अब वैकल्पिक ध्वनि चिह्नों (diacritic marks) को जोड़ें जो उच्चारण को बदलते हैं लेकिन सामान्य लेखन में आवश्यक नहीं होते हैं, इसलिए एक मॉडल को अनुमान लगाना होता है कि उनकी अनुपस्थिति का अर्थ "आवश्यक नहीं" है या "स्कैनर ने उन्हें छूट दिया"। अब पूरी चीज़ को Nastaliq में प्रस्तुत करें, एक कलात्मक शैली जहाँ अक्षर तिरछे ढंग से बहते हैं और एक-दूसरे के ऊपर जमा हो जाते हैं, और किसी भी चीज़ के चारों ओर साफ़ बाउंडिंग बॉक्स खींचने की कोशिश करें।
यह एक पैराग्राफ़ में फ़ारसी OCR है, और इसी कारण से 110 मिलियन से अधिक लोगों द्वारा बोली जाने वाली इस लिपि का टेक्स्ट रिकग्निशन गुणवत्ता में लैटिन-लिपि भाषाओं से बहुत पीछे है। एक नया पेपर, "Persian Pixel," इस समस्या को ठीक करने के लिए नई मॉडल आर्किटेक्चर का प्रस्ताव नहीं करता है। यह कुछ अधिक बोरिंग और, मेरी राय में, अधिक उपयोगी करता है: यह मौजूदा आर्किटेक्चर्स के लिए सीखने के लिए कुछ उचित उपलब्ध कराने के लिए 343,000 नकली दस्तावेज़ छवियाँ बनाता है।
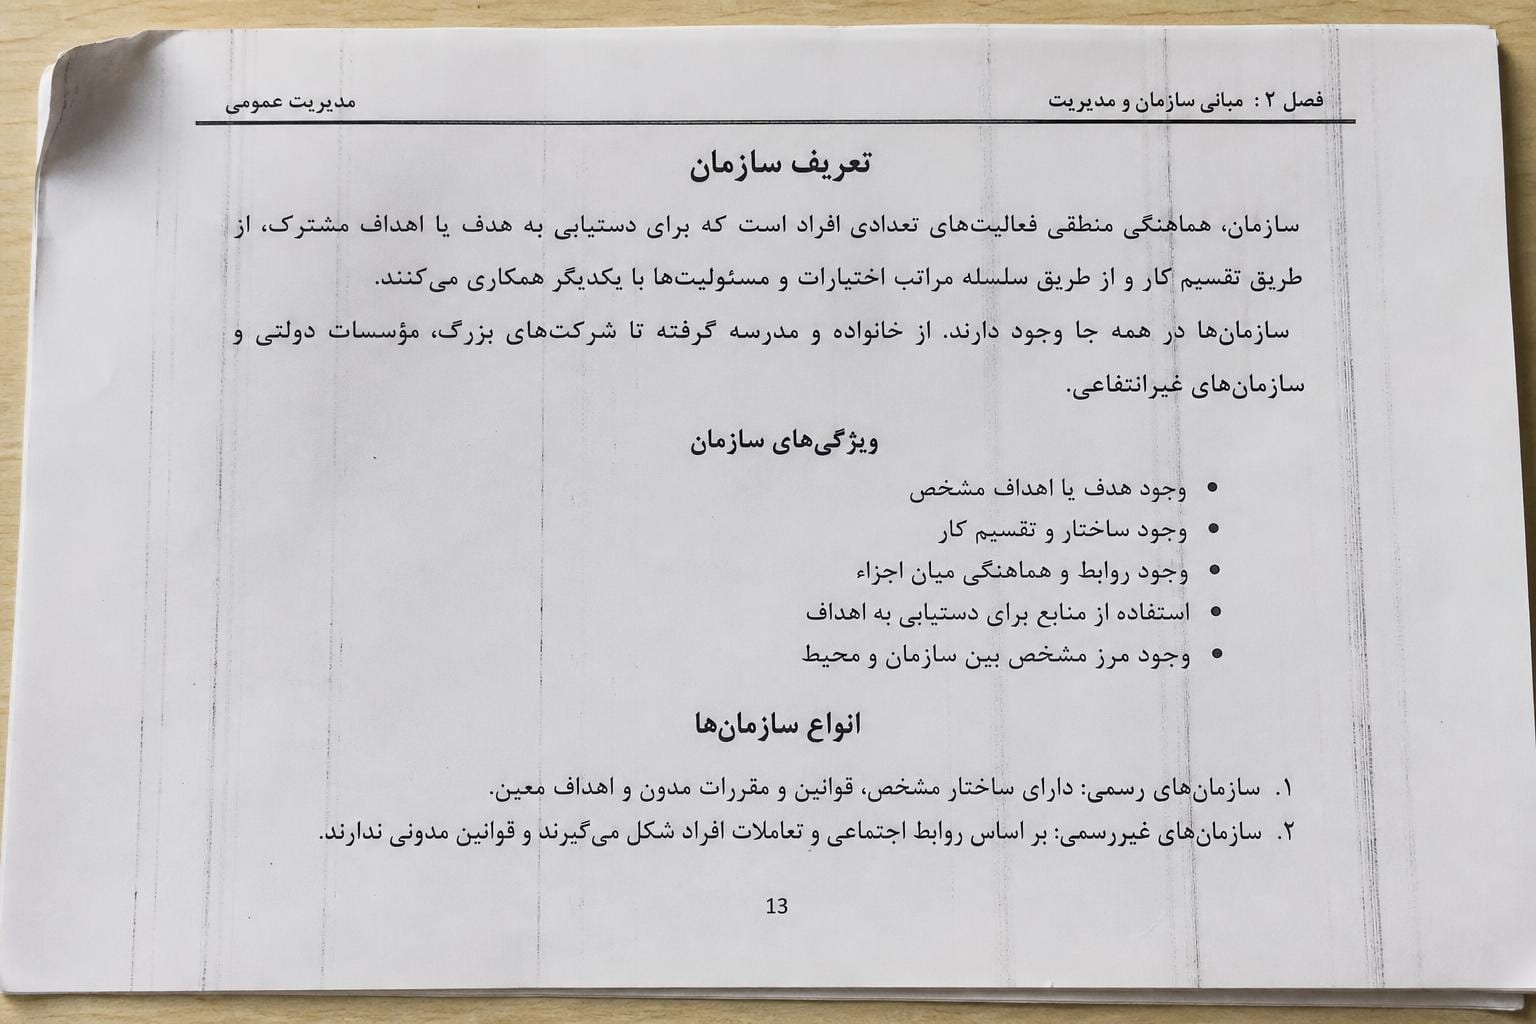
समस्या कभी मॉडल्स की नहीं थी, समस्या डेटा की थी
आधुनिक OCR सिस्टम, जैसे कि पेपर में जिनका जिक्र किया गया है, TrOCR और Donut जैसे ट्रांसफॉर्मर-आधारित मॉडल, भूखे हैं। इन्हें युग्मित डेटा (paired data) की विशाल मात्रा की आवश्यकता होती है: एक तरफ टेक्स्ट की छवि, और दूसरी तरफ उसकी सही ट्रांसक्रिप्शन। अंग्रेजी में इसकी प्रचुरता है, जो दशकों पुरानी स्कैन की गई किताबों, फॉर्मों और वेबसाइटों से स्क्रैप की गई है, और फिर एनोटेटर्स की सेनाओं द्वारा हाथ से सही की गई है। फारसी में ऐसा नहीं है।
इस खाई का एक हिस्सा सिर्फ आर्थिक है। OCR डेटा का एनोटेशन करना इसका मतलब है कि किसी को (या किसी पाइपलाइन को) छवि को देखना होगा और अक्षर-दर-अक्षर, यहाँ तक कि डायक्रिटिक्स (diacritics) कहाँ लैंड हुए हैं, यह भी शामिल करके, बिल्कुल वही टाइप करना होगा जो उसमें लिखा है। यह धीमा है, महंगा है, और यह उसी तरह स्केल नहीं करता जैसे एक स्क्रैप की गई अंग्रेजी कॉर्पस करता है। लेकिन इस खाई का एक हिस्सा स्क्रिप्ट स्वयं है। फारसी, अरबी और उर्दू की तरह, नियम के कारण, शैली के विकल्प के कारण नहीं, cursively लिखी जाती है, और हर अक्षर अपने आस-पास के अक्षरों के आधार पर सूक्ष्म रूप से अपना आकार बदल लेता है। कुछ साफ़, आधुनिक फॉन्ट्स से बने डेटासेट मॉडल को वास्तविक दुनिया में मिलने वाले लिगेशर्स (ligatures) और ग्लिफ वेरिएंट्स के लिए तैयार नहीं करेंगे, बल्कि दो प्रमुख लेखन परंपराओं, नस्ख (जो अधिक सीधा, प्रिंट जैसा है) और नस्तालीक (जो फारसी साहित्य और साइनबोर्ड में आम बहती हुई कलात्मक रूप है) के लिए भी नहीं, जो एक ऐसे मॉडल के लिए लगभग असंबंधित स्क्रिप्ट्स लगती हैं यदि उसने केवल उनमें से एक को देखा हो।
तो आप अंत में फंस जाते हैं: वास्तविक एनोटेटेड डेटा स्केल पर बनाने के लिए बहुत महंगा है, और छोटे डेटासेट स्क्रिप्ट की पर्याप्त विविधता को कवर नहीं करते ताकि एक मजबूत मॉडल को ट्रेन किया जा सके। Persian Pixel का उत्तर है कि वास्तविक डेटा के लिए इंतज़ार करना बंद करें और इसके बजाय सिंथेटिक डेटा जेनरेट करें, और फिर कड़ी मेहनत करें ताकि सिंथेटिक डेटा वास्तविक डेटा की तरह व्यवहार करे जब मॉडल उसे देखता है।
उन्होंने कैसे 343,000 नकली दस्तावेज़ बनाए जो (ज़्यादातर) असली जैसा व्यवहार करते हैं
पाइपलाइन की शुरुआत एक सात मिलियन शब्दों वाले फ़ारसी पाठ कॉर्पस से होती है, जिसे बड़े पैमाने पर स्क्रैप करने के बजाय सावधानी से चुना गया है, और यह नीचे की सभी प्रक्रियाओं के लिए कच्चा माल बन जाता है। लेखकों द्वारा SynthOCR-Gen नामित एक रेंडरिंग फ्रेमवर्क फिर उस पाठ को छवियों में बदल देता है, और यहीं पर स्क्रिप्ट-विशिष्ट इंजीनियरिंग वास्तव में होती है। सिस्टम को संदर्भिक वर्ण जुड़ने (contextual character joining) को सही करना होता है (अर्थात अपने पड़ोसियों के आधार पर अक्षर का कौन सा रूप बनाना है), स्थानात्मक ग्लिफ़ वेरिएंट्स को सही जगह रखना होता है, दीक्रिटिक (diacritic) की स्थिति का प्रबंधन करना होता है, और यह सब Naskh और Nastaliq दोनों शैलियों में फैले कई प्रतिनिधि फ़ारसी टाइपफ़ेस के साथ करना होता है।
आउटपुट केवल शब्द-स्तरीय स्निपेट्स नहीं हैं। डेटासेट तीन लेआउट स्केल में फैला हुआ है: वाक्य, पैराग्राफ़, और पूर्ण-पृष्ठ दस्तावेज़। यह रेंज जितनी लगती है, उससे ज़्यादा महत्वपूर्ण है। केवल अलग-थलग शब्दों पर प्रशिक्षित मॉडल की लाइन ब्रेक्स, पैराग्राफ़ जस्टिफ़िकेशन, या असली स्कैन किए गए पृष्ठ के लेआउट शोर को संभालने की कोई समझ नहीं होती, जहाँ पाठ पढ़ने के लिए साफ़ एक ही लाइन में नहीं होता।
साफ़ पाठ को रेंडर करना आधा आसान हिस्सा है। कठिन समस्या, और वह जो वास्तव में यह तय करती है कि इसका कोई उपयोग है या नहीं, सिंथेटिक-टू-रियल डोमेन गैप है: एक मॉडल जो निर्मल कंप्यूटर-रेंडर्ड पाठ पर प्रशिक्षित होता है, वह तुरंत टूट जाता है जब वह किसी असली स्कैन या फ़ोटोग्राफ़ किए गए दस्तावेज़ से मिलता है, क्योंकि असली दस्तावेज़ भौतिक दोषों से भरे होते हैं जो रेंडरर डिफ़ॉल्ट रूप से पैदा नहीं करता। Persian Pixel इस पर हमला करता है रेंडर्ड छवियों पर 25 से ज़्यादा स्टोकास्टिक डिग्रेडेशन मॉडल्स को लेयर करके: कलर ब्लीड, कागज़ का पुराना होना, ब्लर, असमान प्रकाश, स्कैनर आर्टिफ़ैक्ट्स, कंप्रेशन नॉइज़, और कई अन्य नॉइज़ प्रक्रियाएं, जो प्रायिकता के आधार पर लागू की जाती हैं ताकि कोई भी दो छवियाँ एक जैसी खराब न हों। यह OCR का वह संस्करण है जैसे एक सेल्फ़-ड्राइविंग सिस्टम को सिम्युलेटर में प्रशिक्षित करना, और फिर सिम्युलेटेड मौसम, रोशनी, और सड़क की गंदगी को रैंडमाइज़ करना जब तक कि मॉडल सिम्युलेशन और वास्तविकता के बीच अंतर नहीं कर पाता।
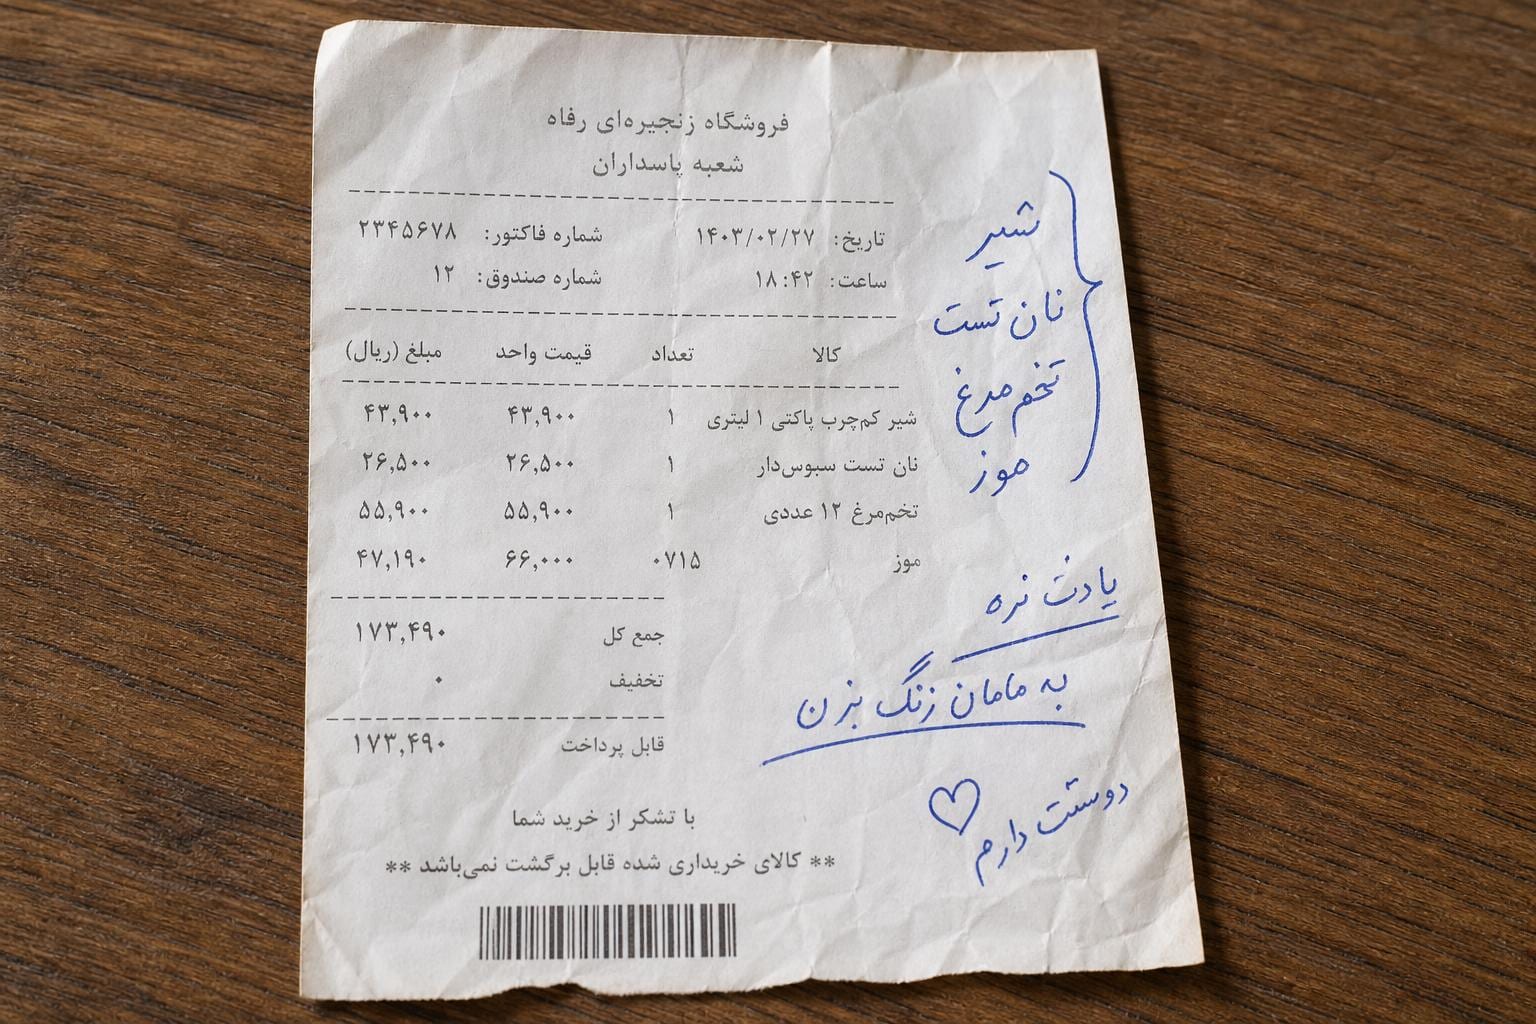
बॉक्स में वास्तव में क्या है
पाइपलाइन विवरण को हटा दें और डेटासेट स्वयं का वर्णन करना सरल है: 343,000 से अधिक इमेज-टेक्स्ट जोड़े, जो सात मिलियन शब्दों के कॉर्पस से उत्पन्न किए गए हैं, वाक्य, पैराग्राफ और पेज-स्तरीय लेआउट में विभाजित, दोनों प्रमुख लिपि शैलियों को कवर करने वाले कई फारसी टाइपफेस में रेंडर किए गए, और वास्तविक दुनिया की कैप्चर स्थितियों को सिमुलेट करने के लिए 25 से अधिक आर्टिफैक्ट मॉडल्स के साथ डिग्रेड किए गए। इसे विशेष रूप से TrOCR और Donut जैसे ट्रांसफॉर्मर OCR आर्किटेक्चर्स के लिए एक ट्रेनिंग या फाइन-ट्यूनिंग संसाधन के रूप में बनाया गया है, न कि एक जनरल-पर्पोज़ बेचमार्क के रूप में।
जो चीज़ पेपर के अमरीट में शामिल नहीं है, वह वह हिस्सा है जिसे मैं सबसे अधिक देखना चाहता था: वास्तविक, गैर-सिंथेटिक फारसी दस्तावेजों के खिलाफ Persian Pixel पर ट्रेन किए गए मॉडल के बारे में वास्तविक संख्याएँ। कोई कैरेक्टर एरर रेट नहीं, कोई वर्ड एरर रेट नहीं, और न ही मौजूदा फारसी OCR बेसलाइन्स से कोई तुलना। यह डेटासेट की उपयोगिता पर इतना ही नहीं है, बल्कि यह दावे को कैसे पढ़ना है, इसके लिए एक झंडा है। "हमने एक बड़ा, सावधानी से इंजीनियर किया गया सिंथेटिक डेटासेट बनाया" और "हमने साबित किया कि यह डेटासेट वास्तविक दुनिया की सटीकता के अंतर को कम करता है" दो अलग-अलग दावे हैं, और यहाँ वर्णित चीज़ों द्वारा केवल पहला दावा पूरी तरह से समर्थित है।
OCR बनाने या चुनने वाले किसी के लिए इसका महत्व क्यों है
अगर आप कोई OCR इंजन चुन रहे हैं और आपके दस्तावेज़ मिक्स में फारसी (Persian) कहीं भी है—चाहे वह रसीदें हों, सरकारी फॉर्म हों, या ऐतिहासिक हस्तलिखित पांडुलिपियाँ—तो व्यावहारिक निष्कर्ष "सीधे Persian Pixel का उपयोग करें" नहीं है। बल्कि यह है कि इस क्षेत्र में अब एक विश्वसनीय, उद्देश्य-निर्मित प्रशिक्षण संसाधन उपलब्ध है जो एक ऐसे लिपि के लिए है जिसकी बहुत कम सेवा की जाती थी, और अगले एक या दो वर्षों में कोई भी विक्रेता या ओपन मॉडल जो फारसी सपोर्ट का दावा करता है, संभवतः ऐसे डेटा पर प्रशिक्षित होगा, क्योंकि इस पैमाने पर हाथ से एनोटेट किया गया फारसी डेटा कहीं और मौजूद ही नहीं है।
इससे भी बड़ा सबक फारसी से आगे तक सामान्यीकृत होता है। दुनिया की लिपि प्रणालियों का एक बड़ा हिस्सा, अरबी, उर्दू, थाई, अमहारिक और दर्जनों अन्य, बिल्कुल उसी बाधा का सामना कर रहे हैं: जटिल लिपियाँ, पतले एनोटेटेड डेटा, और परिणामस्वरूप लैटिन लिपियों की तुलना में OCR गुणवत्ता में पिछड़ापन। Persian Pixel उस समाधान का एक कामकाजी उदाहरण है जिसे बड़े पैमाने पर लागू किया जा रहा है: मैन्युअल एनोटेशन के पकड़ने का इंतज़ार करने के बजाय, लिपि के रेंडरिंग नियमों को इतनी सटीकता से मॉडल करें कि सिंथेटिक डेटा उसकी जगह ले सके, फिर वास्तविक इंजीनियरिंग प्रयास उस खाई को बंद करने में लगाएं जो "टेक्स्ट जैसा दिखने" और "ऐसे दस्तावेज़ जैसा दिखने" के बीच है जो स्कैनर, एक दशक और एक खराब फोटोकॉपियर से गुज़रा हो। हालाँकि मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा, क्योंकि देवनागरी की जटिल संयुक्त वर्ण और शिरोरेखा संरचनाएं अलग चुनौतियां पैदा करती हैं।
अगर आप किसी OCR प्रदाता के फारसी (या अरबी, या थाई) दावों का मूल्यांकन कर रहे हैं, तो ईमानदार सवाल यह पूछना है कि उनका रिपोर्ट किया गया सटीकता इस सिंथेटिक बेंचमार्क से आई है या वास्तविक दस्तावेज़ों से जो आप वास्तव में चलाएंगे। सिंथेटिक-प्रशिक्षित मॉडल वास्तव में मजबूत हो सकते हैं, लेकिन "343,000 सिंथेटिक पेजों पर प्रशिक्षित" और "343,000 सिंथेटिक पेजों पर परीक्षण" का दावा "वास्तविक इनवॉइस पर परीक्षण जिनका अनुमान रेंडरर ने नहीं लगाया था" की तुलना में बहुत कमजोर है। डेटासेट के आकार के बजाय वास्तविक दुनिया की संख्या मांगें।
अभी भी क्या कमी है
कुछ खाली जगहों को स्पष्ट रूप से नाम देना उचित है। पहला और सबसे स्पष्ट: इस लेख के लिए उपलब्ध सामग्री में कोई भी बेंचमार्क परिणाम नहीं है। हमें नहीं पता कि फारसी पिक्सल पर फाइन-ट्यूनिंग के बाद TrOCR या Donut मॉडल वास्तव में कितनी त्रुटि दर (error rates) हासिल करते हैं, चाहे वह होल्ड-आउट सिंथेटिक डेटा पर हो या, और भी महत्वपूर्ण रूप से, वास्तविक स्कैन की गई फारसी दस्तावेज़ों पर। वही संख्या आपको बताएगी कि क्या यह डेटासेट वास्तव में स्थिति को बदलता है या केवल कागज पर प्रभावशाली लगता है।
दूसरा, सिंथेटिक डिग्रेडेशन, चाहे कितना भी परिष्कृत हो, वास्तविक दुनिया के क्षरण का एक सिमुलेशन है, स्वयं वह क्षरण नहीं। पच्चीस स्टोकास्टिक डिग्रेडेशन मॉडल्स इंजीनियरिंग की बहुत मेहनत है, और संभवतः डोमेन गैप को सार्थक रूप से कम करने के लिए पर्याप्त है, लेकिन "कम करना" "निकट होना" नहीं है। विशेष रूप से ऐतिहासिक हस्तलिखित ग्रंथ, जिन्हें पेपर स्पष्ट रूप से उपयोग के मामलों के रूप में नाम देता है, में डिग्रेडेशन पैटर्न शामिल हैं (सदियों पुरानी स्याही का फीका पड़ना, भौतिक क्षति, गैर-मानक ऐतिहासिक टाइपफेस और हाथ से लिखा हुआ अक्षर) जो आधुनिक रेंडरिंग पाइपलाइन द्वारा संभवतः पूरी तरह से कैप्चर नहीं किए जा सकते हैं, जो कि समकालीन नस्ख और नस्तालीक फॉन्ट्स पर कैलिब्रेट की गई है।
तीसरा, हाथ से लिखे अक्षरों का जिक्र बिल्कुल नहीं है। यहाँ वर्णित सब कुछ रेंडर किया गया, टाइपसेट टेक्स्ट है। फारसी हाथ से लिखे अक्षरों की पहचान, जो कि स्क्रिप्ट की कर्सिव बेसलाइन को ध्यान में रखते हुए एक और कठिन समस्या मानी जा सकती है क्योंकि हाथ से लिखे रूप में यह और अधिक तीव्र हो जाती है, इस डेटासेट द्वारा संबोधित नहीं की गई है।
इनमें से कोई भी योगदान को मिटाता नहीं है। फारसी दस्तावेज़ों का डिजिटाइज़ेशन लंबे समय से डेटा की दीवार के पीछे अटका हुआ है, और एक सावधानीपूर्वक इंजीनियर किया गया सिंथेटिक डेटासेट जो स्क्रिप्ट के वास्तविक टाइपोग्राफिक नियमों का मॉडल बनाता है, बजाय इसके कि फारसी को "दाएं से बाएं लैटिन टेक्स्ट" के रूप में माना जाए, यह एक वास्तविक कदम है। बस हेडलाइन संख्या, 343,000 इमेज-टेक्स्ट जोड़े, को पैमाने और इंजीनियरिंग प्रयास के मापदंड के रूप में लें, न कि इस बात के प्रतिनिधि के रूप में कि परिणामी मॉडल आपके वास्तविक दस्तावेज़ों को कितनी अच्छी तरह पढ़ेंगे। उस दूसरे सवाल का अभी भी उत्तर देने की आवश्यकता है, और यह वह सवाल है जिसे इस पर आधारित निर्माण शुरू करने से पहले पूछना चाहिए।