波斯语有1.1亿使用者,但几乎没有OCR数据。本文伪造了34.3万页数据来解决这一问题
参考论文: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
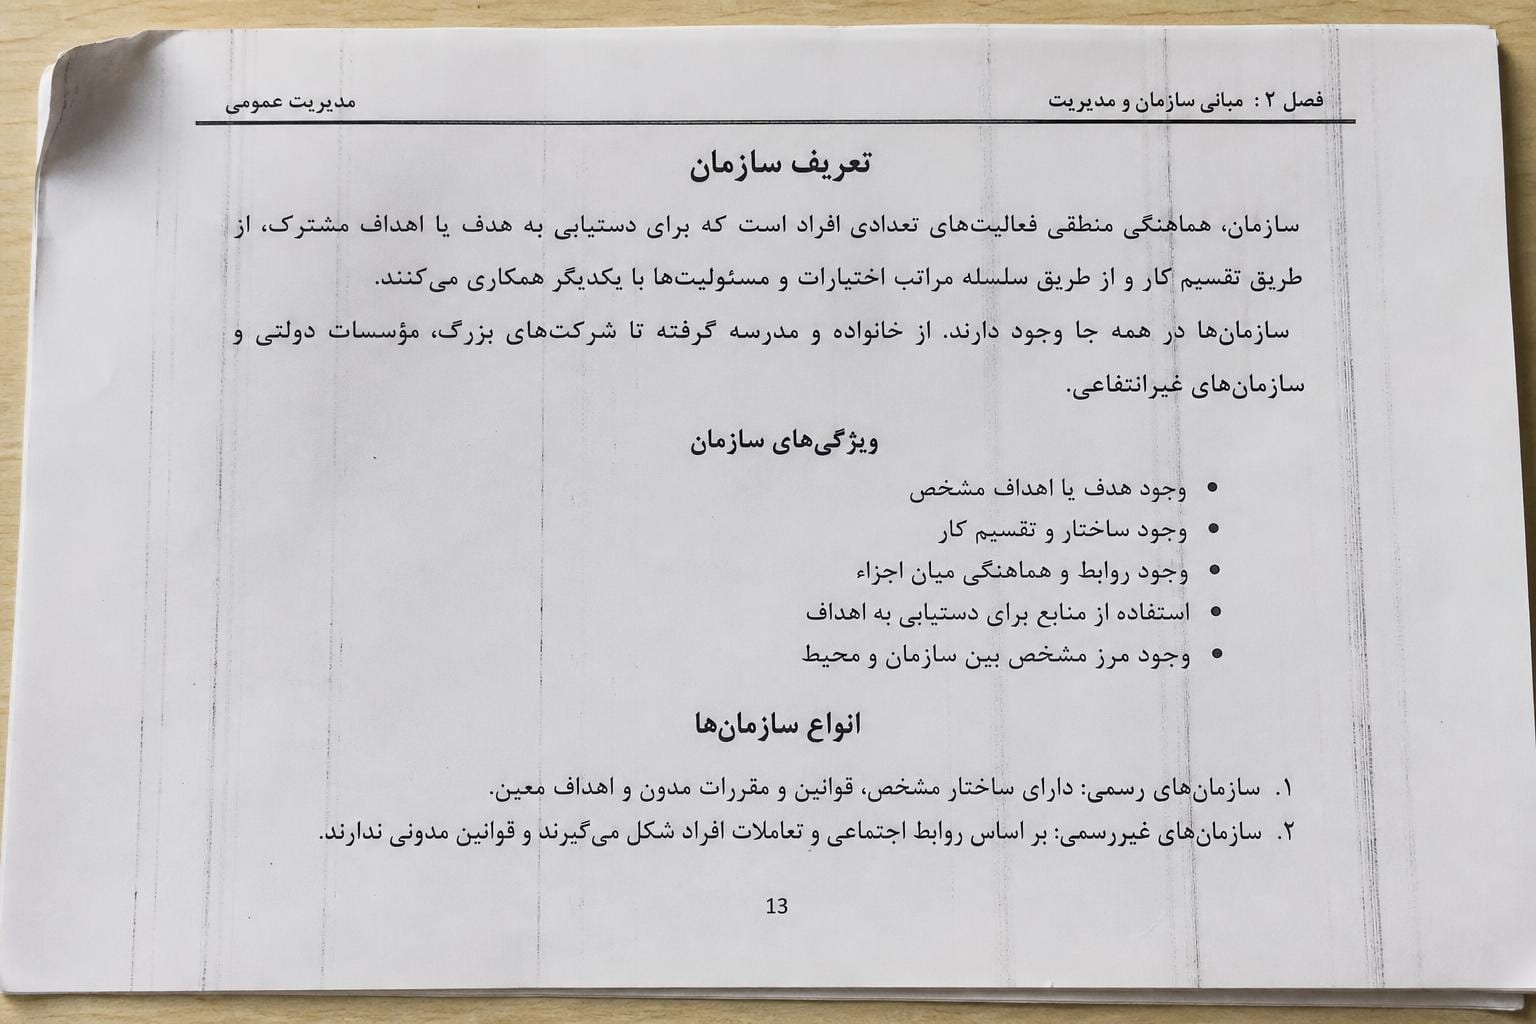
试试这个:拿波斯字母 ب(相当于“b”)来想象,根据它在词首、词中、词尾或独立出现,它会呈现四种不同的形态。现在对字母表中的大多数字母都这样做。再加上可选的变音符号,它们会改变发音,但在日常书写中并非必需,因此模型必须猜测其缺失是因为“不需要”还是“扫描仪漏掉了”。最后,将所有内容以纳斯塔利克体(Nastaliq)渲染,这是一种书法风格,字母呈对角线弯曲并相互堆叠,祝你好运能画出干净的边界框。
这就是波斯语 OCR 的缩影,也是为什么一种有超过 1.1 亿使用者使用的文字,在文本识别质量上仍远远落后于拉丁字母语言。一篇新论文《Persian Pixel》并没有提出新的模型架构来解决这个问题。它做了一件更枯燥、但在我看来更有用的事:制造了 343,000 张伪造的文档图像,让现有的架构有像样的数据可供学习。
问题从来不在模型,而在数据
现代 OCR 系统,尤其是论文中提到的基于 Transformer 的 TrOCR 和 Donut,对数据的需求极大。它们需要海量的配对数据:一侧是文本图像,另一侧是准确的转录文本。英语拥有充足的数据资源,这些数据来自数十年来扫描的书籍、表格和网站,并由庞大的标注团队进行人工校对。而波斯语则不然。
这种差距部分源于经济因素。标注 OCR 数据意味着有人(或某个流程)必须查看图像,并逐字输入其中的内容,包括变音符号的位置。这一过程缓慢、昂贵,且无法像抓取英语语料库那样实现规模化。但差距的另一部分源于书写系统本身。波斯语与阿拉伯语和乌尔都语一样,按规则以连笔书写,而非出于风格选择,每个字母都会根据相邻字符微妙地改变形状。仅由少量清晰现代字体构建的数据集,无法让模型适应真实场景中遇到的连字和字形变体,更不用说两种主要的书写传统——纳斯赫体(Naskh,较为直立,类似印刷体)和纳斯塔利克体(Nastaliq,流畅的书法形式,常见于波斯文学和标牌)——如果模型只见过其中一种,这两种字体看起来几乎像是完全不同的书写系统。
因此,你最终陷入困境:真实标注数据的大规模生产成本过高,而小规模数据集又无法覆盖足够的书写变体,难以训练出稳健的模型。Persian Pixel 的解决方案是停止等待真实数据,转而生成合成数据,并努力使合成数据在模型看到时表现得如同真实数据一般。
他们如何构建 34.3 万份(大多)表现得像真实文件的伪造文档
该流程始于一个经过精心策划而非大规模爬取的七百万词波斯语文本语料库,这成为了下游所有任务的原始素材。作者称之为 SynthOCR-Gen 的渲染框架随后将这些文本转换为图像,而针对特定脚本的工程化工作正是在此环节展开。系统必须正确处理上下文字符连接(根据相邻字符决定字母的形态)、准确放置位置字形变体、处理变音符号的布局,并在涵盖 Naskh 和 Nastaliq 两种风格的多种代表性波斯字体中完成所有这些操作。
输出结果不仅仅是单词级别的片段。该数据集涵盖了三种布局尺度:句子、段落和整页文档。这种范围的重要性远超表面所见。仅在孤立单词上训练的模型完全不知道如何处理换行、段落对齐或真实扫描页面中的布局噪声,因为在真实场景中,文本并不会整齐地排列在单行中等待阅读。
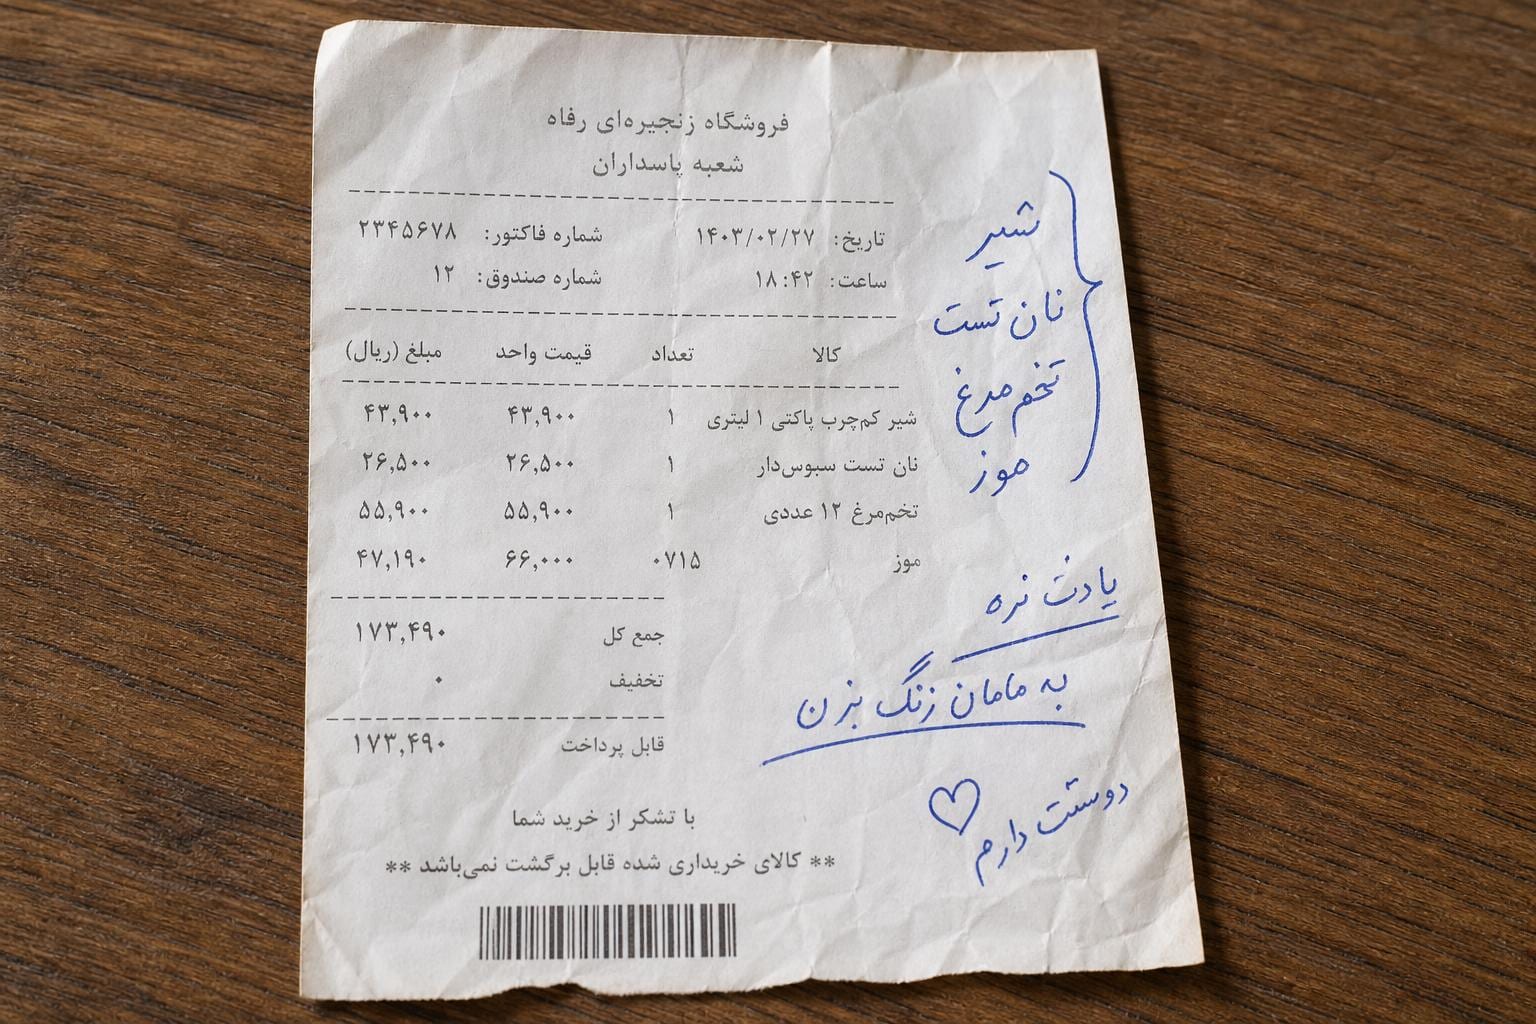
渲染清晰文本只是容易的一半。更困难的问题,也是决定这一切是否有用的关键,在于合成到真实的域差距:在完美计算机渲染文本上训练的模型,一旦遇到实际的扫描或拍摄文档,往往会迅速失效,因为真实文档充满了渲染器默认不会生成的物理瑕疵。Persian Pixel 通过将二十多种随机退化模型叠加到渲染图像上来应对这一问题:墨水晕染、纸张老化、模糊、光照不均、扫描伪影、压缩噪声以及其他几种噪声过程,这些过程以概率方式应用,确保没有两张图像的退化完全相同。这相当于在模拟器中训练自动驾驶系统,然后随机化模拟的天气、光照和路面污垢,直到模型无法区分模拟与现实为止。
盒子里到底有什么
抛开流水线描述不谈,数据集本身其实很容易描述:超过 343,000 个图像-文本对,源自一个七百万词的语料库,分布在句子、段落和页面级别的布局中,使用多种波斯语字体渲染,涵盖两种主要书写风格,并通过 25 多种伪影模型进行退化处理,以模拟现实世界的捕获条件。它专为 TrOCR 和 Donut 等 Transformer OCR 架构的训练或微调而设计,而非通用基准。
论文摘要中没有包含我最想看到的部分:在波斯像素(Persian Pixel)上训练的模型在真实、非合成波斯语文档上的实际表现数据。没有字符错误率,没有词错误率,也没有与现有任何波斯语 OCR 基线的对比。这并非否定数据集的实用性,而是提醒我们如何解读其主张。“我们构建了一个大型、精心设计的合成数据集”与“我们证明该数据集缩小了现实世界的准确率差距”是两个不同的主张,而此处描述的内容仅充分支持前者。
为什么这对任何构建或选择 OCR 的人都很重要
如果您正在挑选 OCR 引擎,且文档混合中包含波斯语(无论是收据、政府表格还是历史手稿),实际的启示并非“直接使用 Persian Pixel”。而是该领域现在拥有了一个针对此前严重缺乏支持的书写系统的可信、专用训练资源。鉴于如此规模的手动标注波斯语数据在其他地方几乎不存在,任何在未来一两年内声称具备良好波斯语支持的供应商或开源模型,很可能都使用了类似的数据进行训练。
这一更广泛的教训超越了波斯语本身。世界上大量的书写系统——如阿拉伯语、乌尔都语、泰语、阿姆哈拉语以及数十种其他语言——都面临着完全相同的瓶颈:复杂的脚本、稀薄的标注数据,以及因此导致的落后于拉丁字母的 OCR 质量。Persian Pixel 是大规模应用解决方案的一个工作示例:与其等待手动标注赶上,不如精确建模脚本的渲染规则,使合成数据能够替代,然后将真正的工程精力投入到缩小“看起来像文本”与“看起来像经过扫描仪、十年岁月和劣质复印机处理的文档”之间的差距上。对于汉字等拥有数千个字符且布局密集的汉字符号体系而言,这种基于合成数据解决长尾字符和复杂版面问题的思路同样具有关键的借鉴意义。
如果您正在评估 OCR 供应商对波斯语(或阿拉伯语、泰语)的主张,诚实的问题应该是:他们报告的准确率是来自像这样的合成基准测试,还是来自您实际运行流程中拉取的现实文档。合成训练模型可以真正强大,但“在 343,000 个合成页面上训练”和“在 343,000 个合成页面上测试”的主张,远弱于“在无人能预见到渲染器构建方式的真实发票上测试”。要求提供现实世界的数字,而不仅仅是数据集的大小。
还有哪些不足
有几个缺口值得直言不讳地指出。首先,也是最明显的一点:在本文可用的材料中,没有任何基准测试结果。我们不知道 TrOCR 或 Donut 模型在 Persian Pixel 上进行微调后,在保留的合成数据上,或者更重要的是,在真实的波斯语扫描文档上,实际达到的错误率是多少。这个数字才能告诉你,这个数据集是真正推动了进展,还是仅仅在纸面上看起来令人印象深刻。
其次,合成退化无论多么复杂,仍然只是对现实世界磨损的模拟,而非磨损本身。25 个随机退化模型代表了大量的工程努力,可能足以显著缩小领域差距,但“缩小”并不等于“接近”。特别是历史手稿——这是论文明确指出的一个用例——涉及到的退化模式(几个世纪的墨水褪色、物理损坏、非标准的历史字体和手写体)可能无法被基于当代 Naskh 和 Nastaliq 字体校准的现代渲染管道完全捕捉。
第三,手写体完全没有被提及。这里描述的一切都是渲染的、排版的文本。波斯语手写识别,鉴于该脚本的连笔基线在手写形式中变得更加极端,可能是一个更难的问题,而这个数据集并没有解决这个问题。
这些都不否定其贡献。波斯文档数字化长期以来一直受限于数据壁垒,而一个精心设计的合成数据集,它建模了该脚本的实际排版规则,而不是将波斯语视为“从右到左的拉丁文本”,确实是一个真正的进步。只是要把标题中的数字——343,000 个图像-文本对——视为规模和工程努力的衡量标准,而不是作为结果模型读取你实际文档效果的代理指标。第二个问题仍然需要答案,这也是你在基于此构建之前值得问的问题。