O persa tem 110 milhões de falantes e quase nenhum dado de OCR. Este artigo falsifica 343.000 páginas para corrigir isso
Baseado em: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
Persian Pixel: Synthetic Data for Persian OCR
Experimente o seguinte: pegue a letra persa ب (o equivalente ao "b") e imagine-a aparecendo de quatro maneiras diferentes, dependendo se ela inicia uma palavra, fica no meio, termina uma palavra ou está isolada. Agora, faça isso para a maior parte do alfabeto. Agora, adicione marcas diacríticas opcionais que alteram a pronúncia, mas não são obrigatórias na escrita normal, de modo que um modelo precise adivinhar se a ausência delas significa "não necessárias" ou "o scanner as perdeu". Agora, renderize tudo em Nastaliq, um estilo caligráfico em que as letras se curvam diagonalmente e se sobrepõem, e boa sorte ao tentar desenhar uma caixa delimitadora limpa ao redor de qualquer coisa.
Essa é a OCR persa em um parágrafo, e é por isso que um idioma falado por mais de 110 milhões de pessoas ainda fica muito atrás dos idiomas de script latino em qualidade de reconhecimento de texto. Um novo artigo, "Persian Pixel", não propõe uma nova arquitetura de modelo para corrigir isso. Ele faz algo mais chato e, argumentaria eu, mais útil: fabrica 343.000 imagens falsas de documentos para que as arquiteturas existentes tenham algo decente para aprender.
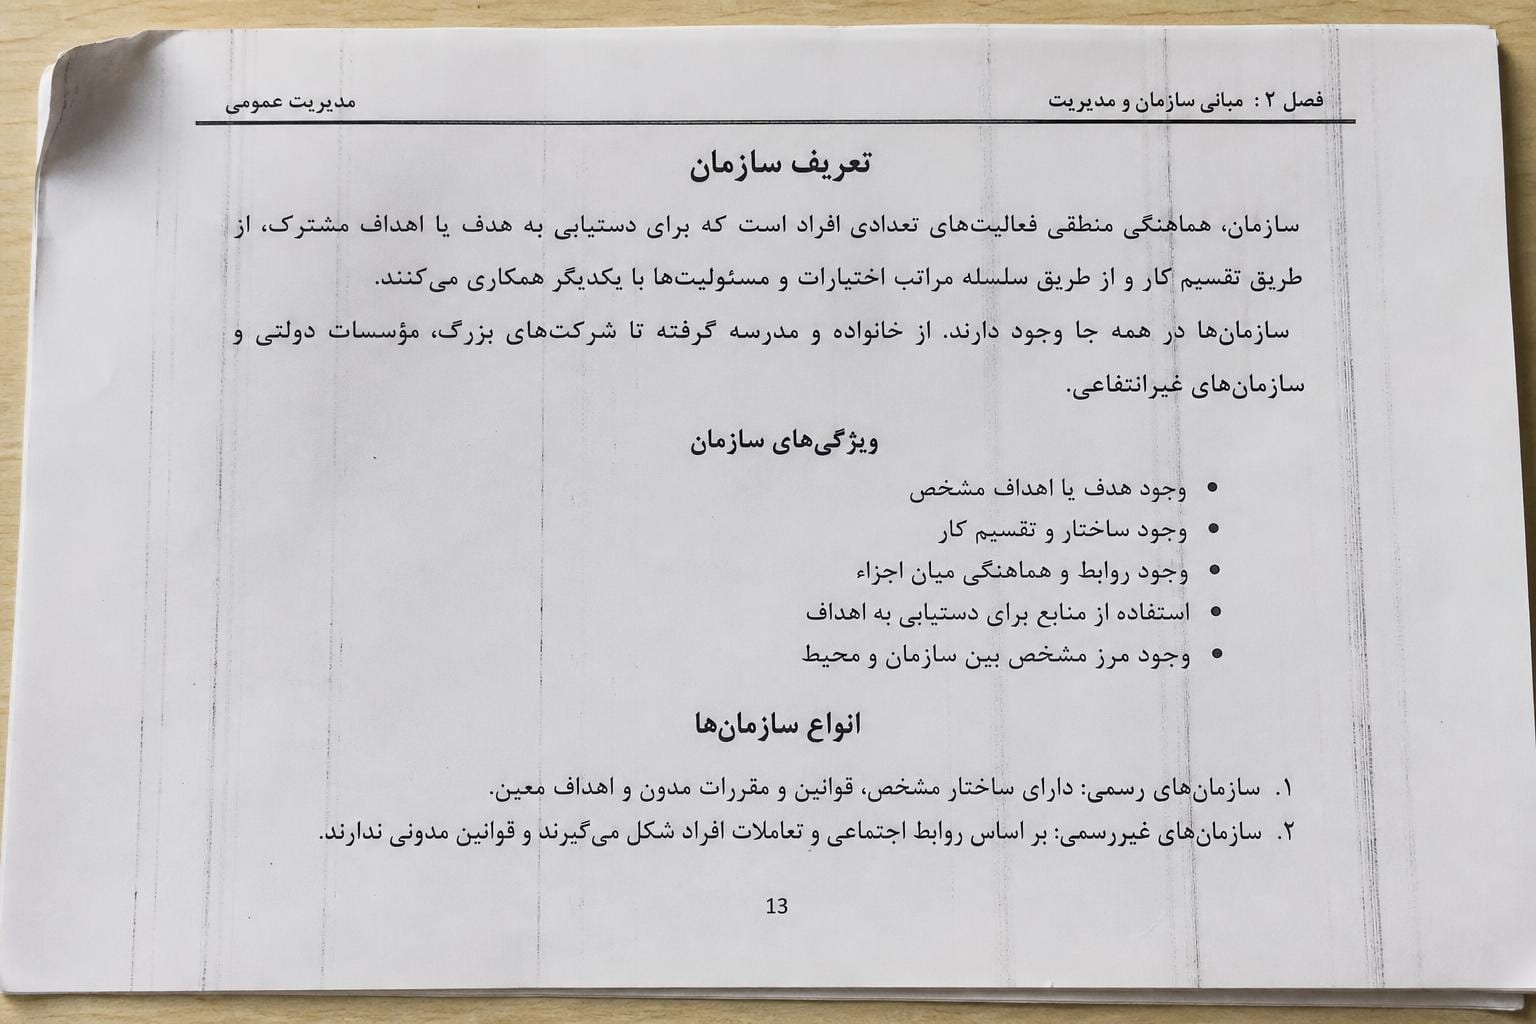
O problema nunca foram os modelos, foram os dados
Os sistemas modernos de OCR, os baseados em transformers como TrOCR e Donut citados no artigo, são famintos. Eles precisam de enormes volumes de dados pareados: uma imagem de texto de um lado e a transcrição correta do outro. O inglês tem isso em abundância, raspado de décadas de livros digitalizados, formulários e sites, e depois corrigido manualmente por exércitos de anotadores. O persa não.
Parte desse hiato é apenas econômica. Anotar dados de OCR significa que alguém (ou algum pipeline) precisa olhar para uma imagem e digitar exatamente o que ela diz, caractere por caractere, incluindo onde as diacríticas se posicionaram. Isso é lento, caro e não escala da mesma forma que um corpus de inglês raspado. Mas parte do hiato é o próprio sistema de escrita. O persa, assim como o árabe e o urdu, é escrito em cursivo por regra, não por escolha estilística, e cada letra se remodela sutilmente com base no que está ao seu lado. Um conjunto de dados construído a partir de algumas fontes modernas e limpas não preparará um modelo para os ligaduras e variantes de glifos que ele encontrará no mundo real, muito menos para as duas tradições de escrita dominantes, Naskh (mais ereto, semelhante à impressão) e Nastaliq (a forma caligráfica fluida comum na literatura persa e em placas), que parecem sistemas de escrita quase não relacionados se você for um modelo que só viu um deles.
Então você acaba preso: dados anotados reais são muito caros para serem produzidos em escala, e conjuntos de dados pequenos não cobrem variação suficiente do sistema de escrita para treinar um modelo robusto. A resposta do Persian Pixel é parar de esperar por dados reais e gerar dados sintéticos em vez disso, trabalhando duro para fazer com que os dados sintéticos se comportem como dados reais quando um modelo os vê.
Como eles construíram 343.000 documentos falsos que (na maioria das vezes) se comportam como reais
O pipeline começa com um corpus de texto em persa de sete milhões de palavras, curado em vez de raspado em massa, que se torna a matéria-prima para tudo o que vem a seguir. Um framework de renderização chamado pelos autores de SynthOCR-Gen transforma então esse texto em imagens, e é aqui que a engenharia específica do script realmente acontece. O sistema precisa acertar a junção contextual de caracteres (qual forma de uma letra desenhar com base em seus vizinhos), posicionar corretamente variantes de glifos posicionais, lidar com o posicionamento de diacríticos e fazer tudo isso em várias fontes persas representativas que abrangem os estilos Naskh e Nastaliq.
A saída não são apenas trechos em nível de palavra. O conjunto de dados abrange três escalas de layout: frases, parágrafos e documentos de página inteira. Esse alcance importa mais do que parece. Um modelo treinado apenas em palavras isoladas não tem ideia de como lidar com quebras de linha, justificação de parágrafos ou o ruído de layout de uma página digitalizada real, onde o texto não fica alinhado em uma única linha organizada esperando para ser lido.
Renderizar texto limpo é a metade fácil. O problema mais difícil, e aquele que realmente determina se algo disso é útil, é o gap de domínio sintético-para-real: um modelo treinado em texto renderizado por computador impecável tende a se desintegrar no momento em que encontra um documento digitalizado ou fotografado real, porque documentos reais estão cheios de imperfeições físicas que um renderizador não produz por padrão. Persian Pixel ataca isso com mais de vinte e cinco modelos de degradação estocástica sobrepostos às imagens renderizadas: vazamento de tinta, envelhecimento do papel, desfoque, iluminação desigual, artefatos de scanner, ruído de compressão e vários outros processos de ruído, aplicados probabilisticamente para que nenhuma duas imagens se degradem da mesma forma. É o equivalente em OCR de treinar um sistema de direção autônoma em um simulador, e então randomizar o clima simulado, a iluminação e a sujeira da estrada até que o modelo perca a capacidade de distinguir simulação da realidade.
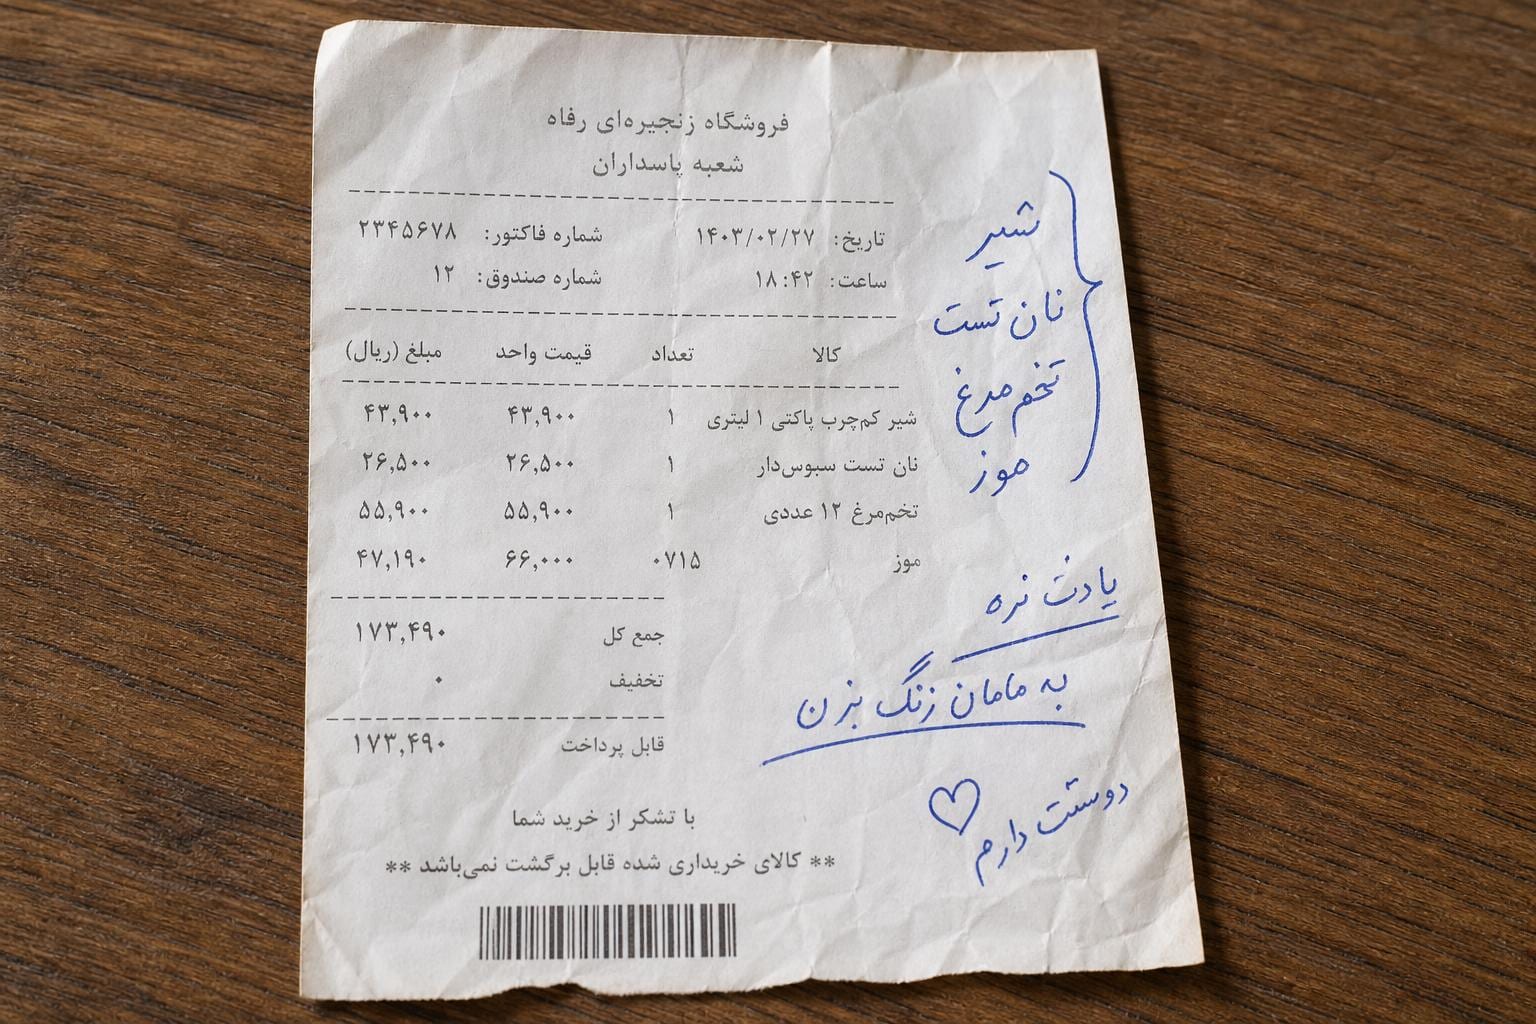
O que há realmente na caixa
Removendo a descrição do pipeline, o próprio conjunto de dados é simples de descrever: mais de 343.000 pares de imagem e texto, gerados a partir de um corpus de sete milhões de palavras, distribuídos em layouts de nível de frase, parágrafo e página, renderizados em múltiplas fontes persas que cobrem ambos os estilos principais de escrita, e degradados com mais de 25 modelos de artefatos para simular condições reais de captura. Ele foi construído para ser um recurso de treinamento ou ajuste fino para arquiteturas OCR baseadas em transformadores como TrOCR e Donut especificamente, em vez de um benchmark de uso geral.
O que o resumo do artigo não inclui é a parte que eu mais queria ver: números reais sobre como um modelo treinado no Persian Pixel se compara a documentos persas reais, não sintéticos. Não há taxa de erro de caractere, não há taxa de erro de palavra, não há comparação com quaisquer linhas de base de OCR persa que já existam. Isso não é uma crítica à utilidade do conjunto de dados, mas sim um alerta sobre como interpretar a afirmação. "Construímos um conjunto de dados sintético grande e cuidadosamente engenheirado" e "provamos que este conjunto de dados fecha a lacuna de precisão no mundo real" são duas afirmações diferentes, e apenas a primeira é totalmente respaldada pelo que é descrito aqui.
Por que isso importa para quem está construindo ou escolhendo OCR
Se você está escolhendo um mecanismo de OCR e o persa faz parte da mistura de documentos que você lida — recibos, formulários governamentais, manuscritos históricos, o que for — a lição prática não é "vá em frente e use o Persian Pixel diretamente". É que o campo agora conta com um recurso de treinamento credível e feito sob medida para um sistema de escrita que estava muito mal atendido, e qualquer fornecedor ou modelo de código aberto que afirme ter um suporte decente para o persa nos próximos um ou dois anos provavelmente treinou com dados como esses, já que dados persas anotados manualmente nessa escala basicamente não existem em outro lugar.
A lição mais ampla se generaliza para além do persa. Uma parcela enorme dos sistemas de escrita do mundo — árabe, urdu, tailandês, amárico e dezenas de outros — enfrenta exatamente o mesmo gargalo: scripts complexos, dados anotados escassos e qualidade de OCR que fica para trás em relação aos scripts latinos como consequência. O Persian Pixel é um exemplo prático da solução sendo aplicada em escala: em vez de esperar que a anotação manual se iguale, modele as regras de renderização do script com precisão suficiente para que dados sintéticos possam substituir os reais, e depois dedique esforço de engenharia real para fechar a lacuna entre "parece texto" e "parece um documento que passou por um scanner, uma década e uma fotocopiadora ruim".
Se você está avaliando as alegações de um fornecedor de OCR em relação ao persa (ou árabe, ou tailandês), a pergunta honesta a fazer é se a precisão relatada deles veio de um benchmark como esse sintético, ou de documentos reais extraídos do tipo de pipeline que você realmente executará. Modelos treinados com dados sintéticos podem ser genuinamente robustos, mas "treinado em 343.000 páginas sintéticas" e "testado em 343.000 páginas sintéticas" é uma alegação muito mais fraca do que "testado em faturas reais que ninguém projetou o renderizador para antecipar". Peça o número do mundo real, não apenas o tamanho do conjunto de dados.
O que ainda está faltando
Algumas lacunas valem a pena ser nomeadas claramente. Primeiro, e mais óbvio: não há resultados de benchmark nos materiais disponíveis para esta peça. Não sabemos as taxas de erro reais que um modelo TrOCR ou Donut alcança após o ajuste fino no Persian Pixel, seja em dados sintéticos retidos ou, mais importante, em documentos persas digitalizados reais. Esse é o número que diria se este conjunto de dados realmente faz a diferença ou apenas parece impressionante no papel.
Em segundo lugar, a degradação sintética, por mais sofisticada que seja, ainda é uma simulação do desgaste do mundo real, não a coisa em si. Vinte e cinco modelos de degradação estocástica são um grande esforço de engenharia e provavelmente suficientes para reduzir significativamente a lacuna de domínio, mas "reduzir" não é "fechar". Manuscritos históricos, em particular, um dos casos de uso que o artigo nomeia explicitamente, envolvem padrões de degradação (séculos de desbotamento de tinta, danos físicos, tipos históricos não padrão e caligrafia) que um pipeline de renderização moderno calibrado em fontes Naskh e Nastaliq contemporâneas provavelmente não captura totalmente.
Em terceiro lugar, a caligrafia não é mencionada de forma alguma. Tudo descrito aqui é texto renderizado e diagramado. O reconhecimento de escrita persa, argumentavelmente um problema ainda mais difícil dada a linha de base cursiva do script que se torna mais extrema na forma manuscrita, não é abordada por este conjunto de dados.
Nenhum disso apaga a contribuição. A digitalização de documentos persas ficou presa atrás de uma parede de dados por muito tempo, e um conjunto de dados sintético cuidadosamente projetado que modela as regras tipográficas reais do script, em vez de tratar o persa como "texto latino, mas da direita para a esquerda", é um passo real. Apenas trate o número de destaque, 343.000 pares de imagem-texto, como uma medida de escala e esforço de engenharia, não como um substituto para o quão bem os modelos resultantes lerão seus documentos reais. Essa segunda questão ainda precisa de uma resposta, e é a que vale a pena perguntar antes de construir sobre isso.