ペルシャ語の話者は1億1000万人いるが、OCRデータはほぼ存在しない。この論文はそれを解決するために34万3000ページを偽造した
元論文: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
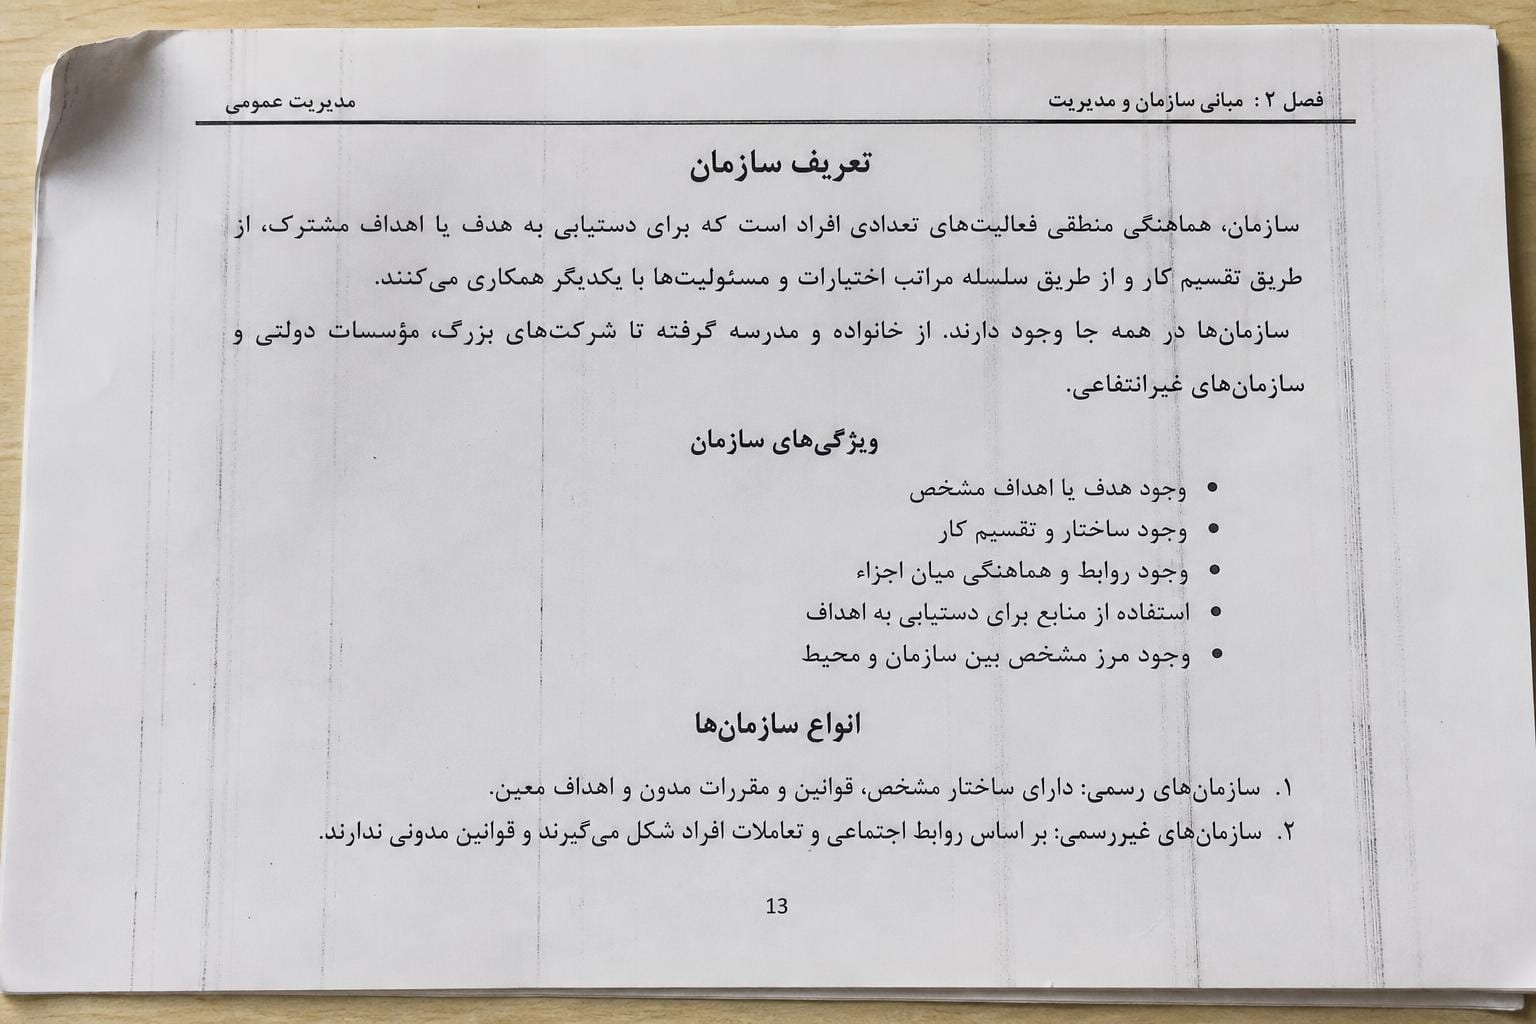
ペルシャ文字の「ب」(「b」に相当する文字)を例に考えてみましょう。この文字は、単語の頭、真ん中、末尾、あるいは単独で現れる場合で、4つの異なる字形をとります。アルファベットの大半の文字で同じことが言えます。さらに、発音を変えるが通常の表記では省略可能な音符(diacritic marks)が存在します。これにより、モデルは音符が欠けている場合、「本来不要だったのか」、それとも「スキャナーが読み取れなかっただけなのか」を推測する必要があります。さらに、文字が斜めに流れるように描かれ、互いに重なり合う書体「ナスタリク体」で全体がレンダリングされると、いかなる文字にもきれいなバウンディングボックスを引くのは至難の業です。
これが1段落で要約されるペルシャ語OCRの現実であり、1億1,000万人以上が使用するこの文字体系が、テキスト認識の精度においてラテン文字圏の言語に大きく遅れを取っている理由です。新しい論文「Persian Pixel」は、この問題を解決するための新しいモデルアーキテクチャを提案するものではありません。代わりに、より地味だが、筆者はより実用的だと考えるアプローチを採用しています。それは、既存のアーキテクチャが十分に学習できるよう、343,000枚の偽造ドキュメント画像を生成することです。
問題だったのはモデルではなく、データでした
論文で言及されているTrOCRやDonutのような、トランスフォーマーベースの現代のOCRシステムは、膨大な量のペアデータ(一方にテキストの画像、他方に正しい転写結果)を必要とする「大食漢」です。英語には、何十年にもわたる書籍、フォーム、ウェブサイトのスキャンデータから収集され、多数の注釈付け担当者によって手作業で修正されたデータが豊富に存在します。しかし、ペルシャ語にはそれがありません。
このギャップの一部は単に経済的な要因によるものです。OCRデータの注釈付けとは、誰か(またはパイプライン)が画像を見て、文字の位置や点字(diacritics)の配置まで含め、正確に文字起こしを行う作業を意味します。これは時間がかかり、コストが高く、スクレイピングされた英語コーパスのようにスケールしません。しかし、ギャップのもう一つの要因は文字体系そのものです。ペルシャ語はアラビア語やウルドゥー語と同様に、スタイルの選択ではなく規則によって筆記体で書かれ、隣接する文字に応じて各文字の形状が微妙に変化します。少数のクリーンで現代的なフォントから構築されたデータセットでは、野外で遭遇する結合文字やグリフのバリエーション、さらには2つの主要な書体伝統であるナスク体(より直立した印刷風)とナスターリーク体(ペルシャ文学や看板で一般的な流れるような書道様式)に対応したモデルを訓練することはできません。これらの書体は、片方の書体しか見たことのないモデルにとって、まるで無関係な文字体系のように見えます。
その結果、以下のようなジレンマに陥ります。実際の注釈付きデータは大規模に作成するにはコストが高すぎ、小さなデータセットでは文字体系の多様性を十分にカバーできず、堅牢なモデルを訓練できません。Persian Pixelの解決策は、実際のデータを待つのをやめ、代わりに合成データを生成し、モデルがそれを見た際に合成データが実際のデータのように振る舞うように徹底的に調整することです。
34万枚の「本物そっくり」の偽文書がどのように構築されたか
パイプラインは、700万語のペルシャ語テキストコーパスから始まります。これは一括スクレイピングではなく、キュレーションされたものであり、それ以降のすべての工程の原材料となります。著者らがSynthOCR-Genと呼ぶレンダリングフレームワークが、このテキストを画像に変換し、ここでスクリプト固有のエンジニアリングが実際に実行されます。システムは、文脈に応じた文字の結合(隣接する文字に基づいてどの字形を描画するか)を正しく処理し、位置に応じた字形バリアントを適切に配置し、点字(diacritic)の配置を処理し、さらにNaskhとNastaliqの両スタイルを網羅する複数の代表的なペルシャ語フォント全体でこれらを処理する必要があります。
出力は単語レベルのスニペットだけではありません。データセットは、文、段落、全ページ文書という3つのレイアウトスケールをカバーしています。この範囲の広さは、聞こえる以上に重要です。孤立した単語のみで学習したモデルは、改行や段落の両端揃え、あるいはテキストが整然と1行に並んで読まれるのを待っているわけではない実際のスキャンページのレイアウトノイズをどのように処理すればよいかを全く理解していません。
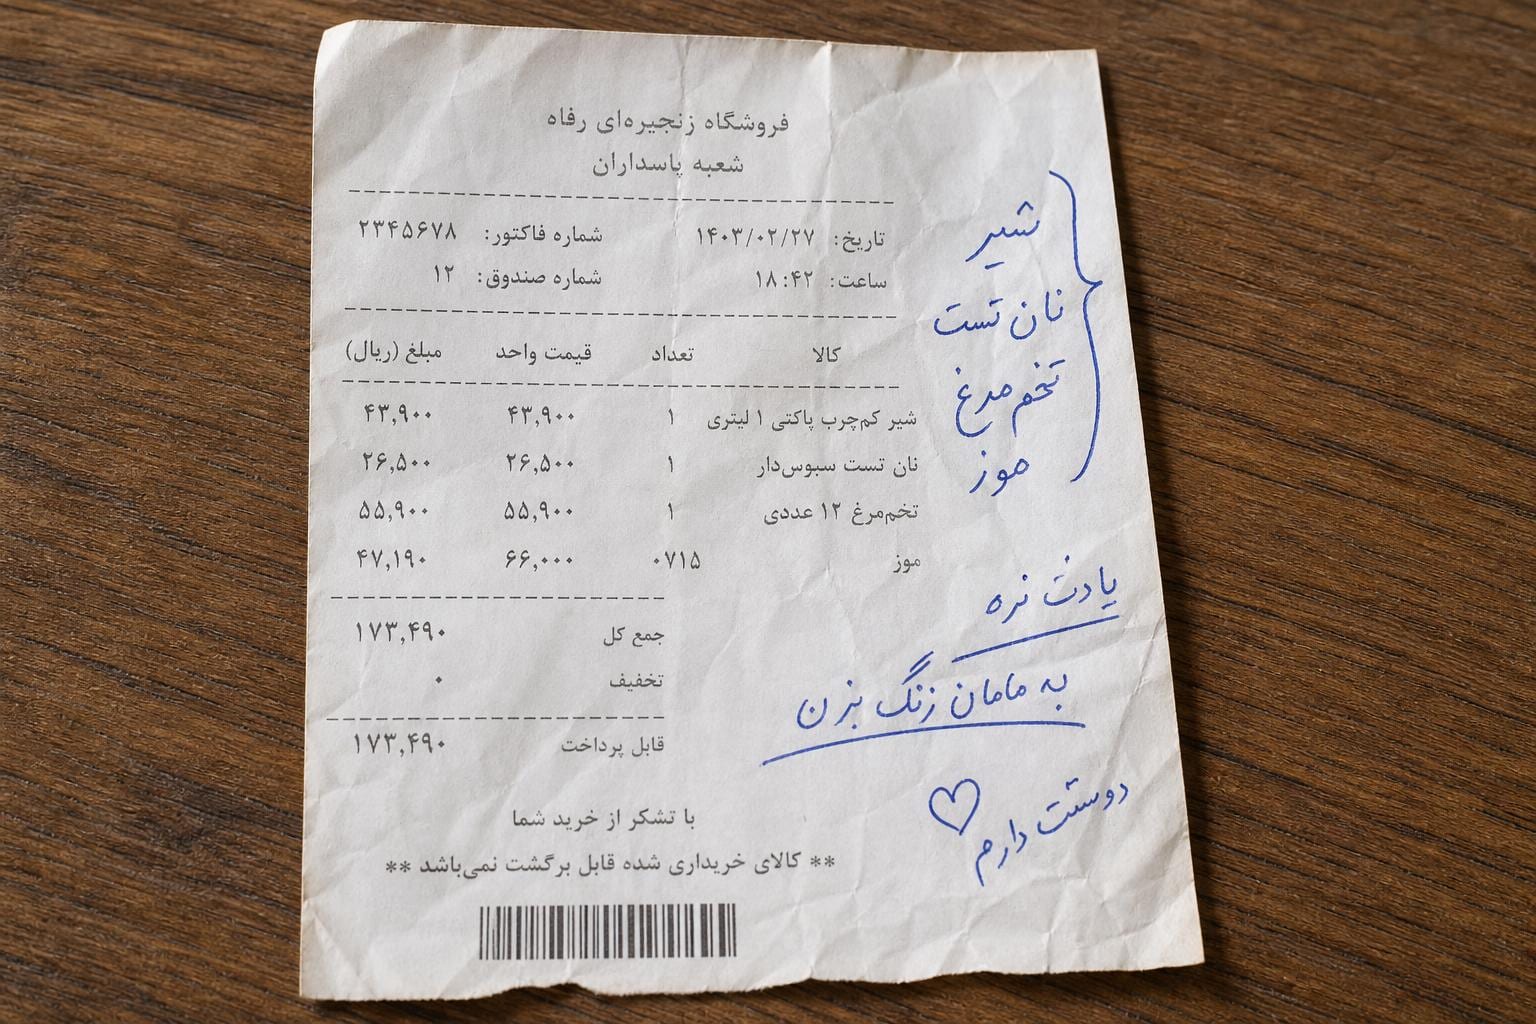
クリーンなテキストのレンダリングは簡単な半分です。より難しい問題で、これが有用かどうかを決定づけるのは、合成データと実データ間のドメインギャップです。完璧なコンピュータレンダリングされたテキストで学習したモデルは、実際のスキャンまたは写真撮影された文書に出会うとすぐに崩壊する傾向があります。これは、実際の文書には、レンダラーがデフォルトで生成しない物理的な欠陥が満ちているためです。Persian Pixelは、レンダリングされた画像に25以上の確率的劣化モデルをレイヤー状に重ねることでこれに対処しています。インクの滲み、紙の劣化、ぼかし、不均一な照明、スキャナーのアーティファクト、圧縮ノイズ、およびその他のいくつかのノイズプロセスが、確率的に適用されるため、2枚として同じ劣化をする画像はありません。これは、シミュレーターで自動運転システムを訓練し、その後、シミュレーションされた天気、照明、道路の汚れをランダム化して、モデルがシミュレーションと現実を区別できなくなるまでにする、OCR版の取り組みです。
ボックスの中身は実際には何なのか
パイプラインの説明を取り除けば、データセット自体は単純に説明できます。700万語のコーパスから生成された34万3,000以上の画像とテキストのペアで、文、段落、ページレベルのレイアウトに分割され、主要な2つの書体スタイルをカバーする複数のペルシャ字体でレンダリングされ、25以上のアーティファクトモデルで劣化させて現実のキャプチャ条件をシミュレートしています。これは、TrOCRやDonutのようなトランスフォーマーベースのOCRアーキテクチャ向けのトレーニングまたはファインチューニングリソースとして設計されており、汎用ベンチマークとしては意図されていません。
論文の抄録に含まれていないのは、私が最も見たいと思っていた部分です。つまり、ペルシャピクセルでトレーニングされたモデルが、実際の非合成のペルシャ文書に対してどのようにパフォーマンスを発揮するかという具体的な数値です。文字誤り率も単語誤り率も、既存のペルシャOCRベースラインとの比較もありません。これはデータセットの有用性に対する批判というよりは、この主張をどう読むべきかを示すフラグです。「大規模で慎重に設計された合成データセットを構築した」と「このデータセットが現実世界の精度ギャップを埋めることを証明した」は2つの異なる主張であり、ここで説明されている内容で完全に裏付けられているのは前者だけです。
OCRの構築・選定においてなぜ重要なのか
OCRエンジンの選定において、ペルシャ語がドキュメントミックス(領収書、政府のフォーム、歴史的写本など)に含まれている場合、実務的な教訓は「Persian Pixelを直接使用せよ」というものではありません。むしろ、これまで深刻なデータ不足に悩まされていた書体に対し、信頼性が高く目的特化型の学習リソースがようやく登場したという点にあります。今後1〜2年でペルシャ語の良好なサポートを謳うベンダーやオープンモデルは、この種のデータで学習している可能性が高く、なぜならこの規模の手動アノテーション済みペルシャ語データは他にはほぼ存在しないからです。
この教訓はペルシャ語を超えて一般化できます。アラビア語、ウルドゥー語、タイ語、アムハラ語など、世界の多くの書記体系は同じボトルネックに直面しています。複雑な書体、限られたアノテーションデータ、そしてその結果としてラテン文字系に劣るOCR精度です。Persian Pixelは、この問題に対する大規模な解決策の実例です。手動アノテーションが追いつくのを待つ代わりに、書体のレンダリングルールを十分に精密にモデル化して合成データで代用し、実際のエンジニアリングリソースを「テキストのように見える」状態から「スキャナー、数十年の年月、劣悪なコピー機を経てきたドキュメントのように見える」状態へのギャップを埋める作業に注ぐアプローチです。
ここで重要なローカライズの課題として、日本語は漢字と仮名を混在させ、さらに縦書きというレイアウトを採用するため、OCRやVLMモデルにとって最も困難なケースの一つとなります。もし対象の論文やモデルが英語のみを対象とし、縦書きテキストを無視している場合、それは日本語読者にとって漢字の処理や縦書きレイアウトのサポートがカバーされていないことを意味します。
ペルシャ語(またはアラビア語、タイ語)のOCRプロバイダの主張を評価する場合、正直に問うべきことは、報告された精度がこの種の合成ベンチマークから出たものか、それとも実際に運用するパイプラインから取得した実ドキュメントから出たものか、という点です。合成データで学習したモデルは確かに強力ですが、「34万3,000ページの合成データで学習」し「34万3,000ページの合成データでテスト」したという主張は、「レンダラーが想定していなかった実世界の請求書でテストした」という主張よりもはるかに弱いものです。データセットの規模だけでなく、実世界の数字を求めましょう。
まだ不足しているもの
いくつかの欠陥を率直に指摘しておく価値がある。第一に、そして最も明白な点は、本稿で利用可能な資料にベンチマーク結果が含まれていないことだ。TrOCRやDonutモデルをPersian Pixelでファインチューニングした後、保持された合成データ、あるいはより重要なのは実際のスキャンされたペルシャ語文書において、どの程度の実際のエラー率を達成するかは不明である。この数値こそが、このデータセットが実際に状況を改善するのか、それとも紙面上でのみ印象的に見えるだけなのかを判断する基準となる。
第二に、合成劣化は、どれほど洗練されていようとも、現実世界の摩耗のシミュレーションに過ぎず、それ自体ではない。25の確率的劣化モデルは多大なエンジニアリング努力の結晶であり、ドメインギャップを意味のある範囲で狭めるには十分かもしれないが、「狭める」ことと「近い」ことは異なる。特に、論文で明示的に言及されているユースケースの一つである歴史的写本については、数世紀にわたるインクの褪色、物理的損傷、非標準的な歴史的書体や手書き文字といった劣化パターンが含まれており、現代のNaskhやNastaliqフォントに較正されたレンダリングパイプラインでは完全に捉えきれていない可能性が高い。
第三に、手書き文字については一切言及されていない。ここで説明されているものはすべて、レンダリングされた組版テキストである。ペルシャ語の手書き文字認識は、筆記体のベースラインが手書き形式でより極端になるため、おそらくさらに困難な問題であるが、このデータセットでは対応していない。
これらの欠陥がその貢献を消し去るわけではない。ペルシャ語文書のデジタル化は長らくデータの壁に阻まれており、ペルシャ語を「右から左へのラテン文字」として扱うのではなく、実際のタイポグラフィックルールをモデル化した慎重に設計された合成データセットは、確かに一歩前進である。ただし、34万3,000という画像-テキストペアの数は、規模やエンジニアリング努力の尺度として捉えるべきであり、結果として得られるモデルが実際の文書をどの程度正確に読み取れるかの代用指標としては捉えるべきではない。後者の問いに対する答えはまだ必要であり、このデータセットを基に構築を進める前に問うべき価値のある問いである。