Deja de pedirle a la IA que dibuje cajas: una mejor manera de demostrar de dónde proviene una respuesta
Basado en: Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels — Zhuchenyang Liu, Yao Zhang, Yu Xiao
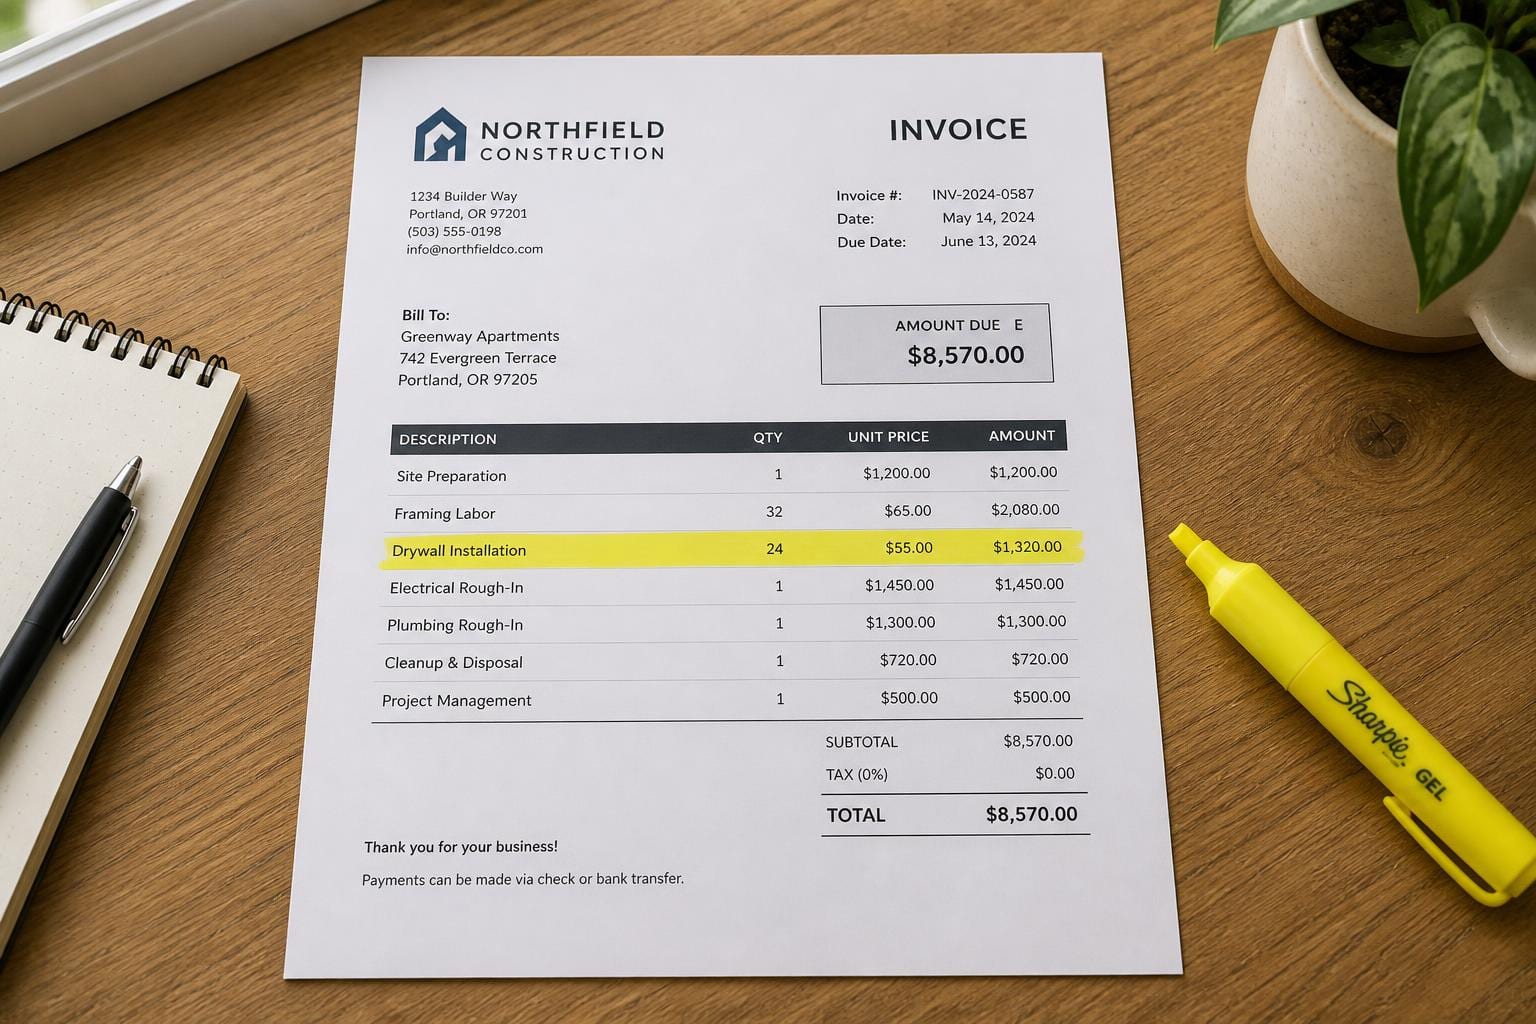
Imagina un bot de informes de gastos que lee una factura escaneada y te dice que el total es de $482.17. Es correcto. Ahora dibuja un recuadro alrededor del logotipo del proveedor y dice que ahí es donde encontró el número. La respuesta era correcta. El señalamiento era absurdo.
Eso no es una hipótesis. Es un modo de fallo documentado en los modelos de visión y lenguaje (VLMs, los modelos que pueden leer tanto una imagen como una indicación de texto juntos), y tiene un nombre: Alucinación de Atribución. Un modelo te da la respuesta correcta y luego cita la evidencia incorrecta para ello, o evidencia que realmente no existe. Un nuevo artículo, "Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels" de Zhuchenyang Liu, Yao Zhang y Yu Xiao, rastrea este fallo hasta algo sorprendentemente mundano: la forma en que hemos estado pidiendo a los modelos que señalen.
La parte que todos pasan por alto: responder y citar son habilidades diferentes
La mayoría de los sistemas actuales de preguntas y respuestas sobre documentos funcionan de la siguiente manera. Se le muestra al modelo una página (una factura, un contrato, un formulario escaneado), se le hace una pregunta ("¿cuál es el total adeudado?") y el modelo proporciona una respuesta junto con una caja delimitadora: un conjunto de coordenadas de píxeles que marcan el rectángulo en la página donde supuestamente encontró esa respuesta. Esta es la interfaz de coordenadas, y es la forma estándar en que los benchmarks y productos han pedido a los modelos que muestren su trabajo.
El problema es que leer un documento y describir coordenadas de píxeles son dos tareas diferentes unidas a la fuerza. Un modelo puede comprender genuinamente que el total es $482.17 porque analizó correctamente la estructura de la tabla, y aún así ser malo traduciendo "ese número, en esa celda" a "x=412, y=88, width=64, height=22". Las coordenadas son un lenguaje para el que los VLMs no fueron entrenados principalmente. El texto sí.
Los autores pusieron esto a prueba en CiteVQA, un benchmark bilingüe (inglés y chino) construido específicamente para la atribución de evidencia, utilizando un subconjunto verificado para que la verdad fundamental sobre qué regiones realmente respaldan cada respuesta sea confiable. En seis VLMs abiertos, descubrieron que permitir que un modelo dibuje una caja te da una recuperación de evidencia (el porcentaje de preguntas donde la región citada por el modelo realmente se superpone con la evidencia verdadera) de como máximo 8 de cada 100. No un 8 por ciento por debajo de algún otro método. Ocho. De cada cien preguntas, la caja es aproximadamente correcta quizás ocho veces, incluso cuando la respuesta real del modelo a la pregunta es correcta con mucha más frecuencia.
Lo que intentaron en su lugar: que el modelo cite y luego busque la cita
La solución que propone el artículo es casi vergonzosamente simple de enunciar, aunque requiere una infraestructura real para hacerla funcionar: dejar de pedirle al modelo que proporcione coordenadas.
En su lugar, el modelo responde a la pregunta y luego cita, textualmente, el fragmento de texto que utilizó como evidencia, de la misma manera que copiarías y pegarías una oración de un PDF en un mensaje de chat en lugar de describir dónde se encuentra en la página. Esa es la "interfaz de lenguaje". Un sistema separado luego busca esa cita en el documento. Específicamente:
- Un analizador de diseño (una herramienta que segmenta una página en regiones estructurales como párrafos, celdas de tabla, encabezados y leyendas de figuras, de la manera en que una persona dividiría visualmente una página en "esto es un párrafo, esto es una tabla") divide primero el documento en regiones candidatas.
- Un recuperador multimodal (un sistema de correspondencia que puede comparar texto tanto con el texto como con el diseño de una página) toma la evidencia citada por el modelo y determina de cuál de esas regiones proviene, devolviendo esa región como la ubicación atribuida.
- Las tablas y las figuras, que no tienen prosa fluida que se pueda citar directamente, se manejan a través de sus leyendas o notas, por lo que el enfoque de citar y localizar sigue funcionando incluso fuera de los párrafos simples.
En efecto, el modelo ya no tiene que hacer geometría. Hace en lo que realmente es bueno: leer y repetir texto. Un sistema de recuperación, construido exactamente para este tipo de correspondencia, se encarga de la geometría en su lugar.
Los números que respaldan el caso
Al ejecutar los mismos seis VLMs abiertos en el mismo subconjunto de CiteVQA, la interfaz de lenguaje impulsó el recall de evidencia desde ese techo de 8 hasta un rango entre 26 y 47, dependiendo del modelo. Se trata de un salto de aproximadamente tres a seis veces, logrado puramente al cambiar el formato de salida que se le pide al modelo, sin volver a entrenarlo ni proporcionarle un mejor prompt sobre coordenadas.
La tasa de alucinación (con qué frecuencia el modelo atribuye con confianza una respuesta a una evidencia que en realidad no la respalda) se redujo a la mitad aproximadamente bajo la nueva interfaz. Y la parte que normalmente sería la contrapartida: la calidad de la respuesta, es decir, si el modelo responde correctamente a la pregunta real, apenas varió. No estás intercambiando corrección por honestidad sobre las fuentes. Recuperas la mayor parte de la honestidad a un costo casi nulo.
Ese es el hallazgo principal, y vale la pena reflexionarlo un momento, porque redefine lo que es realmente la "alucinación de atribución". No es necesariamente un fallo de comprensión. En muchos casos, parece más bien un fallo de formato de salida: el modelo conocía el pasaje correcto, pero la interfaz de coordenadas simplemente no le ofrecía una buena manera de expresarlo.
Convertir la tubería en un maestro: GRPO sin etiquetas de región
El recuerdo en el rango 26-47 es una mejora real, pero no es un problema resuelto. Por lo tanto, los autores utilizaron la tubería de citar y recuperar para un segundo propósito: como un andamio de entrenamiento para hacer que el modelo subyacente sea mejor citando buenas evidencias en primer lugar.
Aquí es donde el artículo busca GRPO (Optimización de Política Relativa de Grupo), un método de aprendizaje por refuerzo que genera un lote de salidas candidatas para la misma entrada, califica cada una y empuja al modelo hacia aquellas que obtuvieron mejores puntuaciones en relación con el grupo. Es la misma familia de técnicas que DeepSeek utilizó para entrenar su modelo de razonamiento R1, y se ha convertido en una forma popular de ajustar finamente un modelo en una tarea donde puedes definir "mejor" pero no tienes un gran conjunto de datos etiquetado que muestre exactamente cómo se ve "mejor" paso a paso.
La forma normal de entrenar un modelo de atribución sería contratar anotadores para dibujar cajas delimitadoras de verdad fundamental en miles de páginas de documentos, marcando exactamente qué región apoya qué respuesta. Eso es costoso y lento, especialmente para documentos largos y multipágina donde una sola respuesta podría depender de evidencia enterrada en la página 14.
El artículo evita eso por completo. En lugar de etiquetas de región, la señal de recompensa proviene de un juez: otro modelo que lee la respuesta correcta (oro) a una pregunta junto con imágenes recortadas de las regiones que el recuperador levantó para la evidencia citada del modelo en entrenamiento, y califica qué tan bien esos recortes realmente apoyan esa respuesta. Ningún humano dibuja nunca una caja. El modelo es recompensado por citar texto que, una vez localizado y recortado, respalda visiblemente la respuesta correcta, y penalizado cuando sus citas llevan al recuperador a regiones irrelevantes.
Aplicado a un modelo base de 8B parámetros (8 mil millones de parámetros, un modelo abierto de tamaño medio por estándares actuales), este entrenamiento impulsó lo que el artículo llama "precisión atribuida estricta", lo que significa que el modelo tiene que obtener tanto la respuesta como la evidencia correcta, o no cuenta, de 22.4 hasta 33.8. Eso es aproximadamente una mejora relativa del 50% en la métrica más estricta y menos indulgente del artículo, utilizando una señal de entrenamiento construida enteramente a partir de herramientas existentes (un modelo juez, un analizador de diseño, un recuperador) en lugar de nuevos datos etiquetados por humanos.
Por qué importa para quien construye o compra document AI
Si estás construyendo algo sobre OCR o document AI, la lección clave aquí no es "usa este benchmark específico". Es que la interfaz que usas para pedirle a un modelo que justifique sus respuestas cambia cuán honesto puede ser, independientemente de qué tan bueno sea el modelo en sí.
Algunas conclusiones concretas:
- Si tu producto muestra a los usuarios "aquí es donde encontré eso" en un documento, verifica qué interfaz está generando esa cita. Una salida de caja delimitadora (bounding box) de un VLM general, según este paper, es correcta como mucho el 8% de las veces en documentos no vistos, incluso cuando la respuesta declarada es correcta. Esa brecha entre "la respuesta es correcta" y "la cita es correcta" es exactamente donde se erosiona silenciosamente la confianza del usuario, porque un resaltado incorrecto junto a una respuesta correcta parece peor para el usuario que ningún resaltado en absoluto.
- Citar-entonces-localizar es un patrón que puedes construir hoy, sin esperar mejores modelos base. No requiere un VLM entrenado a medida. Requiere un analizador de diseño (layout parser) y un recuperador (retriever) conectados alrededor del modelo que ya estés usando, ya que la mejora en este paper provino de cambiar la interfaz, no los pesos subyacentes, para cinco de los seis modelos probados.
- Las etiquetas a nivel de región son costosas, y este paper muestra un camino para evitarlas. Si estás evaluando si financiar un proyecto de anotación para mejorar la calidad de la atribución versus construir una pipeline de recompensa basada en jueces, el resultado de GRPO sugiere que la segunda ruta puede obtener ganancias reales (de 22.4 a 33.8 en precisión estricta atribuida) sin una sola caja dibujada por humanos.
Qué sigue sin resolverse
El artículo es cuidadoso con su alcance, y vale la pena ser igual de precavido al leerlo. Las mejoras se midieron en CiteVQA, un único benchmark bilingüe, y aunque un subconjunto verificado representa una barrera significativamente más alta que uno sin filtrar, sigue siendo un solo conjunto de datos. Un recall de evidencia en el rango de 26-47 es un gran salto desde 8, pero tampoco está cerca de la saturación: más de la mitad de las veces, en la mayoría de los seis modelos, la región recuperada sigue no siendo la correcta. Y el paso de recuperación depende de que el analizador de diseño (layout parser) haga su trabajo correctamente. Si una página se escanea con un ángulo desfavorable, tiene un diseño inusual o contiene tablas que el analizador no puede segmentar bien, toda la cadena de citar y localizar hereda ese error, algo que un modelo hipotético que generara correctamente coordenadas de píxeles en una página bien comportada podría no experimentar.
También hay una dependencia más sutil que merece destacarse: el entrenamiento GRPO depende de un modelo juez para calificar la calidad de la evidencia, y los modelos juez tienen sus propios puntos ciegos. El artículo no afirma que el juez sea un proxy perfecto para el acuerdo humano, y es razonable insistir en ello si se intenta reproducir esto fuera de un entorno de investigación.
Nada de eso socava el hallazgo central. La parte interesante de este artículo no son los números específicos de precisión, sino el diagnóstico: un buen trozo de lo que parecía un problema de razonamiento en IA de documentos era en realidad un problema de formato de salida, y reformatear la salida movió la aguja más de lo que lo habrían hecho la mayoría de los cambios arquitectónicos.