Donut se salta el OCR por completo y aun así lee tus recibos
Basado en: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
Un escáner de recibos sin OCR
Imagine un escáner de recibos que nunca ejecuta OCR. Sin cuadros de detección de texto, sin pasos de reconocimiento de caracteres y sin un modelo independiente acoplado para dar sentido a lo que el motor de OCR haya generado. Usted le entrega la foto de un recibo arrugado y el sistema devuelve un JSON estructurado: nombre del comercio, fecha, artículos y total. Parece que se estuviera saltando un paso indispensable. Sin embargo, según un artículo de 2021 de NAVER (la empresa detrás del buscador dominante en Corea del Sur), omitir ese paso es precisamente lo que hizo que el modelo fuera más rápido y, en varios benchmarks, más preciso que los pipelines que utilizan OCR de manera convencional.
El modelo se llama Donut, abreviatura de Document Understanding Transformer. El nombre es un acrónimo más logrado que el de la mayoría de los artículos académicos, y la idea subyacente es genuinamente contraintuitiva: el enfoque estándar para leer documentos ejecuta primero el OCR y trata el texto reconocido como la verdad absoluta para todo el procesamiento posterior. Donut descarta esa suposición y le pide a un transformer que pase directamente de los píxeles a una salida estructurada.
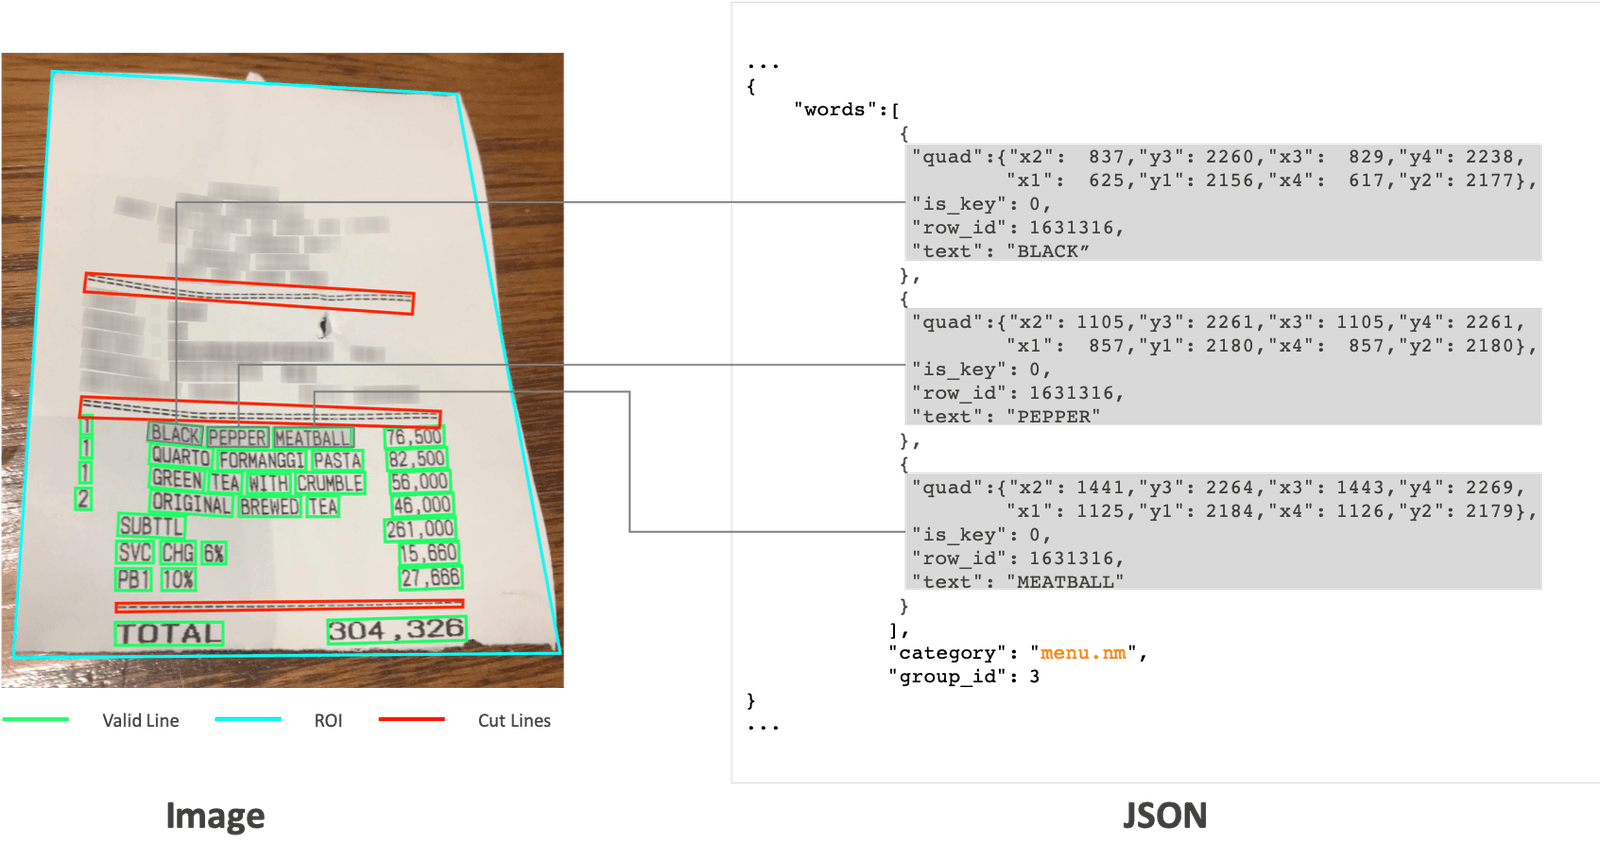
Muestra del CORD receipt dataset (Park et al., Clova AI / NAVER), bajo licencia CC BY 4.0.
Por qué el plan de "simplemente ejecutar OCR primero" resulta ser el equivocado
Hasta hace poco, todos los sistemas de comprensión de documentos visuales seguían la misma receta de dos etapas. Paso uno: ejecutar un motor de OCR (Tesseract, o una API comercial como Amazon Textract o Google Vision) para convertir la imagen en texto y cuadros delimitadores (bounding boxes). Paso dos: alimentar ese texto en un segundo modelo que realice la comprensión real, extrayendo campos, respondiendo preguntas o clasificando el tipo de documento.
Este enfoque funciona, y es la razón por la cual los sistemas basados en OCR han sido el estándar durante años. Sin embargo, los autores del artículo señalan tres problemas intrínsecos a ese diseño:
- Costo. Ejecutar un motor de OCR pesado en cada documento, especialmente a escala, es costoso tanto en cómputo como en latencia. Se paga por un proceso completo de reconocimiento antes de que el modelo "real" siquiera comience a trabajar.
- Inflexibilidad. Los motores de OCR genéricos están optimizados para idiomas y tipos de documentos específicos. Si se utilizan en un recibo en coreano o en una tarjeta de presentación japonesa con formato denso, la precisión puede desplomarse. Reentrenar o ajustar un motor de OCR para un nuevo idioma es, en sí mismo, un proyecto aparte.
- Propagación de errores. Este es el punto que realmente afecta en la práctica. Si el OCR confunde un "3" con un "8" en el total de una factura, cada paso posterior hereda ese error sin posibilidad de recuperarse. El modelo de comprensión ni siquiera llega a ver los píxeles originales; simplemente confía en lo que el motor de OCR le entregó, incluyendo las equivocaciones.
Vale la pena reflexionar sobre este tercer punto, ya que es el tipo de fallo que permanece invisible hasta que le cuesta dinero a alguien. Un pipeline de dos etapas puede estar bien optimizado individualmente en cada fase y, aun así, fallar en su conjunto, porque el traspaso entre etapas descarta información (contexto visual, diseño, características de la fuente) que habría ayudado a detectar el error.
Cómo funciona Donut realmente: un solo modelo, directamente de píxeles a texto
La arquitectura de Donut es casi agresivamente simple, algo que los autores consideran una ventaja y no un descuido. Se trata de un transformer encoder-decoder, la misma estructura general utilizada en muchos modelos sequence-to-sequence.
El encoder es un Swin Transformer, un modelo de visión que procesa la imagen en parches y construye una representación visual. Fundamentalmente, no hay ningún módulo de OCR en esta etapa; no detecta regiones de texto para luego leerlas, sino que construye una comprensión visual general de toda la imagen, de la misma manera que lo haría un modelo de visión diseñado para clasificar fotos de perros.
El decoder es un transformer de texto estilo BART que toma esa representación visual y genera la salida token por token, tal como un modelo de lenguaje genera texto palabra por palabra. El truco clave reside en lo que genera: en lugar de limitarse a transcribir el texto que ve, Donut está entrenado para emitir una secuencia estructurada (básicamente un formato similar a un JSON aplanado) que representa directamente la respuesta a la tarea solicitada. Para un recibo, esto significa el nombre del comercio, la lista de artículos y el total, formateados como una secuencia de tokens especiales que el modelo aprendió a producir durante el entrenamiento. No existe un paso intermedio de "aquí está el texto que detecté". Entran píxeles y salen campos estructurados.
Entrenar un modelo para hacer esto desde cero requiere una cantidad enorme de datos de documentos etiquetados, los cuales no existen en las cantidades necesarias. Por ello, los autores crearon un generador de datos sintéticos llamado SynthDoG (Synthetic Document Generator) que produce documentos de aspecto realista con su correspondiente ground truth en múltiples idiomas, combinando imágenes de fondo, texto muestreado y plantillas de diseño. Esto les permitió preentrenar Donut con millones de documentos sintéticos antes de realizar el fine-tuning en conjuntos de datos reales más pequeños para tareas específicas, que es también como evitaron el problema de la inflexibilidad lingüística que afecta a los motores de OCR. Basta con generar documentos sintéticos en un nuevo idioma para obtener datos de entrenamiento para ese idioma, sin necesidad de reentrenar el OCR.
Abandonado — por MStewartPhotography vía flickr, BY 2.0.
Lo que realmente muestran los números
Los resultados principales provienen de tres tipos de tareas: clasificación de documentos, extracción de información y respuesta a preguntas visuales (visual question answering).
En el dataset RVL-CDIP (un benchmark estándar de 400,000 documentos escaneados en 16 categorías, como cartas, formularios y facturas), Donut alcanzó una precisión de clasificación del 95.30%. Este resultado es competitivo o incluso superior a las líneas base basadas en OCR, lográndolo además con una velocidad de inferencia notablemente mayor, ya que omite por completo el paso de OCR.
Los resultados de extracción de información son donde la apuesta por el "no OCR" rinde frutos de manera más evidente. En CORD, un benchmark público de recibos indonesios con campos como artículos del menú, precios y totales, Donut obtuvo un F1 de 91.6, superando a las líneas base basadas en OCR que utilizaban la misma arquitectura de comprensión de documentos pero dependían de la salida de un motor de OCR externo como entrada. En un dataset de tarjetas de presentación japonesas creado para el paper, Donut superó igualmente a las líneas base de pipeline de OCR, a pesar de que el japonés es un idioma donde los motores de OCR históricamente tienen un rendimiento inferior en comparación con el inglés.
La velocidad es la otra parte de la historia, y no es un detalle menor. Debido a que Donut no ejecuta un paso de OCR independiente, la inferencia es significativamente más rápida que en un sistema comparable de dos etapas, especialmente en imágenes de documentos de alta resolución donde el OCR suele ser la parte más lenta del pipeline. El paper reporta que Donut procesa los documentos en aproximadamente la mitad del tiempo que las líneas base basadas en OCR con las que se comparó, lo cual es fundamental si se implementa a un volumen real y no solo como una demo puntual.
Dónde falla: texto pequeño, diseños complejos y hambre de datos de entrenamiento
Este no es un artículo que pretenda afirmar que el OCR ha quedado obsoleto, y es importante señalar sus limitaciones reales.
En primer lugar, Donut sigue teniendo dificultades con el texto pequeño y denso en alta resolución. Debido a que la resolución de entrada de un vision transformer es fija, existe un límite en la cantidad de detalles finos que el modelo puede resolver; una página saturada de fuente de 8 puntos pone a prueba ese límite de una manera que un motor de OCR dedicado, diseñado específicamente para resolver glifos pequeños, no hace.
En segundo lugar, el modelo requiere un fine-tuning específico para cada tarea para ser realmente eficaz. El pretraining proporciona un modelo que entiende los "documentos" en un sentido general, pero extraer los campos correctos de un tipo de documento específico sigue requiriendo ejemplos etiquetados de dicho documento. Esto no es inusual en la IA de documentos, pero significa que la idea de "simplemente apuntarlo a un nuevo tipo de documento y listo" tiene un asterisco.
Tercero, y esto es un problema estructural: Donut genera la salida como una secuencia aplanada, y la generación es inherentemente más difícil de hacer totalmente fiable que un pipeline de extracción bien diseñado, donde un paso de post-procesamiento basado en reglas puede detectar salidas obviamente mal formadas. Cuando Donut se equivoca, puede producir una salida estructurada que parece plausible pero que sigue siendo incorrecta, y no hay un OCR confidence score ni un bounding box al cual recurrir para una verificación de coherencia. Esa es la contrapartida de omitir la representación intermedia: también se pierde la interpretabilidad que dicha representación proporcionaba.
Por qué es importante si estás desarrollando o adquiriendo OCR
Para cualquiera que esté construyendo pipelines de procesamiento de documentos, la verdadera contribución de Donut no es "elimina tu motor de OCR". Es la evidencia de que los modelos end-to-end y OCR-free son viables para una parte significativa de las tareas de comprensión de documentos, especialmente en la extracción estructurada de documentos con diseños predecibles, como recibos, formularios y tarjetas de presentación.
Si hoy en día estás trabajando sobre un pipeline de OCR y comprensión, esto sugiere algunos puntos prácticos que vale la pena revisar. ¿Realmente necesita tu modelo downstream el texto transcrito, o funcionaría igual de bien (o mejor) trabajando directamente desde la imagen para tu tarea de extracción específica? ¿Es la latencia del OCR realmente un cuello de botella dado tu volumen, y tendría importancia para tu producto la ventaja de velocidad de un modelo end-to-end? Y, fundamentalmente, ¿tiene tu pipeline actual alguna forma de detectar y corregir errores de OCR antes de que se propaguen, o confías ciegamente en lo que el motor de OCR te entrega?
Donut, lanzado junto con su código, pesos entrenados y el generador SynthDoG, se ha convertido desde entonces en una pieza fundamental del ecosistema de document AI de código abierto; modelos posteriores (como Nougat para PDFs científicos) adoptaron su enfoque de "generar tokens estructurados directamente desde los píxeles". La idea principal que plantea el artículo es que el OCR no es una ley natural para la comprensión de documentos. Es una decisión de diseño y, para una clase considerable de documentos —especialmente aquellos con diseños consistentes y tipos de campos conocidos—, omitirlo por completo puede ser más rápido y preciso que intentar ejecutarlo a la perfección.
Dicho esto, no es un reemplazo universal. Si manejas texto denso e impredecible a gran escala, un motor de OCR robusto combinado con un buen modelo de extracción sigue siendo la apuesta más segura hoy en día. La lección de Donut no es que "el OCR ha muerto", sino "verifica si realmente lo necesitas para la tarea que tienes delante", una pregunta mucho más útil de la que la mayoría de los artículos académicos suelen dejarte.