DonutはOCRを完全にスキップし、それでもレシートを読み取る
元論文: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
OCRを一切行わないレシートスキャナーを想像してみてください
テキスト検出のバウンディングボックスも、文字認識ステップも、そしてOCRエンジンが出力した結果を解釈するために後付けされた別モデルも存在しません。しわくちゃのレシートの写真を読み込ませると、店名、日付、明細、合計金額といった構造化されたJSONが出力される。必要なステップを飛ばしているように聞こえるかもしれません。しかし、韓国の主要検索エンジンを運営するNAVERが2021年に発表した論文によれば、まさにそのステップを省いたことこそが、モデルの高速化を実現し、いくつかのベンチマークにおいて、適切にOCRを利用したパイプラインよりも高い精度を叩き出した要因だったといいます。
このモデルはDonut(Document Understanding Transformerの略)と呼ばれています。多くの論文よりも優れたアクロニム(略称)ですが、その根底にあるアイデアは実に直感的ではありません。ドキュメントを読み取る標準的なアプローチでは、まずOCRを実行し、認識されたテキストを後続のすべての処理における「正解(ground truth)」として扱います。Donutはこの前提を捨て去り、Transformerを用いてピクセルから構造化出力へと直接変換させるという手法を採っています。
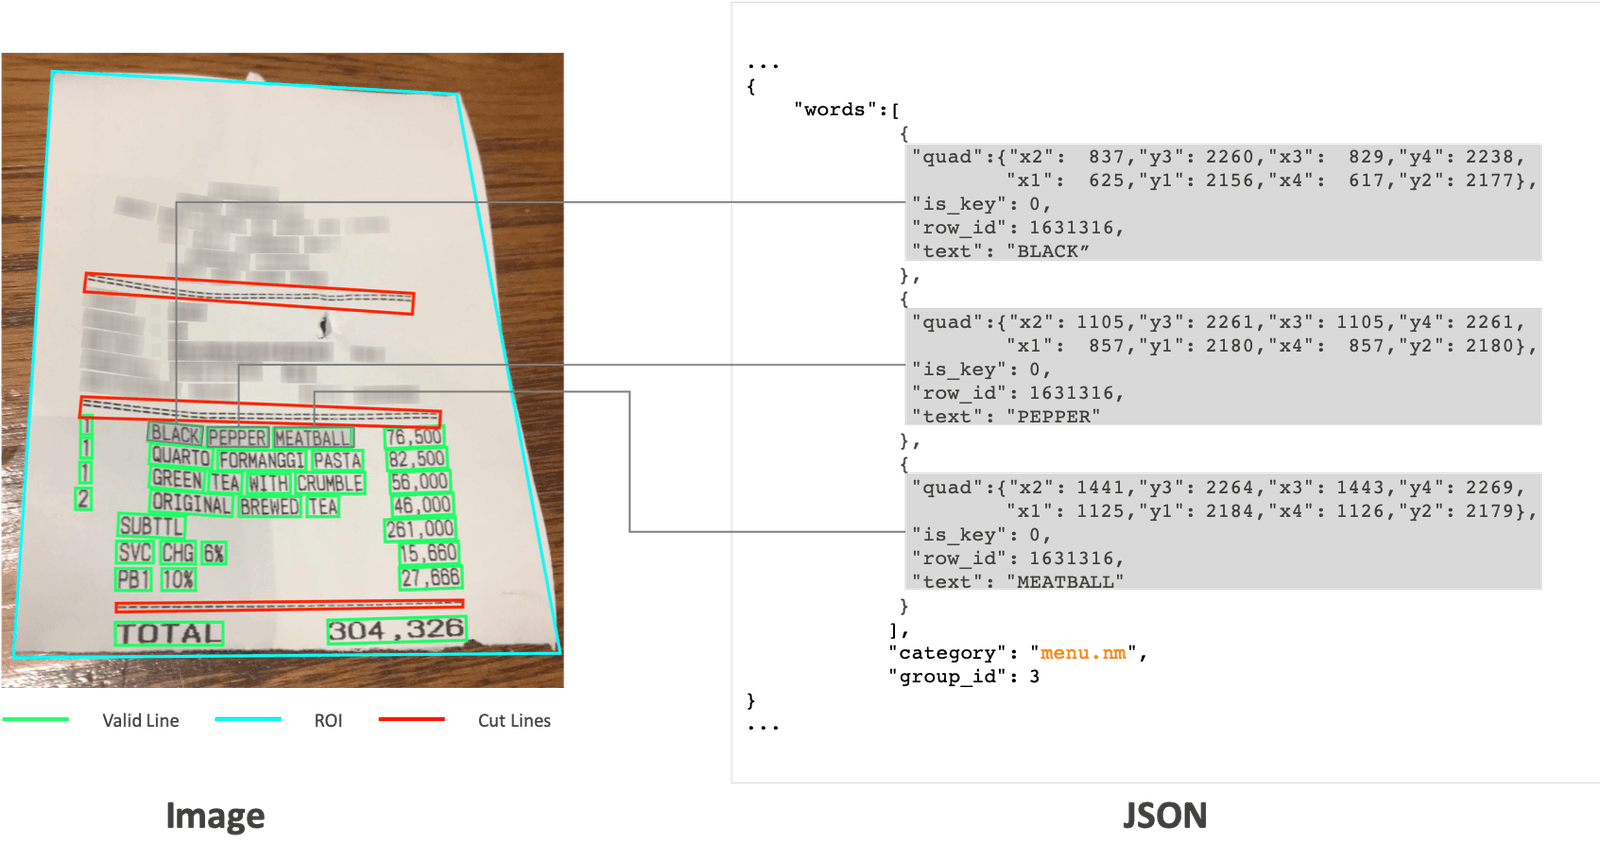
Sample from the CORD receipt dataset (Park et al., Clova AI / NAVER), licensed CC BY 4.0.
「まずOCRをかければいい」という計画が間違いである理由
最近まで、あらゆる視覚的ドキュメント理解システムは、同じ2段階のレシピに従っていました。ステップ1では、OCRエンジン(Tesseractや、Amazon Textract、Google Visionなどの商用API)を実行し、画像をテキストとバウンディングボックスに変換します。ステップ2では、そのテキストを2つ目のモデルに投入し、フィールドの抽出や質問への回答、ドキュメント種類の分類といった実際の「理解」を行います。
この手法は機能しますし、だからこそOCRベースのシステムが長年デフォルトとなってきました。しかし、本論文の著者らは、この設計に組み込まれた3つの問題点を指摘しています。
- コスト。 すべてのドキュメントに対して、特に大規模に重いOCRエンジンを走らせることは、計算リソースとレイテンシの両面でコストがかかります。「本番」のモデルが動き出す前に、フル認識パスのためのコストを支払っていることになります。
- 柔軟性の欠如。 既製のOCRエンジンは、特定の言語やドキュメントタイプに合わせて調整されています。韓国語のレシートや、密集したフォーマットの日本の名刺に適用すると、精度が急激に低下することがあります。新しい言語に合わせてOCRエンジンを再学習させたりファインチューニングしたりすること自体が、一つの大きなプロジェクトになってしまいます。
- エラーの伝播。 これが実務において最も深刻な問題です。例えば、請求書の合計金額でOCRが「3」を「8」と誤認した場合、後続のすべてのステップがそのエラーを引き継ぎ、回復する方法はありません。理解モデルは元のピクセルを一切見ることがなく、OCRエンジンから渡された内容を、間違いも含めてそのまま信頼してしまうからです。
特に3つ目のポイントは深く考える価値があります。なぜなら、これは誰かが金銭的な損失を被るまで表面化しない種類の失敗だからです。2段階のパイプラインは、各ステージを個別に最適化したとしても、全体としては失敗する可能性があります。ステージ間の受け渡しにおいて、エラーの検知に役立つはずの情報(視覚的なコンテキスト、レイアウト、フォントの特徴など)が捨てられてしまうためです。
Donutの仕組み:ピクセルからテキストへ直接変換する単一モデル
Donutのアーキテクチャは驚くほどシンプルですが、著者らはこれを設計上のミスではなく、あえて採用した「機能」として位置づけています。その構造は、多くのsequence-to-sequenceモデルで採用されているものと同様の、エンコーダー・デコーダー形式のTransformerです。
エンコーダーにはSwin Transformerが採用されており、画像をパッチ単位で処理して視覚的表現を構築します。ここで極めて重要なのは、この段階でOCRモジュールが一切介在しない点です。テキスト領域を検出してから読み取るのではなく、犬の写真を分類するビジョンモデルと同じように、画像全体の視覚的な理解を構築しているに過ぎません。
デコーダーはBARTスタイルのテキストTransformerで、エンコーダーが作成した視覚的表現を受け取り、言語モデルが単語を一つずつ生成するように、トークンを一つずつ生成します。ここでの最大の工夫は、「何を生成させるか」にあります。Donutは単に目に見えるテキストを書き起こすのではなく、タスクの回答を直接的に表現する構造化されたシーケンス(実質的にフラット化されたJSONのような形式)を出力するように学習されています。例えばレシートの場合、店名、商品リスト、合計金額などが、学習過程で習得した特殊トークンのシーケンスとして出力されます。「検出したテキストはこれです」という中間ステップは存在しません。ピクセルが入力され、構造化されたフィールドが出力されるという仕組みです。
このようなモデルをゼロから学習させるには膨大な量のラベル付きドキュメントデータが必要ですが、現実的にそれほどの量は存在しません。そこで著者らは、SynthDoG (Synthetic Document Generator) という合成データ生成ツールを構築しました。これは背景画像、サンプリングされたテキスト、レイアウトテンプレートを組み合わせることで、正解データ付きのリアルなドキュメントを多言語で生成するものです。これにより、数百万件の合成ドキュメントでDonutを事前学習させ、その後、特定のタスク向けに小規模な実データセットでファインチューニングすることが可能になりました。また、この手法によって、従来のOCRエンジンが抱えていた「言語への柔軟性の欠如」という問題も解決しています。新しい言語で合成ドキュメントを生成すれば、OCRの再学習を行うことなく、その言語の学習データを確保できるからです。
Left Behind — MStewartPhotography による作品、flickr 経由、CC BY 2.0。
数値が示す実際の結果
主要な結果は、「ドキュメント分類」、「情報抽出」、「視覚的質問応答(VQA)」という3つのタスクから得られています。
RVL-CDIPデータセット(手紙、フォーム、請求書など16カテゴリーにわたる40万枚のスキャン文書で構成される標準的なベンチマーク)において、Donutは95.30%の分類精度を達成しました。これはOCRベースのベースラインと同等かそれ以上の性能であり、かつOCR工程を完全にスキップするため、推論時の実行速度が著しく向上しています。
「OCR不要」というアプローチのメリットが最も顕著に現れたのが、情報抽出の結果です。メニュー項目、価格、合計金額などのフィールドを含むインドネシアのレシートの公開ベンチマークであるCORDにおいて、DonutはF1スコア91.6を記録しました。これは、同じドキュメント理解アーキテクチャを使用しながら外部OCRエンジンの出力に依存していたOCRベースのベースラインを上回る数値です。また、本論文のために構築された日本の名刺データセットにおいても、歴史的にOCRエンジンが英語に比べて性能が低いとされる日本語であるにもかかわらず、Donutは同様にOCRパイプラインのベースラインを上回る成果を上げました。
そして、もう一つの重要なポイントが速度です。これは単なる補足事項ではありません。Donutは個別のOCR処理を行わないため、特にOCR自体がパイプラインの中で最も時間を要することが多い高解像度のドキュメント画像において、同等の2ステージシステムよりも推論速度が大幅に向上します。論文によると、Donutは比較対象となったOCRベースのベースラインの約半分の時間でドキュメントを処理しており、これは単発のデモではなく、実運用レベルの大規模な処理を行う場合に極めて重要な意味を持ちます。
限界点:小さな文字、複雑なレイアウト、そして学習データへの飢餓感
本論文はOCRが完全に不要になったと主張しているわけではなく、正直なところ、その限界についても触れる価値があります。
第一に、Donutは依然として高解像度における高密度で小さなテキストの処理に苦戦します。Vision Transformerの入力解像度が固定されているため、モデルが識別できる詳細度には上限があります。8ポイントのフォントで埋め尽くされたページのようなケースでは、小さな文字の識別を専門に設計された専用のOCRエンジンとは異なり、この上限に突き当たってしまいます。
第二に、モデルが真に実用的な精度を出すには、タスク固有のファインチューニングが必要です。事前学習によって「ドキュメント」というものを一般的に理解するモデルは得られますが、特定のドキュメント形式から正しいフィールドを抽出するには、依然としてその形式のラベル付きデータが必要です。これはドキュメントAIにおいては珍しいことではありませんが、「新しいドキュメント形式に適用するだけで即座に動作する」という話には、注釈が必要であることを意味します。
第三に、構造的な問題があります。Donutは出力をフラットなシーケンスとして生成します。生成タスクは本質的に、ルールベースの後処理で明らかな形式エラーを検知できる設計済みの抽出パイプラインよりも、完全な信頼性を確保することが困難です。Donutが誤ったとき、一見正しそうに見える構造化データを出力することがあり、正気判定(サニティチェック)に利用できるOCRの信頼度スコアやバウンディングボックスも存在しません。これが中間表現をスキップしたことの代償であり、中間表現が提供していた解釈可能性も同時に失われることになります。
OCRを自社開発または導入する際に重要な理由
ドキュメント処理パイプラインを構築する人々にとって、Donutがもたらした真の貢献は「OCRエンジンを捨てろ」ということではありません。むしろ、エンドツーエンドのOCRレスモデルが、ドキュメント理解タスクの相当な範囲において有効であるという証拠を示したことです。特に、レシートやフォーム、名刺のようにレイアウトが予測可能なドキュメントからの構造化抽出においてその傾向が顕著です。ただし、本手法は主に英語圏のデータに基づいているため、日本語特有の縦書きレイアウトや複雑な漢字の認識への対応については別途検討が必要です。
現在、OCRと理解モデルを組み合わせたパイプラインを利用している場合、いくつか実用的な確認事項があります。ダウンストリームのモデルに本当に文字起こしされたテキストが必要なのか、あるいは特定の抽出タスクにおいては画像から直接処理した方が同等かそれ以上の精度が出るのではないか。また、現在の処理量においてOCRのレイテンシが実際にボトルネックとなっており、エンドツーエンドモデルの速度面でのメリットが製品価値に影響するか。そして決定的な点として、現在のパイプラインにOCRエラーが伝播する前にそれを検出し修正する手段があるのか、それともOCRエンジンが出力した結果を盲信しているだけではないか、ということです。
コード、学習済み重み、そしてSynthDoGジェネレーターと共にリリースされたDonutは、オープンソースのドキュメントAIエコシステムにおける重要な構成要素となりました。その後のモデル(科学論文PDF向けのNougatなど)も、「ピクセルから直接構造化トークンを生成する」というアプローチを継承しています。この論文が提示したより大きな概念は、ドキュメント理解においてOCRは「自然界の法則」ではなく、あくまで一つの「設計上の選択肢」であるということです。特にレイアウトが一貫しており、フィールドタイプが既知であるドキュメント群においては、OCRを完全にスキップすることが、結果としてより高速で高精度な手法になり得ます。
とはいえ、これが万能な代替手段になるわけではありません。大規模に、かつ予測不可能な高密度のテキストを扱う場合は、依然として強力なOCRエンジンと優れた抽出モデルを組み合わせる方が安全な選択です。Donutから得られる教訓は「OCRは死んだ」ということではなく、「目の前のタスクに本当にOCRが必要かどうかを確認せよ」ということです。これは、多くの論文が提示する結論よりも、実務において遥かに有用な問いであると言えます。