Donut يتجاوز الـ OCR تماماً، ومع ذلك لا يزال يقرأ إيصالاتك
استنادًا إلى: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
تخيل ماسحاً ضوئياً للفواتير لا يستخدم الـ OCR على الإطلاق
تخيل نظاماً لا يحتاج إلى صناديق لتحديد النصوص، ولا إلى خطوة للتعرف على الحروف، ولا إلى نموذج منفصل مضاف لتحليل ما أخرجه محرك الـ OCR. كل ما عليك فعله هو تزويده بصورة لفاتورة مجعدة، ليقوم هو بإخراج بيانات JSON مهيكلة: اسم التاجر، التاريخ، بنود الفاتورة، والمجموع الكلي. قد يبدو الأمر وكأنه يتجاوز خطوة ضرورية، ولكن وفقاً لورقة بحثية صدرت عام 2021 عن شركة NAVER (الشركة المطورة لمحرك البحث المهيمن في كوريا الجنوبية)، فإن تخطي هذه الخطوة هو بالضبط ما جعل النموذج أسرع، وفي عدة اختبارات قياسية (benchmarks)، أكثر دقة من سلاسل المعالجة التي تستخدم الـ OCR بشكل تقليدي.
يُطلق على هذا النموذج اسم Donut، وهو اختصار لـ Document Understanding Transformer. الاسم هنا يعد اختصاراً أذكى مما تنجح معظم الأوراق البحثية في ابتكاره، أما الفكرة الكامنة وراءه فهي غير بديهية حقاً؛ فالمنهج القياسي لقراءة المستندات يعتمد على تشغيل الـ OCR أولاً والتعامل مع النص المستخرج كحقيقة مطلقة (ground truth) لكل العمليات اللاحقة. أما Donut فيتخلص من هذا الافتراض، ويطلب من الـ transformer الانتقال مباشرة من البكسلات (pixels) إلى المخرجات المهيكلة.
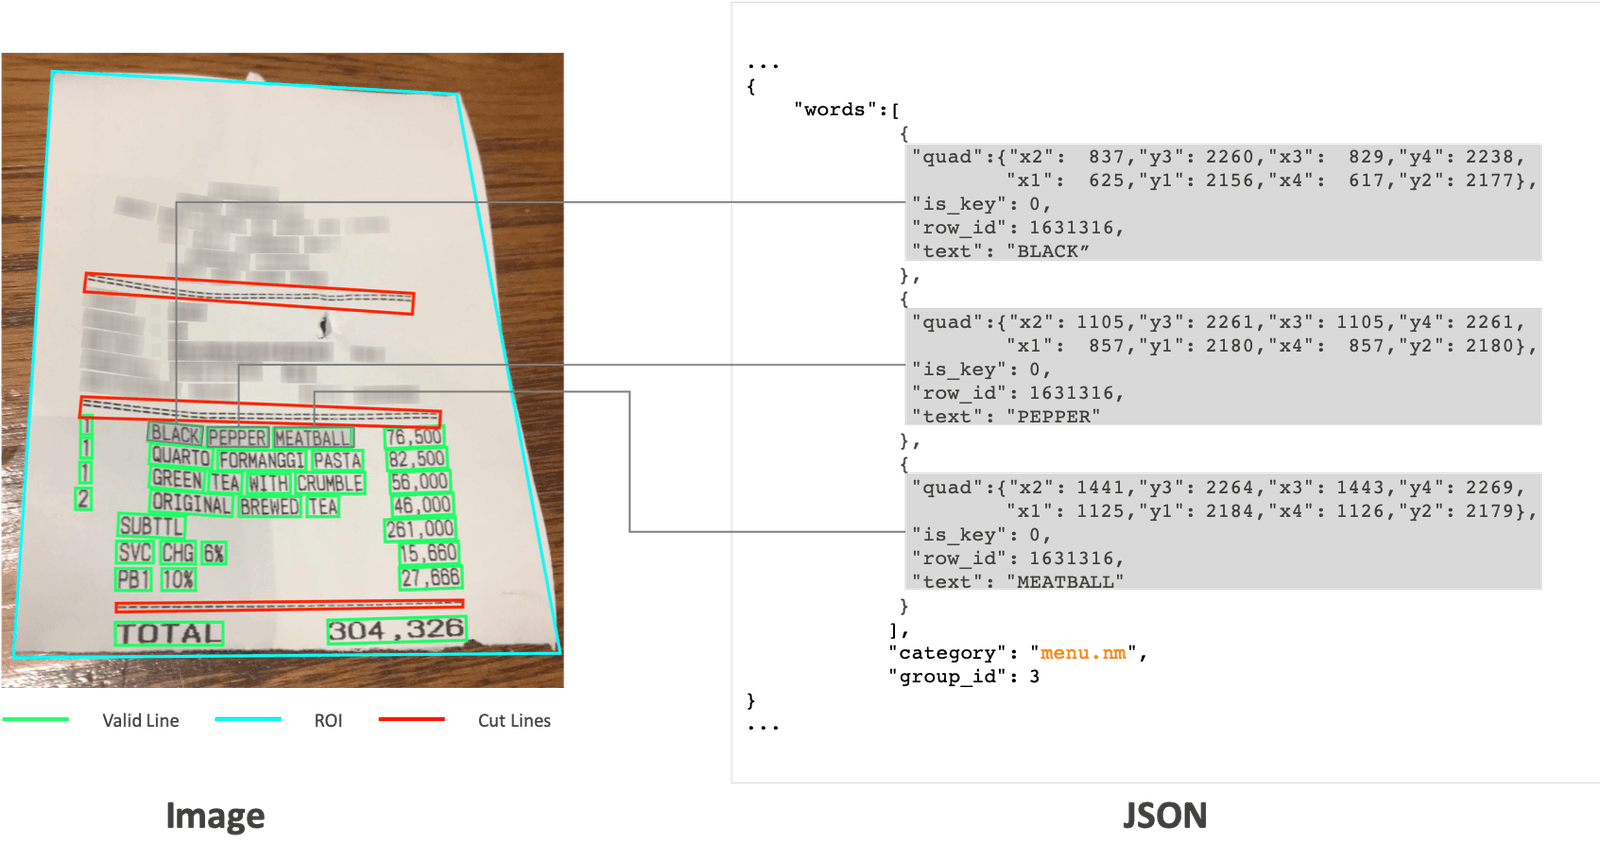
عينة من CORD receipt dataset (Park et al., Clova AI / NAVER)، مرخصة بموجب CC BY 4.0.
لماذا تبين أن خطة "تشغيل OCR أولاً" هي الخيار الخاطئ
حتى وقت قريب، كانت جميع أنظمة فهم المستندات المرئية تتبع نفس الوصفة المكونة من مرحلتين. الخطوة الأولى: تشغيل محرك OCR (مثل Tesseract، أو واجهة برمجة تطبيقات تجارية مثل Amazon Textract أو Google Vision) لتحويل الصورة إلى نص مع صناديق إحاطة (bounding boxes). الخطوة الثانية: تغذية هذا النص في نموذج ثانٍ يتولى عملية الفهم الفعلية، سواء باستخراج الحقول، أو الإجابة على الأسئلة، أو تصنيف نوع المستند.
هذا النهج فعال، ولهذا السبب ظلت الأنظمة القائمة على OCR هي الخيار الافتراضي لسنوات. لكن مؤلفي الورقة البحثية يشيرون إلى ثلاث مشكلات متأصلة في هذا التصميم:
- التكلفة. إن تشغيل محرك OCR ثقيل على كل مستند، خاصة عند العمل على نطاق واسع، يعد مكلفاً من حيث القوة الحوسبية وزمن الاستجابة (latency). فأنت تدفع ثمن عملية تعرّف كاملة قبل أن يبدأ نموذجك "الحقيقي" في العمل.
- عدم المرونة. يتم ضبط محركات OCR الجاهزة للغات وأنواع مستندات محددة. فإذا وجهت أحدها نحو إيصال باللغة الكورية أو بطاقة عمل يابانية ذات تنسيق كثيف، فقد تنهار الدقة بشكل حاد. كما أن إعادة تدريب أو ضبط محرك OCR للغة جديدة يعد مشروعاً قائماً بذاته.
- انتشار الأخطاء (Error propagation). هذه هي المشكلة التي تظهر آثارها السلبية فعلياً في الممارسة العملية. فإذا أخطأ OCR وقرأ الرقم "3" على أنه "8" في إجمالي فاتورة ما، فإن كل خطوة لاحقة سترث هذا الخطأ دون وجود أي وسيلة لتصحيحه. إن نموذج الفهم لا يرى البكسلات الأصلية أبداً، بل يثق ببساطة في كل ما سلمه إياه محرك OCR، بما في ذلك الأخطاء.
تستحق النقطة الثالثة تأملاً عميقاً، لأن هذا النوع من الفشل يظل غير مرئي حتى يتسبب في خسائر مالية لشخص ما. يمكن أن يكون خط الإنتاج المكون من مرحلتين مضبوطاً بدقة في كل مرحلة على حدة، ومع ذلك يفشل ككل؛ لأن عملية التسليم بين المراحل تتسبب في فقدان معلومات (مثل السياق المرئي، والتنسيق، وخصائص الخط) التي كان من شأنها أن تساعد في اكتشاف الخطأ وتصحيحه.
كيف يعمل Donut فعلياً: نموذج واحد، من البكسلات إلى النصوص مباشرة
تتميز بنية Donut ببساطة شديدة، وهو أمر اعتبره المؤلفون ميزة أساسية وليس مجرد سهو. يعتمد النموذج على بنية encoder-decoder transformer، وهو نفس الشكل العام المستخدم في العديد من نماذج sequence-to-sequence.
يعمل الـ encoder كـ Swin Transformer، وهو نموذج رؤية حاسوبية يعالج الصورة على شكل رقع (patches) ليبني تمثيلاً بصرياً لها. والنقطة الجوهرية هنا هي عدم وجود أي وحدة OCR في هذه المرحلة؛ فالنموذج لا يقوم بتحديد مناطق النصوص ثم قراءتها، بل يبني فهماً بصرياً عاماً للصورة بأكملها، تماماً كما يفعل نموذج الرؤية المصمم لتصنيف صور الكلاب مثلاً.
أما الـ decoder فهو نصي من طراز BART-style transformer، يأخذ ذلك التمثيل البصري ويقوم بتوليد المخرجات رمزاً تلو الآخر (token by token)، بنفس الطريقة التي يولد بها النموذج اللغوي النصوص كلمة بكلمة. تكمن الحيلة الأساسية في "ما" يقوم بتوليده؛ فبدلاً من مجرد نسخ النصوص التي يراها، تم تدريب Donut على إخراج تسلسل مهيكل، وهو أساساً تنسيق مسطح يشبه JSON، يمثل مباشرة الإجابة على المهمة المطلوبة. ففي حالة الإيصالات، يعني هذا استخراج اسم التاجر، وقائمة العناصر، والمجموع الكلي، منسقة كسلسلة من الرموز الخاصة (special tokens) التي تعلم النموذج إنتاجها أثناء التدريب. لا توجد خطوة وسيطة تقول "إليك النص الذي اكتشفته"، بل تدخل البكسلات وتخرج الحقول المهيكلة.
يتطلب تدريب نموذج للقيام بذلك من الصفر كمية هائلة من بيانات المستندات المصنفة، وهي غير متوفرة بالكميات المطلوبة. لذا، قام المؤلفون ببناء مولد بيانات اصطناعية يسمى SynthDoG (Synthetic Document Generator)، يقوم بإنتاج مستندات تبدو واقعية مع بيانات مرجعية (ground truth) مقابلة لها بلغات متعددة، وذلك عبر دمج صور خلفيات، ونصوص عشوائية، وقوالب تخطيط (layout templates). أتاح لهم ذلك تدريب Donut مسبقاً (pretrain) على ملايين المستندات الاصطناعية قبل إجراء الضبط الدقيق (fine-tuning) على مجموعات بيانات حقيقية أصغر لمهام محددة. وهذه هي الطريقة التي تجاوزوا بها مشكلة عدم المرونة اللغوية التي تعاني منها محركات OCR؛ فبمجرد توليد مستندات اصطناعية بلغة جديدة، ستحصل على بيانات تدريب لتلك اللغة دون الحاجة لإعادة تدريب نظام الـ OCR.
تاركين خلفاً — بواسطة MStewartPhotography عبر flickr، BY 2.0.
ماذا تظهر الأرقام فعلياً
تأتي النتائج الرئيسية من ثلاثة أنواع من المهام: تصنيف المستندات، واستخراج المعلومات، والإجابة على الأسئلة المرئية (visual question answering).
في مجموعة بيانات RVL-CDIP (وهي معيار قياسي يضم 400,000 مستند ممسوح ضوئياً موزعة على 16 فئة، مثل الرسائل والنماذج والفواتير)، حقق Donut دقة تصنيف بلغت 95.30%. وتعد هذه النتيجة منافسة أو حتى أفضل من النماذج المرجعية المعتمدة على OCR، وقد وصل إلى ذلك مع سرعة ملحوظة في وقت الاستنتاج (inference time)، نظراً لتجاوزه مرحلة الـ OCR بالكامل.
أما نتائج استخراج المعلومات فهي المكان الذي ظهرت فيه ثمار الرهان على استراتيجية "بدون OCR" بشكل جلي. ففي مجموعة CORD، وهي معيار عام لإيصالات إندونيسية تحتوي على حقول مثل عناصر القائمة والأسعار والمجاميع، سجل Donut درجة 91.6 F1، متفوقاً على النماذج المرجعية المعتمدة على OCR والتي استخدمت نفس بنية فهم المستندات الأساسية ولكنها اعتمدت على مخرجات محرك OCR خارجي كمدخلات. وبالمثل، تفوق Donut على النماذج المرجعية التي تعتمد على مسار (pipeline) الـ OCR في مجموعة بيانات لبطاقات عمل يابانية تم إعدادها خصيصاً للورقة البحثية، رغم أن اللغة اليابانية من اللغات التي تعاني فيها محركات OCR تاريخياً من ضعف الأداء مقارنة بالإنجليزية.
السرعة هي الشق الآخر من القصة، وهي ليست مجرد تفصيل هامشي. وبما أن Donut لا يقوم بتشغيل مرحلة OCR منفصلة، فإن عملية الاستنتاج تكون أسرع بشكل ملموس من الأنظمة المماثلة ذات المرحلتين، خاصة في صور المستندات عالية الدقة حيث يكون الـ OCR نفسه غالباً هو الجزء الأبطأ في مسار العمل. وتشير الورقة البحثية إلى أن Donut يعالج المستندات في نصف الوقت الذي تستغرقه النماذج المرجعية المعتمدة على OCR التي تمت مقارنته بها، وهو أمر بالغ الأهمية إذا كنت تشغل هذا النظام على نطاق واسع بدلاً من مجرد عرضه كنموذج تجريبي بسيط.
نقاط الضعف: النصوص الصغيرة، التنسيقات الغريبة، والاحتياج الشديد لبيانات التدريب
هذه الورقة البحثية لا تدعي أن تقنية OCR قد أصبحت من الماضي، ومن المهم بكل صراحة تسمية القيود الموجودة.
أولاً، لا يزال Donut يعاني مع النصوص الصغيرة والكثيفة ذات الدقة العالية. وبما أن دقة الإدخال في الـ vision transformer ثابتة، فهذا يعني وجود سقف محدد لمقدار التفاصيل الدقيقة التي يمكن للنموذج تحليلها؛ لذا فإن الصفحة المزدحمة بخط حجم 8 نقطة تضغط على هذا السقف بطريقة لا تفعلها محركات OCR المتخصصة، والمصممة خصيصاً لتحليل الرموز الصغيرة.
ثانياً، يحتاج النموذج إلى عملية fine-tuning مخصصة لكل مهمة ليكون فعالاً حقاً. تمنحك مرحلة الـ Pretraining نموذجاً يفهم "المستندات" بشكل عام، ولكن استخراج الحقول الصحيحة من نوع معين من المستندات لا يزال يتطلب أمثلة مصنفة (labeled examples) من ذلك النوع. هذا الأمر ليس غريباً في مجال ذكاء المستندات (document AI)، ولكنه يعني أن مقولة "وجه النموذج نحو نوع مستند جديد وسيعمل مباشرة" مشروطة بوجود بيانات تدريب.
ثالثاً، وهي نقطة هيكلية: يقوم Donut بتوليد المخرجات كسلسلة مسطحة (flattened sequence)، وعملية التوليد بطبيعتها أصعب في جعلها موثوقة تماماً مقارنة بمسار استخراج (extraction pipeline) مصمم جيداً، حيث يمكن لخطوة معالجة لاحقة تعتمد على القواعد (rule-based post-processing) أن تكتشف المخرجات المشوهة بوضوح. عندما يخطئ Donut، قد ينتج مخرجات مهيكلة تبدو منطقية ولكنها خاطئة، ولا يوجد score ثقة لعملية OCR أو bounding box يمكن الرجوع إليهما للتحقق من صحة البيانات. هذا هو الوجه الآخر لتخطي التمثيل الوسيط (intermediate representation)؛ فبجانب التبسيط، تفقد أيضاً القدرة على التفسير (interpretability) التي كان يوفرها ذلك التمثيل.
لماذا يهم هذا الأمر سواء كنت تقوم ببناء نظام OCR أو شرائه
بالنسبة لكل من يعمل على بناء مسارات معالجة المستندات، فإن المساهمة الحقيقية لنموذج Donut ليست في دعوته لـ "حذف محرك OCR الخاص بك"، بل في تقديم دليل على أن النماذج الشاملة (end-to-end) والخالية من OCR هي خيار قابل للتطبيق في جزء كبير من مهام فهم المستندات، خاصة عمليات الاستخراج المهيكلة من المستندات ذات التنسيقات المتوقعة، مثل الإيصالات والنماذج وبطاقات العمل.
إذا كنت تعتمد حالياً على مسار عمل يدمج بين OCR والفهم (OCR-and-understanding pipeline)، فإن هذا يطرح عدة نقاط عملية تستحق المراجعة. هل يحتاج نموذجك اللاحق فعلياً إلى نص منسوخ، أم أنه سيؤدي المهمة بنفس الكفاءة (أو أفضل) من خلال العمل على الصورة مباشرة في مهمة الاستخراج المحددة؟ هل يمثل زمن استجابة (latency) الـ OCR عنق زجاجة فعلياً في حجم بياناتك، وهل ستشكل ميزة السرعة في النماذج الشاملة فارقاً لمنتجك؟ والأهم من ذلك، هل يمتلك مسار عملك الحالي أي وسيلة لرصد وتصحيح أخطاء OCR قبل انتقالها، أم أنك تثق بصمت في كل ما يقدمه لك محرك OCR؟ وتزداد هذه التحديات تعقيداً عند التعامل مع النصوص العربية، حيث تفرض طبيعة الخط المتصل (cursive) والحروف المتغيرة حسب موقعها في الكلمة صعوبات إضافية تجعل الـ OCR أكثر تعقيداً.
لقد أصبح Donut، الذي أُصدر مع الكود البرمجي والأوزان المدربة ومولد SynthDoG، حجر زاوية حقيقي في منظومة ذكاء المستندات مفتوحة المصدر، كما استعارت نماذج لاحقة (مثل Nougat لملفات PDF العلمية) نهجه القائم على "توليد رموز مهيكلة مباشرة من البكسلات". الفكرة الأكبر التي تطرحها الورقة البحثية هي أن الـ OCR ليس قانوناً طبيعياً لا يمكن تجاوزه لفهم المستندات، بل هو خيار تصميمي؛ وبالنسبة لفئة كبيرة من المستندات، خاصة تلك ذات التنسيقات المتسقة وأنواع الحقول المعروفة، فإن تخطيه تماماً قد يكون أسرع وأكثر دقة من محاولة تنفيذه بإتقان.
ومع ذلك، لا يعد هذا بديلاً شاملاً. فإذا كنت تتعامل مع نصوص كثيفة وغير متوقعة على نطاق واسع، فإن الاعتماد على محرك OCR قوي مقترن بنموذج استخراج جيد لا يزال هو الرهان الأكثر أماناً اليوم. الدرس المستفاد من Donut ليس أن "الـ OCR قد انتهى"، بل هو "تحقق مما إذا كنت تحتاجه فعلاً للمهمة التي بين يديك"، وهو سؤال أكثر فائدة مما تتركه معظم الأوراق البحثية في أذهان القراء.