Donut OCR को पूरी तरह से छोड़ देता है, और फिर भी यह आपकी रसीदें पढ़ लेता है
आधारित शोध-पत्र: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
एक ऐसे रसीद स्कैनर की कल्पना करें जो कभी OCR का उपयोग नहीं करता।
कोई टेक्स्ट डिटेक्शन बॉक्स नहीं, कोई कैरेक्टर रिकग्निशन स्टेप नहीं, और न ही OCR इंजन द्वारा निकाले गए टेक्स्ट को समझने के लिए अलग से जोड़ा गया कोई मॉडल। आप इसे एक मुड़ी-तुड़ी रसीद की फोटो देते हैं और यह सीधे स्ट्रक्चर्ड JSON आउटपुट देता है: मर्चेंट का नाम, तारीख, लाइन आइटम्स और कुल राशि। सुनने में ऐसा लगता है जैसे यह किसी ज़रूरी स्टेप को छोड़ रहा है। लेकिन NAVER (दक्षिण कोरिया के प्रमुख सर्च इंजन के पीछे की कंपनी) के 2021 के एक पेपर के अनुसार, इस स्टेप को छोड़ना ही वह वजह थी जिसने मॉडल को तेज़ बनाया और कई benchmarks में इसे उन पाइपलाइन्स से अधिक सटीक साबित किया जो सही तरीके से OCR का उपयोग करती हैं।
इस मॉडल का नाम Donut है, जो Document Understanding Transformer का संक्षिप्त रूप है। इसका नाम ज़्यादातर रिसर्च पेपर्स के एक्रोनिम्स से बेहतर है, और इसके पीछे का विचार वास्तव में काफी अलग (counterintuitive) है: दस्तावेज़ों को पढ़ने का मानक तरीका पहले OCR चलाना होता है और पहचाने गए टेक्स्ट को आगे की सभी प्रक्रियाओं के लिए 'ग्राउंड ट्रुथ' (ground truth) माना जाता है। Donut इस धारणा को पूरी तरह खारिज कर देता है और एक transformer से सीधे पिक्सेल (pixels) से स्ट्रक्चर्ड आउटपुट तैयार करने के लिए कहता है।
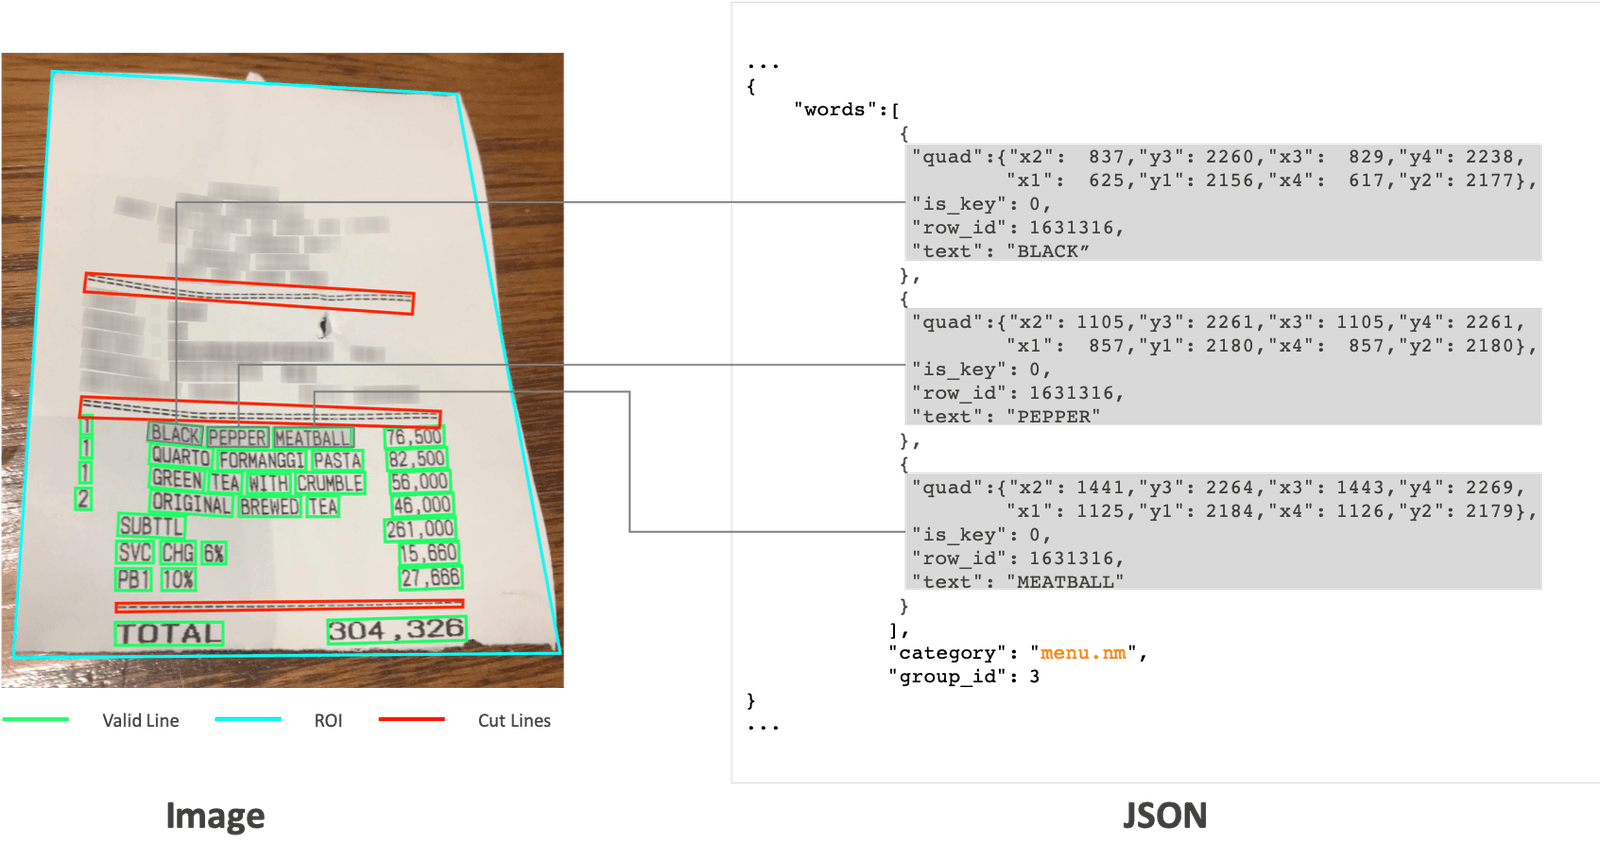
CORD receipt dataset (Park et al., Clova AI / NAVER) से नमूना, CC BY 4.0 के तहत लाइसेंस प्राप्त।
"पहले सिर्फ OCR चलाएं" वाली योजना गलत क्यों साबित होती है
हाल तक, हर विजुअल डॉक्यूमेंट अंडरस्टैंडिंग सिस्टम एक ही दो-चरणीय (two-stage) तरीके का पालन करता था। पहला कदम: इमेज को टेक्स्ट और bounding boxes में बदलने के लिए एक OCR इंजन (Tesseract, या Amazon Textract या Google Vision जैसे कमर्शियल API) चलाना। दूसरा कदम: उस टेक्स्ट को एक दूसरे मॉडल में डालना जो वास्तव में अंडरस्टैंडिंग का काम करता है, जैसे कि fields को एक्सट्रैक्ट करना, सवालों के जवाब देना, या डॉक्यूमेंट टाइप को क्लासिफाई करना।
यह तरीका काम करता है, और यही कारण है कि सालों से OCR-आधारित सिस्टम ही डिफॉल्ट रहे हैं। लेकिन इस पेपर के लेखक इस डिज़ाइन में मौजूद तीन समस्याओं की ओर इशारा करते हैं:
- लागत (Cost): हर डॉक्यूमेंट पर एक भारी OCR इंजन चलाना, खासकर बड़े पैमाने पर, कंप्यूट और लेटेंसी (latency) दोनों के मामले में महंगा होता है। आपके "असली" मॉडल के शुरू होने से पहले ही आप एक पूरे रिकग्निशन पास के लिए भुगतान कर रहे होते हैं।
- लचीलेपन की कमी (Inflexibility): ऑफ-द-शेल्फ OCR इंजन विशिष्ट भाषाओं और डॉक्यूमेंट प्रकारों के लिए ट्यून किए जाते हैं। यदि आप इन्हें कोरियन रसीद या घने फॉर्मेट वाले जापानी बिजनेस कार्ड पर इस्तेमाल करते हैं, तो सटीकता (accuracy) तेजी से गिर सकती है। किसी नई भाषा के लिए OCR इंजन को रिट्रेन या फाइन-ट्यून करना अपने आप में एक बड़ा प्रोजेक्ट है।
- त्रुटियों का प्रसार (Error propagation): यह वह समस्या है जो वास्तव में व्यावहारिक रूप से नुकसान पहुँचाती है। यदि OCR किसी इनवॉइस टोटल में "3" को "8" पढ़ लेता है, तो उसके बाद का हर स्टेप उस गलती को अपना लेता है और उसे सुधारने का कोई तरीका नहीं बचता। अंडरस्टैंडिंग मॉडल कभी मूल पिक्सेल (original pixels) को देखता ही नहीं है। वह बस उस चीज़ पर भरोसा करता है जो OCR इंजन ने उसे सौंपी है, गलतियों सहित।
तीसरे बिंदु पर गहराई से विचार करना जरूरी है, क्योंकि यह उस तरह की विफलता है जो तब तक अदृश्य रहती है जब तक कि इसकी वजह से किसी का आर्थिक नुकसान न हो जाए। एक टू-स्टेज पाइपलाइन के हर चरण को व्यक्तिगत रूप से अच्छी तरह ट्यून किया जा सकता है, फिर भी वह समग्र रूप से विफल हो सकती है, क्योंकि चरणों के बीच का हैंडऑफ उस जानकारी (विजुअल कॉन्टेक्स्ट, लेआउट, फॉन्ट विशेषताएं) को हटा देता है जो गलती को पकड़ने में मदद कर सकती थी।
Donut वास्तव में कैसे काम करता है: एक मॉडल, सीधे पिक्सेल से टेक्स्ट तक
Donut का आर्किटेक्चर बेहद सरल है, जिसे इसके लेखकों ने एक कमी के बजाय एक विशेषता (feature) के रूप में पेश किया है। यह एक encoder-decoder transformer है, जिसका सामान्य ढांचा कई sequence-to-sequence मॉडल्स जैसा ही है।
इसका encoder एक Swin Transformer है, जो एक विजन मॉडल है। यह इमेज को पैच (patches) में प्रोसेस करता है और एक विजुअल रिप्रेजेंटेशन तैयार करता है। सबसे महत्वपूर्ण बात यह है कि इस चरण में कहीं भी कोई OCR मॉड्यूल नहीं है। यह टेक्स्ट क्षेत्रों को डिटेक्ट करके उन्हें नहीं पढ़ता, बल्कि पूरी इमेज की एक सामान्य विजुअल समझ विकसित करता है, ठीक उसी तरह जैसे कुत्तों की तस्वीरों को क्लासिफाई करने वाला विजन मॉडल करता है।
इसका decoder एक BART-style टेक्स्ट ट्रांसफार्मर है, जो उस विजुअल रिप्रेजेंटेशन को लेता है और टोकन-दर-टोकन आउटपुट जेनरेट करता है, ठीक वैसे ही जैसे एक लैंग्वेज मॉडल एक-एक शब्द करके टेक्स्ट जेनरेट करता है। यहाँ मुख्य ट्रिक यह है कि यह क्या जेनरेट करता है। केवल टेक्स्ट को ट्रांसक्राइब करने के बजाय, Donut को एक स्ट्रक्चर्ड सीक्वेंस (मूल रूप से एक फ्लैट JSON-जैसा फॉर्मेट) आउटपुट करने के लिए ट्रेन किया गया है, जो सीधे तौर पर दिए गए टास्क के उत्तर को दर्शाता है। उदाहरण के लिए, एक रसीद (receipt) के मामले में, इसका मतलब है मर्चेंट का नाम, आइटम की लिस्ट और कुल राशि, जिन्हें उन स्पेशल टोकन्स के सीक्वेंस के रूप में फॉर्मेट किया जाता है जिन्हें मॉडल ने ट्रेनिंग के दौरान सीखा था। इसमें "यहाँ वह टेक्स्ट है जिसे मैंने डिटेक्ट किया" जैसा कोई इंटरमीडिएट स्टेप नहीं होता। पिक्सेल अंदर जाते हैं और स्ट्रक्चर्ड फील्ड्स बाहर आते हैं।
किसी मॉडल को शुरू से ऐसा करने के लिए ट्रेन करने के लिए भारी मात्रा में लेबल किए गए डॉक्यूमेंट डेटा की आवश्यकता होती है, जो जरूरी मात्रा में उपलब्ध नहीं है। इसलिए, लेखकों ने SynthDoG (Synthetic Document Generator) नामक एक सिंथेटिक डेटा जेनरेटर बनाया। यह बैकग्राउंड इमेज, सैंपल्ड टेक्स्ट और लेआउट टेम्पलेट्स को मिलाकर कई भाषाओं में ग्राउंड ट्रुथ के साथ वास्तविक दिखने वाले डॉक्यूमेंट्स तैयार करता है। इसने उन्हें विशिष्ट टास्क के लिए छोटे रियल डेटासेट्स पर फाइन-ट्यून करने से पहले लाखों सिंथेटिक डॉक्यूमेंट्स पर Donut को प्री-ट्रेन करने की सुविधा दी। इसी तरह उन्होंने उस भाषा-अपरिवर्तनीयता (language-inflexibility) की समस्या को भी हल किया जो अक्सर OCR इंजनों में देखी जाती है। बस एक नई भाषा में सिंथेटिक डॉक्यूमेंट्स जेनरेट करें और आपके पास उस भाषा के लिए ट्रेनिंग डेटा तैयार है, बिना किसी OCR री-ट्रेनिंग के।
Left Behind — MStewartPhotography द्वारा flickr के माध्यम से, BY 2.0.
आंकड़े वास्तव में क्या दर्शाते हैं
मुख्य परिणाम तीन प्रकार के कार्यों से आए हैं: document classification, information extraction, और visual question answering।
RVL-CDIP dataset (16 श्रेणियों, जैसे पत्र, फॉर्म और इनवॉइस के 400,000 स्कैन किए गए दस्तावेज़ों का एक मानक बेंचमार्क) पर, Donut ने 95.30% classification accuracy हासिल की। यह OCR-आधारित baselines के बराबर या उनसे बेहतर है, और यह inference time पर काफी तेज़ रहा क्योंकि यह OCR pass को पूरी तरह से छोड़ देता है।
Information extraction के परिणाम वह जगह हैं जहाँ "no OCR" का दांव सबसे स्पष्ट रूप से सफल होता है। CORD पर, जो मेनू आइटम, कीमतों और कुल योग जैसे फ़ील्ड्स वाले इंडोनेशियाई रसीदों का एक सार्वजनिक बेंचमार्क है, Donut ने 91.6 F1 स्कोर किया। इसने उन OCR-आधारित baselines को पीछे छोड़ दिया जिन्होंने समान document understanding architecture का उपयोग किया था लेकिन इनपुट के रूप में एक बाहरी OCR engine के आउटपुट पर निर्भर थे। इस पेपर के लिए बनाए गए एक जापानी बिजनेस कार्ड डेटासेट पर भी Donut ने OCR-pipeline baselines से बेहतर प्रदर्शन किया, जबकि जापानी एक ऐसी भाषा है जहाँ OCR engines ऐतिहासिक रूप से अंग्रेजी की तुलना में कम प्रभावी रहे हैं।
रफ़्तार इस कहानी का दूसरा महत्वपूर्ण हिस्सा है, और यह कोई मामूली बात नहीं है। क्योंकि Donut एक अलग OCR pass नहीं चलाता है, इसलिए इसका inference एक तुलनीय two-stage system की तुलना में काफी तेज़ है, विशेष रूप से उच्च-रिज़ॉल्यूशन वाले दस्तावेज़ चित्रों के लिए जहाँ OCR अक्सर पाइपलाइन का सबसे धीमा हिस्सा होता है। पेपर के अनुसार, Donut ने उन OCR-आधारित baselines की तुलना में दस्तावेज़ों को लगभग आधे समय में प्रोसेस किया, जो कि तब बहुत मायने रखता है जब आप इसे किसी एक डेमो के बजाय बड़े पैमाने (real volume) पर चला रहे हों।
जहाँ यह विफल होता है: छोटा टेक्स्ट, अजीब लेआउट और ट्रेनिंग डेटा की भारी ज़रूरत
यह कोई ऐसा पेपर नहीं है जो यह दावा करे कि OCR अब पुराना हो चुका है, और इसकी वास्तविक सीमाओं को बताना ज़रूरी है।
पहला, Donut अभी भी हाई रिज़ॉल्यूशन पर घने और छोटे टेक्स्ट के साथ संघर्ष करता है। विज़न ट्रांसफॉर्मर (vision transformer) के लिए फिक्स्ड इनपुट रिज़ॉल्यूशन का मतलब है कि मॉडल कितनी बारीकी से विवरण देख सकता है, उसकी एक सीमा है। 8-पॉइंट फ़ॉन्ट से भरा हुआ पेज उस सीमा को इस तरह चुनौती देता है, जैसा कि एक समर्पित OCR इंजन (जो विशेष रूप से छोटे ग्लिफ़्स को पहचानने के लिए बनाया गया है) नहीं करता।
दूसरा, किसी भी काम में वास्तव में कुशल होने के लिए मॉडल को टास्क-स्पेसिफिक फाइन-ट्यूनिंग की आवश्यकता होती है। प्रीट्रेनिंग से आपको एक ऐसा मॉडल मिलता है जो सामान्य तौर पर "दस्तावेजों" (documents) को समझता है, लेकिन किसी विशिष्ट दस्तावेज़ प्रकार से सही फ़ील्ड्स निकालने के लिए अभी भी उस दस्तावेज़ प्रकार के लेबल्ड उदाहरणों की आवश्यकता होती है। डॉक्यूमेंट AI के लिए यह असामान्य नहीं है, लेकिन इसका मतलब यह है कि "बस इसे एक नए दस्तावेज़ प्रकार पर लागू करें और शुरू हो जाएं" वाली बात पूरी तरह सच नहीं है।
तीसरा, और यह संरचनात्मक (structural) है: Donut आउटपुट को एक फ्लैटेड सीक्वेंस (flattened sequence) के रूप में जेनरेट करता है, और जनरेशन को पूरी तरह विश्वसनीय बनाना स्वाभाविक रूप से कठिन होता है, बजाय एक अच्छी तरह से डिज़ाइन किए गए एक्सट्रैक्शन पाइपलाइन के जहाँ रूल-बेस्ड पोस्ट-प्रोसेसिंग स्टेप स्पष्ट रूप से गलत आउटपुट को पकड़ सकता है। जब Donut गलती करता है, तो वह ऐसा स्ट्रक्चर्ड आउटपुट दे सकता है जो दिखने में सही लगे लेकिन वास्तव में गलत हो, और सैनिटी चेक के लिए हमारे पास कोई OCR कॉन्फिडेंस स्कोर या बाउंडिंग बॉक्स नहीं होता। इंटरमीडिएट रिप्रेजेंटेशन (intermediate representation) को छोड़ने का यही दूसरा पहलू है: आप उस इंटरप्रिटेबिलिटी (interpretability) को भी खो देते हैं जो इंटरमीडिएट रिप्रेजेंटेशन प्रदान करता था।
यदि आप OCR बना रहे हैं या खरीद रहे हैं, तो यह क्यों महत्वपूर्ण है
डॉक्यूमेंट प्रोसेसिंग पाइपलाइन्स बनाने वाले किसी भी व्यक्ति के लिए, Donut का असली योगदान यह नहीं है कि "अपने OCR इंजन को हटा दें।" बल्कि यह इस बात का प्रमाण है कि end-to-end, OCR-free मॉडल्स डॉक्यूमेंट अंडरस्टैंडिंग के कई महत्वपूर्ण कार्यों के लिए व्यावहारिक हैं, खासकर रसीदों, फॉर्म्स और बिजनेस कार्ड्स जैसे प्रेडिक्टेबल लेआउट वाले डॉक्यूमेंट्स से structured extraction के लिए।
यदि आप आज एक OCR-and-understanding पाइपलाइन पर काम कर रहे हैं, तो यह कुछ व्यावहारिक बातों की जांच करने का सुझाव देता है। क्या आपके डाउनस्ट्रीम मॉडल को वास्तव में ट्रांसक्राइब किए गए टेक्स्ट की आवश्यकता है, या वह आपके विशिष्ट एक्सट्रैक्शन टास्क के लिए सीधे इमेज से काम करके उतना ही अच्छा (या बेहतर) परिणाम दे सकता है? क्या आपके वॉल्यूम पर OCR लेटेंसी वास्तव में एक बॉटलनेक है, और क्या एक end-to-end मॉडल का स्पीड एडवांटेज आपके प्रोडक्ट के लिए मायने रखेगा? और सबसे महत्वपूर्ण बात यह है कि क्या आपकी वर्तमान पाइपलाइन में OCR एरर्स को आगे बढ़ने से पहले पकड़ने और सुधारने का कोई तरीका है, या आप चुपचाप उस पर भरोसा कर रहे हैं जो OCR इंजन आपको दे रहा है? यहाँ यह ध्यान रखना ज़रूरी है कि एक मज़बूत English OCR का मतलब यह नहीं है कि वह Devanagari OCR में भी उतना ही सटीक होगा।
Donut, जिसे कोड, ट्रेंड वेट्स और SynthDoG जनरेटर के साथ रिलीज़ किया गया था, तब से ओपन-सोर्स डॉक्यूमेंट AI इकोसिस्टम में एक महत्वपूर्ण बिल्डिंग ब्लॉक बन गया है, और बाद के मॉडल्स (जैसे साइंटिफिक PDFs के लिए Nougat) ने इसके "generate structured tokens directly from pixels" अप्रोच को अपनाया। यह पेपर एक बड़ा विचार पेश करता है कि डॉक्यूमेंट अंडरस्टैंडिंग के लिए OCR कोई प्रकृति का नियम (law of nature) नहीं है। यह एक डिज़ाइन चॉइस है, और डॉक्यूमेंट्स की एक महत्वपूर्ण श्रेणी के लिए, विशेष रूप से वे जिनमें कंसिस्टेंट लेआउट और ज्ञात फील्ड टाइप्स होते हैं, इसे पूरी तरह से छोड़ना इसे अच्छी तरह से करने की तुलना में तेज़ और अधिक सटीक दोनों हो सकता है।
तथापि, यह कोई यूनिवर्सल रिप्लेसमेंट नहीं है। यदि आप बड़े पैमाने पर डेंस और अनप्रेडिक्टेबल टेक्स्ट के साथ काम कर रहे हैं, तो एक मज़बूत OCR इंजन और एक अच्छे एक्सट्रैक्शन मॉडल का कॉम्बिनेशन आज भी सुरक्षित विकल्प है। Donut से मिलने वाला सबक यह नहीं है कि "OCR खत्म हो गया है।" बल्कि यह है कि "जांचें कि क्या आपको वास्तव में अपने सामने वाले काम के लिए इसकी आवश्यकता है," जो कि अधिकांश पेपर्स द्वारा छोड़े गए सवालों की तुलना में अधिक उपयोगी है।