Donut 完全跳过了 OCR,但依然能读取你的收据
参考论文: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
想象一个从不运行 OCR 的收据扫描仪
没有文本检测框,没有字符识别步骤,也没有为了解析 OCR 引擎输出结果而额外挂载的独立模型。你只需向它输入一张揉皱的收据照片,它就能直接输出结构化的 JSON 数据:商家名称、日期、项目清单以及总额。这听起来像是跳过了必要的步骤。但根据 NAVER(韩国主导搜索引擎背后的公司)在 2021 年发表的一篇论文,跳过这一步恰恰让该模型运行得更快,且在多项基准测试中比那些正确使用 OCR 的流水线更准确。
这个模型被称为 Donut,即 Document Understanding Transformer 的缩写。这个名字比大多数论文的缩写要精妙得多,而其背后的核心理念确实反直觉:传统的文档读取方法是先运行 OCR,并将识别出的文本作为后续所有环节的基准真相(ground truth)。Donut 摒弃了这一假设,让 transformer 直接从像素映射到结构化输出。
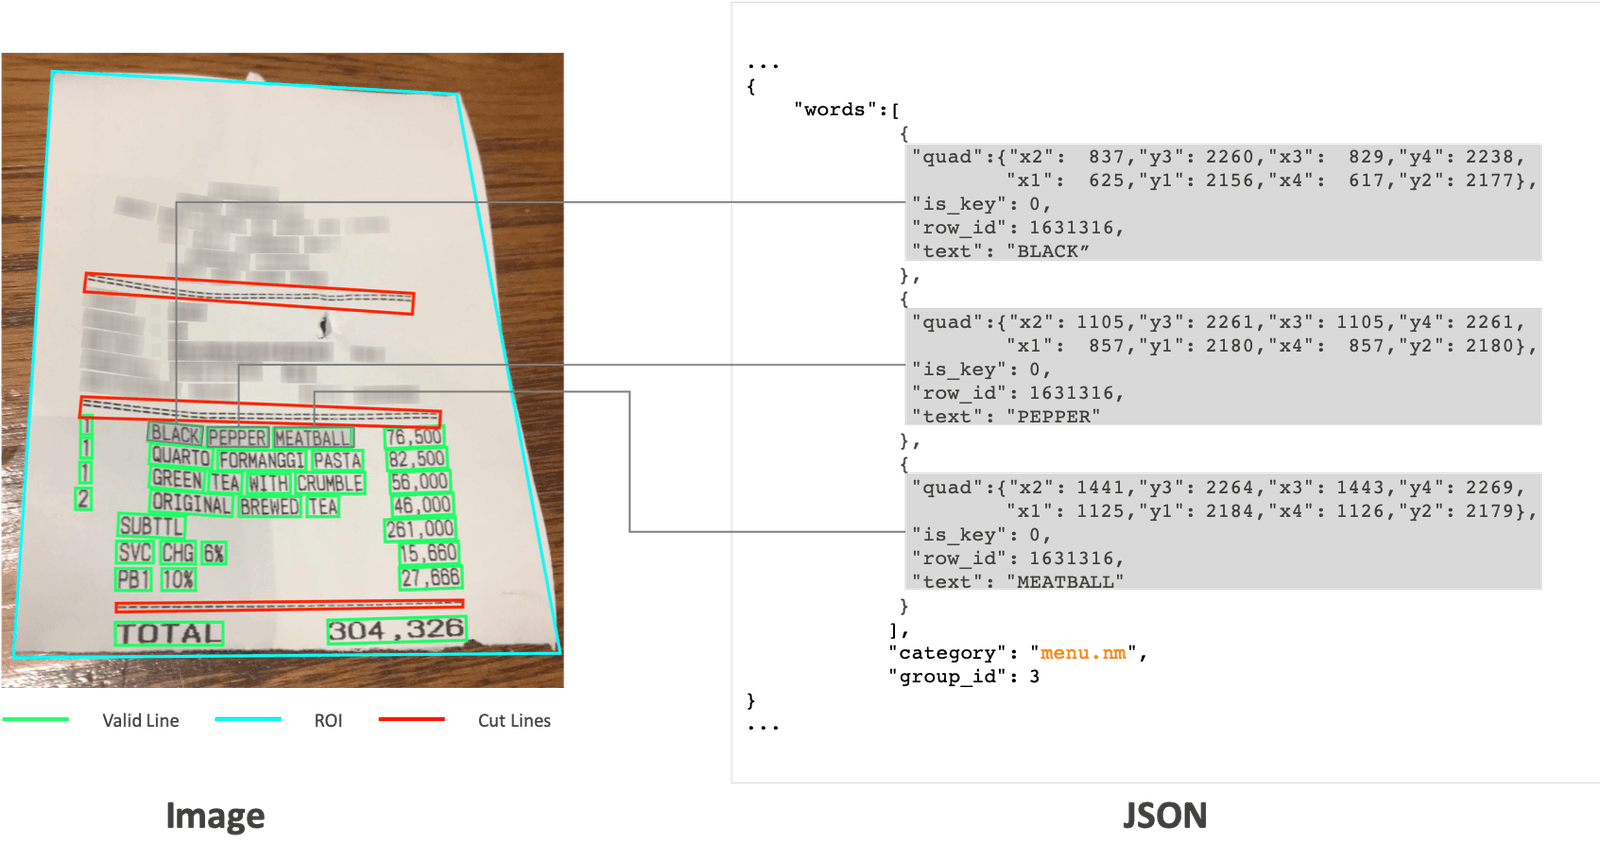
样本来自 CORD receipt dataset (Park et al., Clova AI / NAVER),采用 CC BY 4.0 许可。
为什么“先运行 OCR”最终被证明是错误的方案
直到最近,几乎所有的视觉文档理解系统都遵循相同的两阶段方案。第一步:运行 OCR 引擎(如 Tesseract,或 Amazon Textract、Google Vision 等商业 API),将图像转换为文本及其对应的边界框(bounding boxes)。第二步:将这些文本输入到第二个模型中进行实际的理解工作,例如提取字段、回答问题或对文档类型进行分类。
这种方法确实有效,这也是为什么基于 OCR 的系统多年来一直被视为默认方案。但该论文的作者指出了这种设计中固有的三个问题:
- 成本。 对每份文档运行沉重的 OCR 引擎,尤其是在大规模应用时,在计算资源和延迟方面都非常昂贵。在你的“核心”模型开始工作之前,你已经为一次完整的识别过程支付了成本。
- 缺乏灵活性。 现成的 OCR 引擎通常针对特定的语言和文档类型进行调优。如果将其应用于韩语收据或格式密集的日语名片,准确率可能会大幅下降。而为新语言重新训练或微调 OCR 引擎本身就是一项巨大的工程。
- 错误传播。 这是在实际应用中最致命的问题。如果 OCR 将发票总额中的“3”误读为“8”,那么所有下游步骤都会继承这个错误,且无法挽回。理解模型根本看不到原始像素,它只能盲目信任 OCR 引擎传递给它的内容,包括其中的错误。
第三点尤其值得深思,因为这类故障在造成实际经济损失之前往往是不可见的。一个两阶段流水线即使每个阶段都经过了精细调优,整体依然可能失败,因为阶段之间的传递丢弃了原本有助于纠错的关键信息(如视觉上下文、布局、字体特征)。
Donut 的工作原理:一个模型,直接从像素到文本
Donut 的架构简单得近乎激进,而作者将其视为一项特性而非疏忽。它采用了 Encoder-Decoder Transformer 结构,这与许多 sequence-to-sequence 模型的通用形态一致。
其 Encoder 是一个 Swin Transformer,这是一个通过分块(patches)处理图像并构建视觉表示的视觉模型。至关重要的一点是,在这个阶段完全没有 OCR 模块。它并非先检测文本区域再进行读取,而是像那些用于识别狗类照片的视觉模型一样,构建对整幅图像的通用视觉理解。
其 Decoder 是一个 BART 风格的文本 Transformer,它接收上述视觉表示并逐个 token 地生成输出,就像语言模型逐词生成文本一样。这里的关键技巧在于它生成的内容:Donut 并非简单地转录所看到的文本,而是被训练为输出一个结构化序列(本质上是一种扁平化的类 JSON 格式),直接代表当前任务的答案。以收据为例,这意味着商户名称、项目列表和总额会被格式化为一系列特殊 token,而这些 token 是模型在训练过程中学习生成的。这里没有“这是我检测到的文本”这一中间步骤。输入的是像素,输出的是结构化字段。
要从零开始训练这样一个模型需要海量的标注文档数据,而现实中并不存在如此规模的数据集。因此,作者构建了一个名为 SynthDoG (Synthetic Document Generator) 的合成数据生成器。通过结合背景图像、采样文本和布局模板,SynthDoG 能够生成具有对应 ground truth 且看起来真实的多种语言文档。这使得他们能够在针对特定任务在较小的真实数据集上进行微调之前,先在数百万份合成文档上对 Donut 进行预训练。这也是他们避开困扰 OCR 引擎的语言灵活性问题的方法:只需生成一种新语言的合成文档,就能获得该语言的训练数据,无需重新训练 OCR。
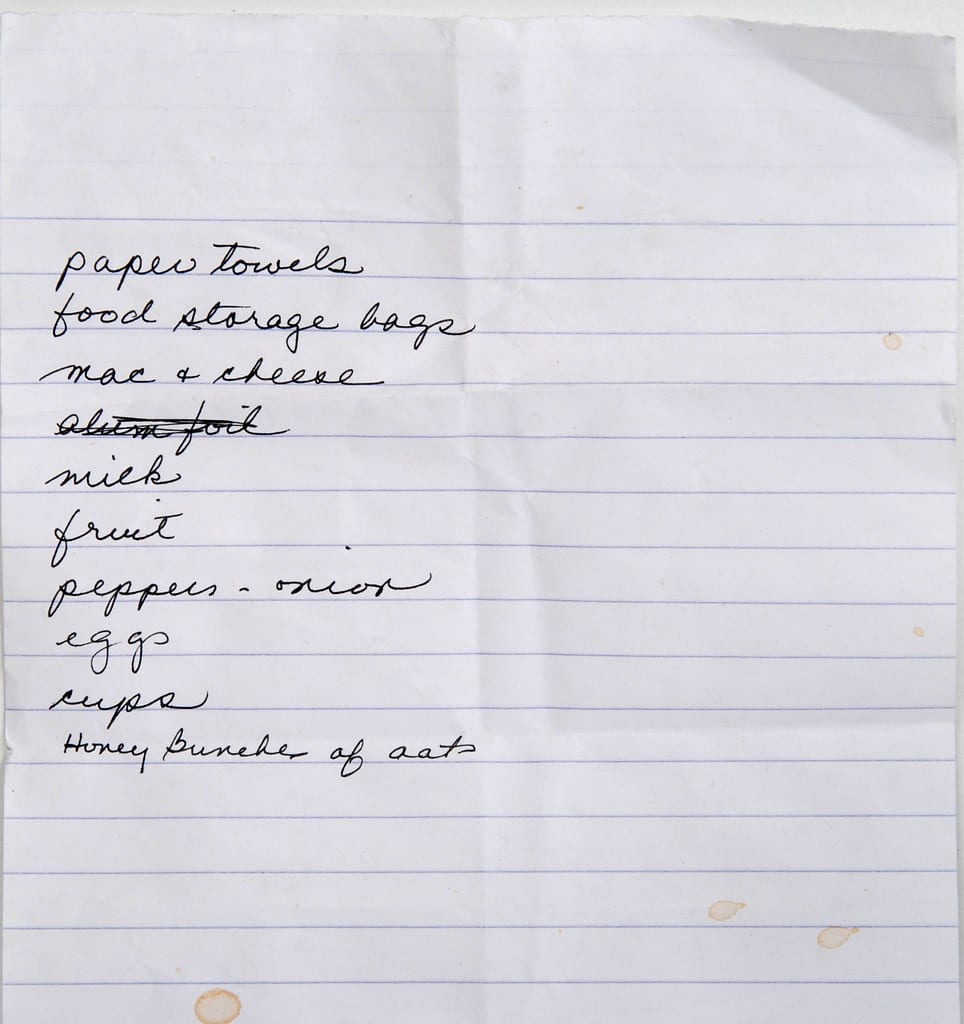
被遗忘 — 由 MStewartPhotography 通过 flickr 提供,BY 2.0。
数据揭示的实际结果
核心结果来自三类任务:文档分类、信息提取和视觉问答。
在 RVL-CDIP 数据集(一个包含 16 个类别,如信函、表单和发票,共 400,000 份扫描文档的标准基准数据集)上,Donut 达到了 95.30% 的分类准确率。这一结果与基于 OCR 的基准模型相当甚至更优,且由于完全跳过了 OCR 步骤,其推理速度明显更快。
在信息提取结果中,“无需 OCR”的策略优势最为显著。在 CORD(一个包含菜单项、价格和总额等字段的印尼语收据公开基准数据集)上,Donut 获得了 91.6 的 F1 分数,击败了那些采用相同底层文档理解架构但依赖外部 OCR 引擎输出作为输入的基准模型。在为该论文构建的日语名片数据集上,Donut 同样优于 OCR 流水线基准模型,尽管日语在历史上一直是 OCR 引擎表现逊于英语的语言。
速度是另一个关键点,且并非次要因素。由于 Donut 不需要运行独立的 OCR 步骤,其推理速度明显快于类似的两阶段系统,尤其是在处理高分辨率文档图像时,因为 OCR 通常是整个流水线中最慢的部分。论文报告称,Donut 处理文档的时间大约仅为对比的 OCR 基准模型的一半。如果你是在实际的大规模场景而非单次演示中运行该模型,这一点至关重要。
局限之处:小文本、复杂布局与对训练数据的渴求
这篇论文并非在宣称 OCR 已经过时,其坦诚地指出的局限性同样值得关注。
首先,Donut 在处理高分辨率下的密集小文本时依然吃力。由于 Vision Transformer 的输入分辨率是固定的,这意味着模型能解析的细节程度存在上限。当页面充斥着 8 号字体时,这种限制就会显现;而专门为解析微小字形而设计的传统 OCR 引擎则没有这个问题。
其次,该模型需要针对具体任务进行微调才能真正发挥作用。预训练能让模型在通用意义上理解“文档”,但若要从特定类型的文档中提取正确的字段,仍然需要该类文档的标注样本。这在文档 AI 领域并不罕见,但这意味着“直接将其应用于新文档类型即可”的说法其实是有条件的。
第三,这是一个结构性问题:Donut 将输出生成为扁平化的序列。相比于设计良好的提取流水线(其中基于规则的后处理步骤可以拦截明显的错误输出),生成式输出本质上更难保证完全可靠。当 Donut 出错时,它可能会生成一个看起来很合理但实际错误的结构化输出,且由于缺乏 OCR 置信度分数或边界框(bounding box),我们无法进行常识性检查。这就是跳过中间表示(intermediate representation)的代价:你同时也失去了中间表示所提供的可解释性。
为什么这对构建或购买 OCR 方案至关重要
对于任何构建文档处理流水线的人来说,Donut 的真正贡献并非让你“删除 OCR 引擎”,而是证明了端到端、无需 OCR 的模型在很大一部分文档理解任务中是可行的,特别是针对收据、表单和名片等布局可预测的文档结构化提取。
如果你目前正基于“OCR + 理解”的流水线进行开发,那么有几个实际问题值得考量。你的下游模型真的需要转录后的文本吗?还是说针对特定的提取任务,直接从图像中获取信息效果同样好(甚至更好)?在你的业务量级下,OCR 的延迟是否真的是瓶颈?端到端模型带来的速度优势对你的产品是否关键?最重要的一点是,你目前的流水线是否有机制在 OCR 错误传播之前将其捕获并修正,还是在默默地信任 OCR 引擎输出的所有结果?
Donut 在发布时随附了代码、训练权重和 SynthDoG 生成器,现已成为开源文档 AI 生态系统中的重要基石,后来的模型(如针对科学 PDF 的 Nougat)也借鉴了其“直接从像素生成结构化 Token”的方法。这篇论文提出的核心观点是:OCR 并非文档理解的必然定律,而是一种设计选择。对于一类具有一致布局和已知字段类型的文档,直接跳过 OCR 可能会比将其优化到极致地更快速且更准确。不过,对于包含大量密集且不规则字符的中文等汉字脚本文档,由于其极高的视觉复杂度和字符量,完全弃用 OCR 仍面临较大挑战。
即便如此,它并非万能的替代方案。如果你需要大规模处理密集且不可预测的文本,目前最稳妥的选择依然是强有力的 OCR 引擎配合优秀的提取模型。Donut 给我们的启示不是“OCR 已死”,而是“检查你当前的任务是否真的需要它”——这比大多数论文能给出的结论要实用得多。