Donut pula o OCR completamente e ainda assim lê seus recibos
Baseado em: OCR-free Document Understanding Transformer — Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park
Imagine um scanner de recibos que nunca executa OCR
Sem caixas de detecção de texto, sem a etapa de reconhecimento de caracteres e sem um modelo separado acoplado para dar sentido ao que o motor de OCR gerou. Você fornece a foto de um recibo amassado e ele entrega um JSON estruturado: nome do estabelecimento, data, itens da compra e valor total. Parece que ele está pulando uma etapa essencial. No entanto, de acordo com um artigo de 2021 da NAVER (a empresa por trás do principal buscador da Coreia do Sul), pular essa etapa foi exatamente o que tornou o modelo mais rápido e, em diversos benchmarks, mais preciso do que pipelines que utilizam OCR da maneira convencional.
O modelo chama-se Donut, abreviação de Document Understanding Transformer. O nome é um acrônimo melhor do que a maioria dos artigos consegue criar, e a ideia por trás dele é genuinamente contraintuitiva: a abordagem padrão para a leitura de documentos executa o OCR primeiro e trata o texto reconhecido como a verdade absoluta para todas as etapas seguintes. O Donut descarta essa premissa e solicita que um transformer vá diretamente dos pixels para a saída estruturada.
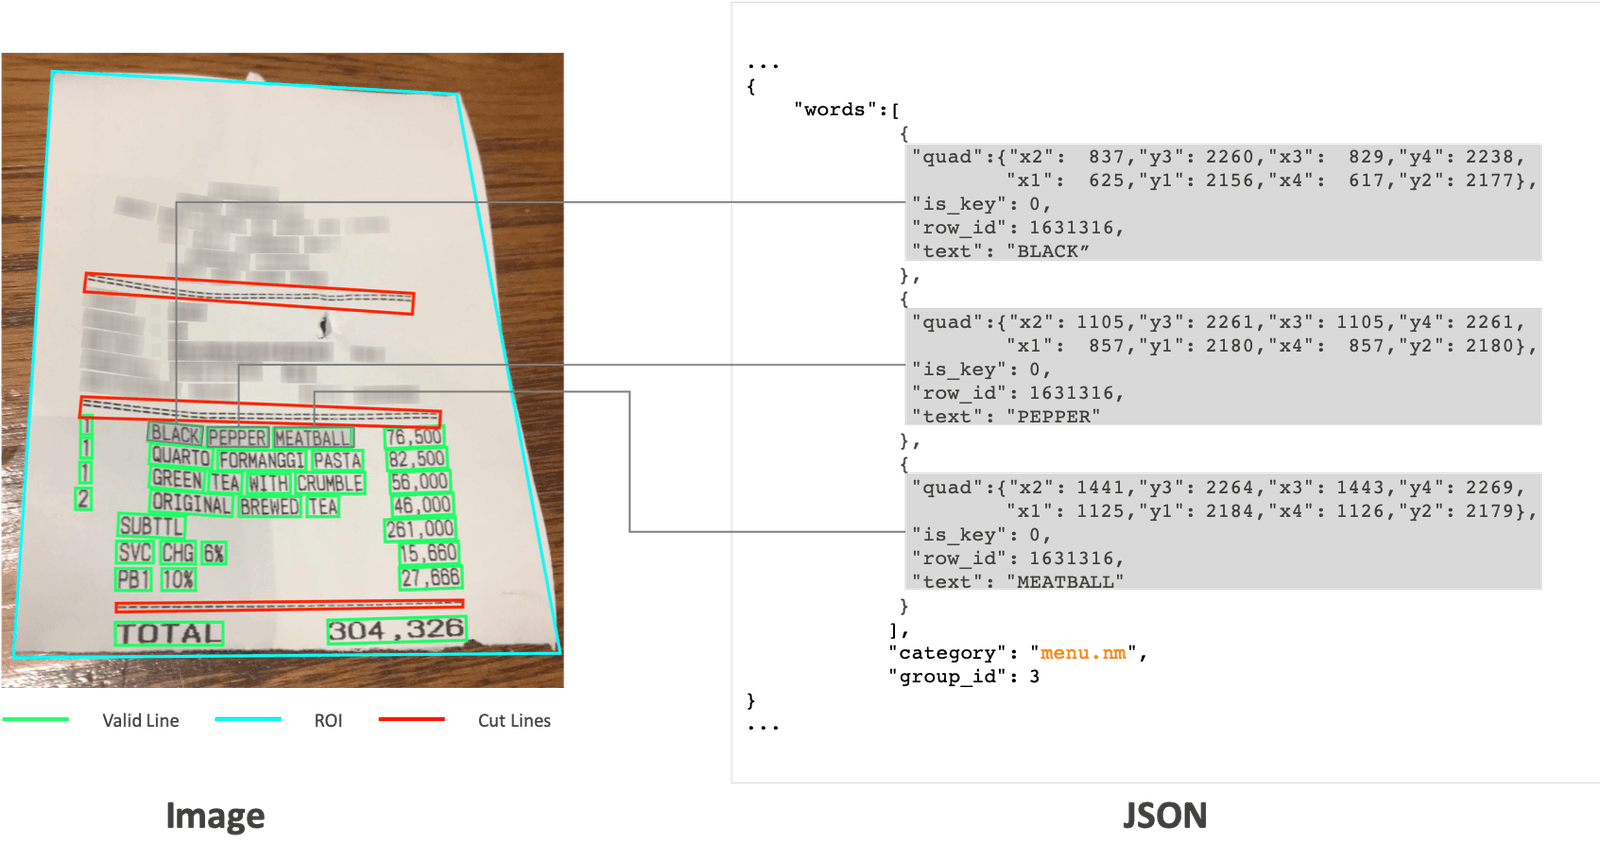
Amostra do CORD receipt dataset (Park et al., Clova AI / NAVER), licenciado sob CC BY 4.0.
Por que "apenas executar o OCR primeiro" acaba sendo a estratégia errada
Até recentemente, todo sistema de compreensão de documentos visuais seguia a mesma receita de duas etapas. Passo um: executar um motor de OCR (Tesseract, ou uma API comercial como Amazon Textract ou Google Vision) para converter a imagem em texto e bounding boxes. Passo dois: alimentar esse texto em um segundo modelo que realiza a compreensão propriamente dita, extraindo campos, respondendo a perguntas ou classificando o tipo de documento.
Isso funciona, e é por isso que os sistemas baseados em OCR foram o padrão por anos. No entanto, os autores do artigo apontam três problemas inerentes a esse design:
- Custo. Executar um motor de OCR pesado em cada documento, especialmente em escala, é caro tanto em termos de computação quanto de latência. Você paga por um ciclo completo de reconhecimento antes mesmo de o seu modelo "real" começar a operar.
- Inflexibilidade. Motores de OCR prontos para uso são ajustados para idiomas e tipos de documentos específicos. Ao direcioná-los para um recibo em coreano ou um cartão de visitas japonês com formatação densa, a precisão pode despencar. Retreinar ou fazer o fine-tuning de um motor de OCR para um novo idioma é, por si só, um projeto à parte.
- Propagação de erros. Este é o ponto que realmente causa problemas na prática. Se o OCR ler erroneamente um "3" como um "8" no total de uma fatura, cada etapa subsequente herdará esse erro sem qualquer forma de recuperação. O modelo de compreensão sequer vê os pixels originais; ele apenas confia no que o motor de OCR entregou, incluindo os equívocos.
Vale a pena refletir sobre esse terceiro ponto, pois é o tipo de falha que permanece invisível até que cause prejuízo financeiro. Um pipeline de duas etapas pode ser individualmente bem ajustado em cada fase e, ainda assim, falhar como um todo, porque a transição entre as etapas descarta informações (contexto visual, layout, características da fonte) que teriam ajudado a detectar o erro.
Como o Donut realmente funciona: um único modelo, dos pixels diretamente ao texto
A arquitetura do Donut é quase agressivamente simples, algo que os autores tratam como uma característica, e não como um descuido. Trata-se de um transformer encoder-decoder, a mesma estrutura geral utilizada em muitos modelos sequence-to-sequence.
O encoder é um Swin Transformer, um modelo de visão que processa a imagem em patches e constrói uma representação visual. Crucialmente, não existe nenhum módulo de OCR nesta etapa. Ele não está detectando regiões de texto para depois lê-las; ele está apenas construindo uma compreensão visual geral de toda a imagem, da mesma forma que um modelo de visão criado para classificar fotos de cachorros faria.
O decoder é um transformer de texto no estilo BART que recebe essa representação visual e gera a saída token por token, da mesma maneira que um modelo de linguagem gera texto palavra por palavra. O "pulo do gato" está no que ele gera. Em vez de apenas transcrever o texto que vê, o Donut é treinado para emitir uma sequência estruturada — essencialmente um formato similar a um JSON linearizado — que representa diretamente a resposta para a tarefa em questão. Para um recibo, isso significa o nome do estabelecimento, a lista de itens e o valor total, formatados como uma sequência de tokens especiais que o modelo aprendeu a produzir durante o treinamento. Não há a etapa intermediária de "aqui está o texto que detectei". Os pixels entram e os campos estruturados saem.
Treinar um modelo para fazer isso do zero exigiria uma quantidade enorme de dados de documentos rotulados, que não existem nas quantidades necessárias. Por isso, os autores criaram um gerador de dados sintéticos chamado SynthDoG (Synthetic Document Generator), que produz documentos com aparência realista e seus respectivos ground truth, em múltiplos idiomas, combinando imagens de fundo, textos amostrados e templates de layout. Isso permitiu que eles pré-treinassem o Donut em milhões de documentos sintéticos antes do fine-tuning em conjuntos de dados reais menores para tarefas específicas, que foi também a maneira como contornaram o problema da inflexibilidade linguística que afeta os motores de OCR. Basta gerar documentos sintéticos em um novo idioma e você terá dados de treinamento para aquela língua, sem a necessidade de retreinar o OCR.
Deixado para trás — por MStewartPhotography via flickr, BY 2.0.
O que os números realmente mostram
Os resultados principais derivam de três tipos de tarefas: classificação de documentos, extração de informações e visual question answering.
No dataset RVL-CDIP (um benchmark padrão de 400.000 documentos digitalizados em 16 categorias, como cartas, formulários e faturas), o Donut atingiu 95,30% de precisão na classificação. Esse valor é competitivo ou superior aos baselines baseados em OCR, e foi alcançado com uma execução visivelmente mais rápida no momento da inferência, já que ele ignora completamente a etapa de OCR.
Os resultados de extração de informações são onde a aposta no "no OCR" traz o retorno mais visível. No CORD, um benchmark público de recibos indonésios com campos como itens do menu, preços e totais, o Donut obteve um F1 de 91,6, superando baselines baseados em OCR que utilizavam a mesma arquitetura de compreensão de documentos, mas dependiam da saída de um motor de OCR externo como entrada. Em um dataset de cartões de visita japoneses criado para o artigo, o Donut também superou os baselines de pipeline de OCR, apesar de o japonês ser um idioma onde os motores de OCR historicamente apresentam desempenho inferior em relação ao inglês.
A velocidade é a outra parte da história, e não é apenas um detalhe. Como o Donut não executa uma etapa de OCR separada, a inferência é significativamente mais rápida do que em um sistema comparável de dois estágios, particularmente para imagens de documentos de alta resolução, onde o próprio OCR costuma ser a parte mais lenta do pipeline. O artigo relata que o Donut processa documentos em aproximadamente metade do tempo dos baselines baseados em OCR com os quais foi comparado, o que é fundamental se você estiver operando em qualquer volume real, e não apenas em uma demonstração pontual.
Onde ele falha: textos pequenos, layouts incomuns e a fome por dados de treinamento
Este não é um artigo alegando que o OCR se tornou obsoleto, e as limitações reais merecem ser mencionadas.
Primeiro, o Donut ainda apresenta dificuldades com textos densos e pequenos em alta resolução. A resolução de entrada fixa de um vision transformer significa que existe um teto para a quantidade de detalhes finos que o modelo consegue resolver; assim, uma página repleta de fonte tamanho 8 atinge esse limite de formas que um motor de OCR dedicado, construído especificamente para resolver glifos pequenos, não atingiria.
Segundo, o modelo precisa de fine-tuning específico para a tarefa para ser genuinamente eficiente em qualquer coisa. O pretraining entrega um modelo que compreende "documentos" em um sentido geral, mas a extração dos campos corretos de um tipo específico de documento ainda exige exemplos rotulados desse tipo de documento. Isso não é incomum para a IA de documentos, mas significa que a ideia de "basta apontá-lo para um novo tipo de documento e pronto" vem com ressalvas.
Terceiro, e este é um ponto estrutural: o Donut gera a saída como uma sequência linear (flattened sequence), e a geração é inerentemente mais difícil de tornar totalmente confiável do que um pipeline de extração bem projetado, onde uma etapa de pós-processamento baseada em regras pode capturar saídas obviamente malformadas. Quando o Donut erra, ele pode produzir uma saída estruturada que parece plausível, mas que ainda está incorreta, e não há um OCR confidence score ou bounding box para servir de verificação de sanidade. Esse é o outro lado de pular a representação intermediária: você também perde a interpretabilidade que essa representação proporcionava.
Por que isso é importante se você está desenvolvendo ou comprando OCR
Para quem está construindo pipelines de processamento de documentos, a real contribuição do Donut não é "delete seu motor de OCR". É a evidência de que modelos end-to-end, livres de OCR, são viáveis para uma fatia significativa de tarefas de compreensão de documentos, particularmente na extração estruturada de documentos com layouts previsíveis, como recibos, formulários e cartões de visita.
Se você utiliza hoje um pipeline de OCR seguido de compreensão, isso sugere alguns pontos práticos que valem a pena analisar. O seu modelo downstream realmente precisa do texto transcrito, ou ele teria o mesmo desempenho (ou melhor) trabalhando diretamente com a imagem para a sua tarefa de extração específica? A latência do OCR é realmente um gargalo no seu volume de dados, e a vantagem de velocidade de um modelo end-to-end faria diferença para o seu produto? E, crucialmente, o seu pipeline atual possui alguma forma de capturar e corrigir erros de OCR antes que eles se propaguem, ou você está confiando cegamente no que o motor de OCR entrega?
O Donut, lançado com código, pesos treinados e o gerador SynthDoG, tornou-se desde então um componente fundamental no ecossistema de document AI de código aberto, e modelos posteriores (como o Nougat para PDFs científicos) tomaram emprestada a sua abordagem de "gerar tokens estruturados diretamente dos pixels". A ideia central que o artigo propõe é que o OCR não é uma lei da natureza para a compreensão de documentos. É uma escolha de design e, para uma classe significativa de documentos — especialmente aqueles com layouts consistentes e tipos de campos conhecidos —, ignorá-lo completamente pode ser mais rápido e preciso do que tentar implementá-lo com perfeição.
Dito isso, não se trata de um substituto universal. Se você lida com textos densos e imprevisíveis em larga escala, um motor de OCR robusto combinado com um bom modelo de extração ainda é a aposta mais segura hoje. A lição do Donut não é que "o OCR morreu", mas sim "verifique se você realmente precisa dele para a tarefa em questão", o que é uma pergunta muito mais útil do que a maioria dos artigos costuma deixar.