TextMonkey: Enseñando a un Vision-Language Model a señalar la línea que acaba de leer
Basado en: TextMonkey: An OCR-Free Large Multimodal Model for Understanding Document — Yuliang Liu, Biao Yang, Qiang Liu, Zhang Li, Zhiyin Ma, Shuo Zhang, Xiang Bai
El problema de la "caja negra" en la IA de documentos
Si le preguntas a la mayoría de las herramientas de IA para documentos "¿cuál es el total de esta factura?", obtendrás un número. No hay forma de verificarlo, ni de saber si el modelo leyó la fila 4 o si tomó accidentalmente un subtotal de la fila 7. Simplemente tienes que confiar en el resultado.
TextMonkey, un artículo de 2024 de la Huazhong University of Science and Technology, hace algo mucho más útil: responde a la pregunta y dibuja un recuadro alrededor del texto exacto que utilizó para llegar a esa respuesta. Si le pides que busque una palabra, no se limita a decir "sí, está aquí", sino que te proporciona las coordenadas. Esto podría parecer una funcionalidad menor, pero en realidad es una apuesta estructural sobre cómo deberían funcionar estos modelos, y es la parte más interesante del artículo.
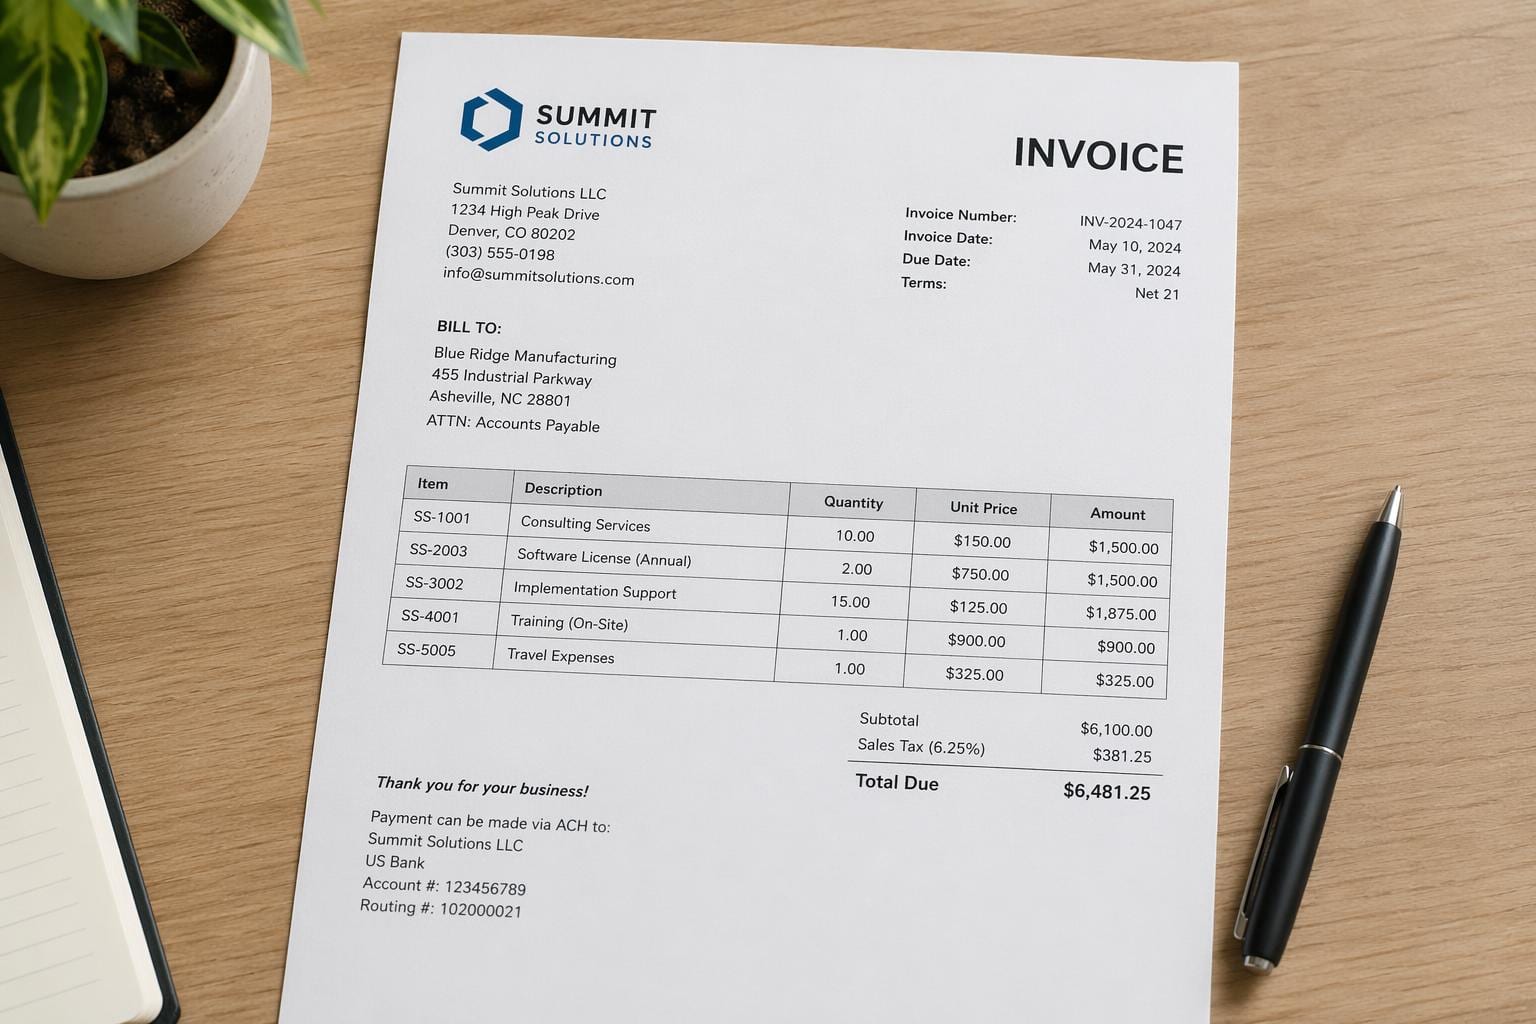
El método antiguo: primero OCR, luego comprensión
Durante años, "leer" un documento con IA implicaba un flujo de trabajo de dos pasos. El primer paso consistía en que un motor de OCR (Tesseract, o algo más sofisticado) convirtiera los píxeles en cadenas de texto. El segundo paso era que un modelo de lenguaje leyera esas cadenas y respondiera preguntas sobre ellas.
El problema es que el primer paso es un cuello de botella que carece de memoria de la imagen original. Una vez que el OCR convierte tu factura en una cadena de caracteres, el modelo ya ha perdido el diseño, la estructura de las tablas, el tamaño de la fuente que indicaba qué línea era el encabezado y el contexto visual que le diría a un lector humano: "este número está en negrita y dentro de un recuadro, probablemente sea el total". Si el motor de OCR lee mal un carácter o omite una línea, el modelo de lenguaje nunca sabrá que se perdió información; simplemente responderá con seguridad basándose en una entrada errónea.
TextMonkey pertenece a una familia más reciente de modelos "OCR-free" que se saltan el primer paso. El modelo analiza directamente la imagen del documento y genera el texto, la estructura y las respuestas todo a la vez, de la misma manera que mirarías un recibo y sabrías el total sin necesidad de transcribir conscientemente cada carácter primero. Para 2024, esta no es una idea nueva, pero TextMonkey la lleva más allá en cuanto a resolución, eficiencia y —la parte genuinamente innovadora— la capacidad de señalar.
Por qué las imágenes de documentos rompen los modelos de visión convencionales
Los modelos de visión y lenguaje fueron diseñados y ajustados principalmente para fotografías: un perro en la playa, un plato de comida, una escena callejera. Los documentos son un desafío completamente distinto.
Una foto puede sobrevivir al ser reducida a 224x224 píxeles; aún se puede distinguir que es un perro. Sin embargo, una página de texto financiero denso reducida a 224x224 se convierte en una masa ilegible. Los encoders de visión estándar fueron creados para un régimen de resolución específico, mientras que los documentos requieren uno totalmente diferente: alta resolución, ya que el significado de un campo en un formulario a menudo depende de unos pocos caracteres pequeños, y la información suele estar distribuida uniformemente por toda la página en lugar de concentrarse en una sola región prominente.
Aumentar la resolución de entrada parece la solución obvia, pero genera problemas en otras áreas. Los vision transformers procesan una imagen dividiéndola en pequeños patches y calculando la atención entre ellos. A resoluciones más altas hay muchos más patches y, si cada patch solo "ve" su entorno inmediato, el modelo pierde el rastro de elementos que se extienden a través de varias regiones, como la fila de una tabla que va desde el borde izquierdo al derecho en un documento ancho. Simplemente aumentar la resolución sin solucionar esto provoca que se pierdan las relaciones de largo alcance o que el coste computacional sea prohibitivo.
Cómo lee TextMonkey una página en realidad
El enfoque del artículo se divide en varias piezas que trabajan en conjunto.
Shifted Window Attention. En lugar de procesar toda la imagen de alta resolución como un único cálculo de atención gigante (costoso) o dividirla en ventanas aisladas que no se solapan y no pueden comunicarse entre sí (lo que provoca la pérdida de información entre ventanas), TextMonkey toma prestado un truco de la arquitectura de visión Swin Transformer: procesar la imagen en ventanas locales y luego desplazar los límites de la ventana en la siguiente capa, de modo que las regiones que previamente estaban divididas se agrupen en esta ocasión. A lo largo de varias capas, la información se propaga efectivamente por toda la imagen sin incurrir nunca en el coste de una atención global completa. Los autores añaden un detalle más importante de lo que parece: inicializan este mecanismo de atención desplazada en cero, lo que significa que al inicio del entrenamiento no aporta nada y aumenta gradualmente. Esto mantiene estable el entrenamiento temprano, en lugar de introducir un mecanismo de ventanas cruzadas a medio entrenar y esperar que el modelo no diverja.
Eliminación de tokens redundantes. Las imágenes de documentos de alta resolución a nivel de patch producen una gran cantidad de tokens, y una parte considerable de ellos son redundantes. Pensemos en un margen blanco amplio o en la misma textura de fondo repetida en docenas de patches. TextMonkey utiliza un filtro basado en la similitud para identificar estos tokens de baja información y descartarlos antes de que lleguen a las partes más costosas del modelo. Un hallazgo digno de mención: esto no es solo un truco de velocidad. El artículo informa que la eliminación de tokens redundantes mejoró el rendimiento además de hacer que el modelo fuera más rápido, lo que sugiere que algunos de esos tokens "extra" actuaban como ruido en lugar de señal.
Text spotting y grounding como tareas de entrenamiento. Esta es la parte que produce el comportamiento de señalización. En lugar de entrenar al modelo únicamente para responder preguntas en texto libre, los autores también lo entrenan para realizar text spotting (buscar y transcribir texto en ubicaciones específicas) y grounding (dada una frase, devolver su bounding box). Crucialmente, integran la información posicional en las propias respuestas del modelo, por lo que cuando TextMonkey responde "¿cuál es el total?", la respuesta puede incluir las coordenadas de dónde leyó dicha respuesta. Esto convierte una respuesta opaca en una verificable.
Comprensión de capturas de pantalla mediante fine-tuning. El modelo también adquiere la capacidad de analizar capturas de pantalla de interfaces de usuario (interfaces de aplicaciones, páginas web) a través de un fine-tuning específico, extendiendo las mismas habilidades de lectura de documentos a un dominio visual bastante diferente: disperso, con un diseño predominante y basado en iconos y botones, en lugar de párrafos densos de texto.
Las cifras y su significado real
TextMonkey fue evaluado en 12 benchmarks divididos en tres categorías:
- Tareas centradas en texto de escena (lectura de texto en fotos del mundo real, como señales viales o etiquetas de productos): STVQA, TextVQA, OCRVQA. Mejora: 5.2%.
- Tareas orientadas a documentos (documentos estructurados, como formularios, infografías, gráficos y tablas): DocVQA, InfoVQA, ChartVQA, DeepForm, Kleister Charity, WikiTableQuestions. Mejora: 6.9%.
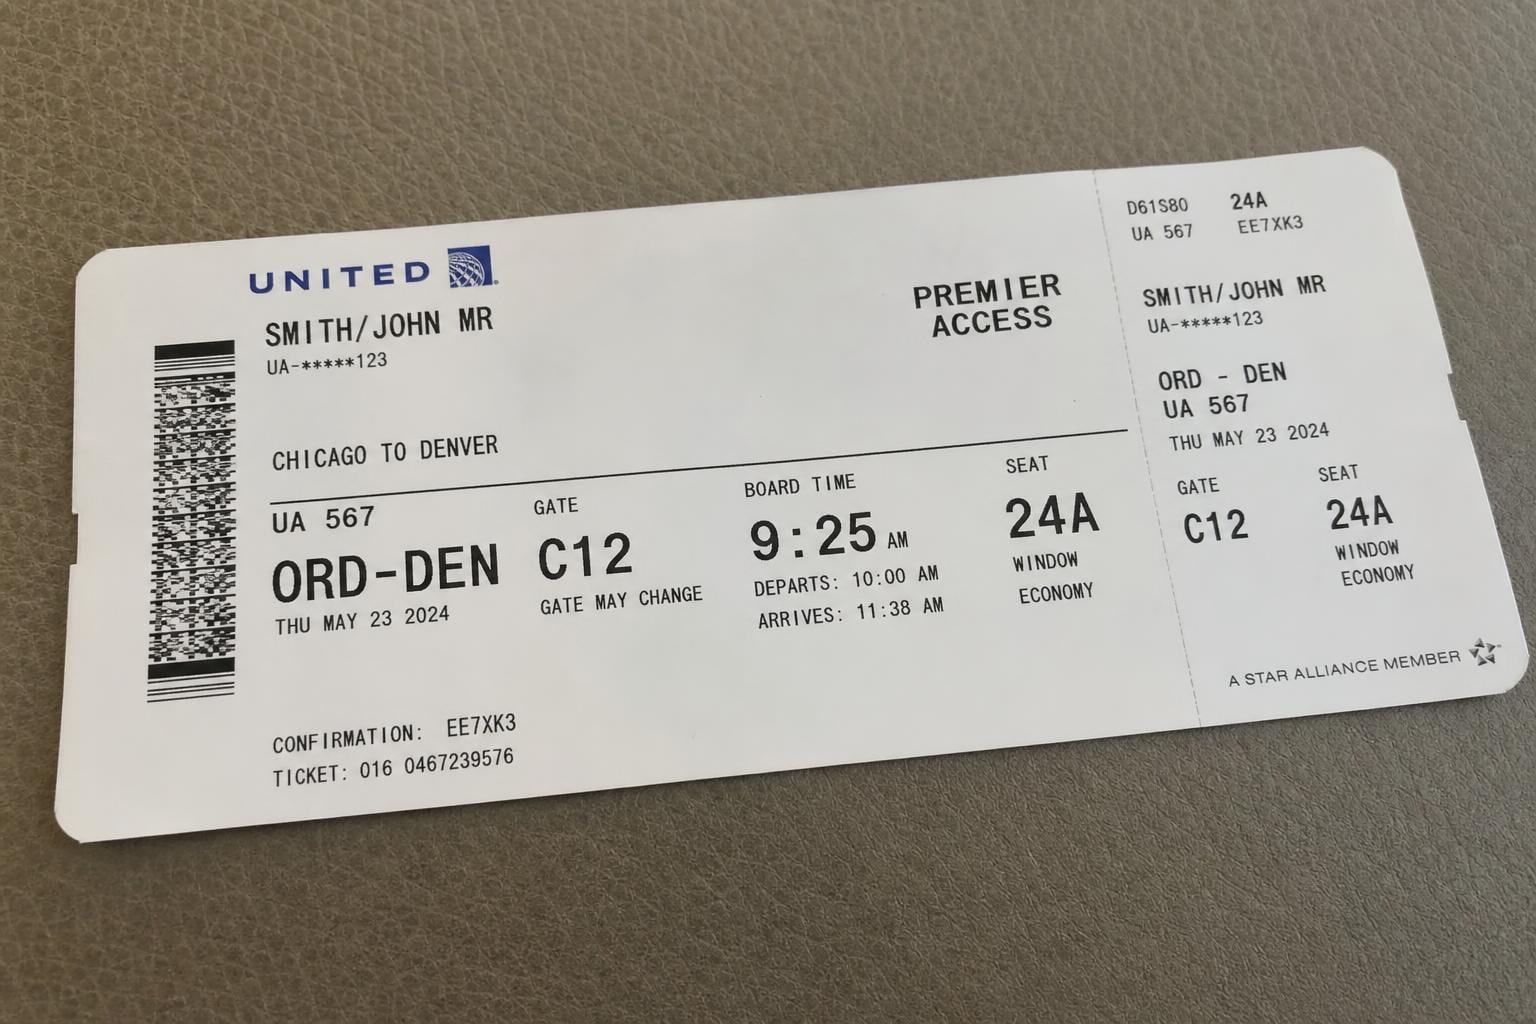
- Extracción de información clave (obtención de campos específicos en documentos semiestructurados, por ejemplo, extraer el "nombre del proveedor" y el "monto adeudado" de una factura): FUNSD, SROIE, POIE. Mejora: 2.8%.
El hecho de que la categoría de documentos presentara el salto más significativo (6.9%) coincide con el planteamiento del artículo: aquí es donde el manejo de resolución mediante shifted-window y el filtrado de tokens deberían tener mayor impacto, ya que los formularios y tablas densas son precisamente donde los modelos anteriores perdían información debido a la baja resolución.
La detección de texto de escena (localizar y leer texto disperso en una fotografía natural, no en un escaneo limpio) mejoró en un 10.9%, la cifra individual más alta del estudio. Es probable que este sea el resultado directo de entrenar el modelo explícitamente en tareas de spotting y grounding, en lugar de tratar la localización como un aspecto secundario.
En OCRBench, una suite exhaustiva de 29 subtareas relacionadas con OCR, TextMonkey obtuvo una puntuación de 561, superando a los modelos multimodales grandes de código abierto diseñados para la comprensión de documentos hasta ese momento. Las métricas de OCRBench evolucionan rápidamente en este campo y quedan obsoletas en uno o dos años; por lo tanto, conviene interpretar el 561 como el "estado del arte en marzo de 2024" más que como un ranking permanente. No obstante, la brecha relativa respecto a los modelos abiertos anteriores sigue siendo reveladora sobre el beneficio obtenido gracias a las decisiones arquitectónicas.
Dónde sigue siendo insuficiente
El artículo no se detiene demasiado en las limitaciones, pero hay algunas lagunas que conviene señalar claramente.
El paso de filtrado de tokens se basa en la similitud para decidir qué es redundante, lo cual es una heurística. Es plausible que, ocasionalmente, se descarte un token de baja frecuencia pero significativo, como un sello pequeño o una marca de agua tenue que solo aparece una vez y no parece "similar" a nada más en la página. El artículo reporta ganancias netas de rendimiento, pero eso es un promedio entre benchmarks, no una garantía contra un caso difícil específico.
La precisión del grounding depende totalmente de la calidad de la lectura subyacente. Si el modelo lee mal un dígito, el bounding box que dibuje apuntará con total confianza a la evidencia incorrecta. El grounding te otorga verificabilidad, no corrección. Es una mejora real frente al "confía en mí", pero no es una prueba definitiva.
Además, los benchmarks utilizados siguen siendo mayoritariamente en inglés y basados en formatos de documentos occidentales. Nada en el abstract del artículo sugiere pruebas en documentos multilingües, formularios con mucha escritura a mano o los escaneos más caóticos que aparecen en los archivos del mundo real (inclinados, de bajo contraste o manchados de café). El rendimiento en benchmarks limpios y el rendimiento en el mundo real están correlacionados, pero no son idénticos.
Por qué importa para quien construye o compra OCR
Si estás eligiendo un motor de IA documental para un producto, la capacidad de anclaje (grounding) es lo que debes observar, más que las cifras brutas de los benchmarks. Un modelo que solo devuelve "el total es $482.19" no te permite detectar cuándo se equivoca. Un modelo que devuelve el número junto con una caja delimitadora (bounding box) te permite construir una interfaz donde un revisor humano ve la región resaltada y puede confirmar o rechazar de un vistazo, en lugar de volver a leer todo el documento. Para cualquier flujo de trabajo que implique dinero, contratos o cumplimiento normativo, esa diferencia es la que separa el "OCR que puedes verificar por muestreo" del "OCR en el que tienes que confiar ciegamente".
También es un dato relevante en el cambio más amplio hacia modelos únicos que leen y comprenden en un solo paso, alejándose de las tuberías de OCR seguido de análisis. Este cambio se está manifestando en muchos de los modelos que seguimos, y altera el cálculo para cualquiera que haya construido infraestructura asumiendo que la extracción de texto OCR y la comprensión documental son pasos separados realizados por herramientas distintas. Cada vez más, no lo son, y los modelos que omiten esta transferencia están ganando en benchmarks intensivos en documentos por una razón sencilla: nada se pierde en la traducción entre la cadena de texto OCR y el modelo que la lee.
El ángulo de la eficiencia de tokens también importa en la práctica. Si estás ejecutando inferencia a gran escala, una técnica que reduzca los tokens redundantes y mejore la precisión al mismo tiempo es lo suficientemente rara como para notarse: las ganancias de eficiencia y calidad no suelen llegar juntas, y aquí sí lo hicieron.