AIにボックスを描かせようとするのをやめよう:回答の出所を証明するより良い方法
元論文: Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels — Zhuchenyang Liu, Yao Zhang, Yu Xiao
帰属の幻覚
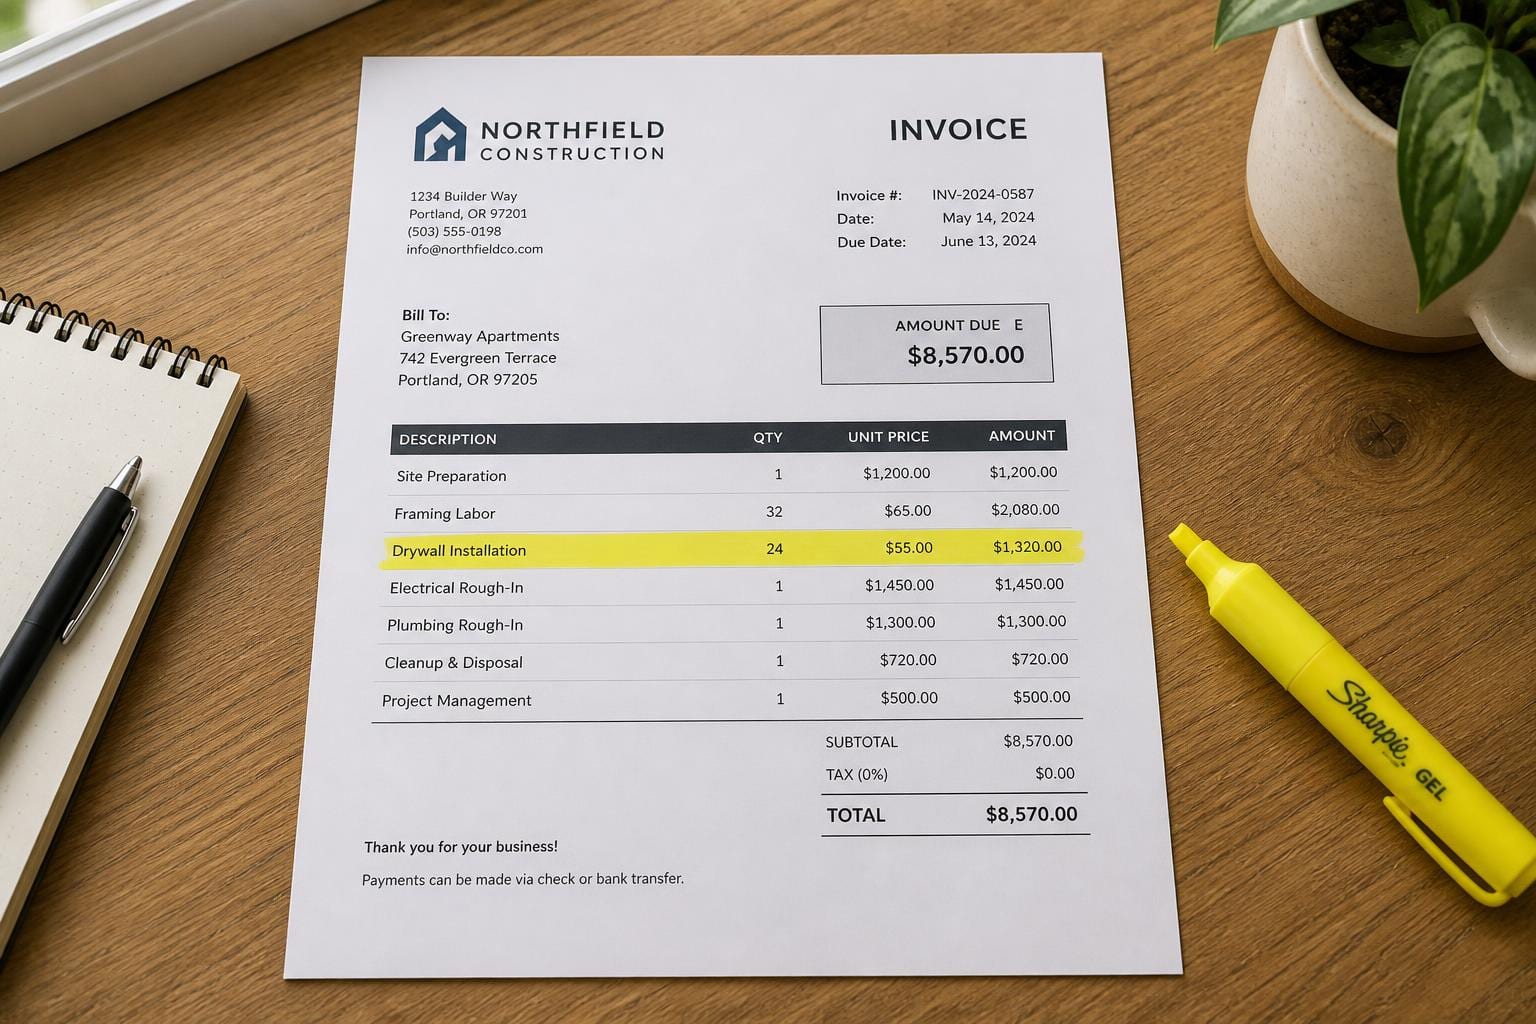
スキャンされた請求書を読み取り、合計額が482.17ドルであると報告する経費報告用ボットを想像してください。その回答は正解です。しかし、次にそのボットはベンダーのロゴに矩形を描き、「ここからその数字を見つけました」と主張します。答えは正しかったものの、その指し示しは意味をなしませんでした。
これは仮説の話ではありません。これは、ビジョン・ランゲージ・モデル(VLM:画像とテキストプロンプトの両方を同時に処理できるモデル)において文書化されている失敗モードであり、「帰属の幻覚(Attribution Hallucination)」という名前が付けられています。モデルは正しい答えを提供しながら、その根拠として誤った証拠を引用したり、実際には存在しない証拠を提示したりします。Zhuchenyang Liu、Yao Zhang、Yu Xiaoによる新論文「Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels」は、この失敗の原因が驚くほど平凡なことに起因することを明らかにしています。それは、私たちがモデルに「指し示す」よう要求する方法なのです。
誰もが見過ごす部分:回答と出典提示は異なるスキルである
現在の多くのドキュメント質問応答システムは、次のような仕組みで動作している。モデルにページ(請求書、契約書、スキャンされたフォームなど)を示し、質問(「合計請求額はいくらですか?」など)を投げると、モデルは回答とともにバウンディングボックス(その回答を supposedly 見つけたページ上の矩形領域を示すピクセル座標のセット)を返す。これが座標インターフェースであり、ベンチマークや製品がモデルにその処理過程を示させるための標準的な方法である。
問題点は、ドキュメントの読み取りとピクセル座標の記述は、無理やり組み合わされた2つの異なるタスクであるということだ。モデルはテーブル構造を正しく解析した結果、合計額が482.17ドルであることを真に理解している場合でも、「そのセルにあるその数字」を「x=412, y=88, width=64, height=22」という座標に変換する能力は低い可能性がある。座標は、VLM(ビジョン・ランゲージ・モデル)が主に学習していない言語である。学習しているのはテキストである。
著者たちは、証拠帰属(evidence attribution)のために特別に構築されたバイリンガル(英語と中国語)ベンチマークであるCiteVQAを用いて、この仮説を検証した。CiteVQAは検証済みサブセットを使用しており、各回答を支持する実際の領域に関する正解データ(ground truth)が信頼できる。6つのオープンVLMを対象とした実験で、モデルにボックスを描かせた場合、証拠再現率(モデルが提示した領域が実際の証拠と実際に重なる質問の割合)は最大でも100問中8問程度にとどまることがわかった。他の手法より8%低いという話ではない。8問である。100問中、モデルの実際の回答が正解である頻度の方がはるかに高いにもかかわらず、ボックスが概ね正しいのはせいぜい8回程度である。
代わりに試したアプローチ:モデルに引用させ、その引用元を検索する
論文で提案されている解決策は、記述としてはほとんど恥ずかしいほどシンプルですが、実際に機能させるには本格的なインフラが必要です。それは、モデルに座標を求めないようにすることです。
代わりに、モデルは質問に答えた後、証拠として使用したテキストの一部を、PDFからチャットメッセージにコピー&ペーストするのと同じように、ページ上の位置を説明するのではなく、正確に引用します。これが「言語インターフェース」です。別のシステムがその引用文を文書内で検索します。具体的には以下の通りです:
- レイアウトパーサー(ページを段落、表のセル、見出し、図のキャプションなどの構造的な領域に分割するツール。人が視覚的にページを「これは段落、これは表」とチャンク分けするのと同じ)が、まず文書を候補となる領域に分割します。
- マルチモーダルレトリバー(テキストをページのテキストおよびレイアウトの両方と比較できるマッチングシステム)が、モデルが引用した証拠を取り、それがどの領域から来たかを特定し、その領域を属性付きの位置として返します。
- 直接引用できる連続した散文がない表や図は、キャプションや注釈を通じて処理されるため、単純な段落以外でも引用して位置特定するアプローチが機能します。
結果として、モデルはもはや幾何学的な処理を行う必要がなくなります。モデルは実際に得意な、テキストの読み取りと再現を行います。代わりに、この種のマッチングのために構築されたレトリバルシステムが幾何学的な処理を行います。
根拠となるデータ
同じ6つのオープンソースVLMを同じCiteVQAサブセットで実行した結果、言語インターフェースにより、証拠の想起率(evidence recall)は8という天井から、モデル次第で26〜47へと向上しました。これは、モデルの再学習や座標に関するより良いプロンプトの提供ではなく、単にモデルに要求される出力形式を変更しただけで達成された、約3〜6倍の飛躍です。
ハルシネーション率(モデルが実際に支持されていない証拠に回答を自信を持って帰属させる頻度)は、新しいインターフェース下で約半分になりました。そして通常はトレードオフとなる部分、つまりモデルが実際の質問を正しく答えられるかどうかを示す回答の質は、ほとんど変動しませんでした。出典の正確さ(honesty about sourcing)を正解率と引き換えにしているわけではありません。ほぼコストなしで、誠実さの大部分を取り戻せるのです。
これが主要な発見であり、少し立ち止まって考える価値があります。なぜなら、これは「帰属ハルシネーション」そのものの定義を再構築するものだからです。それは必ずしも理解の失敗ではありません。多くの場合、それは出力形式の失敗のように見えます:モデルは正しい段落を知っていましたが、座標インターフェースはそれを表現するための適切な方法を提供していなかったのです。
パイプラインを教師にする:リージョンラベルなしのGRPO
26〜47の範囲でのリコールは確かに改善されましたが、これはまだ解決された問題ではありません。そこで著者たちは、クォート&リトリーブパイプラインを2番目の目的のために使用しました。それは、基礎となるモデルがそもそも良い証拠を引用する能力を高めるための学習スケルトンとして利用することです。
ここで論文が取り上げるのが、GRPO(Group Relative Policy Optimization)です。これは強化学習の手法で、同じ入力に対して複数の候補出力を生成し、それぞれにスコアを付け、グループ内で最も高いスコアを得た出力にモデルを誘導します。これはDeepSeekがR1推論モデルを訓練するために使用した手法と同じファミリーに属し、「より良い」という定義はできるが、段階的に「より良い」状態が具体的にどのようなものかを示す大規模なラベル付きデータセットを持っていないタスクに対してモデルをファインチューニングする人気のある方法となっています。
帰属モデルを訓練する通常のやり方は、注釈担当者を使って何千もの文書ページに正解となるバウンディングボックスを描き、どのリージョンがどの回答をサポートしているかを正確にマークすることです。これは特に、1つの回答が14ページ目に埋もれた証拠に依存している可能性のある長い複数ページの文書では、コストが高く時間がかかります。
この論文はそれを完全に回避しています。リージョンラベルの代わりに、報酬信号は審判モデルから得られます。このモデルは、質問の正解(ゴールド)と、学習中のモデルが引用した証拠のためにリトリーバーが引っ張ってきたリージョンの切り抜かれた画像を読み、それらの切り抜きが実際にその回答をどの程度サポートしているかを評価します。人間がボックスを描くことはありません。モデルは、一度位置が特定され切り抜かれたときに、正解を明確に裏付けるテキストを引用することで報酬を受け、その引用がリトリーバーを関連性の低いリージョンに導く場合はペナルティを受けます。
8Bパラメータのバックボーンモデル(現在の基準では中規模のオープンモデル)に適用されたこの訓練は、論文が「厳格な帰属精度」と呼ぶものを22.4から33.8に押し上げました。これは、モデルが回答と証拠の両方を正しく取得しない限りカウントされないという意味で、論文の中で最も厳格で寛容でないメトリクスにおいて、約50%の相対的改善を示しています。この訓練信号は、新しい人間によるラベル付けデータではなく、既存のツール(審判モデル、レイアウトパーサー、リトリーバー)のみを使用して構築されています。
ドキュメントAIの構築・導入においてなぜ重要なのか
OCRやドキュメントAIを活用したシステムを構築している場合、ここで得られる核心的な教訓は「特定のベンチマークを使うべきだ」というものではなく、「モデルに根拠の提示を促すインターフェースの設計が、モデルの基礎性能とは独立して、その回答の信頼性(正直さ)を左右する」という点にあります。
いくつかの具体的な示唆を挙げます。
- 製品上で「ここから該当箇所を見つけました」という引用表示を行う場合、その引用を生成するインターフェースを確認してください。 本論文によると、一般的なVLM(ビジョン言語モデル)が出力するバウンディングボックスは、未知のドキュメントにおいて、たとえ最終的な回答が正しくても、最大で8%の確率でしか正確ではありません。「回答は正しい」が「引用箇所は誤り」というギャップこそが、ユーザーの信頼を静かに損なう原因となります。なぜなら、正しい回答の横に誤ったハイライトが表示されることは、ハイライトがない場合よりもユーザーにとって悪影響だからです。
- 「まず引用し、その後で位置を特定する」というパターンは、より優れた基盤モデルを待たずに、今日から構築可能です。 これはカスタム訓練されたVLMを必要としません。すでに使用しているモデルを中心に、レイアウトパーサーとレトリバーを組み合わせるだけで実現できます。本論文でテストされた6つのモデルのうち5つにおいて、改善は基礎的な重みの変更ではなく、インターフェースの変更から生まれたものでした。
- リージョンレベルのラベル付けはコストが高く、本論文はその回避策を示しています。 帰属品質を向上させるためのアノテーションプロジェクトへの資金投入と、ジャッジベースの報酬パイプラインの構築のどちらを選ぶべきか検討している場合、GRPOの結果は、人間によるボックス描画を一切行わずに、実質的な改善(厳密な帰属精度で22.4から33.8への向上)が得られる可能性を示唆しています。
日本語のOCRやVLMモデルにおいて、漢字や縦書きレイアウトの処理は最も困難なケースの一つであり、本論文が主に英語の横書き文書に焦点を当てている場合、日本語特有の縦組みテキストや複雑な漢字配置に対する適用性については、別途検証やモデルの拡張が必要となる点に留意が必要です。
未解決の課題
本論文はスコープについて慎重に記述しており、読者も同様に慎重に読み解く価値があります。得られた性能向上はCiteVQAという1つのバイリンガルベンチマークで測定されたものであり、検証済みサブセットはフィルタリングされていないものよりも有意義な高い基準ではあるものの、それでもなお1つのデータセットに過ぎません。証拠の再現率(Evidence recall)が8から26〜47の範囲へ大きく向上したことは事実ですが、まだ飽和状態には程遠く、6つのモデルのほとんどにおいて、半数以上のケースで取得された領域が正しくないままです。さらに、取得ステップはレイアウトパーサーが正しく機能することに依存しています。ページが不良な角度でスキャンされていたり、珍しいレイアウトであったり、パーサーが適切にセグメンテーションできない表が含まれている場合、その誤りは「引用と位置特定」の連鎖全体に継承されます。これは、健全なページ上でピクセル座標を正しく出力する仮想的なモデルでは発生しない種類の誤りです。
また、注目すべきもう一つの微妙な依存関係があります。GRPOトレーニングは証拠の品質を評価するジャッジモデルに依存していますが、ジャッジモデル自体にも盲点があります。論文はジャッジが人間の合意に対する完全なプロキシであると主張しておらず、研究環境の外でこれを再現しようとする場合、この点を押さえて進むことは理にかなっています。
これらの課題が核心的な発見を否定するものではありません。この論文で興味深いのは特定の精度数値ではなく、その診断にあります。ドキュメントAIにおける推論問題のように見えていたものの一部は、実際には出力フォーマットの問題であり、出力を再フォーマットすることが、多くのアーキテクチャ変更よりも大きな影響をもたらしたのです。