Pare de pedir à IA para desenhar caixas: uma maneira melhor de provar de onde veio uma resposta
Baseado em: Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels — Zhuchenyang Liu, Yao Zhang, Yu Xiao
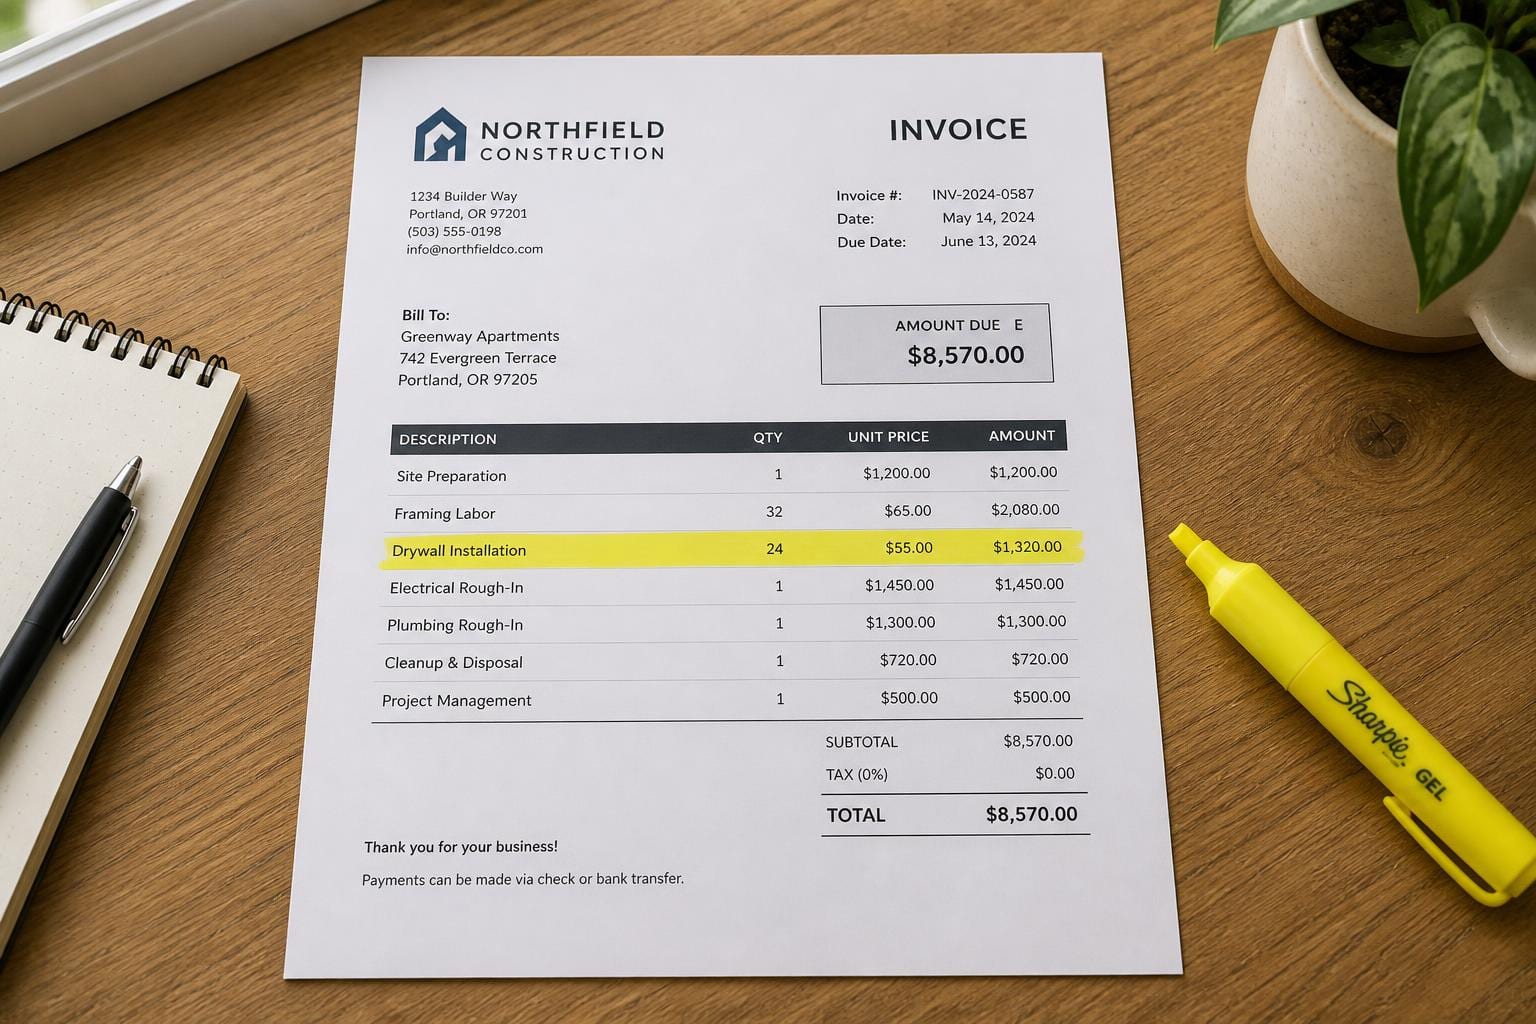
Imagine um bot de relatórios de despesas que lê uma fatura digitalizada e informa que o total é de US$ 482,17. Está correto. Agora, ele desenha uma caixa ao redor do logotipo do fornecedor e diz que foi ali que encontrou o número. A resposta estava certa. A indicação era absurda.
Isso não é hipotético. É um modo de falha documentado em modelos de visão e linguagem (VLMs, os modelos que podem ler uma imagem e um prompt de texto juntos), e tem um nome: Alucinação de Atribuição. Um modelo lhe dá a resposta certa e depois cita a evidência errada para ela, ou evidência que na verdade não existe. Um novo artigo, "Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels", de Zhuchenyang Liu, Yao Zhang e Yu Xiao, rastreia essa falha até algo surpreendentemente banal: a maneira como temos pedido aos modelos que apontem.
A parte que todos ignoram: responder e citar são habilidades diferentes
A maioria dos sistemas de perguntas e respostas em documentos funciona assim hoje em dia. Você mostra ao modelo uma página (uma fatura, um contrato, um formulário escaneado), faz uma pergunta ("qual é o total devido?") e o modelo fornece uma resposta junto com uma caixa delimitadora: um conjunto de coordenadas de pixels que marca o retângulo na página onde ele supostamente encontrou aquela resposta. Esta é a interface de coordenadas, e é a maneira padrão pela qual benchmarks e produtos têm pedido aos modelos que mostrem seu raciocínio.
O problema é que ler um documento e descrever coordenadas de pixels são duas tarefas diferentes acopladas entre si. Um modelo pode compreender genuinamente que o total é $482,17 porque analisou corretamente a estrutura da tabela, e ainda assim ser ruim em traduzir "aquele número, naquela célula" para "x=412, y=88, width=64, height=22". Coordenadas são uma linguagem para a qual os VLMs não foram treinados principalmente. Texto é.
Os autores testaram isso no CiteVQA, um benchmark bilíngue (inglês e chinês) construído especificamente para atribuição de evidências, usando um subconjunto verificado para que a verdade fundamental sobre quais regiões realmente suportam cada resposta seja confiável. Em seis VLMs de código aberto, eles descobriram que deixar um modelo desenhar uma caixa resulta em uma recuperação de evidências (a porcentagem de perguntas em que a região citada pelo modelo realmente se sobrepõe à evidência verdadeira) de no máximo 8 em 100. Não 8 porcento abaixo de algum outro método. Oito. De cem perguntas, a caixa está aproximadamente certa talvez oito vezes, mesmo quando a resposta real do modelo à pergunta está correta com muito mais frequência.
O que eles tentaram em vez disso: fazer o modelo citar e, em seguida, localizar a citação
A solução proposta pelo artigo é quase construtivamente simples de descrever, embora exija infraestrutura real para funcionar: pare de pedir coordenadas ao modelo.
Em vez disso, o modelo responde à pergunta e, em seguida, cita,ipsis litteris, o trecho de texto que usou como evidência, da mesma forma que você copiaria e colaria uma frase de um PDF em uma mensagem de chat, em vez de descrever onde ela está na página. Essa é a "interface de linguagem". Um sistema separado então vai e encontra essa citação no documento. Especificamente:
- Um analisador de layout (uma ferramenta que segmenta uma página em regiões estruturais, como parágrafos, células de tabela, cabeçalhos e legendas de figuras, da mesma forma que uma pessoa dividiria visualmente uma página em "isto é um parágrafo, isto é uma tabela") primeiro divide o documento em regiões candidatas.
- Um recuperador multimodal (um sistema de correspondência que pode comparar texto contra o texto e o layout de uma página) pega a evidência citada pelo modelo e descobre de qual dessas regiões ela veio, retornando essa região como a localização atribuída.
- Tabelas e figuras, que não possuem prosa fluida que possa ser citada diretamente, são tratadas por meio de suas legendas ou notas, de modo que a abordagem de citar e localizar ainda funciona mesmo fora de parágrafos simples.
Em suma, o modelo não precisa mais fazer geometria. Ele faz o que realmente sabe fazer bem: ler e repetir texto. Um sistema de recuperação, construído exatamente para esse tipo de correspondência, faz a geometria em seu lugar.
Os números que fundamentam o argumento
Ao executar os mesmos seis VLMs de código aberto no mesmo subconjunto do CiteVQA, a interface de linguagem elevou a recuperação de evidências daquele teto de 8 para algum valor entre 26 e 47, dependendo do modelo. Isso representa um salto de aproximadamente três a seis vezes, alcançado puramente ao alterar o formato de saída que o modelo é solicitado a produzir, sem retriná-lo ou fornecer um prompt melhor sobre coordenadas.
A taxa de alucinação (com que frequência o modelo atribui confiantemente uma resposta a evidências que não a suportam realmente) foi reduzida pela metade sob a nova interface. E a parte que normalmente seria a pegadinha: a qualidade da resposta, ou seja, se o modelo acerta a pergunta real, mudou muito pouco. Você não está trocando correção por honestidade quanto às fontes. Você recupera a maior parte da honestidade praticamente de graça.
Esse é o principal achado, e vale a pena refletir sobre ele por um momento, pois ele redefine o que é a "alucinação de atribuição". Não é necessariamente uma falha de compreensão. Em muitos casos, parece mais uma falha de formato de saída: o modelo conhecia a passagem correta, e a interface de coordenadas simplesmente não lhe oferecia uma boa maneira de expressá-la.
Transformando o pipeline em um professor: GRPO sem rótulos de regiões
A melhoria na faixa de 26-47 é real, mas o problema ainda não está resolvido. Por isso, os autores usaram o pipeline de citação e recuperação para um segundo propósito: como um andaime de treinamento para tornar o modelo subjacente melhor em citar boas evidências desde o início.
É aqui que o artigo recorre ao GRPO (Group Relative Policy Optimization), um método de aprendizado por reforço que gera um lote de saídas candidatas para a mesma entrada, pontua cada uma e ajusta o modelo em direção àquelas que tiveram melhor pontuação relativa ao grupo. É a mesma família de técnicas que a DeepSeek usou para treinar seu modelo de raciocínio R1, e tornou-se uma maneira popular de ajustar finamente um modelo em uma tarefa onde você pode definir "melhor", mas não possui um grande conjunto de dados rotulado mostrando exatamente como "melhor" se parece passo a passo.
A maneira normal de treinar um modelo de atribuição seria contratar anotadores para desenhar caixas delimitadoras de verdade fundamental em milhares de páginas de documentos, marcando exatamente qual região suporta qual resposta. Isso é caro e lento, especialmente para documentos longos e de várias páginas, onde uma única resposta pode depender de evidências enterradas na página 14.
O artigo contorna isso completamente. Em vez de rótulos de regiões, o sinal de recompensa vem de um juiz: outro modelo que lê a resposta correta (gold) para uma pergunta junto com imagens recortadas de quaisquer regiões que o recuperador tenha puxado para as evidências citadas pelo modelo em treinamento, e avalia o quão bem esses recortes realmente suportam essa resposta. Nenhum humano desenha uma caixa. O modelo é recompensado por citar texto que, uma vez localizado e recortado, visivelmente apoia a resposta correta, e penalizado quando suas citações levam o recuperador a regiões irrelevantes.
Aplicado a um modelo backbone de 8B parâmetros (8 bilhões de parâmetros, um modelo aberto de tamanho médio pelos padrões atuais), esse treinamento elevou o que o artigo chama de "precisão atribuída estrita", o que significa que o modelo precisa acertar tanto a resposta quanto a evidência, ou não conta, de 22,4 para 33,8. Isso representa aproximadamente uma melhoria relativa de 50% na métrica mais estrita e menos permissiva do artigo, usando um sinal de treinamento construído inteiramente a partir de ferramentas existentes (um modelo juiz, um parser de layout, um recuperador) em vez de novos dados rotulados por humanos.
Por que isso importa para quem está construindo ou comprando IA de documentos
Se você está construindo qualquer coisa sobre OCR ou IA de documentos, a lição principal aqui não é "use este benchmark específico". É que a interface que você usa para pedir a um modelo que justifique suas respostas muda o quão honesto ele pode ser, independentemente de quão bom o modelo realmente é por baixo dos panos.
Algumas conclusões concretas:
- Se seu produto mostra aos usuários "aqui é onde encontrei isso" em um documento, verifique qual interface está gerando essa citação. Uma saída de caixa delimitadora (bounding-box) de um VLM geral está correta, no máximo, 8% das vezes em documentos não vistos, mesmo quando a resposta declarada está correta. Essa lacuna entre "a resposta está certa" e "a citação está certa" é exatamente onde a confiança do usuário é silenciosamente destruída, porque um destaque incorreto ao lado de uma resposta correta parece pior para o usuário do que nenhum destaque.
- Citar-então-localizar é um padrão que você pode construir hoje, sem esperar por modelos fundamentais melhores. Não requer um VLM treinado de forma personalizada. Requer um analisador de layout e um recuperador (retriever) conectados ao modelo que você já está usando, já que a melhoria neste artigo veio da mudança na interface, não nos pesos subjacentes, para cinco dos seis modelos testados.
- Rótulos em nível de região são caros, e este artigo mostra um caminho para contorná-los. Se você está ponderando se deve financiar um projeto de anotação para melhorar a qualidade da atribuição versus construir um pipeline de recompensa baseado em juiz, o resultado do GRPO sugere que a segunda rota pode obter ganhos reais (de 22,4 para 33,8 na precisão estritamente atribuída) sem uma única caixa desenhada por humanos.
O que ainda está sem resolução
O artigo é cuidadoso quanto ao seu escopo, e vale a pena ser igualmente cauteloso ao lê-lo. Os ganhos foram medidos no CiteVQA, um benchmark bilíngue, e, embora um subconjunto verificado represente um patamar significativamente mais alto do que um não filtrado, ainda se trata de um único conjunto de dados. A recuperação de evidências na faixa de 26-47 é um grande salto em relação a 8, mas também está longe de estar saturada: mais da metade das vezes, na maioria dos seis modelos, a região recuperada ainda não é a correta. E a etapa de recuperação depende que o analisador de layout (layout parser) execute sua função corretamente. Se uma página for digitalizada em um ângulo inadequado, tiver um layout incomum ou possuir tabelas que o analisador não consegue segmentar bem, toda a cadeia de citação e localização herda esse erro, algo que um modelo hipotético que outputasse coordenadas de pixels corretamente em uma página bem comportada talvez não apresentasse.
Há também uma dependência mais sutil que merece destaque: o treinamento GRPO depende de um modelo juiz para avaliar a qualidade da evidência, e os modelos juízes têm suas próprias cegueiras. O artigo não afirma que o juiz seja um proxy perfeito para o consenso humano, e é razoável questionar isso ao tentar reproduzir o método fora de um ambiente de pesquisa.
Nada disso invalida a descoberta central. A parte interessante deste artigo não são os números específicos de precisão, mas sim o diagnóstico: uma parte do que parecia ser um problema de raciocínio na IA de documentos era, na verdade, um problema de formato de saída, e reformatar a saída moveu o ponteiro mais do que a maioria das mudanças arquitetônicas teria feito.