AI से बॉक्स बनाने के लिए न कहें: उत्तर कहाँ से आया है यह साबित करने का एक बेहतर तरीका
आधारित शोध-पत्र: Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels — Zhuchenyang Liu, Yao Zhang, Yu Xiao
खर्च-रिपोर्ट बॉट की कल्पना करें
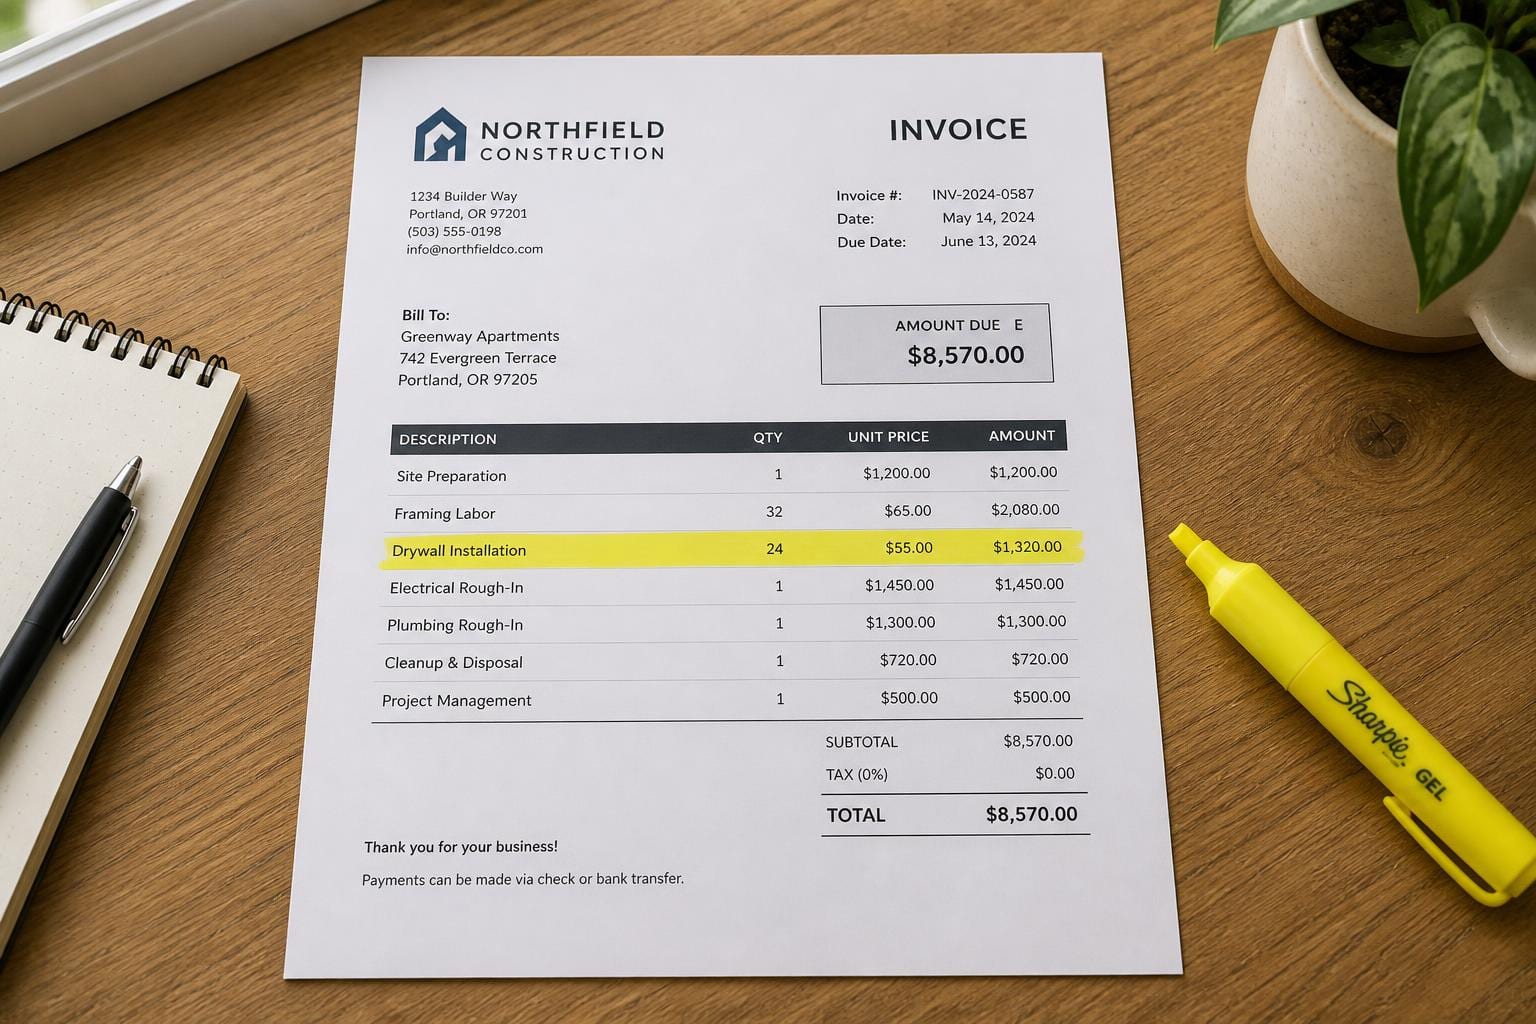
कल्पना करें कि एक खर्च-रिपोर्ट बॉट एक स्कैन की गई इनवॉइस को पढ़ता है और आपको बताता है कि कुल राशि $482.17 है। यह सही है। अब यह विक्रेता के लोगो के चारों ओर एक बॉक्स बनाता है और कहता है कि उसने यह संख्या वहीं पाई थी। उत्तर सही था। इशारा बेमानी था।
यह कोई काल्पनिक स्थिति नहीं है। यह विज़न-लैंग्वेज मॉडल्स (VLMs, वे मॉडल जो एक साथ एक छवि और एक टेक्स्ट प्रॉम्प्ट दोनों को पढ़ सकते हैं) में एक दस्तावेजीकृत विफलता मोड है, और इसका एक नाम है: एट्रिब्यूशन हैलुसिनेशन (Attribution Hallucination)। एक मॉडल आपको सही उत्तर देता है और फिर उसके लिए गलत सबूत का हवाला देता है, या ऐसा सबूत जो वास्तव में मौजूद ही नहीं है। ज़ूचेनयांग लियू, याओ झांग, और यू शियाओ द्वारा लिखी गई एक नई पेपर, "Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels", इस विफलता को कुछ आश्चर्यजनक रूप से साधारण चीज़ से जोड़ती है: हम मॉडल्स से इशारा करने के लिए कैसे पूछते आए हैं।
वह हिस्सा जिसे सब लोग नज़रअंदाज़ कर देते हैं: उत्तर देना और संदर्भ देना अलग-अलग कौशल हैं
आज के अधिकांश दस्तावेज़ प्रश्नोत्तर (document question-answering) सिस्टम इस तरह काम करते हैं। आप मॉडल को एक पेज दिखाते हैं (एक इनवॉइस, एक अनुबंध, एक स्कैन किया गया फॉर्म), एक प्रश्न पूछते हैं ("कुल बकाया कितना है?"), और मॉडल आपको एक उत्तर और एक बाउंडिंग बॉक्स देता है: पिक्सेल निर्देशांकों का एक सेट जो उस आयत को चिह्नित करता है जहाँ मॉडल का मानना है कि उसने वह उत्तर पाया। यह निर्देशांक इंटरफ़ेस है, और यह वह मानक तरीका है जिससे बेचमार्क और प्रोडक्ट मॉडल्स से अपना काम दिखाने के लिए कहते हैं।
समस्या यह है कि दस्तावेज़ पढ़ना और पिक्सेल निर्देशांकों का वर्णन करना दो अलग-अलग कार्य हैं जो एक साथ जोड़े गए हैं। एक मॉडल वास्तव में यह समझ सकता है कि कुल राशि $482.17 है क्योंकि उसने टेबल संरचना को सही ढंग से पार्स किया, और फिर भी "उस सेल में वह संख्या" को "x=412, y=88, width=64, height=22" में बदलने में खराब हो सकता है। निर्देशांक वह भाषा है जिसमें VLMs को मुख्य रूप से ट्रेन नहीं किया गया था। टेक्स्ट है।
लेखकों ने CiteVQA पर इसका परीक्षण किया, जो साक्ष्य विशेषाधिकार (evidence attribution) के लिए विशेष रूप से बनाया गया एक द्विभाषी (अंग्रेज़ी और चीनी) बेचमार्क है, जिसमें सत्यापित सबसेट का उपयोग किया गया है ताकि यह सुनिश्चित हो सके कि कौन सी क्षेत्र वास्तव में प्रत्येक उत्तर का समर्थन करते हैं, इस बारे में ग्राउंड ट्रुथ विश्वसनीय हो। छह ओपन VLMs में, उन्होंने पाया कि मॉडल को एक बॉक्स बनाने देने से आपको साक्ष्य रिकॉल (evidence recall) मिलता है (प्रश्नों का प्रतिशत जहाँ मॉडल द्वारा उद्धृत क्षेत्र वास्तव में सच्चे साक्ष्य के साथ ओवरलैप करता है) जो अधिकतम 100 में से 8 होता है। यह किसी अन्य विधि से 8 प्रतिशत कम नहीं है। आठ। एक सौ प्रश्नों में, बॉक्स शायद आठ बार लगभग सही होता है, भले ही मॉडल का प्रश्न का वास्तविक उत्तर बहुत अधिक बार सही हो।
उन्होंने इसके बजाय क्या आज़माया: मॉडल को उद्धरण देना, फिर उस उद्धरण को खोजना
ग़लतियों को ठीक करने के लिए जो समाधान पेपर में सुझाया गया है, वह बयान करने में तो शर्मनाक हद तक सरल है, लेकिन इसे काम करने के लिए वास्तविक बुनियादी ढांचे की आवश्यकता होती है: मॉडल से निर्देशांक (coordinates) मांगना बंद कर दें।
इसके बजाय, मॉडल प्रश्न का उत्तर देता है और फिर उस पाठ के टुकड़े को शब्दशः उद्धृत करता है जिसका उपयोग उसने सबूत के रूप में किया था, ठीक वैसे ही जैसे आप किसी चैट संदेश में पेज पर कहाँ स्थित है, इसकी बजाय PDF से वाक्य कॉपी-पेस्ट करते हैं। यही "भाषा इंटरफ़ेस" है। एक अलग सिस्टम फिर उस दस्तावेज़ में उस उद्धरण को खोजता है। विशेष रूप से:
- एक लेआउट पार्सर (एक उपकरण जो पृष्ठ को पैराग्राफ, टेबल सेल, हेडर और आकृति कैप्शन जैसे संरचनात्मक क्षेत्रों में विभाजित करता है, ठीक वैसे ही जैसे एक व्यक्ति पृष्ठ को दृश्य रूप से "यह एक पैराग्राफ है, यह एक टेबल है" में विभाजित करेगा) सबसे पहले दस्तावेज़ को उम्मीदवार क्षेत्रों में तोड़ता है।
- एक मल्टीमोडल रीट्रीवर (एक मिलान सिस्टम जो पाठ की तुलना पृष्ठ के पाठ और लेआउट दोनों के साथ कर सकता है) मॉडल के उद्धृत सबूत को लेता है और यह निर्धारित करता है कि यह उनमें से किस क्षेत्र से आया था, और उस क्षेत्र को विशेषता स्थान (attributed location) के रूप में लौटाता है।
- टेबल और आकृतियाँ, जिनका कोई प्रवाहित प्रोज़ नहीं होता जिसे सीधे उद्धृत किया जा सके, उनके कैप्शन या नोट्स के माध्यम से संभाली जाती हैं, इसलिए साधारण पैराग्राफ के बाहर भी उद्धरण-और-स्थान-निर्धारण दृष्टिकोण काम करता है।
संक्षेप में, मॉडल को अब ज्यामिति (geometry) करने की आवश्यकता नहीं है। यह वह करता है जिसमें यह वास्तव में अच्छा है: पाठ पढ़ना और दोहराना। एक रीट्रीवल सिस्टम, जो बिल्कुल इसी प्रकार के मिलान के लिए बनाया गया है, इसके बजाय ज्यामिति करता है।
जो नंबर मामले को स्पष्ट करते हैं
एक ही CiteVQA उपसमुच्चय पर छह खुले VLMs को चलाया गया, भाषा इंटरफ़ेस ने सबूत पुनर्प्राप्ति को उस 8 के छत से बढ़ाकर 26 से 47 के बीच कहीं ले आया, मॉडल पर निर्भर। यह लगभग तीन से छह गुना की कूद है, जो केवल मॉडल से उत्पन्न करने के लिए कहा गया आउटपुट फॉर्मेट बदलकर हासिल की गई, न कि उसे पुनः प्रशिक्षित करके या निर्देशांकों के बारे में बेहतर प्रॉम्प्ट देकर।
नए इंटरफ़ेस के तहत हैलुसिनेशन दर (मॉडल कितनी बार आत्मविश्वास के साथ एक ऐसे सबूत का हवाला देता है जो वास्तव में उसका समर्थन नहीं करता है) लगभग आधी रह गई। और वह हिस्सा जो आमतौर पर पकड़ में आता है: उत्तर की गुणवत्ता, यानी मॉडल वास्तविक प्रश्न का सही उत्तर देता है या नहीं, वह बहुत कम बदला। आप स्रोत के बारे में ईमानदारी के लिए सही होने की कीमत नहीं चुका रहे हैं। आप लगभग मुफ्त में ईमानदारी का अधिकांश हिस्सा वापस पा रहे हैं।
यह मुख्य खोज है, और इसे एक पल के लिए सोचने के लायक है, क्योंकि यह "आकर्षण हैलुसिनेशन" को फिर से परिभाषित करता है। यह ज़रूरी नहीं कि समझने में विफलता हो। कई मामलों में यह अधिकतर आउटपुट-फॉर्मेट विफलता जैसा दिखता है: मॉडल को सही पैराग्राफ पता था, और निर्देशांक इंटरफ़ेस बस उसे इतना अच्छा तरीका नहीं दे पाया था।
पाइपलाइन को एक शिक्षक में बदलना: क्षेत्र लेबल्स के बिना GRPO
याद रखें कि 26-47 रेंज में रिकॉल एक वास्तविक सुधार है, लेकिन यह एक हल हो चुका मुद्दा नहीं है। इसलिए लेखकों ने दूसरे उद्देश्य के लिए कोट-एंड-रिट्रीव (quote-and-retrieve) पाइपलाइन का उपयोग किया: एक प्रशिक्षण स्काफोल्ड के रूप में, ताकि मूल मॉडल को सबसे पहले अच्छे सबूतों को उद्धृत करने में बेहतर बनाया जा सके।
यहीं पर पेपर GRPO (Group Relative Policy Optimization) की ओर बढ़ता है, जो एक रीइन्फोर्समेंट-लर्निंग विधि है जो समान इनपुट के लिए उम्मीदवार आउटपुट्स का एक बैच जनरेट करती है, प्रत्येक का स्कोर करती है, और मॉडल को उस दिशा में धकेलती है जो समूह के सापेक्ष सबसे अच्छा स्कोर करती है। यह उसी तकनीक के परिवार का हिस्सा है जिसका उपयोग DeepSeek ने अपने R1 रीजनिंग मॉडल को प्रशिक्षित करने के लिए किया था, और यह किसी ऐसे कार्य पर मॉडल को फाइन-ट्यून करने का एक लोकप्रिय तरीका बन गया है जहाँ आप "बेहतर" को परिभाषित कर सकते हैं लेकिन आपके पास यह दिखाने के लिए बड़ा लेबल्ड डेटासेट नहीं है कि "बेहतर" कदम-दर-कदम कैसा दिखता है।
एट्रिब्यूशन मॉडल को प्रशिक्षित करने का सामान्य तरीका एनोटेटर्स को हायर करना होगा जो हजारों दस्तावेज़ पृष्ठों पर ग्राउंड-ट्रुथ बाउंडिंग बॉक्स खींचें, यह चिह्नित करते हुए कि कौन सा क्षेत्र किस उत्तर का समर्थन करता है। यह महंगा और धीमा है, खासकर लंबे, मल्टी-पेज दस्तावेज़ों के लिए जहाँ एक एकल उत्तर पृष्ठ 14 में दबे हुए सबूतों पर निर्भर हो सकता है।
पेपर इसे पूरी तरह से छोड़ देता है। क्षेत्र लेबल्स के बजाय, रिवॉर्ड सिग्नल एक जज से आता है: एक अन्य मॉडल जो प्रश्न के गोल्ड (सही) उत्तर के साथ-साथ ट्रेनी मॉडल के उद्धृत सबूतों के लिए रिट्रीवर द्वारा लाए गए क्षेत्रों की क्रॉप्ड छवियों को पढ़ता है, और रेट करता है कि वे क्रॉप्स वास्तव में उस उत्तर का समर्थन कितनी अच्छी तरह करते हैं। कोई इंसान कभी बॉक्स नहीं खींचता। मॉडल को उन पाठों को उद्धृत करने के लिए इनाम दिया जाता है जो, एक बार स्थान और क्रॉप किए जाने पर, सही उत्तर को दृश्यमान रूप से सपोर्ट करते हैं, और जब उसके उद्धरण रिट्रीवर को प्रासंगिक नहीं होने वाले क्षेत्रों की ओर ले जाते हैं तो उसे दंडित किया जाता है।
8B-पैरामीटर बैकबोन मॉडल (8 अरब पैरामीटर, वर्तमान मानकों के अनुसार एक मध्यम आकार का ओपन मॉडल) पर लागू करने पर, इस प्रशिक्षण ने पेपर द्वारा "स्ट्रिक्ट एट्रिब्यूटेड एकरसी" (strict attributed accuracy) कहा जाने वाले मेट्रिक को 22.4 से बढ़ाकर 33.8 तक पहुँचाया, जिसका अर्थ है कि मॉडल को उत्तर और सबूत दोनों सही होने चाहिए, वरना यह गिनती में नहीं आएगा। पेपर में सबसे सख्त, सबसे कम क्षमाशील मेट्रिक पर यह लगभग 50% सापेक्ष सुधार है, जो नए मानव-लेबल्ड डेटा के बजाय पूरी तरह से मौजूदा उपकरणों (एक जज मॉडल, एक लेआउट पार्सर, एक रिट्रीवर) से बनाए गए प्रशिक्षण सिग्नल का उपयोग करके प्राप्त किया गया है।
यह क्यों मायने रखता है किसी भी डॉक्यूमेंट AI बनाने या खरीदने वाले के लिए
अगर आप OCR या डॉक्यूमेंट AI पर कुछ भी बना रहे हैं, तो यहाँ का मुख्य सबक "इस विशिष्ट बेंचमार्क का उपयोग करें" नहीं है। यह है कि जिस इंटरफ़ेस का आप मॉडल से अपने आप को सही साबित करने के लिए कहने के लिए उपयोग करते हैं, वह यह निर्धारित करता है कि वह कितना ईमानदार हो सकता है, चाहे मॉडल के नीचे वास्तव में कितना अच्छा हो।
कुछ ठोस निष्कर्ष:
- अगर आपका प्रोडक्ट उपयोगकर्ताओं को डॉक्यूमेंट पर "यहाँ देखें जहाँ मैंने यह पाया" दिखाता है, तो जाँचें कि उस उद्धरण (citation) को कौन सा इंटरफ़ेस जनरेट कर रहा है। इस पेपर के अनुसार, एक सामान्य VLM से बाउंडिंग-बॉक्स आउटपुट, भले ही दिया गया उत्तर सही हो, अज्ञात डॉक्यूमेंट्स पर अधिकतम 8% समय ही सही होता है। "उत्तर सही है" और "उद्धरण सही है" के बीच यह अंतर वही जगह है जहाँ उपयोगकर्ताओं का भरोसा धीरे-धीरे खो जाता है, क्योंकि सही उत्तर के बगल में गलत हाइलाइटिंग, बिल्कुल हाइलाइटिंग न होने की तुलना में उपयोगकर्ता के लिए बदतर लगती है।
- Quote-then-locate एक पैटर्न है जिसे आप आज ही बना सकते हैं, बेहतर फाउंडेशन मॉडल्स का इंतज़ार किए बिना। इसके लिए एक कस्टम-ट्रेन किया गया VLM की आवश्यकता नहीं है। इसमें एक लेआउट पार्सर और एक रीट्रीवर की आवश्यकता होती है जो आपके पहले से उपयोग किए जा रहे मॉडल के चारों ओर जुड़ा हो, क्योंकि इस पेपर में पाँच में से छह मॉडल्स के लिए सुधार इंटरफ़ेस बदलने से आया था, न कि अंतर्निहित वेट्स से।
- रिजन-लेवल लेबल्स महंगे होते हैं, और यह पेपर उनके आसपास एक रास्ता दिखाता है। अगर आप एट्रिब्यूशन क्वालिटी को बेहतर बनाने के लिए एक एनोटेशन प्रोजेक्ट को फंड करने के विरुद्ध एक जज-आधारित रिवॉर्ड पाइपलाइन बनाने पर विचार कर रहे हैं, तो GRPO परिणाम सुझाव देता है कि दूसरा रास्ता एक भी मानव-आकर्षित बॉक्स के बिना वास्तविक लाभ (कठोर एट्रिब्यूटेड एकरूपता में 22.4 से 33.8) प्राप्त कर सकता है।
यह आरेख दिखाता है कि इंटरफ़ेस डिज़ाइन कैसे मॉडल की विश्वसनीयता को प्रभावित करता है।
मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; इस पेपर की दायरे में देवनागरी स्क्रिप्ट के लिए अलग चुनौतियाँ हैं, जैसे कि संयुक्त अक्षरों और शिरोरेखा की जटिलताएँ, जिन्हें ध्यान में रखना आवश्यक है।
अभी भी अनसुलझे मुद्दे
लेखक दायरे (scope) के बारे में सावधानी बरतते हैं, और इसे पढ़ते समय उतनी ही सावधानी बरतना उचित है। लाभों को CiteVQA, एक द्विभाषी बेचमार्क पर मापा गया था, और हालांकि सत्यापित उपसमुच्चय (verified subset) अनफ़िल्टर्ड डेटासेट की तुलना में एक अर्थपूर्ण रूप से उच्च मानक है, यह फिर भी केवल एक डेटासेट है। 26-47 के रेंज में साक्ष्य रिकॉल (evidence recall) 8 से एक बड़ी छलांग है, लेकिन यह संतृप्त (saturated) होने के करीब भी नहीं है: छह मॉडलों में से अधिकांश के लिए, अधिकांश बार, पुनर्प्राप्त क्षेत्र (retrieved region) अभी भी सही नहीं होता है। और रिकवरी चरण इस बात पर निर्भर करता है कि लेआउट पार्सर अपना काम सही ढंग से कर रहा है। यदि किसी पृष्ठ को खराब कोण पर स्कैन किया गया है, उसका लेआउट असामान्य है, या उसमें ऐसे ताले हैं जिन्हें पार्सर ठीक से विभाजित नहीं कर सकता, तो पूरा "उद्धरण-और-स्थान-निर्धारण" (quote-and-locate) श्रृंखला उस त्रुटि को विरासत में प्राप्त करती है, जिस तरह से एक काल्पनिक मॉडल जो एक व्यवस्थित पृष्ठ पर पिक्सेल निर्देशांक सही ढंग से आउटपुट करता है, वह शायद नहीं करती।
एक और सूक्ष्म निर्भरता को ध्यान में रखना महत्वपूर्ण है: GRPO प्रशिक्षण साक्ष्य की गुणवत्ता को ग्रेड करने के लिए एक जज मॉडल (judge model) पर निर्भर करता है, और जज मॉडल के अपने अंधेरे कोने (blind spots) होते हैं। लेख यह दावा नहीं करता कि जज मानवीय सहमति के लिए एक पूर्ण प्रतिस्थापक है, और यदि आप शोध सेटिंग के बाहर इसे पुन: प्रस्तुत करने का प्रयास कर रहे हैं, तो इस पर जोर देना एक उचित बात है।
इनमें से कोई भी बात मुख्य निष्कर्ष को कमजोर नहीं करती। इस लेख का दिलचस्प हिस्सा विशिष्ट सटीकता संख्याएं नहीं हैं, बल्कि निदान है: दस्तावेज़ AI में एक तर्क समस्या (reasoning problem) जैसा दिखने वाले हिस्से का एक बड़ा हिस्सा वास्तव में एक आउटपुट-फॉर्मेट समस्या थी, और आउटपुट को फिर से फॉर्मेट करने से सुधार हुआ, जो कि अधिकांश आर्किटेक्चरल परिवर्तनों की तुलना में अधिक प्रभावी था।