别再让 AI 画框了:一种证明答案来源的更好方法
参考论文: Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels — Zhuchenyang Liu, Yao Zhang, Yu Xiao
想象一下
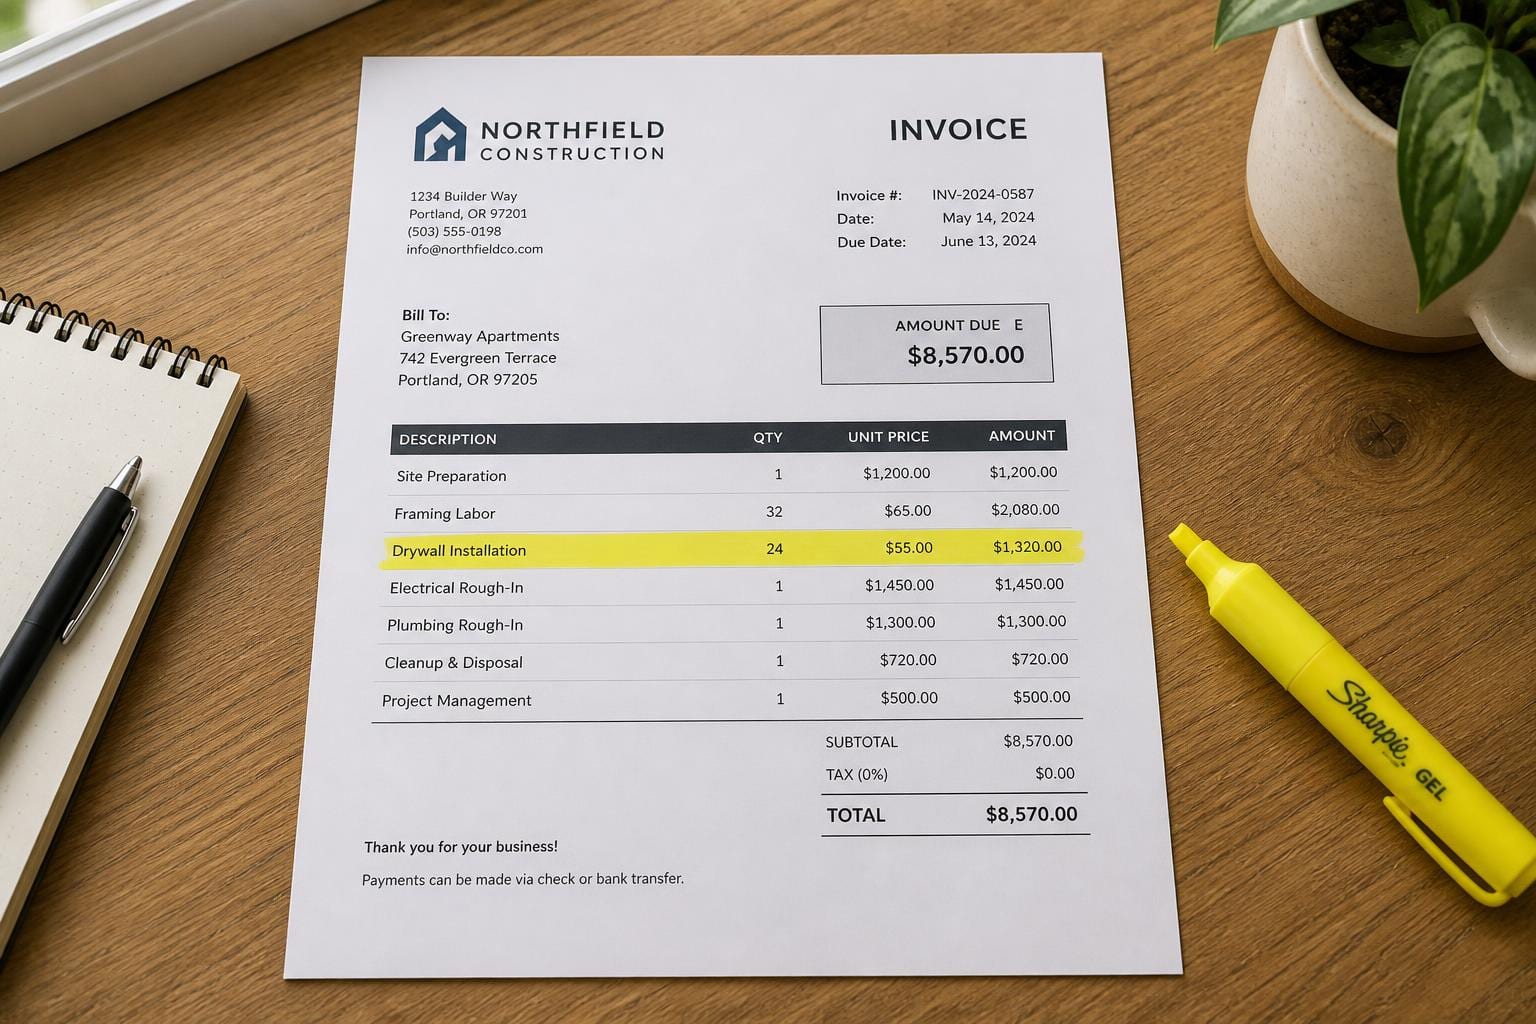
想象一下,一个费用报销机器人读取了一张扫描的发票,并告诉你总金额是 482.17 美元。它是正确的。现在,它在供应商的标志周围画了一个框,并说这就是它找到该数字的地方。答案是正确的。但指向却是胡扯。
这并非假设。这是视觉语言模型(VLMs,即能够同时读取图像和文本提示的模型)中一种有据可查的故障模式,并且它有一个名称:归因幻觉(Attribution Hallucination)。模型会给你正确的答案,然后引用错误的证据,或者引用根本不存在的证据。一篇新论文《无需坐标或区域标签的视觉文档理解中的证据归因》("Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels"),由刘竹阳(Zhuchenyang Liu)、张耀(Yao Zhang)和肖宇(Yu Xiao)撰写,将这种故障追踪到一个出奇平凡的原因:我们要求模型进行指向的方式。
被所有人忽略的部分:回答和引用是不同的技能
如今大多数文档问答系统的工作方式如下。你向模型展示一页文档(发票、合同、扫描的表格),提出一个问题(“应付总额是多少?”),模型会给出一个答案以及一个边界框:一组像素坐标,标记出模型声称找到该答案的页面矩形区域。这就是坐标接口,也是基准测试和产品要求模型展示其工作过程的标准方式。
问题在于,阅读文档和描述像素坐标是两个被强行捆绑在一起的不同任务。模型可能因为正确解析了表格结构而真正理解总额为 $482.17,但仍然不擅长将“那个单元格中的那个数字”转化为“x=412, y=88, width=64, height=22”。坐标是一种视觉语言模型(VLM)并非主要训练来使用的语言。文本才是。
作者在 CiteVQA 上对此进行了测试,这是一个专门为证据归因构建的双语(英语和中文)基准测试,使用经过验证的子集,因此关于哪些区域实际支持每个答案的基准事实是可信的。在六个开源 VLM 中,他们发现让模型绘制一个框只能得到最多 8/100 的证据召回率(模型引用的区域实际与真实证据重叠的问题百分比)。不是比某些其他方法低 8 个百分点。是 8。在一百个问题中,即使模型对问题的实际答案正确率远高于此,框大致正确的次数可能也只有八次。
他们尝试的替代方案:让模型引用原文,然后再去定位该引用
论文中提出的修复方案在表述上几乎简单得令人尴尬,但要使其真正发挥作用则需要实实在在的底层基础设施支持:彻底停止要求模型输出坐标。
取而代之的是,模型在回答问题后,会逐字引用其作为证据使用的文本片段,就像你会将 PDF 中的一句话复制粘贴到聊天消息中,而不是描述它在页面上的具体位置一样。这就是所谓的“语言接口”。随后,一个独立的系统会去文档中查找该引用。具体流程如下:
- 布局解析器(一种将页面分割为段落、表格单元格、标题和图片说明等结构区域的工具,就像人眼将页面视觉化为“这是一段文字,这是一个表格”那样)首先将文档拆分为候选区域。
- 多模态检索器(一种能够将文本与页面的文本及布局进行比对的匹配系统)接收模型引用的证据,并确定其源自哪个区域,将该区域作为归属位置返回。
- 对于无法直接引用流动文本的表格和图片,则通过其标题或注释进行处理,因此即使在纯段落之外,这种“引用并定位”的方法依然有效。
实质上,模型不再需要处理几何问题。它只做自己真正擅长的事:阅读和复述文本。而几何定位工作则由一个专为此类匹配任务构建的检索系统来完成。
支撑论点的数据
在相同的 CiteVQA 子集上运行相同的六个开源 VLM,语言接口将证据召回率从 8 的上限提升至 26 到 47 之间,具体取决于模型。这是一个大约三到六倍的跃升,纯粹是通过改变要求模型生成的输出格式实现的,而不是通过重新训练或提供关于坐标的更好提示。
幻觉率(模型自信地将答案归因于实际上不支持它的证据的频率)在新接口下大约减半。而通常被视为缺点的部分:答案质量,即模型是否正确回答了实际问题,几乎没有变化。你并没有用正确性来换取对来源的诚实。你几乎免费地找回了大部分的诚实。
这是主要发现,值得仔细思考,因为它重新定义了“归因幻觉”的含义。它不一定是理解失败。在许多情况下,它看起来更像是输出格式失败:模型知道正确的段落,但坐标接口没有给它一个好的表达方式。
将流水线转化为教师:无需区域标签的 GRPO
回想一下,26-47 范围内的召回率确实是一种改进,但这并非一个已彻底解决的问题。因此,作者将引用与检索流水线用于第二个目的:作为训练脚手架,使底层模型在最初就能更好地引用优质证据。
正是在这里,论文引入了 GRPO(Group Relative Policy Optimization,组相对策略优化),这是一种强化学习方法,它为同一输入生成一批候选输出,对每个输出进行评分,并促使模型向相对于组内得分最高的输出靠拢。这与 DeepSeek 用于训练其 R1 推理模型的技术属于同一类,它已成为在任务中能够定义“更好”但缺乏展示逐步“更好”样貌的大型标注数据集时,微调模型的流行方式。
训练归因模型的常规方法是雇佣标注人员在数千个文档页面上绘制真实边界框,精确标记哪个区域支持哪个答案。这既昂贵又缓慢,特别是对于长文档或多页文档,单个答案可能依赖于隐藏在第十四页的证据。
该论文完全规避了这一问题。它不使用区域标签,而是从评判者那里获得奖励信号:另一个模型读取问题的黄金(正确)答案,以及检索器为受训模型引用的证据提取的区域裁剪图像,并评估这些裁剪图像在多大程度上实际支持该答案。人类无需绘制任何框。当模型引用的文本在被定位和裁剪后,明显支持正确答案时,模型会获得奖励;而当其引用导致检索器找到无关区域时,则会受到惩罚。
这种训练方法应用于一个 8B 参数的主干模型(80 亿参数,按当前标准属于中等规模的开源模型),将论文所称的“严格归因准确率”——即模型必须同时答对答案和证据,否则不计入——从 22.4 提升至 33.8。这在论文中最严格、最不容忍的指标上实现了约 50% 的相对提升,其训练信号完全由现有工具(评判模型、布局解析器、检索器)构建,而非依赖新的人工标注数据。
为什么这对构建或采购文档 AI 的人至关重要
如果您正在基于 OCR 或文档 AI 构建任何产品,这里的核心教训并非“使用这个特定的基准测试”。而是,您用来要求模型自我解释的接口,会改变其“诚实”的程度,这与模型本身的基础能力无关。
几个具体的启示:
- 如果您的产品向用户展示“我在此处找到了该内容”,请检查生成该引用的接口。 根据本文,通用视觉语言模型(VLM)输出的边界框在未见过的文档上最多只有 8% 的准确率,即使其给出的答案本身是正确的。这种“答案正确”与“引用正确”之间的差距,正是用户信任被悄然侵蚀的地方,因为与正确答案相伴的错误高亮,比完全没有高亮更让用户反感。
- “先引用后定位”是一种您可以立即采用的模式,无需等待更强大的基础模型。 它不需要定制训练的 VLM。它只需要一个布局解析器和一个检索器,与您现有的模型相结合,因为本文中的改进来自于改变接口,而非底层权重,这在测试的六个模型中有五个得到了验证。
- 区域级标注成本高昂,而本文展示了一条绕过这一成本的路径。 如果您正在权衡是资助一个标注项目以提高归因质量,还是构建一个基于裁判的奖励管道,GRPO 的结果表明,后者可以在不依赖任何人工绘制边界框的情况下获得实质性提升(严格归因准确率从 22.4 提升至 33.8)。鉴于中文等汉字符号系统具有字符密集、布局复杂的特点,这种不依赖精确边界框的归因方法,对于处理非拉丁字母的文档识别任务同样具有显著的实用价值。
尚未解决的问题
该论文对研究范围界定得非常谨慎,我们在阅读时也应保持同样的审慎。其性能提升是在 CiteVQA 这一双语基准上测量的,虽然经过验证的子集比未经过滤的数据集代表了更高的标准,但它毕竟只是单一数据集。证据召回率从 8 跃升至 26-47 的区间,这是一个巨大的进步,但远未达到饱和状态:在大多数情况下,对于这六个模型中的大部分,检索到的区域仍然不正确。此外,检索步骤依赖于布局解析器(layout parser)能否正确执行任务。如果页面扫描角度不佳、布局特殊,或者包含解析器难以良好分割的表格,整个“引用并定位”(quote-and-locate)链条都会继承这些错误,而一个假设的、能在规范页面上直接输出像素坐标的模型则可能不会受到此类影响。
还有一个更微妙的依赖关系值得指出:GRPO 训练依赖于一个裁判模型(judge model)来评估证据质量,而裁判模型自身也存在盲区。论文并未声称该裁判模型是人类一致性的完美代理,但在研究环境之外尝试复现此工作时,继续推进这一方法是合理的。
上述问题并未削弱其核心发现。这篇论文有趣的部分不在于具体的准确率数字,而在于其诊断结论:文档 AI 中看似属于推理问题的一部分,实际上是一个输出格式问题,而重新格式化输出所带来的提升,超过了大多数架构变更所能带来的效果。